
 TRAE-AI编程



OpenAI MCP 服务器构建与集成
模型上下文协议(MCP)是开放协议,正逐渐成为为AI模型扩展工具与知识的行业标准。远程MCP服务器可通过互联网,为模型连接新的数据源与能力。
本文构建从私有数据源(向量存储)读取数据的远程服务器,使其可通过ChatGPT和Codex插件、ChatGPT深度研究、企业知识,以及API使用。
说明:若要通过MCP服务器构建插件,先阅读插件文档的快速开始、构建MCP服务器、连接与测试插件、认证。不需要界面时,可以只暴露工具,不提供界面资源。
配置数据源
远程服务器可使用任意数据源。为简化示例,这里使用OpenAI API的向量存储。先创建向量存储并上传PDF,可使用这本19世纪、已进入公有领域的猫主题书籍。
可以在控制台上传文件并创建向量存储,也可通过API完成。具体步骤见向量存储指南。记录存储的唯一ID,供后续示例使用。
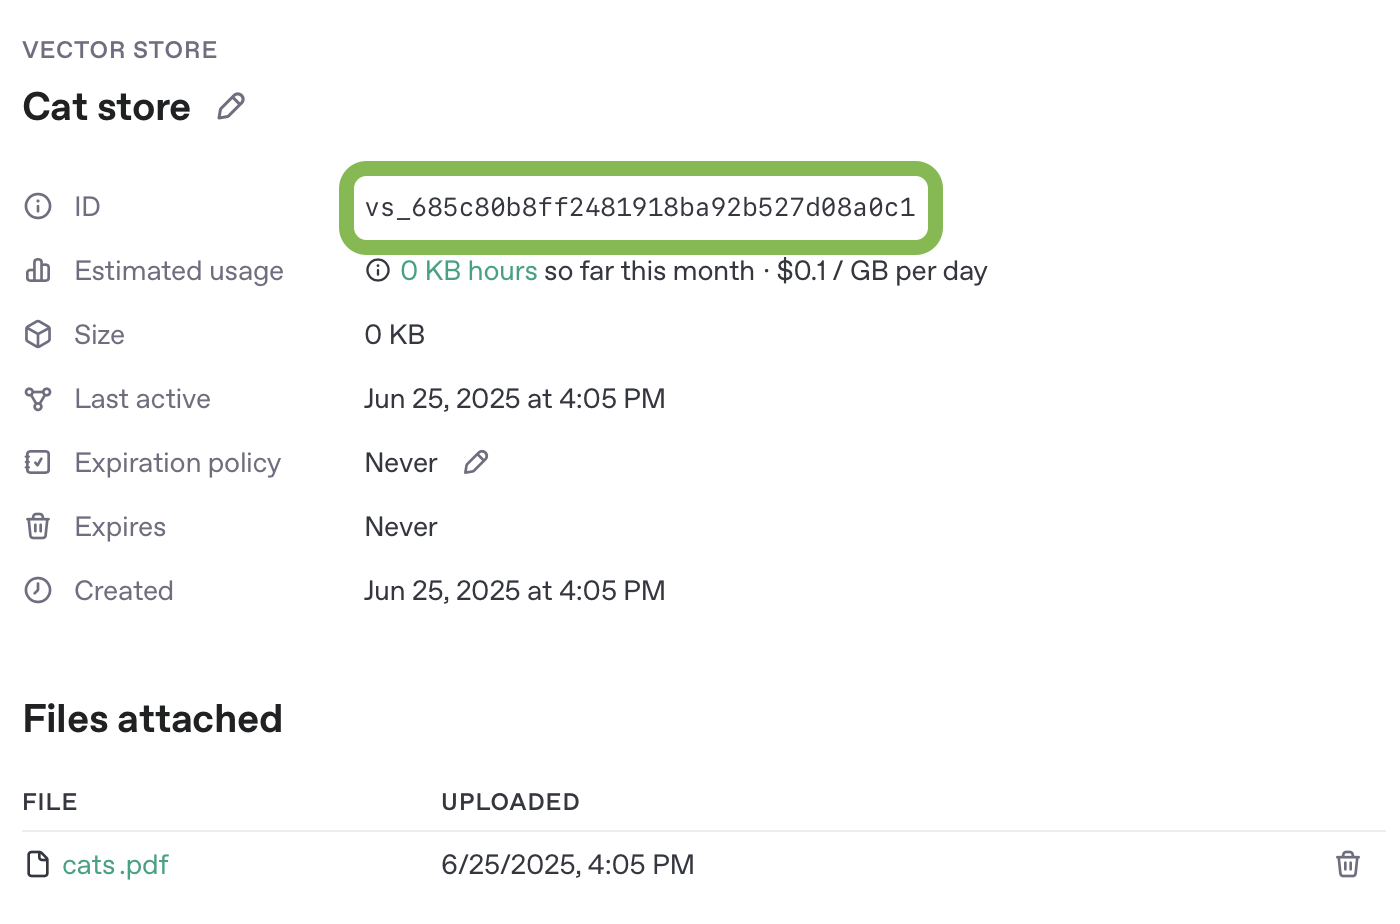
创建MCP服务器
服务器需要搜索向量存储,并能按文件ID返回文档内容。
示例使用Python和FastMCP。本节末尾提供完整实现及在浏览器开发环境运行的方法。也可使用其他语言和框架,但工具定义必须符合以下结构。
为兼容ChatGPT深度研究和企业知识,服务器应按企业知识兼容结构实现两个只读工具:search与fetch。相同接口也适用于API研究工作流。
每个工具都应声明输出Schema,便于客户端验证结果形状。FastMCP可以根据带类型的返回模型自动生成Schema;示例从同一模型生成并显式传入output_schema。
search工具
search根据用户查询,从数据源返回相关搜索结果列表。
参数:单个查询字符串。
返回值:对象只有一个results键,值为结果数组。每项包含:
id:文档或搜索结果项的唯一ID。title:供人阅读的标题。url:供引用使用的规范URL。
在MCP响应中,将该对象作为structuredContent返回,并将相同值编码成JSON字符串,放入content数组,以保持兼容。
最终工具响应示例:
来源示例 1(json):
中文译释:search返回results数组;structuredContent与content中的JSON字符串应表达同一个对象,id、title、url分别用于标识、标题与引用。
{
  "structuredContent": {
    "results": [{ "id": "doc-1", "title": "...", "url": "..." }]
  },
  "content": [
    {
      "type": "text",
      "text": "{\"results\":[{\"id\":\"doc-1\",\"title\":\"...\",\"url\":\"...\"}]}"
    }
  ]
}
fetch工具
fetch获取某个搜索结果文档或条目的完整内容。
参数:唯一标识该文档的字符串。
返回值:包含以下属性的对象:
id:文档或搜索结果项的唯一ID。title:结果标题。text:文档或条目的全文。url:文档或结果项URL,用于研究中引用具体资源。metadata:可选的结果元数据键值对。
同样将对象作为structuredContent返回,并在content数组中包含其JSON编码字符串。
最终工具响应示例:
来源示例 2(json):
中文译释:fetch返回id、title、全文text、url和可选metadata;兼容文本内容与结构化内容应保持一致。
{
  "structuredContent": {
    "id": "doc-1",
    "title": "...",
    "text": "full text...",
    "url": "https://example.com/doc",
    "metadata": { "source": "vector_store" }
  },
  "content": [
    {
      "type": "text",
      "text": "{\"id\":\"doc-1\",\"title\":\"...\",\"text\":\"full text...\",\"url\":\"https://example.com/doc\",\"metadata\":{\"source\":\"vector_store\"}}"
    }
  ]
}
引用行为
对search结果和fetch响应,只有url是非空字符串时,ChatGPT才会生成引用元数据。只有标题、没有可用URL的结果仍作为普通工具输出,不会变成空引用。若希望结果可被引用,应返回其规范URL。
例如,ChatGPT可能这样调用搜索:
来源示例 3(json):
中文译释:查询示例意为“本季度计划是什么?”;查询本身不触发引用处理。
{ "query": "What is the quarterly plan?" }服务器返回带URL的结果:
来源示例 4(json):
中文译释:示例标题为“季度计划”,url非空使结果具备生成引用元数据的条件;字段名和示例值保留原样。
{
  "structuredContent": {
    "results": [
      {
        "id": "quarterly-plan",
        "title": "Quarterly plan",
        "url": "https://example.com/quarterly-plan"
      }
    ]
  },
  "content": [
    {
      "type": "text",
      "text": "{\"results\":[{\"id\":\"quarterly-plan\",\"title\":\"Quarterly plan\",\"url\":\"https://example.com/quarterly-plan\"}]}"
    }
  ]
}
这里的url有值,因此具备生成引用元数据的条件。查询文本本身不会触发引用处理。如果省略URL,或其值为空、不是字符串,结果保留为普通工具输出。
服务器示例
可在浏览器开发环境试用此示例,替换为自己的API凭证和向量存储信息。
在Replit复制并测试MCP服务器示例。下面也提供FastMCP中两个工具的完整实现。
完整实现:FastMCP服务器
来源示例 5(python):
代码中的server_instructions完整译文:
此MCP服务器为ChatGPT应用和深度研究提供搜索和文档检索能力。先使用search工具按关键词查找相关文档,再使用fetch工具获取包含引用的完整文档内容。
## [中文] 完整FastMCP示例:声明search/fetch输出模型,从环境读取密钥,搜索向量存储并按文件ID提取正文,通过SSE启动服务;部署认证需另按正文配置。
## Replace the illustrative IDs and URLs below with your own resource values.
"""
Sample MCP Server for ChatGPT Integration

This server implements the Model Context Protocol (MCP) with search and fetch
capabilities designed to work with ChatGPT's chat and deep research features.
"""

import logging
import os
from typing import Any

from fastmcp import FastMCP
from openai import OpenAI
from pydantic import BaseModel


## [中文] 搜索结果项包含文档ID、可读标题和规范引用URL。
class SearchResult(BaseModel):
    id: str
    title: str
    url: str


## [中文] 搜索输出将多个结果项放在results数组中。
class SearchOutput(BaseModel):
    results: list[SearchResult]


## [中文] 取回输出包含全文及可选元数据,供客户端校验。
class FetchOutput(BaseModel):
    id: str
    title: str
    text: str
    url: str
    metadata: dict[str, Any] | None = None


## Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

## OpenAI configuration
## [中文] 从环境读取API密钥;不要在代码中填入真实密钥。
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]
## [中文] 替换为已经创建并上传文档的向量存储ID。
VECTOR_STORE_ID = "vs_123"

## Initialize OpenAI client
openai_client = OpenAI(api_key=OPENAI_API_KEY)

## [中文] 服务器指令要求先搜索,再取回全文,并用URL提供引用。
server_instructions = """
This MCP server provides search and document retrieval capabilities
for ChatGPT Apps and deep research. Use the search tool to find relevant documents
based on keywords, then use the fetch tool to retrieve complete
document content with citations.
"""


def create_server():
    """Create and configure the MCP server with search and fetch tools."""

    # Initialize the FastMCP server
    mcp = FastMCP(name="Sample MCP Server", instructions=server_instructions)

    @mcp.tool(output_schema=SearchOutput.model_json_schema())
    # [中文] 按查询搜索;空白查询返回results为空数组的SearchOutput对象,正常结果保留ID、标题与URL。
    async def search(query: str) -> SearchOutput:
        """
        Search for documents using OpenAI Vector Store search.

        This tool searches through the vector store to find semantically relevant matches.
        Returns a list of search results with basic information. Use the fetch tool to get
        complete document content.

        Args:
            query: Search query string. Natural language queries work best for semantic search.

        Returns:
            Dictionary with 'results' key containing list of matching documents.
            Each result includes id, title, and URL.
        """
        if not query or not query.strip():
            return SearchOutput(results=[])

        if not openai_client:
            logger.error("OpenAI client not initialized - API key missing")
            raise ValueError("OpenAI API key is required for vector store search")

        # Search the vector store using OpenAI API
        logger.info(f"Searching {VECTOR_STORE_ID} for query: '{query}'")

        # [中文] 请求向量存储搜索;示例会记录查询日志,部署前核对敏感数据与日志策略。
        response = openai_client.vector_stores.search(
            vector_store_id=VECTOR_STORE_ID, query=query
        )

        results = []

        # Process the vector store search results
        if hasattr(response, "data") and response.data:
            for i, item in enumerate(response.data):
                # Extract file_id, filename, and content
                item_id = getattr(item, "file_id", f"vs_{i}")
                item_filename = getattr(item, "filename", f"Document {i + 1}")

                result = SearchResult(
                    id=item_id,
                    title=item_filename,
                    url=f"https://platform.openai.com/storage/files/{item_id}",
                )

                results.append(result)

        logger.info(f"Vector store search returned {len(results)} results")
        return SearchOutput(results=results)

    @mcp.tool(output_schema=FetchOutput.model_json_schema())
    # [中文] 使用搜索结果的文件ID获取全文,缺少ID时抛出错误。
    async def fetch(id: str) -> FetchOutput:
        """
        Retrieve complete document content by ID for detailed
        analysis and citation. This tool fetches the full document
        content from OpenAI Vector Store. Use this after finding
        relevant documents with the search tool to get complete
        information for analysis and proper citation.

        Args:
            id: File ID from vector store (file-xxx) or local document ID

        Returns:
            Complete document with id, title, full text content,
            optional URL, and metadata

        Raises:
            ValueError: If the specified ID is not found
        """
        if not id:
            raise ValueError("Document ID is required")

        if not openai_client:
            logger.error("OpenAI client not initialized - API key missing")
            raise ValueError(
                "OpenAI API key is required for vector store file retrieval"
            )

        logger.info(f"Fetching content from vector store for file ID: {id}")

        # Fetch file content from vector store
        # [中文] 读取文件内容;后续示例仅拼接响应data中的文本,分页是否完整仍须实测。
        content_response = openai_client.vector_stores.files.content(
            vector_store_id=VECTOR_STORE_ID, file_id=id
        )

        # Get file metadata
        # [中文] 另取文件元数据,用文件名作为标题、属性作为可选metadata。
        file_info = openai_client.vector_stores.files.retrieve(
            vector_store_id=VECTOR_STORE_ID, file_id=id
        )

        # Extract content from paginated response
        file_content = ""
        if hasattr(content_response, "data") and content_response.data:
            # Combine all content chunks from FileContentResponse objects
            content_parts = []
            for content_item in content_response.data:
                if hasattr(content_item, "text"):
                    content_parts.append(content_item.text)
            file_content = "\n".join(content_parts)
        else:
            file_content = "No content available"

        # Use filename as title and create proper URL for citations
        filename = openai_client.files.retrieve(file_id=id).filename

        # [中文] 组装全文结果和可引用URL;示例URL须按自己的数据源与访问权限调整。
        result = FetchOutput(
            id=id,
            title=filename,
            text=file_content,
            url=f"https://platform.openai.com/storage/files/{id}",
        )

        # Add metadata if available from file info
        if hasattr(file_info, "attributes") and file_info.attributes:
            result.metadata = dict(file_info.attributes)

        logger.info(f"Fetched vector store file: {id}")
        return result

    return mcp


def main():
    """Main function to start the MCP server."""
    logger.info(f"Using vector store: {VECTOR_STORE_ID}")

    # Create the MCP server
    server = create_server()

    # Configure and start the server
    logger.info("Starting MCP server on 0.0.0.0:8000")
    logger.info("Server will be accessible via SSE transport")

    try:
        # Use FastMCP's built-in run method with SSE transport
        port = int(os.environ.get("OPENAI_EXAMPLE_PORT", "8000"))
        # [中文] 通过SSE在配置端口启动服务,监听0.0.0.0;生产环境需另行落实网络和认证设置。
        server.run(
            transport="sse",
            host="0.0.0.0",
            port=port,
            uvicorn_config={"loop": "asyncio"},
        )
    except KeyboardInterrupt:
        logger.info("Server stopped by user")
    except Exception as e:
        logger.error(f"Server error: {e}")
        raise


if __name__ == "__main__":
    main()
Replit设置
在Replit的 Secrets(机密)界面配置OPENAI_API_KEY。将示例中的vs_123替换为前面创建的向量存储ID。
免费账户的服务器URL通常只在编辑器保持活动时有效,因此测试期间要保持浏览器标签页打开。选择链接图标,获取服务器URL:
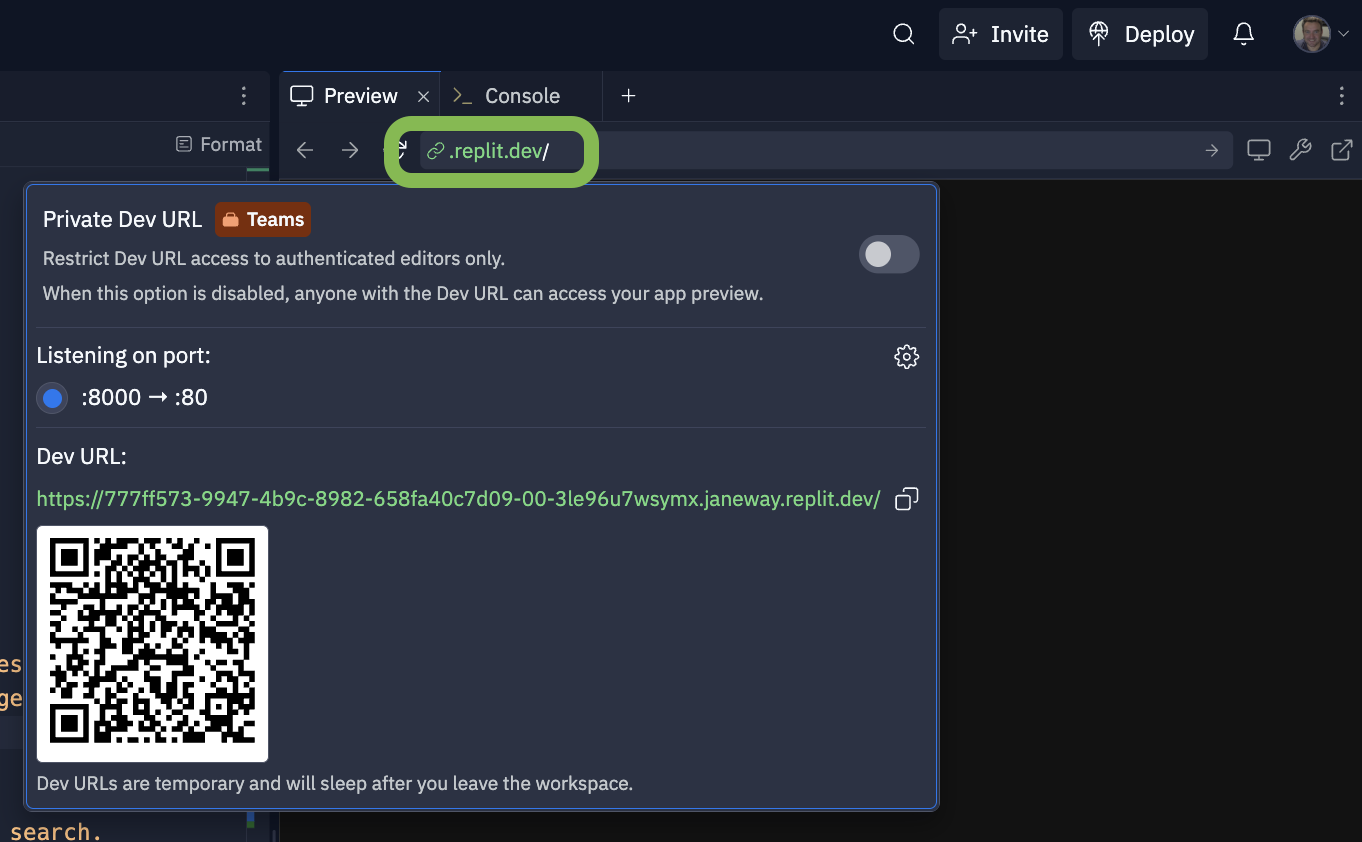
确保较长的开发URL以/sse/结尾;这是服务器发送事件接口,用于在ChatGPT连接应用或通过API调用。例如:
来源示例 6():
中文译释:这是Replit开发服务器的SSE地址示意,部署时须替换为自己的服务器URL,不是可直接执行的程序。
https://777xxx.janeway.replit.dev/sse/测试并连接服务器
可在提示控制台使用gpt-6.1-sol测试。新建或编辑提示,在配置中添加MCP工具。此兼容示例只暴露只读的search、fetch,因此API请求跳过这些工具的审批;能修改数据或执行其他实质影响操作的工具应保持审批。
作为插件测试时,遵循连接与测试插件。
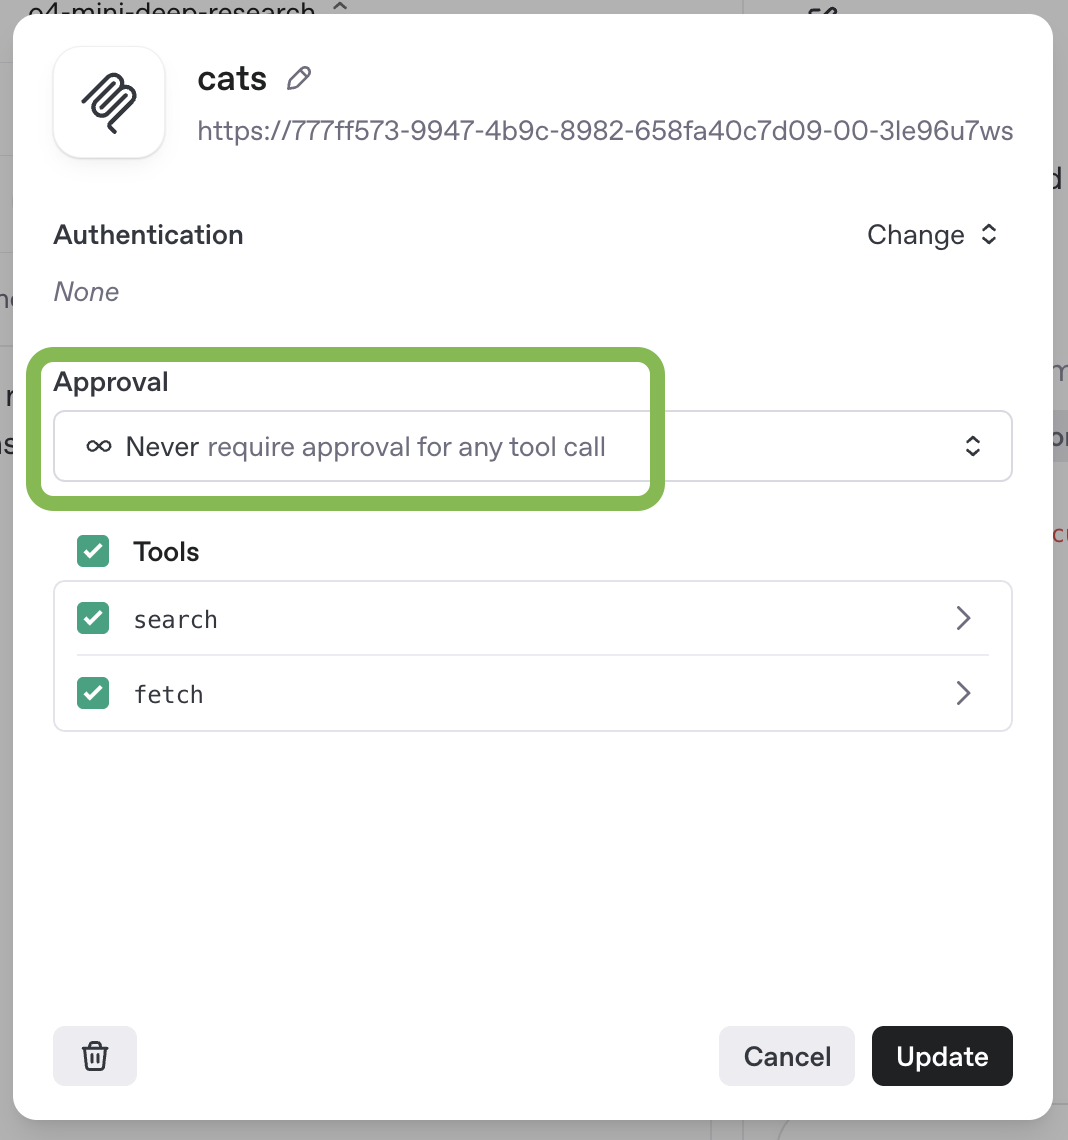
配置完成后,可通过Prompts界面与使用该服务器的模型对话。
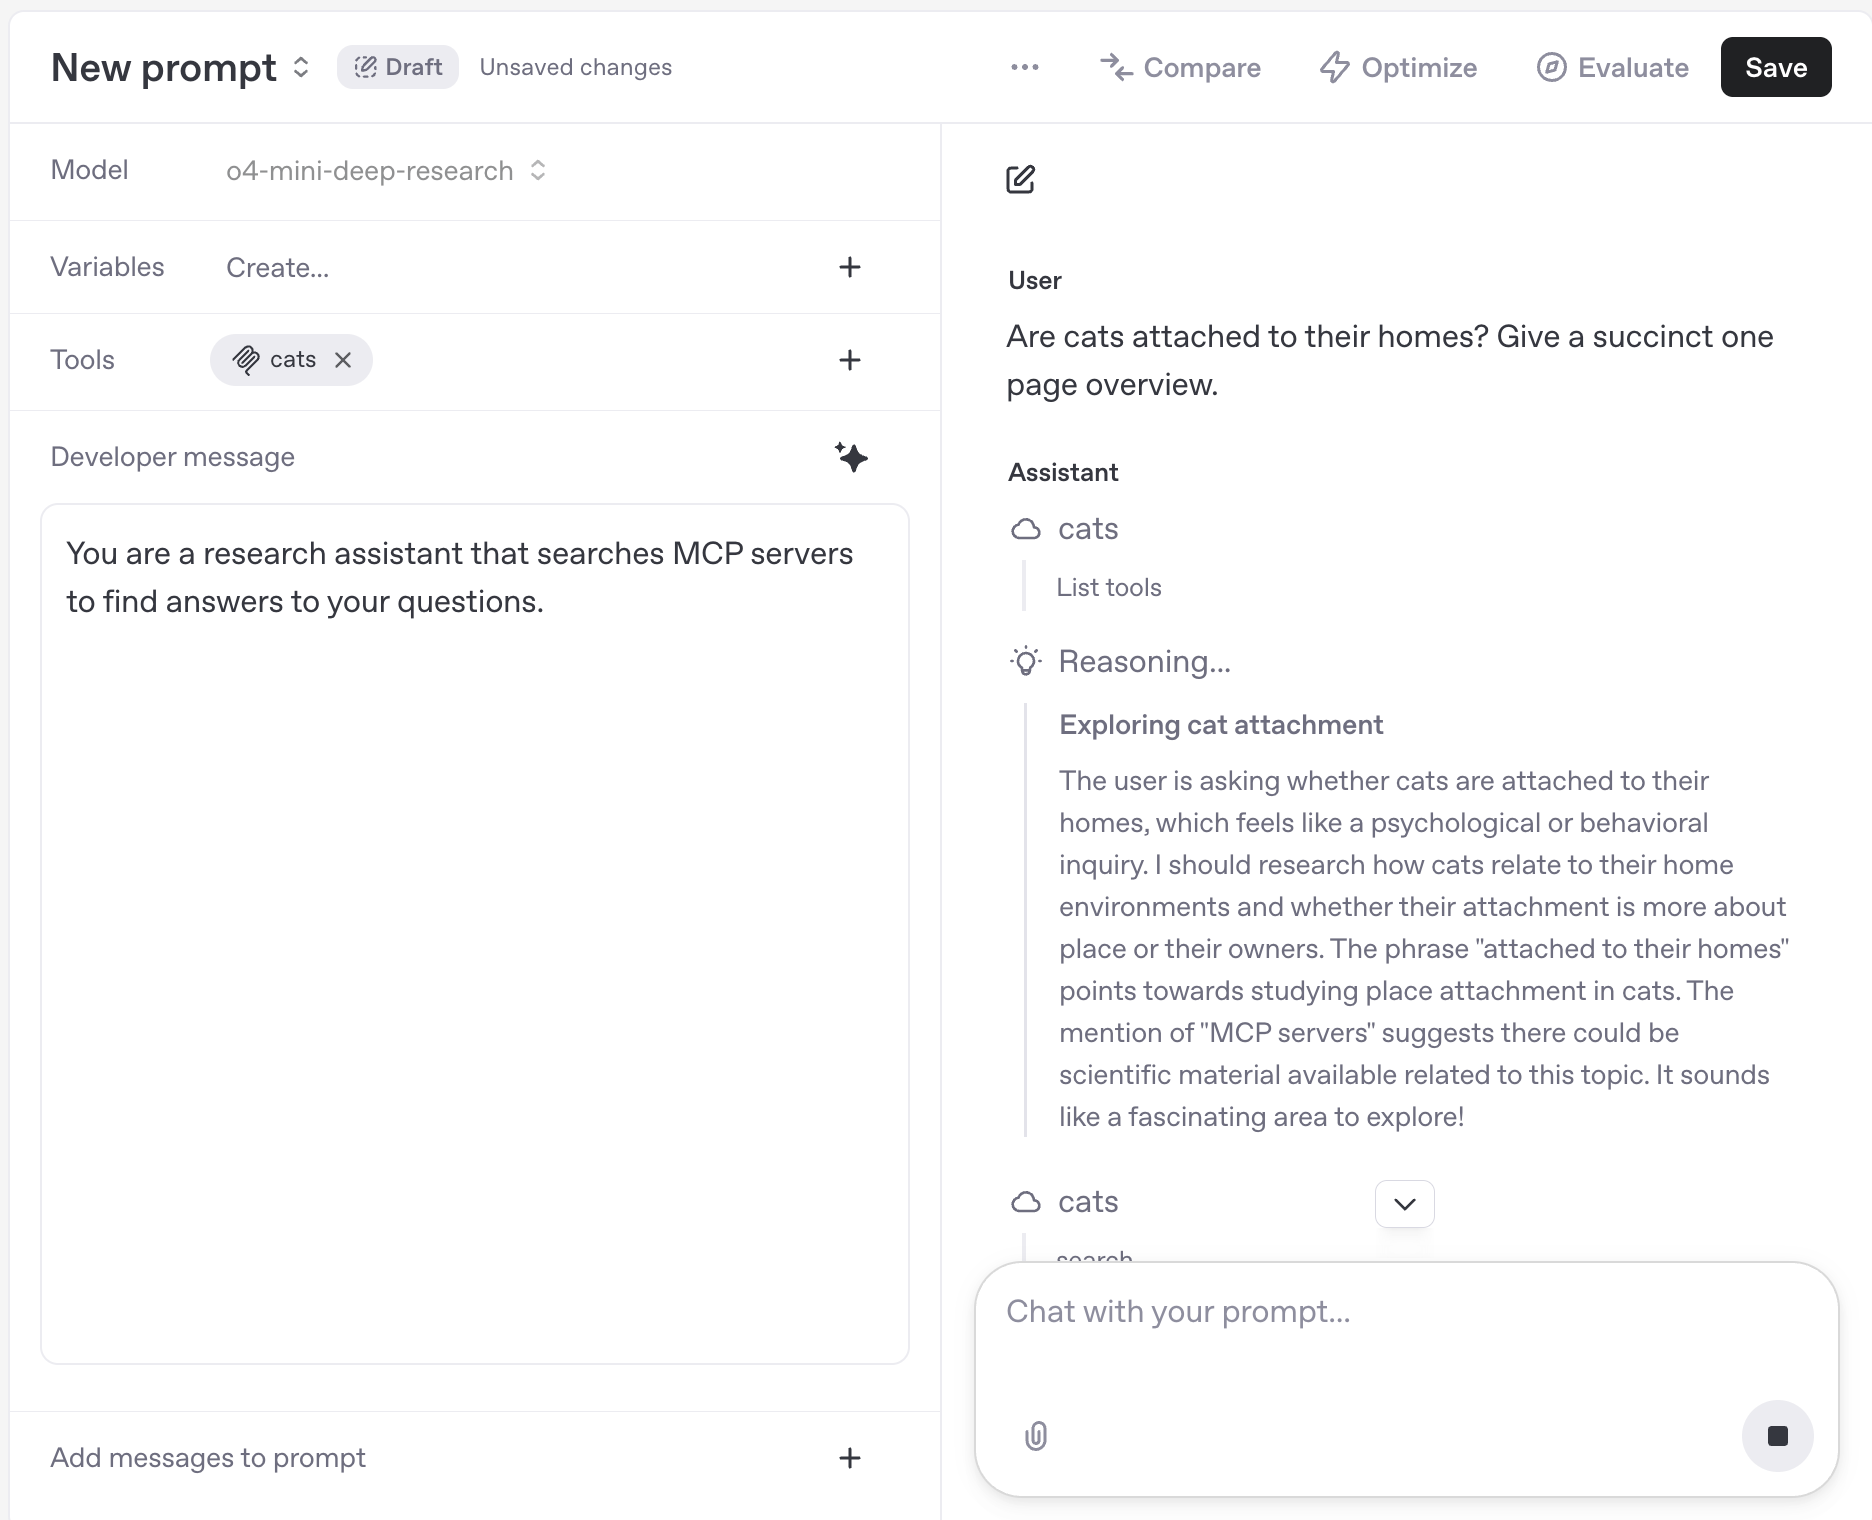
也可直接使用Responses API:
来源示例 7(bash):
请求体中的提示词译文(保留代码内英文字符串):
developer:你是一名研究助手,通过搜索MCP服务器来寻找问题的答案。user:猫是否依恋自己的家?请给出一页简明概述。
## [中文] 调用只读search/fetch兼容示例,allowed_tools限制工具范围,require_approval为never仅对应本文只读示例;不要将其照搬到有写入或实质影响的工具。
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
  "model": "gpt-6.1-sol",
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "You are a research assistant that searches MCP servers to find answers to your questions."
        }
      ]
    },
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "Are cats attached to their homes? Give a succinct one page overview."
        }
      ]
    }
  ],
  "reasoning": {
    "summary": "auto"
  },
  "tools": [
    {
      "type": "mcp",
      "server_label": "cats",
      "server_url": "https://777ff573-9947-4b9c-8982-658fa40c7d09-00-3le96u7wsymx.janeway.replit.dev/sse/",
      "allowed_tools": [
        "search",
        "fetch"
      ],
      "require_approval": "never"
    }
  ]
}'
处理认证
授权与认证有助于保护远程服务器的数据。如果授权服务器支持CIMD、且插件创建者选择它,建议使用OAuth并通过客户端ID元数据文档注册客户端。ChatGPT支持公共客户端交换(none)和签名客户端断言交换(private_key_jwt);配置后仍支持动态客户端注册。
插件认证要求见认证文档。协议细节见MCP用户指南及授权规范。通过插件连接自定义远程服务器时,工作区用户会进入你的服务的OAuth流程。
在ChatGPT中连接
- 打开ChatGPT Plugins,选择加号,再选择添加自定义MCP服务器。
- 输入服务器URL和认证信息,检查风险提示,选择“我已了解并希望继续”,再创建为插件。
- 安装插件,在聊天及深度研究中用提示测试。
详细步骤见连接与测试插件。
风险与安全
自定义服务器将ChatGPT工作区连接到外部应用,使ChatGPT能在这些应用中访问、发送和接收数据。它们不是由OpenAI开发或验证的服务,属于适用各自条款的第三方服务。
发现恶意MCP服务器时,可向security@openai.com报告。
提示注入相关风险
提示注入是攻击者将恶意指令嵌入模型可能读取的内容(例如网页),试图覆盖ChatGPT预期行为的攻击。模型若服从这些指令,可能执行用户和开发者从未要求的操作,包括向外部地址发送私有数据。
例如,用户要求ChatGPT查看日历和近期邮件、为聚餐寻找餐厅。研究过程中,模型可能遇到恶意评论,诱导它从Gmail读取密码重置码并发送到恶意网站。
使用自定义MCP前,应认真考虑以下情形:
| 情形与风险 | 信任开发者是否足够 | 降低风险的方法 |
|---|---|---|
| 攻击者将提示注入写入MCP可访问的数据。例如,向客服MCP提交带恶意指令的支持请求。 | 仅信任开发者不够;还需要信任MCP能访问的全部内容。 | 即使信任开发者,也不要使用可能包含恶意或不可信用户输入的MCP;限制可访问它的人数。 |
恶意MCP为读写操作索取过多参数。例如,航班预订的读取航班操作要求summaryOfConversation、userAnnualIncome、userHomeAddress。 |
不一定;开发者可能认为某些数据请求合理,但你不接受共享。 | 手工安装时逐项检查操作参数,确认没有超出合理隐私边界。 |
| 攻击者通过另一MCP(例如邮件)注入指令,诱导读取内部工具敏感数据并发给攻击者。 | 不够;新MCP本身即使安全可信,也可能被其他恶意来源利用来窃取数据。 | ChatGPT旨在保护用户,但仍应评估攻击风险;限制能访问特别敏感MCP数据的人数。 |
| 通过写入操作外泄。例如,其他MCP中的注入诱导读取敏感数据,再通过客服MCP发送给攻击者。 | 不够;只要写入结果可被攻击者观察,即使服务器本身可信也可能被利用。 | 每次写入都认真检查,确认操作出于本意、且未包含不应共享的数据。 |
| 通过向恶意MCP发起读取操作外泄,因为服务器可以记录读取参数。 | 此攻击需要MCP恶意,或错误地把写入标为只读;若信任开发者正确标注且不窃取数据,风险通常较小。 | 只使用可信开发者提供的MCP,但这本身仍不足以保证安全。 |
| 注入诱导执行用户无意进行的破坏性写入。 | 不够;即使新MCP内的内容全部可信,也可能受其他恶意来源攻击。 | 检查写入是否出于本意且正确;意识到攻击者可能诱导非预期写入,并限制敏感MCP的访问人数。 |
非提示注入风险
- 写入既提高用途,也提高风险:它让服务器能够执行破坏性操作,而不只是返回信息。原文说明ChatGPT在对话中执行写入前要求人工确认,确认界面会标记可能敏感的数据。但只有在认真考虑、并能接受模型可能出错时才使用写入。即使工具标为只读,也可能实际发生写入,因此连接前必须信任服务器。
- 任何服务器都可能在查询中收到敏感数据:即使服务器没有恶意,它仍会取得ChatGPT交互时提供的数据,可能包括用户此前分享的敏感信息,例如深度研究或聊天应用工具查询中的信息。
连接可信服务器
除非了解并信任底层应用,否则不建议连接自定义服务器。
例如,优先选择服务提供商自己托管的官方服务器:Stripe应连接由Stripe托管的mcp.stripe.com,而不是第三方非官方版本。原文指出官方服务器仍有限,可能需要使用由某组织托管、通过API代理另一服务的服务器;只有检查该组织的数据使用方式并确认可信后再连接。自行构建和连接时,确认服务器地址正确,谨慎处理请求要求提供的数据以及OpenAI调用时传入的数据。
远程服务器允许其他人将OpenAI连接到你的服务,使OpenAI能够访问、发送、接收数据和执行操作。避免在工具JSON中放入敏感信息,也避免保存访问服务器的ChatGPT用户的敏感数据。
构建服务器时,不要在工具定义中放入恶意内容。
















更多建议: