
 TRAE-AI编程



OpenAI 优化 LLM 准确率
如何提高 LLM 的正确性和行为一致性
优化LLM很难。OpenAI在与初创及大型企业开发者合作中,常遇到三个问题:从哪里开始提高准确率,什么时候使用哪种方法,以及达到什么程度才足以上线。
本文介绍提示词工程、检索增强生成(RAG)和微调的适用条件及常见陷阱。阅读时应联系自己的业务:生成一段需要人工修订的文案,与把100美元退款误操作成1000美元,代价完全不同。讨论准确率前,要先估计失败成本及成功带来的收益。
LLM 优化的背景
优化并非必然按“提示词→RAG→微调”线性推进。不同技术解决不同问题,应把它们看成矩阵中的不同方向。

通常先从提示词工程建立测试基线,分析错误后再选择方向:
- 上下文优化:训练时未见过的知识、过时知识或专有信息造成缺口时,补充上下文,改善回答准确性。
- LLM优化:格式不一致、语气风格不对或推理方式不稳定时,改善模型行为一致性。
实际过程是评测、提出假设、实施、再评测和重新判断。例如:
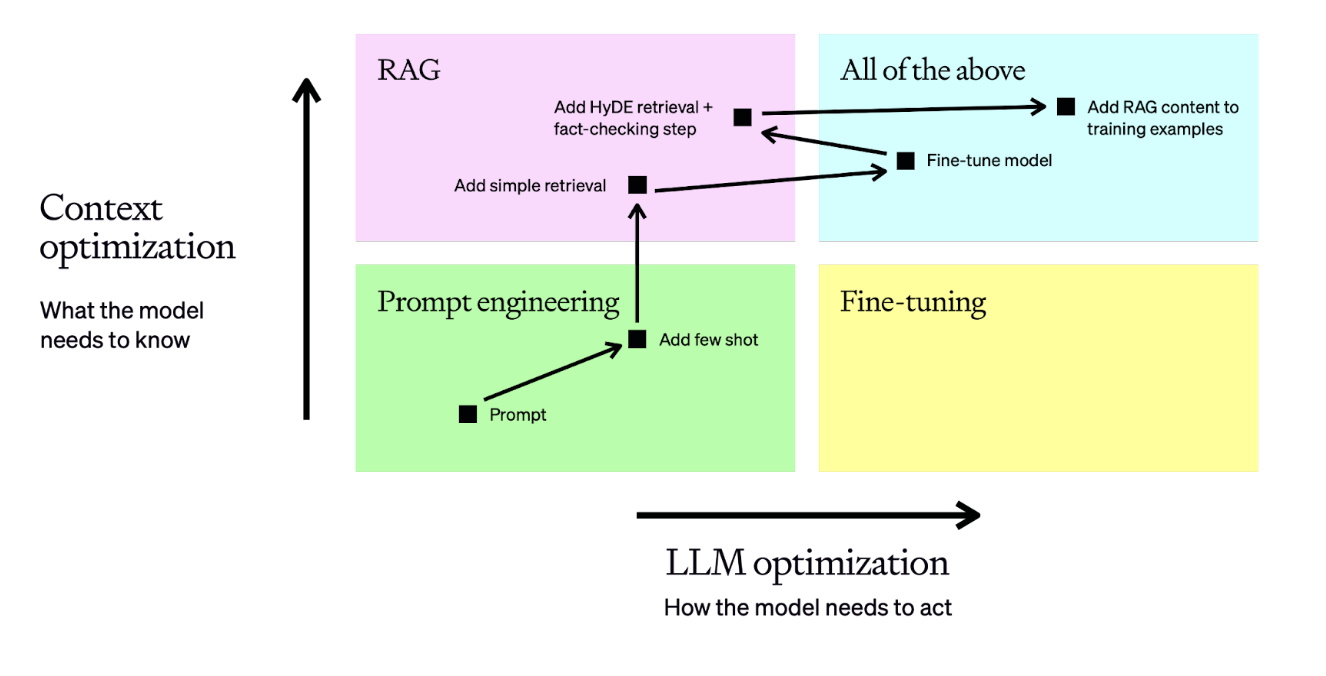
先评测基本提示词;加入静态少样本示例;根据问题动态检索相关示例;准备50条以上样例进行微调;调整检索并加入事实核查;最后用包含改进后RAG输入的新样例重新训练。这一路径帮助区分缺少相关上下文与缺少稳定行为,再决定下一步。
提示词工程
通常应从提示词工程开始。摘要、翻译、代码生成等任务,有时零样本提示就能达到所需准确率和一致性。它迫使你先定义“正确”:从简单输入与预期输出开始,根据不符合预期的原因,逐步加入上下文、指令或示例。
优化
提示词工程指南中的策略可分别优化上下文、模型行为或两者:
| 策略 | 上下文优化 | 行为优化 |
|---|---|---|
| 清晰指令 | 是 | |
| 复杂任务拆分 | 是 | 是 |
| 给模型思考时间 | 是 | |
| 系统地测试变更 | 是 | 是 |
| 提供参考文本 | 是 | |
| 使用外部工具 | 是 |
下面保留来源使用GPT-4 Turbo纠正冰岛语句子的历史实验,不将旧型号作为当前模型推荐。
语言纠错的提示词工程
冰岛语错误语料库提供含错句和正确版本。任务是尽量少改词,输出纠正后的句子,用BLEU比较相对质量。
| 项目 | 原实验内容 |
|---|---|
| 系统要求的中文含义 | 以下冰岛语句子可能包含错误,请尽量少改词进行纠正 |
| 用户句子 | Sörvistölur eru nær hálsi og skartgripir kvenna á brjótsti. |
| 标准答案 | Sörvistölur eru nær hálsi og skartgripir kvenna á brjósti. |
| 助手回答 | Sörvistölur eru nær hálsi og skartgripir kvenna á brjósti. |
| 此条BLEU | 1.0 |
原实验GPT-4零样本整体BLEU为62,加入少样本示例:
来源示例 1(example-chat):
SYSTEM: The following sentences contain Icelandic sentences which may include errors. Please correct these errors using as few word changes as possible.

## Examples
USER: "Stofnendurnir séu margir og eru fulltrúar hennar frá Englandi, Grikklandi, Rússlandi, Svíþjóð og fleiri löndum Evrópu."
ASSISTANT: "Hann segir að stofnendur leynireglunnar séu margir og að fulltrúar hennar séu frá Englandi, Grikklandi, Rússlandi, Svíþjóð og fleiri löndum Evrópu."

USER: "Helsta fæða bjúgorma eru hægfara lífverur sem eru á sama búsvæði og bjúgormarnir, oft smærri ormar eins og burstormar (fræðiheiti: Polychatete)."
ASSISTANT: "Helsta fæða bjúgorma eru hægfara lífverur sem eru á sama búsvæði og bjúgormarnir, oft smærri ormar eins og burstaormar (fræðiheiti: Polychatete)."

USER: "Sörvistölur eru nær hálsi og skartgripir kvenna á brjótsti."
ASSISTANT: "Sörvistölur eru nær hálsi og skartgripir kvenna á brjósti."

USER: [input user query here]
整体BLEU提高至70。来源写作“+8%”,这里两分数相差8分,应避免混同相对增幅。这说明示范有帮助,模型可能已有相关知识,主要需要优化行为。后面将继续检验这一假设。
提示词工程也有扩展限制:可能需要动态上下文,或少样本不足以达到稳定行为。长上下文能容纳更多信息,但复杂长提示可能发生中间信息丢失,即模型无法对所有位置保持同等注意。应在不同长度上评测。Greg Kamradt的大海捞针测试将信息放到长文不同位置测试检索,说明“全部塞入上下文”也可能付出准确率代价。
当提示词不再足够时,先根据评测选择下一种方法。
评测
本阶段应形成有效提示词,以及包含问题和标准答案的评测集。有20条以上问答、详细的失败分析和可检验假设,就有了进入高级优化的基线。
可自动化以加快迭代:ROUGE、BERTScore适合快速估计输出变化,但未必与人工高度相关;G-Eval论文使用GPT-4作为评估器,通过评分表尽量客观判断。实践见摘要评测Cookbook。
理解工具
提示词与评测集建立后,先诊断失败位置,再选工具。
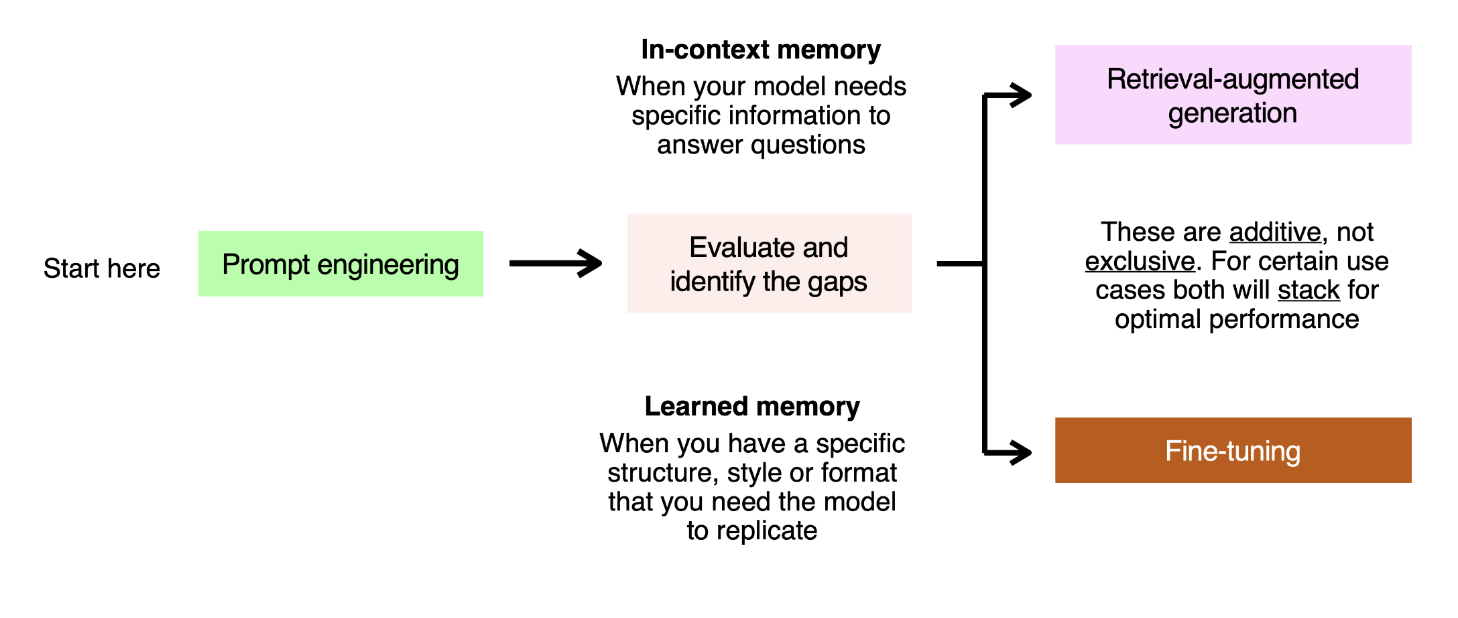
可以类比考试:上课半年、通过反复样例学会概念,是“已学习的记忆”,对应通过训练学习提示词和回答;带教材现场查找,是“上下文记忆”,对应静态附加资料或用RAG动态检索。两者可以叠加。先看上下文问题的处理方式。
检索增强生成(RAG)
RAG先检索(Retrieve),再增强(Augment)模型提示词,最后生成(Generate)回答,为任务提供领域上下文。来源说明OpenAI许多大型客户部署仅靠提示词工程与RAG完成。
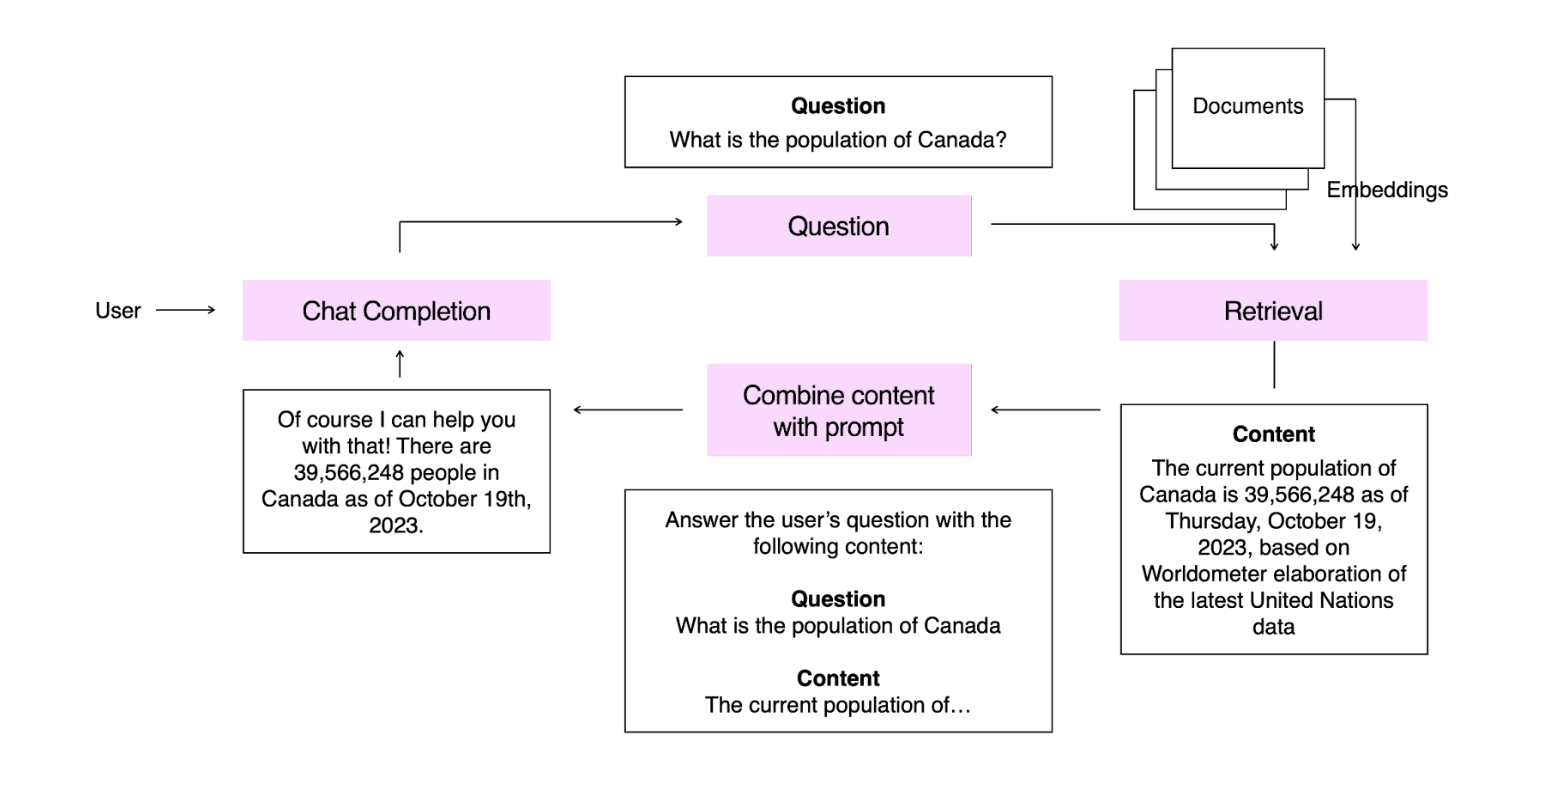
示例将统计知识库嵌入;用户提问后嵌入查询、检索相关内容,再交给模型。新增的检索环节也要评测:既要找到正确上下文,也要确认模型正确使用。
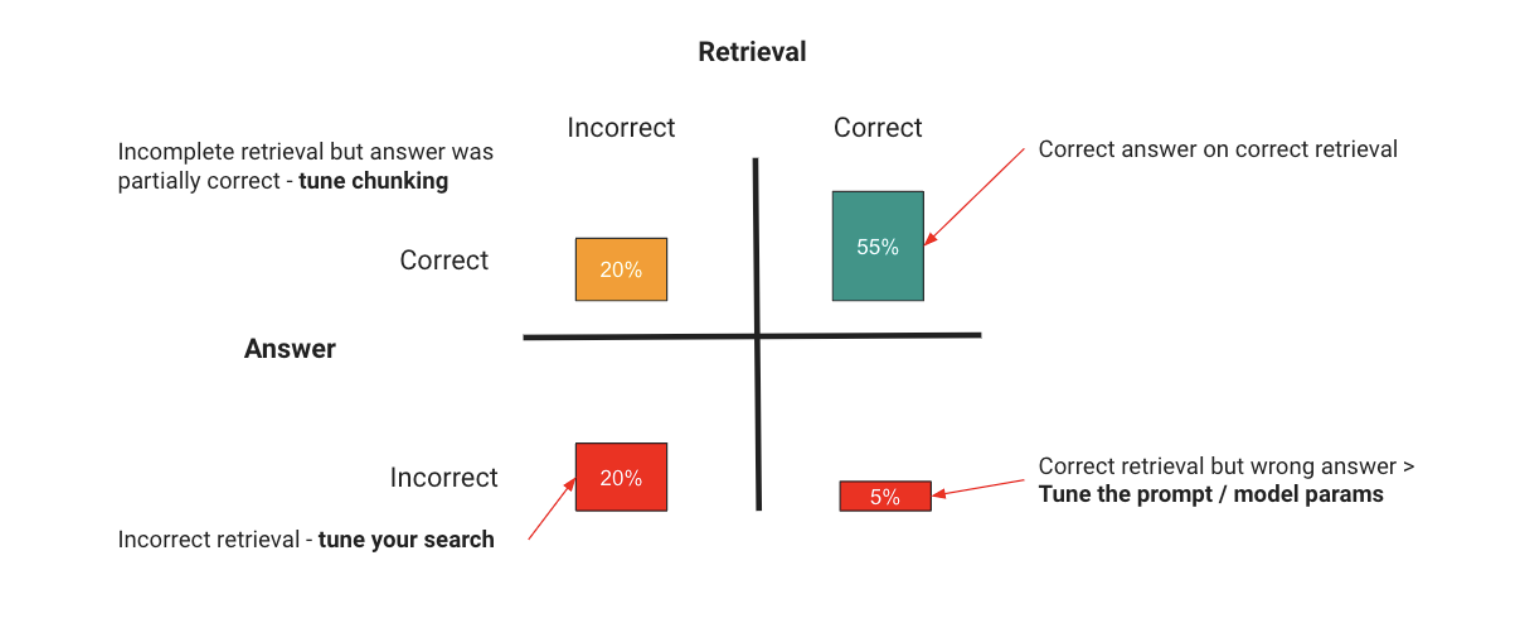
| 环节 | 问题 | 改进方向 |
|---|---|---|
| 检索 | 上下文错误,或无关内容过多淹没有效信息并造成幻觉 | 调整搜索相关性、减少噪声、增加每条结果所需信息;LlamaIndex、LangChain等提供多种方法 |
| LLM | 上下文正确但使用方式错误 | 改进指令和处理方法;若示例有效,再考虑微调 |
原则仍是先评测定位再修复,只是新增检索维度。RAG解决上下文学习问题;若需要模型稳定学会某项行为,则考虑微调。
微调
用较小领域数据继续训练,通常为提高特定任务准确率,或以更少词元、更小模型保持同等准确率。
最关键的是准备能准确代表真实输入的样例。可在试点中广泛记录输入输出,筛选为真实训练集,来源称其为“prompt baking”。
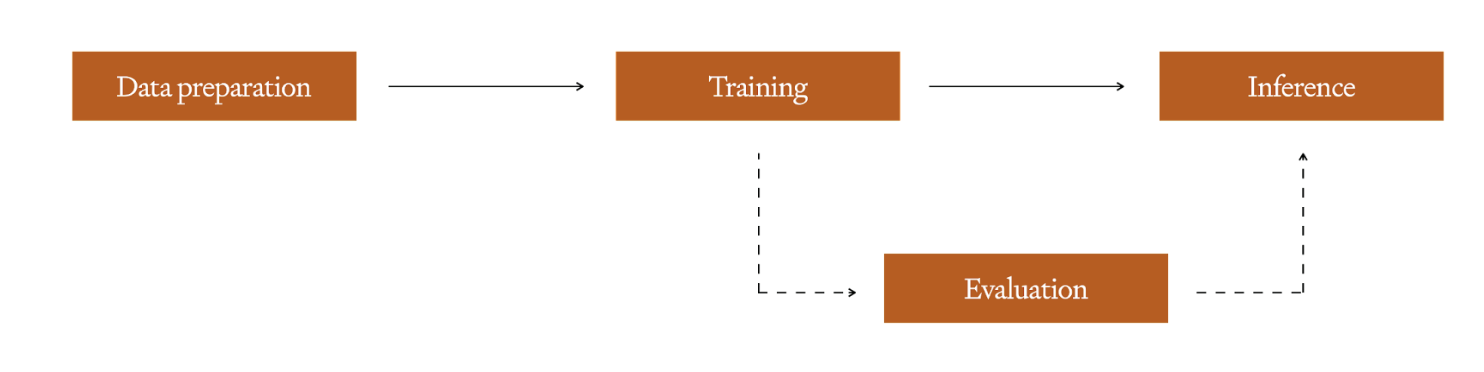
清理后启动训练,按平台或框架调整超参数。务必留出独立评测集识别过拟合,参考微调数据指导。训练完成后模型可用于推理,平台实际可用性仍以当前退出时间表为准。
主要实践:先用提示词工程取得可靠评测基线;从50条以上高质量样例开始,不足时再扩充,且先确认错误属于行为而非上下文;训练样例应代表生产格式,例如RAG应用应使用带RAG上下文的样例训练,避免让模型推理时首次学习如何使用资料。
组合以上方法
若同时有上下文与行为问题,可组合微调与RAG:用大量训练样例减少每次请求的指令和少样本词元;通过微调学习复杂行为;用RAG注入最新或专门知识。
用这些工具改进语言任务
继续冰岛语纠错案例:首先根据行为优化假设,分别微调GPT-3.5 Turbo与GPT-4;同时试验相关检索样例是否有助于上下文学习,但对后者的信心较低。
微调
采用与前述少样本类似的1000条训练数据:
来源示例 2(example-chat):
## One training example
SYSTEM: The following sentences contain Icelandic sentences which may include errors. Please correct these errors using as few word changes as possible.
USER: "Hið sameinaða fyrirtæki verður einn af stærstu bílaframleiðendum í heiminum."
ASSISTANT: "Hið sameinaða fyrirtæki verður einn af stærstu bílaframleiðendum heims."
对两个模型训练,再在验证集评测。结果支持原假设:
| 运行 | 方法 | BLEU |
|---|---|---|
| 1 | GPT-4零样本 | 62 |
| 2 | GPT-4加3条少样本 | 70 |
| 3 | GPT-3.5 Turbo用1000条微调 | 78 |
| 4 | GPT-4用1000条微调 | 87 |
来源据此认为已接近该用例上线需要;继续加入检索测试是否还能提高。
RAG与微调结合
从训练和验证集之外再取1000条,嵌入后存入向量库,用于微调GPT-4的检索上下文。
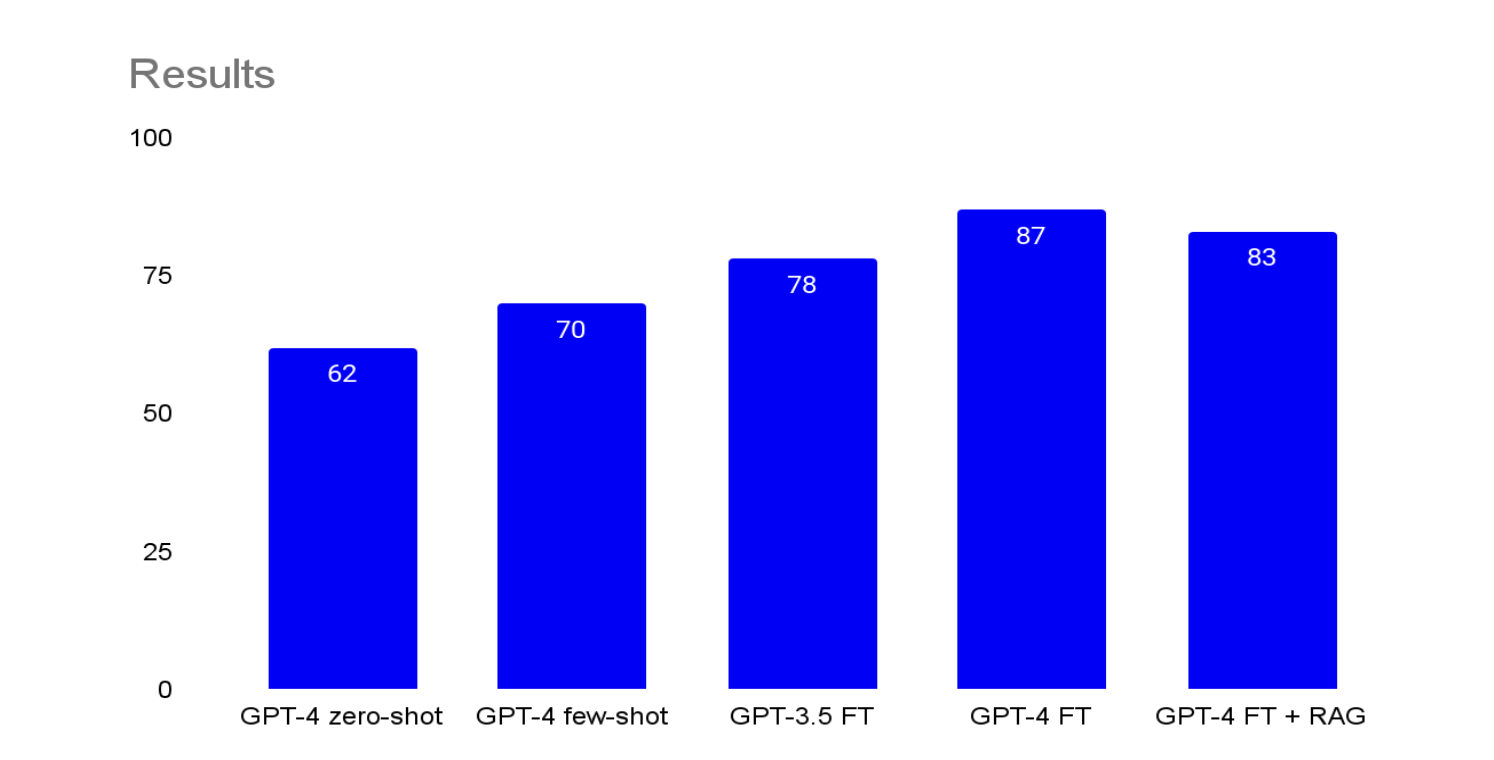
结果反而下降4分至83。模型已通过微调掌握行为,额外检索内容增加了噪声。这说明每种方法都有收益和风险,应通过评测选适合的工具;继续改进可考虑更丰富、更多训练样例。
引入RAG后需同时优化检索与模型行为;微调则需重新训练并管理训练、验证集。两者都会减慢迭代、增加复杂性和回归风险。应先尽量用基础方法达到目标,再按需要增加技术复杂度。
上线需要多高准确率
准确率优化可能没有终点,常规方法难以保证99.999%。关键是决定何时足够,以及怎样控制上线风险。可分别从业务和技术判断。
业务
开放且不可预测的错误比规则系统更难管理。来源客服案例先为主要成功、失败类型估算成本:AI替代人工解决一案节省20美元;不必要转人工每案成本40美元;最坏的流失每案损失1000美元,假定占失败案例5%。
| 事件 | 每案价值(美元) | 案例数 | 成本或收益绝对额(美元) |
|---|---|---|---|
| AI成功 | +20 | 815 | 16,300 |
| AI失败:转人工 | -40 | 175.75 | 7,030 |
| AI失败:流失 | -1000 | 9.25 | 9,250 |
| 净结果 | +20 | ||
| 来源示例盈亏平衡准确率 | 81.5% |
同时比较纯人工与AI交互的客户满意度、回顾审核的决策准确率及解决时间。来源试点得到两项决定:即使转人工偏多,只要大部分错误是尽早升级,85%准确率仍可能带来明显运营节约;欺诈等失败代价极高的任务则由人工主导,AI辅助,不采用全自动。
技术
业务明确收益和失败成本后,技术实现应让失败以可恢复方式发生。假设意图准确率为85%,可通过追问更多信息,增加第二次判断机会;让二线助手退回意图识别阶段以自我修复;意图不清时转人工。
这些方式可能增加延迟、降低即时解决率或节约金额,但提高整体准确性、减少长期流失。将交互设计与业务成本模型结合,才能制定符合现实的目标。
后续实践
这套框架用于选择准确率优化工具和上线标准。更多实践见Morgan Stanley与Klarna案例。文中的旧模型、BLEU实验和成本数字均是来源案例,不构成当前模型能力或业务收益保证。
















更多建议: