
 TRAE-AI编程



OpenAI 延迟优化
本页把来自生产应用的延迟优化方法归为七条原则,适用于细粒度工作流到完整聊天应用。末尾用假设客服机器人演示取舍;并非每个应用都要使用所有方法。
七条原则
更快地处理词元
推理速度是模型处理词元的速率,常用TPM或TPS衡量。模型大小是主要因素:较小模型通常更快、更便宜,正确使用时也可能在具体任务上超过大模型。可通过更详细的提示词、更多少样本示例、微调或蒸馏维持效果。
大部分输出已知时,例如代码编辑,可用预测输出,让模型关注变化部分。硬件、可用计算量及运行引擎的饱和度也影响速度;可控基础设施下更快硬件、降低饱和或其他推理优化可能有益,但超出本页范围。
生成更少词元
生成通常是耗时最大环节。来源经验是输出减少50%,延迟可能约减少50%,并非所有请求的保证。自然语言可要求少于20个词或简洁作答,用少样本/微调训练短输出;结构化结果可缩短函数/字段名、减少不必要命名参数、合并参数。适用接口还可用max_tokens或stop_tokens提前结束,但需核对模型与端点支持。
减少输入词元
输入减半通常仅带来约1%—5%延迟改善;除超长文档/图像等大上下文外,可优先优化其他环节。大上下文可微调以减少长指令/示例,筛选RAG结果、清理HTML;把固定前缀放前、动态RAG和历史放后,改善KV缓存复用。更多见提示缓存。
减少请求
每次调用都有网络往返成本。多个顺序步骤可尝试合并提示词,一次输出全部结果;将步骤编号并返回具名JSON字段,便于解析和引用,同时减少多响应处理复杂性。
并行处理
无严格依赖的步骤可并发执行。即使顺序依赖,也可对高概率分类分支使用推测执行:例如同时启动输入审核与故事生成,检查审核结果,不符合预期时取消生成并按需重试;预测正确时可节省等待。应按应用规则控制未经审核结果的展示。
减少用户等待
让用户看到进展与空等不同:流式尽早展示;需要审核/翻译等后处理时按块处理再发送前端;展示实际步骤和工具进度;使用加载状态、进度条。进度提示主要改善感受,流式/分块还可使用户更早开始和完成阅读。来源称流式可将等待缩至约一秒或更少,这属于示例体验,不是延迟承诺。
不要默认使用大语言模型
输出高度固定的动作确认、拒绝或标准输入提示可硬编码并准备多个文案;输入范围有限时可预计算候选回复,避免同用户重复;统计指标、报告、搜索结果可能更适合专门UI。二分搜索、缓存、哈希表和复杂度优化仍适用于LLM应用。
示例
以下是假设客服系统,灵感来自生产架构,使用源文的GPT-4/GPT-3.5作历史示例,不代表当前模型推荐或已经运行的实测。
架构与提示词
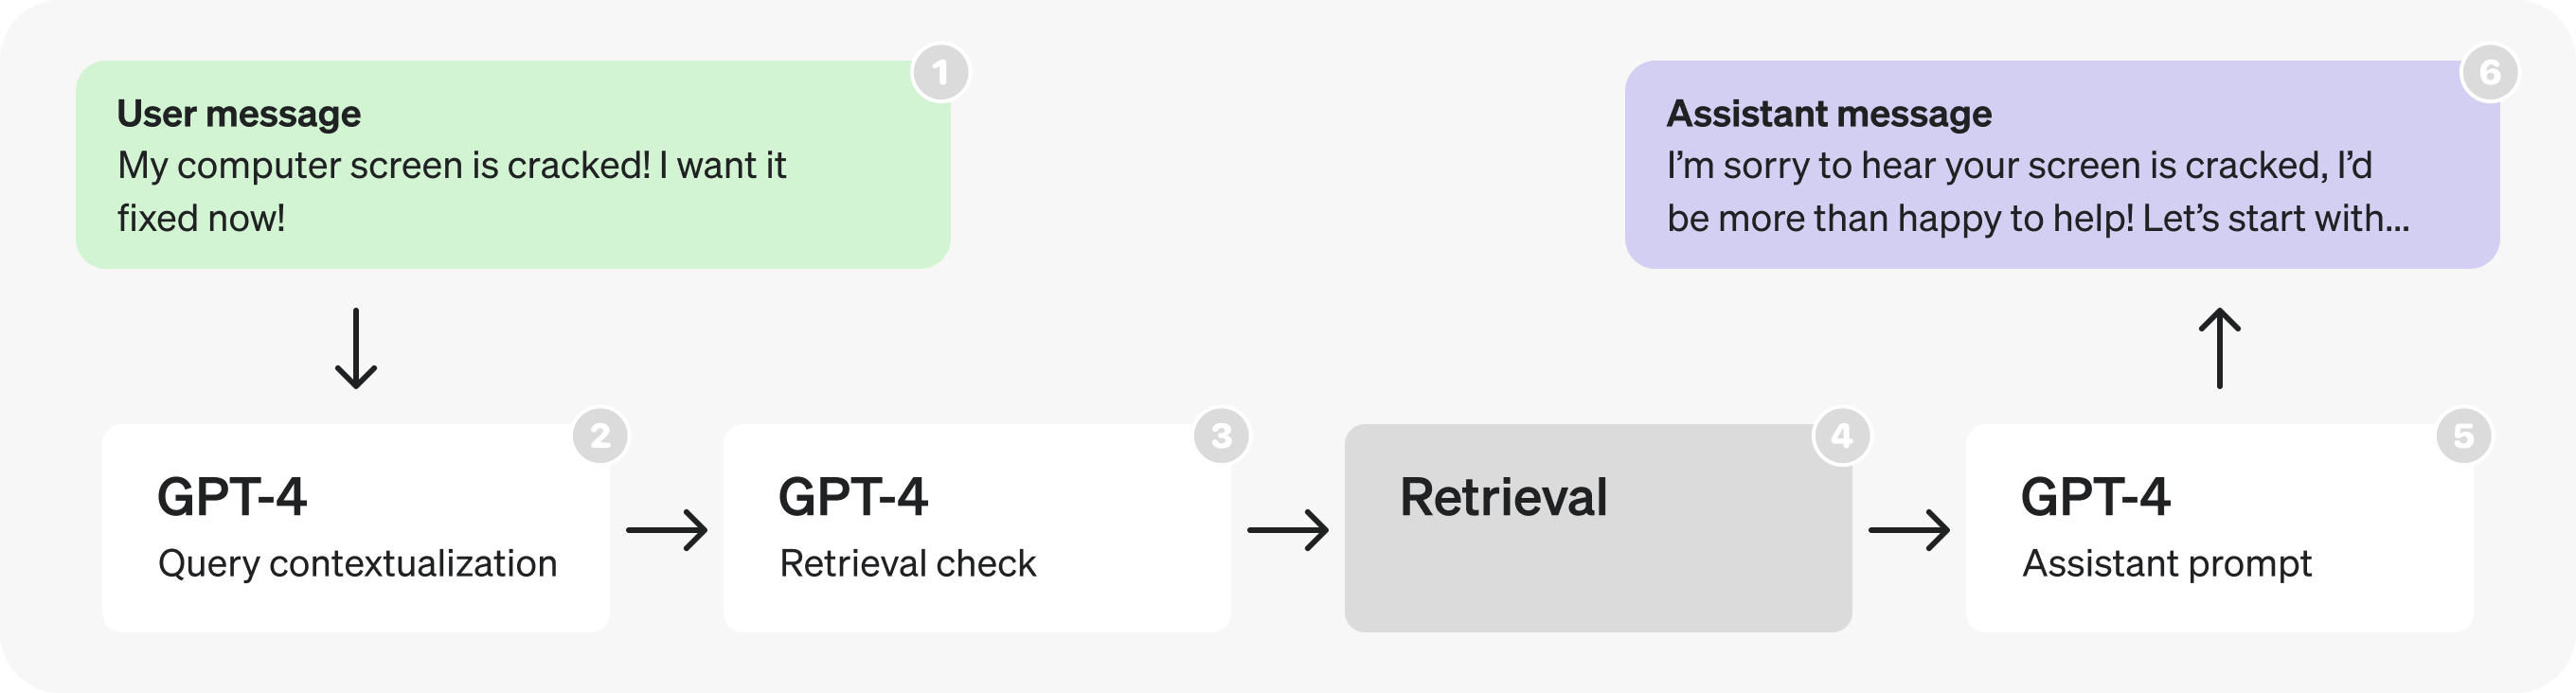
流程:用户发来会话消息 → 将最后问题改写为完整独立查询 → 判断是否需要检索 → 检索得到资料 → 助手结合查询和资料组织回答 → 返回用户。以下提示词是简化示例;方括号占位符在运行时替换为真实数据。
查询上下文化提示词
结合历史将用户最后问题改成自包含搜索查询。
来源示例 1(example-chat):
系统指令:结合先前会话,改写最后一个用户问题,使其包含全部必要上下文。例:历史用户问“退货政策是什么”,后续问“有效期多久”,应改写为“退货政策的有效期多久”。运行时传入最近3条消息、最后用户问题,并以JSON会话替换占位符。
SYSTEM: Given the previous conversation, re-write the last user query so it contains
all necessary context.

## Example
History: [{user: "What is your return policy?"},{assistant: "..."}]
User Query: "How long does it cover?"
Response: "How long does the return policy cover?"

## Conversation
[last 3 messages of conversation]

## User Query
[last user query]

USER: [JSON-formatted input conversation here]
检索判断提示词
判断该问题是否需要实时检索才能回答。
来源示例 2(example-chat):
系统指令:判断用户查询是否需要实时查找资料才能回答。例:“30天后如何退货”返回true;“谢谢”返回false。用户位置替换为实际输入查询。
SYSTEM: Given a user query, determine whether it requires doing a realtime lookup to
respond to.

## Examples
User Query: "How can I return this item after 30 days?"
Response: "true"

User Query: "Thank you!"
Response: "false"

USER: [input user query here]
助手提示词
根据会话与检索资料,按预设JSON字段分析再给出最终答复。
来源示例 3(example-chat):
系统指令:你是有帮助的客服机器人,使用检索上下文,按结果JSON分析用户查询。例:用户愤怒表示电脑屏幕破裂、要求立即修理;依次填写是否延续会话True、消息数1、情绪Aggravated(恼怒)、类型Hardware Issue(硬件问题)、语气Validating and solution-oriented(理解感受并面向解决)、要求Propose options for repair or replacement(提出维修/换货选项)、是否要求人工False、上下文信息是否足够True、最终response。用户输入还包含相关检索信息与实际查询。布尔样式字符串及字段名按原示例保留。
SYSTEM: You are a helpful customer service bot.

Use the result JSON to reason about each user query - use the retrieved context.

## Example

User: "My computer screen is cracked! I want it fixed now!!!"

Assistant Response:
{
  "message_is_conversation_continuation": "True",
  "number_of_messages_in_conversation_so_far": "1",
  "user_sentiment": "Aggravated",
  "query_type": "Hardware Issue",
  "response_tone": "Validating and solution-oriented",
  "response_requirements": "Propose options for repair or replacement.",
  "user_requesting_to_talk_to_human": "False",
  "enough_information_in_context": "True",
  "response": "..."
}

USER: # Relevant Information
` ` `
[retrieved context]
` ` `

USER: [input user query here]
分析与优化
第一部分:检索提示词
连续调用GPT-4可能低效,可考虑合并或并行。
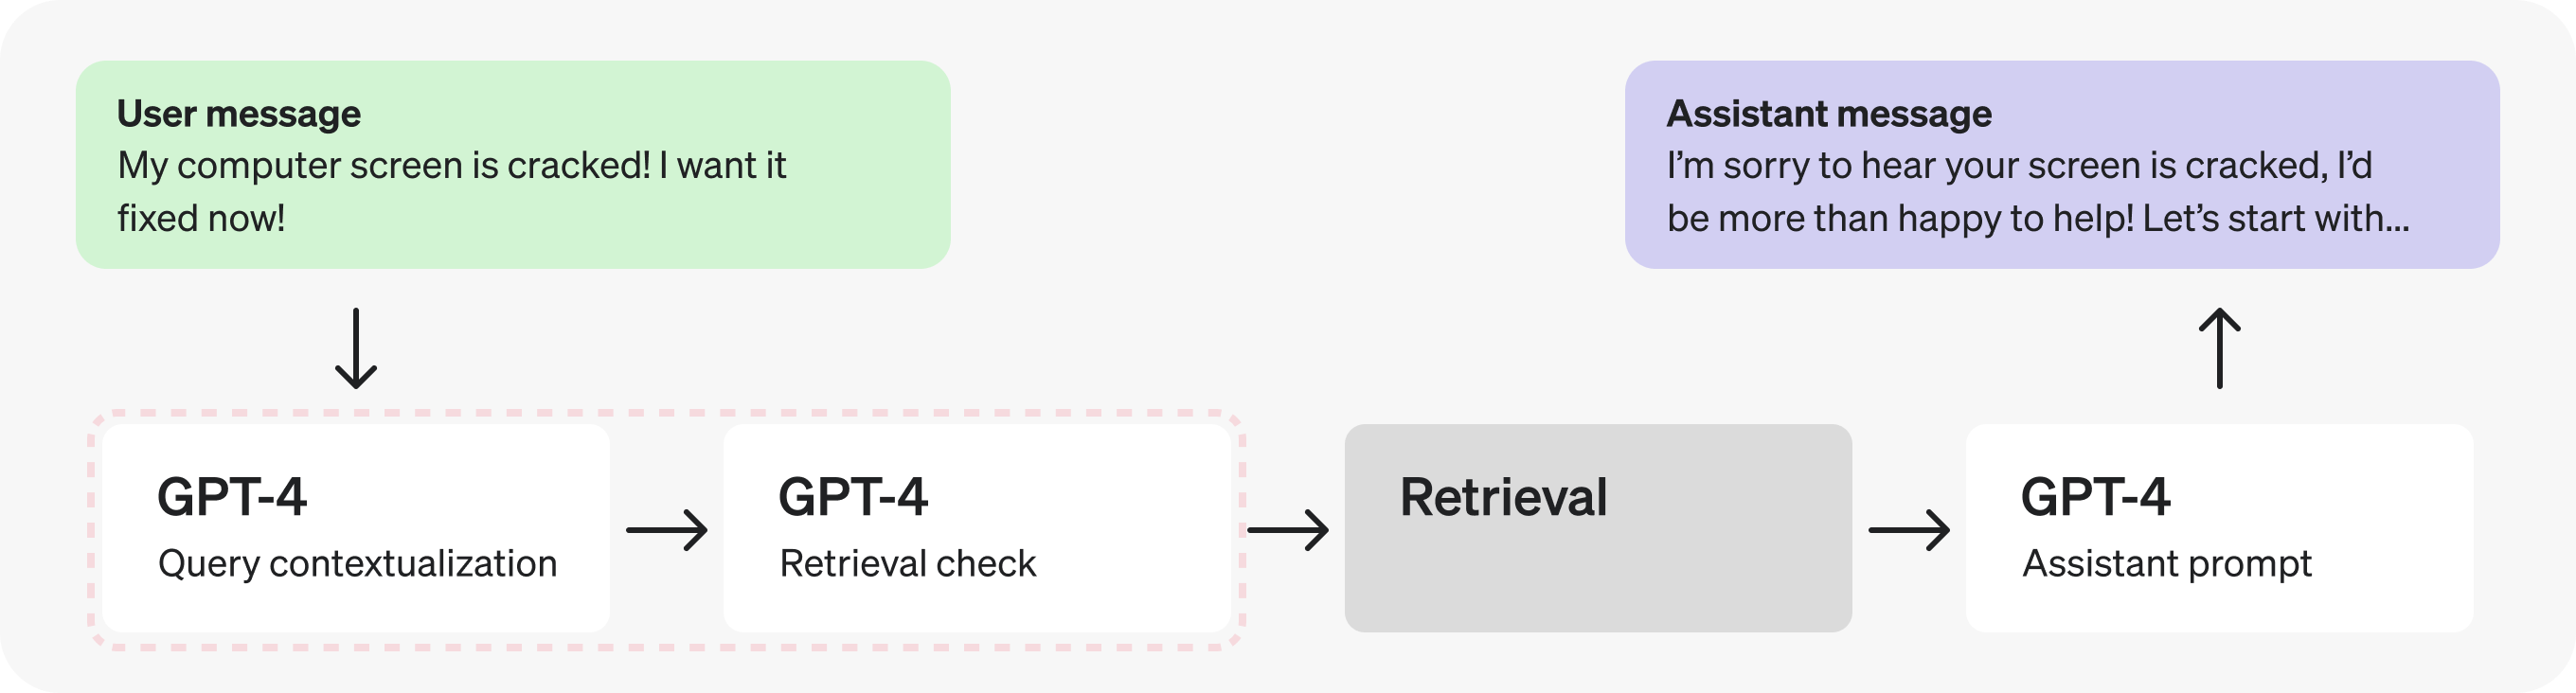
检索判断依赖上下文化结果,因此先合并为同一提示词,减少请求。
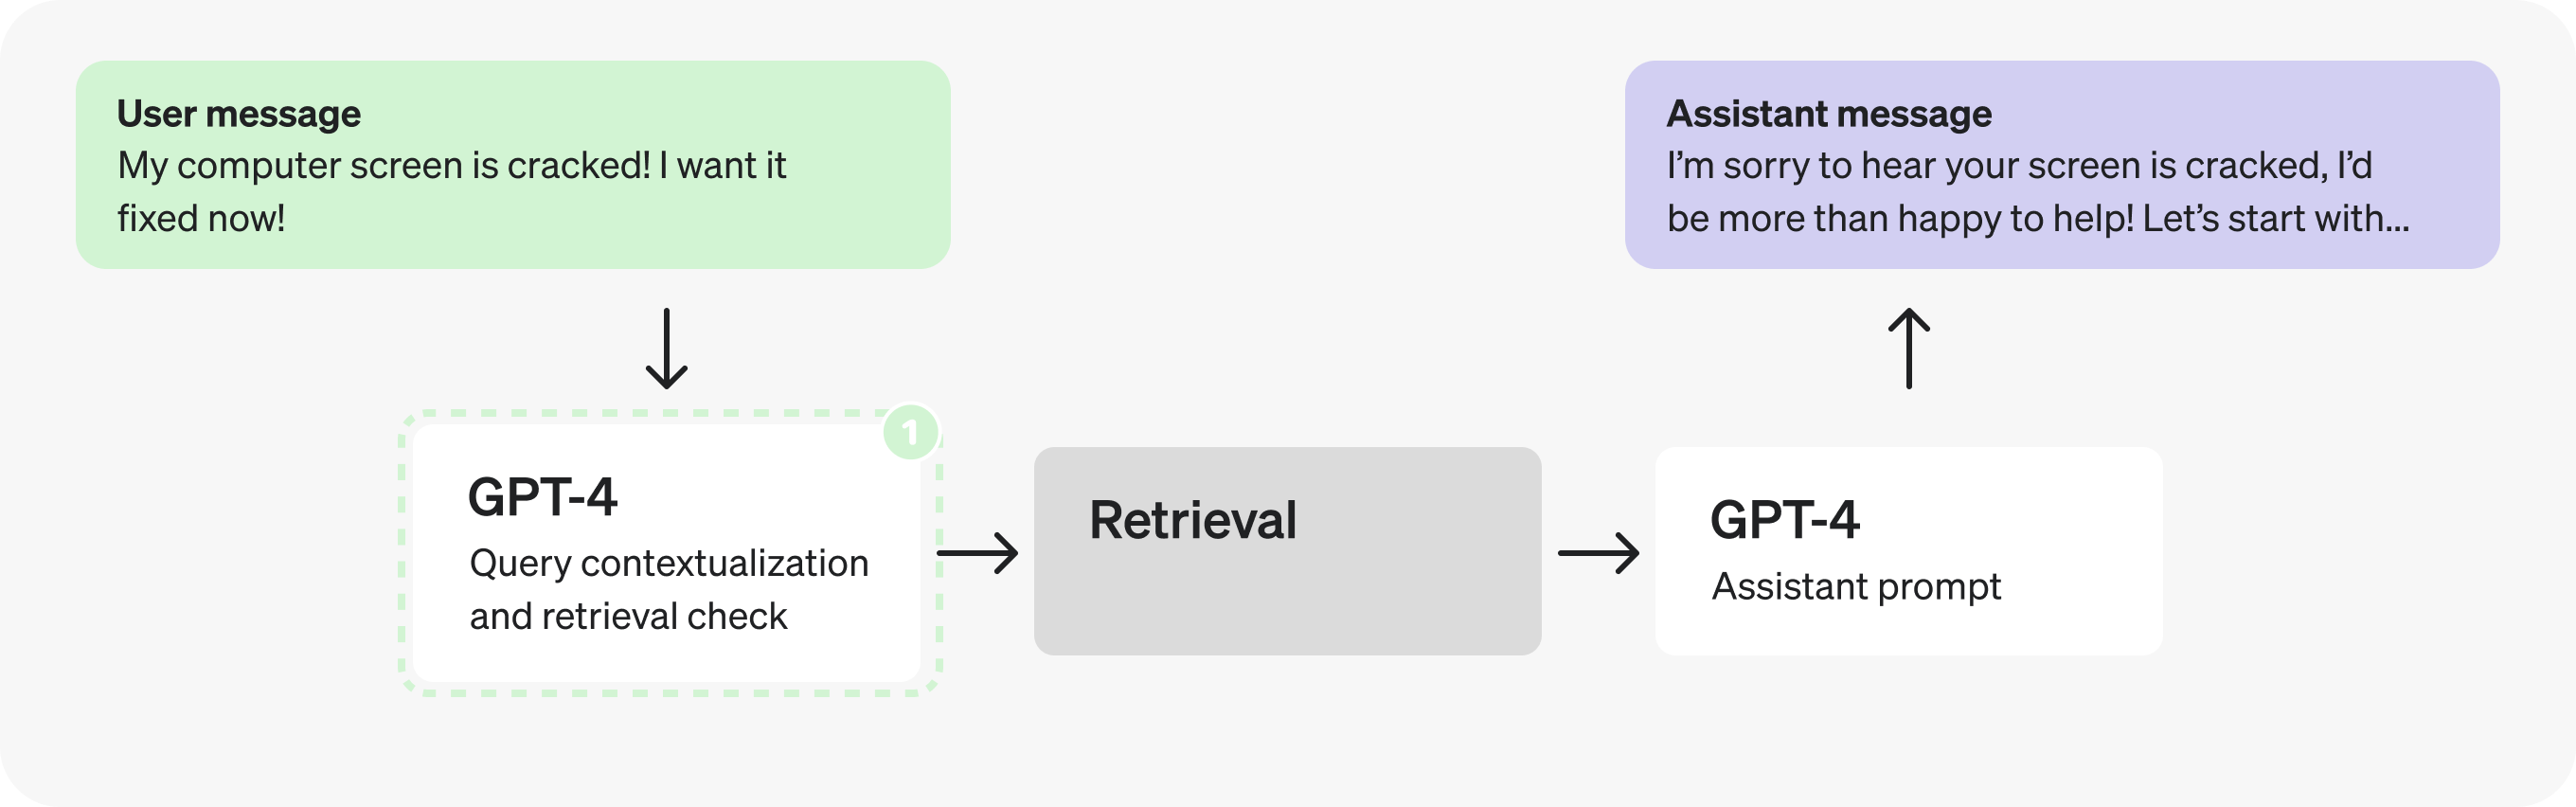
合并上下文化与检索判断
原本一条改写、一条判断;现在同一提示词完成两项,并调整首行指令及输出对象:
来源示例 4(javascript):
// [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
{
  query: "[contextualized query]",
  retrieval: "[true/false - whether retrieval is required]",
}
来源示例 5(ruby):
## [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
combined_query = {
  query: "[contextualized query]",
  retrieval: "[true/false - whether retrieval is required]"
}

puts(combined_query)
来源示例 6(example-chat):
系统指令:结合历史将最后问题改写为自包含查询,再判断完整请求是否需实时查找。输出query(改写后的查询)、retrieval(是否需检索)。例一:退货政策历史中追问有效期,返回完整有效期查询及true;例二:退货咨询后说“谢谢”,返回“谢谢”及false。运行时传入最近3条消息、最后问题及JSON会话。源文展示的对象是提示词格式示意,不是严格JSON请求。
SYSTEM: Given the previous conversation, re-write the last user query so it contains
all necessary context. Then, determine whether the full request requires doing a
realtime lookup to respond to.

Respond in the following form:
{
  query:"[contextualized query]",
  retrieval:"[true/false - whether retrieval is required]"
}

## Examples

History: [{user: "What is your return policy?"},{assistant: "..."}]
User Query: "How long does it cover?"
Response: {query: "How long does the return policy cover?", retrieval: "true"}

History: [{user: "How can I return this item after 30 days?"},{assistant: "..."}]
User Query: "Thank you!"
Response: {query: "Thank you!", retrieval: "false"}

## Conversation
[last 3 messages of conversation]

## User Query
[last user query]

USER: [JSON-formatted input conversation here]
两项均明确且范围有限,可考虑用较小的微调模型;源示例改为GPT-3.5,以提高处理速度。
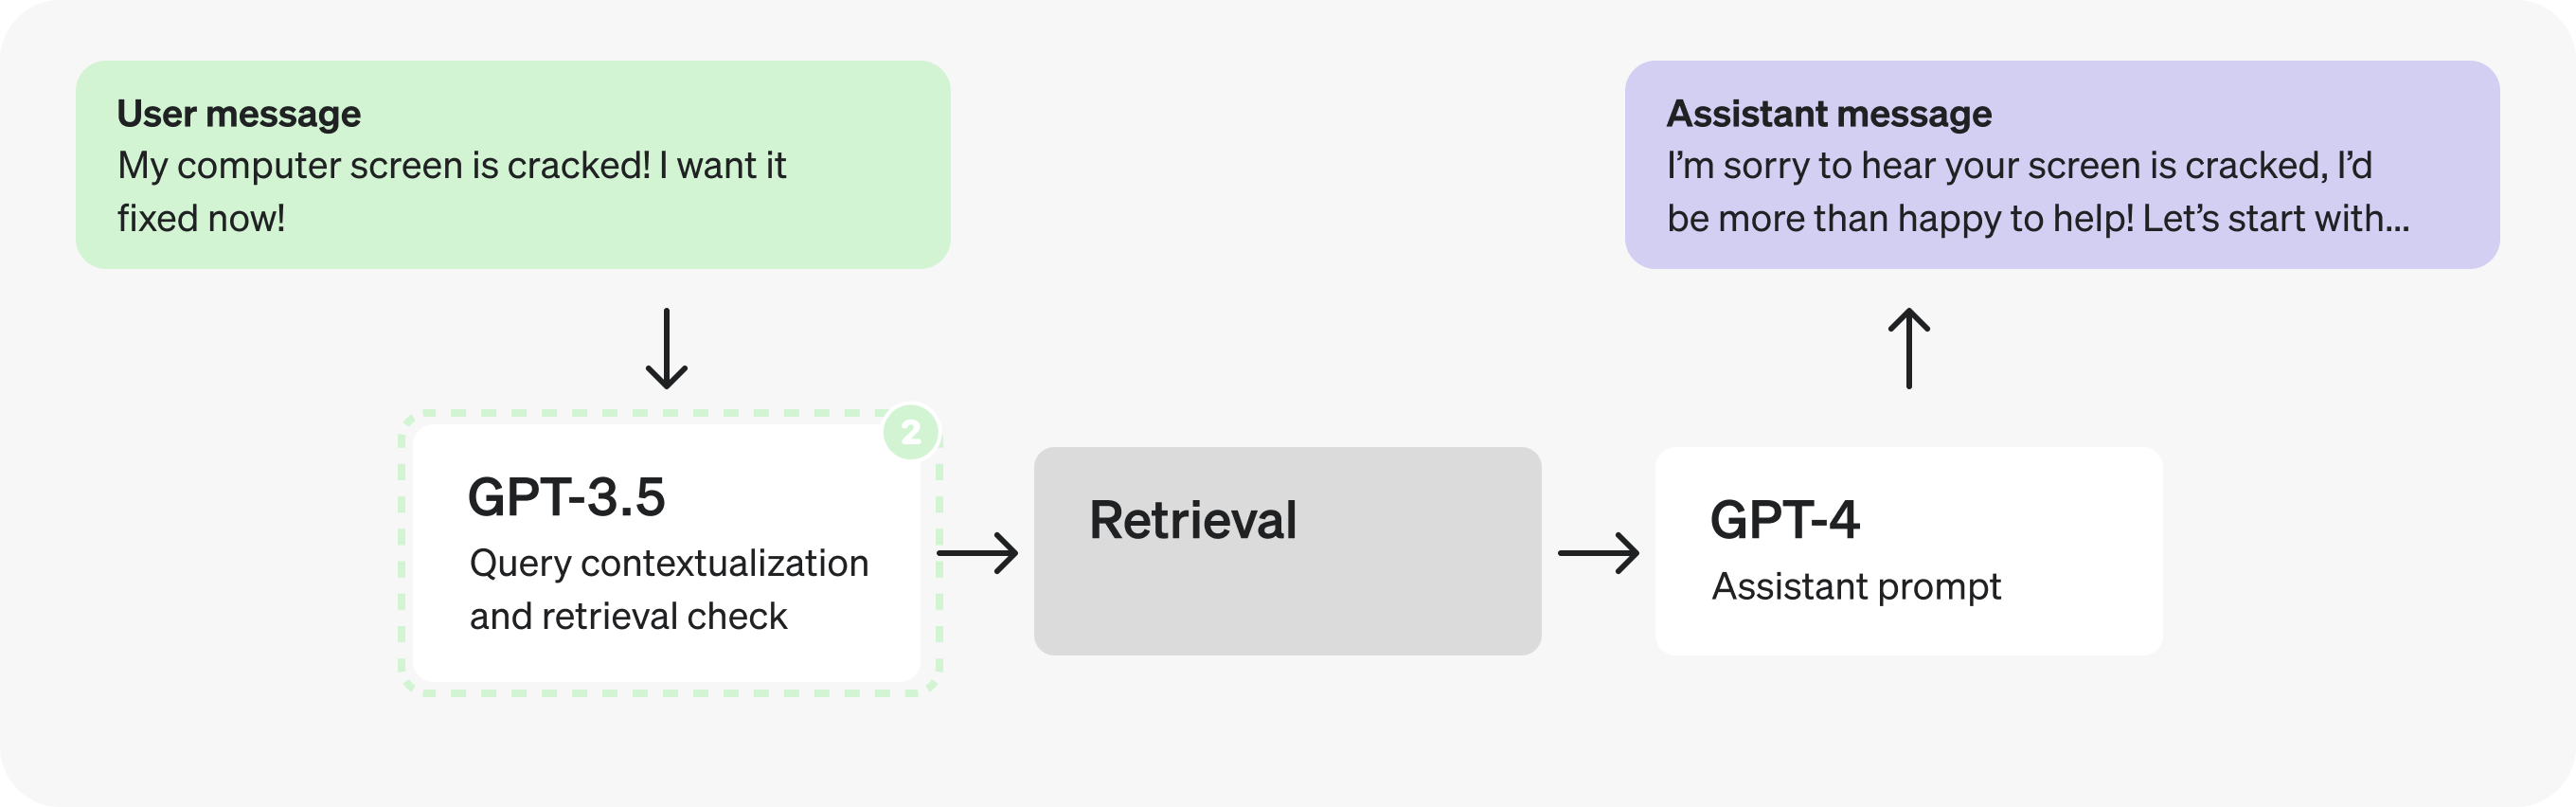
第二部分:助手提示词
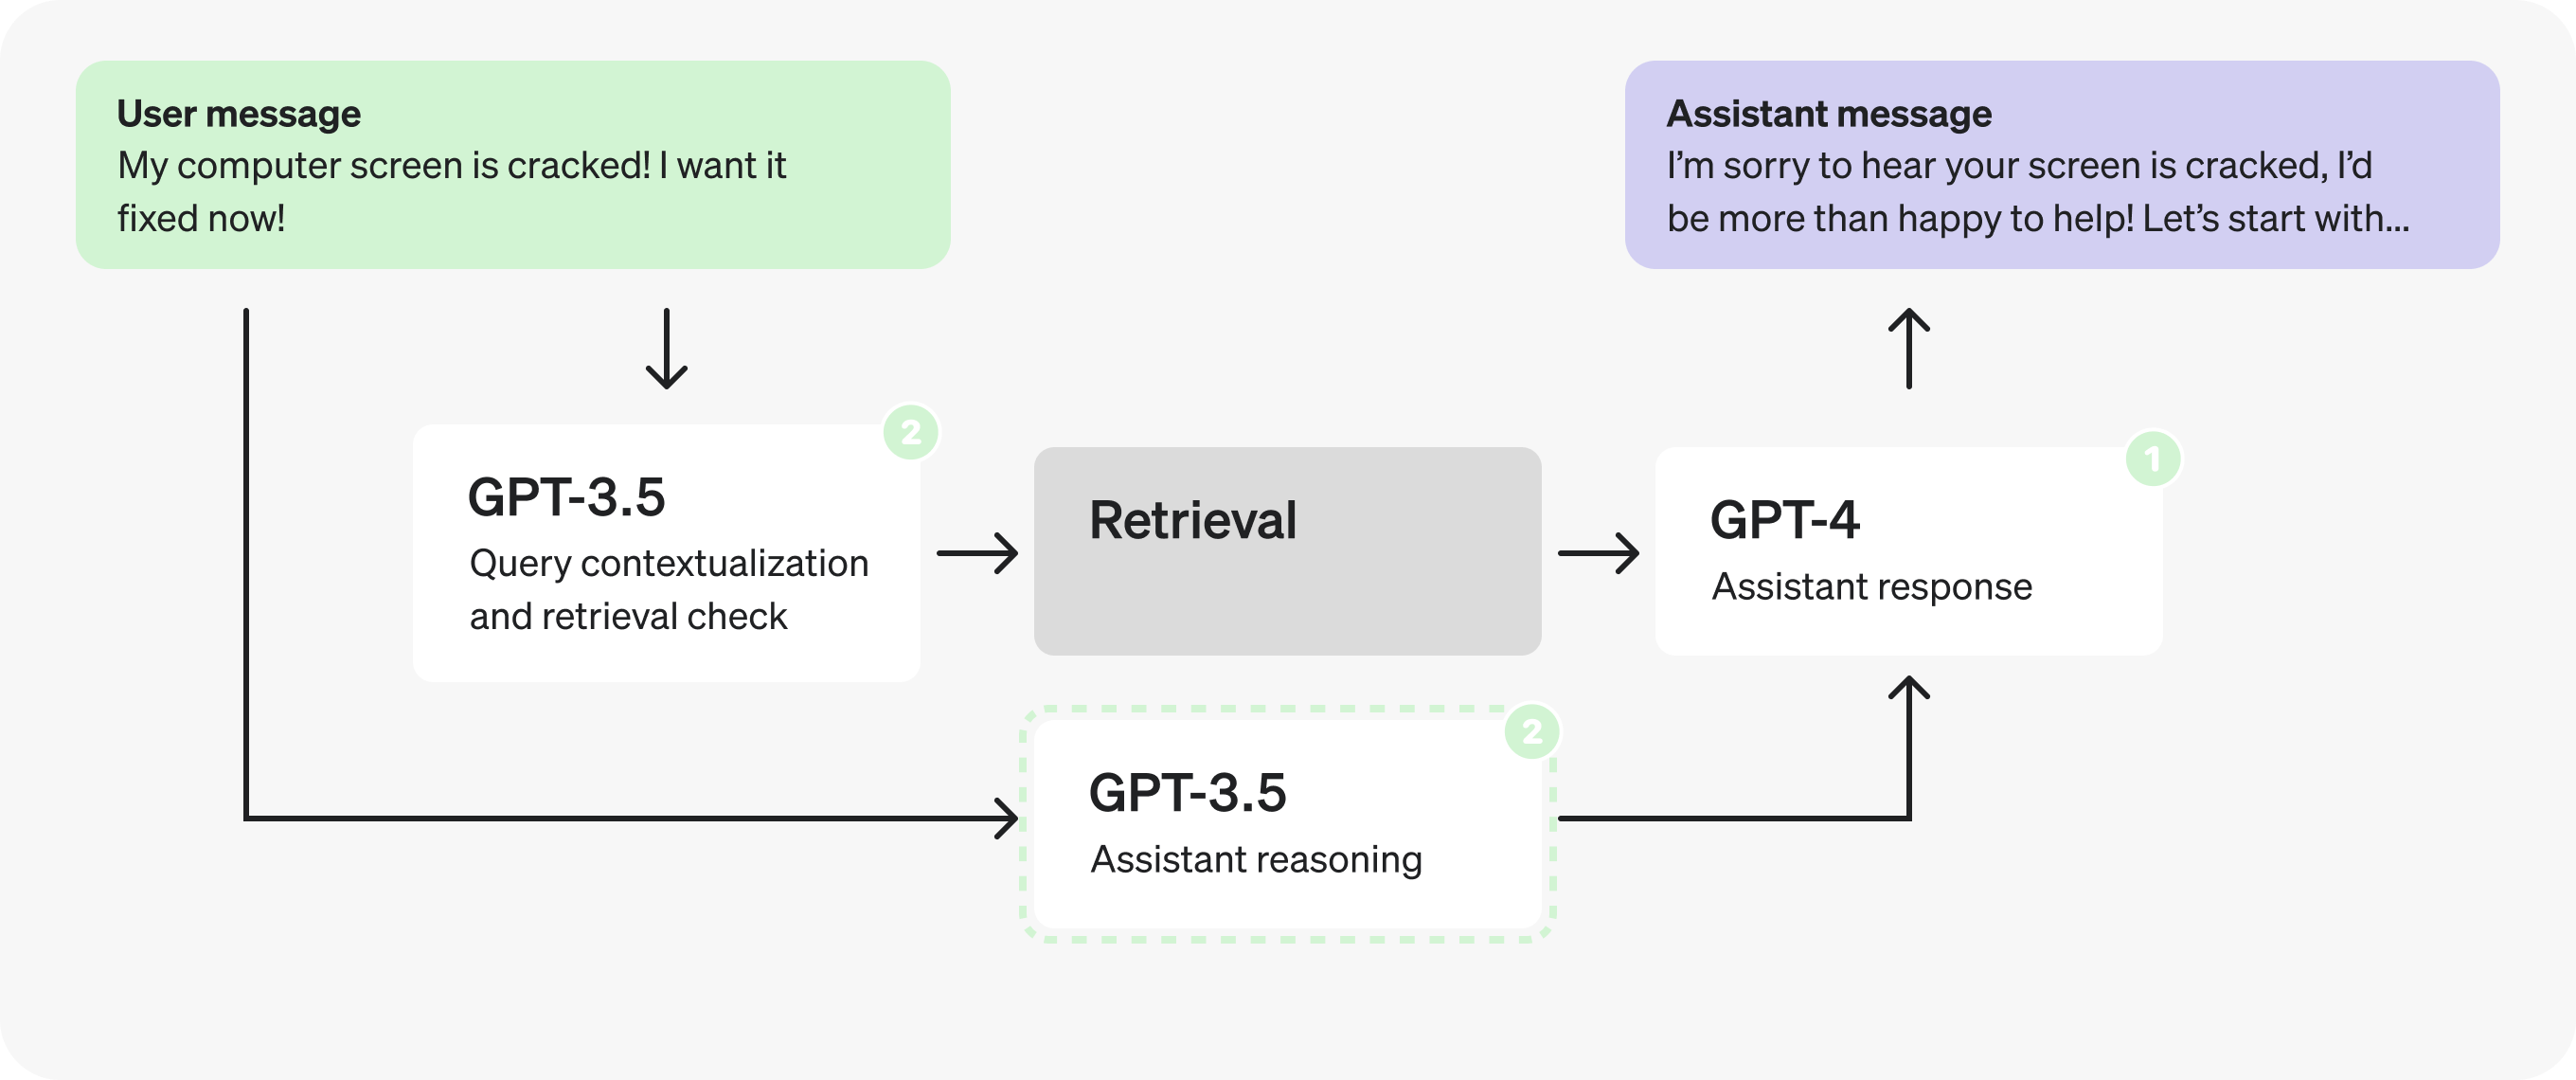
JSON中有多步分析,看似可并行:
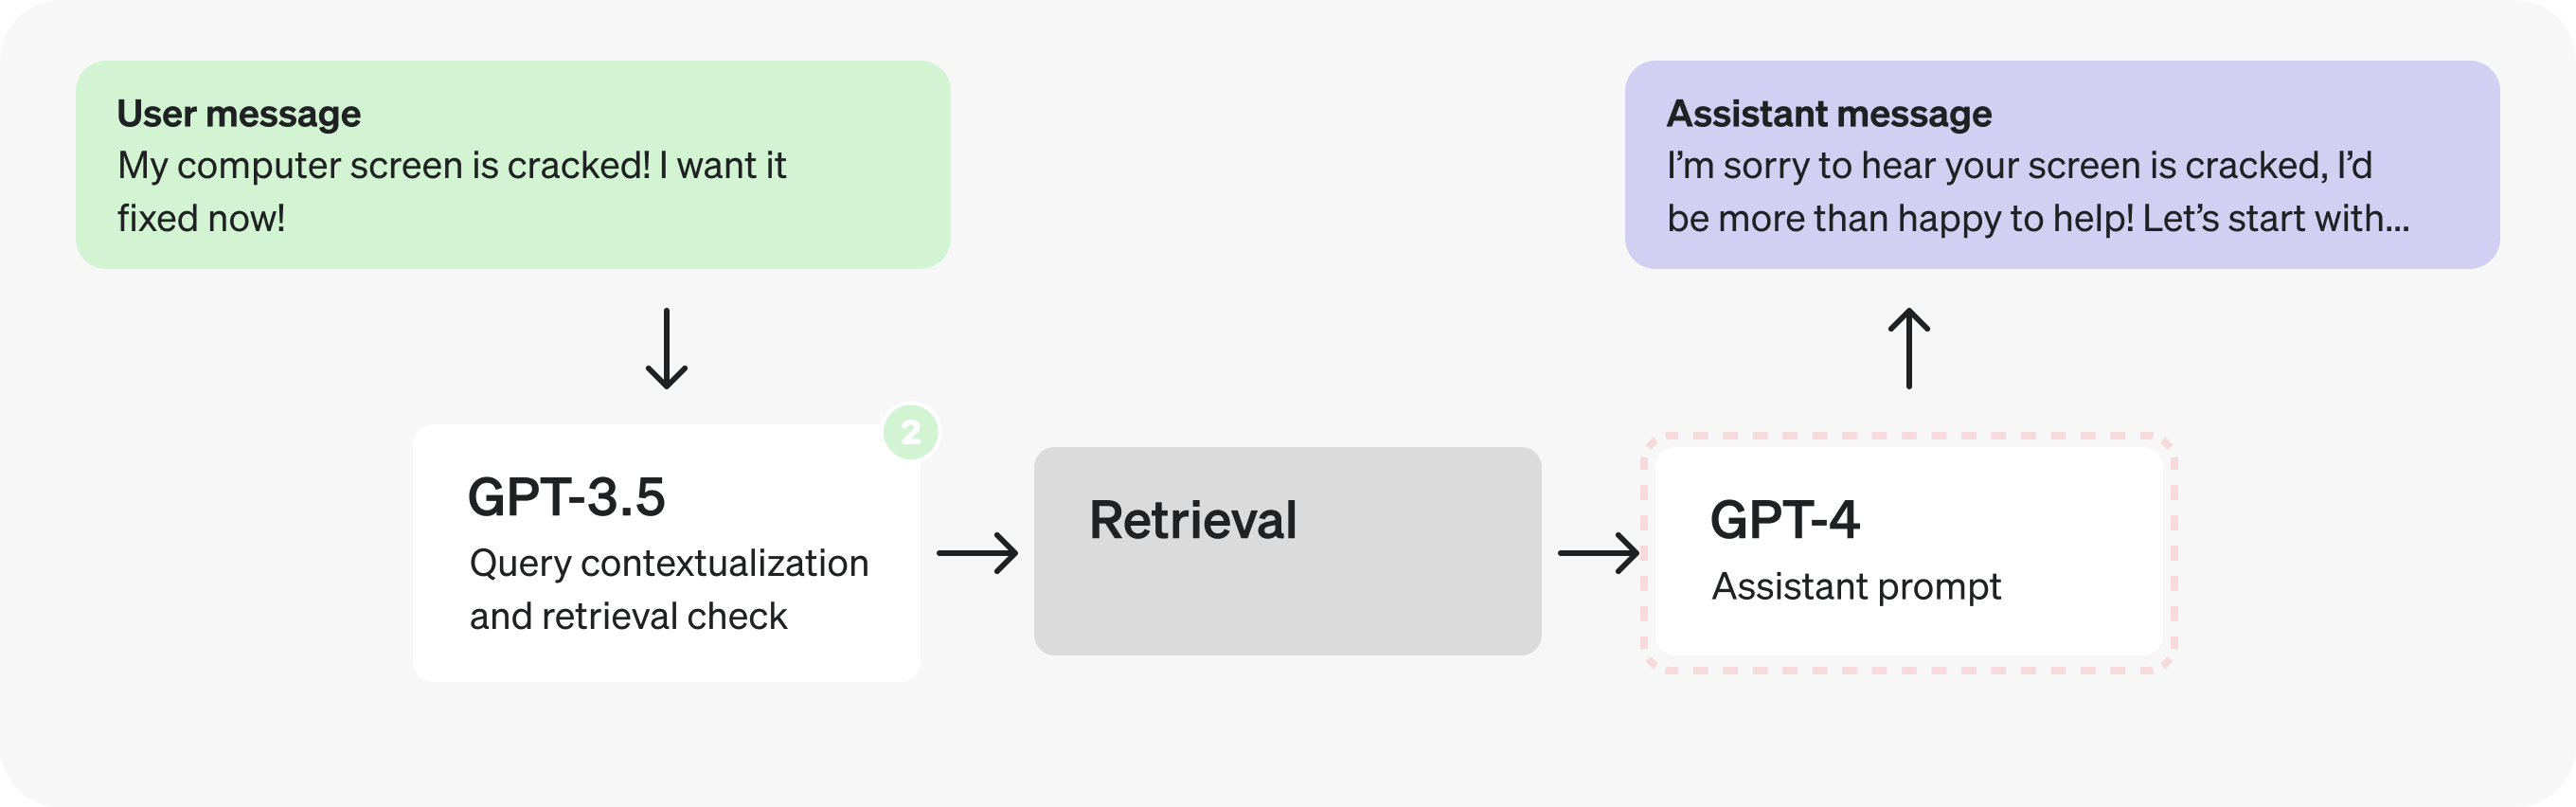
假设测试发现拆开分析步骤反而降低回答质量,则需其他方案。开放式最终回答源示例仍交GPT-4,而前面明确、有限的字段分析可能适合微调小模型。
来源示例 7(javascript):
// [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
{
  message_is_conversation_continuation: "True", // <-
  number_of_messages_in_conversation_so_far: "1", // <-
  user_sentiment: "Aggravated", // <-
  query_type: "Hardware Issue", // <-
  response_tone: "Validating and solution-oriented", // <-
  response_requirements: "Propose options for repair or replacement.", // <-
  user_requesting_to_talk_to_human: "False", // <-
  enough_information_in_context: "True", // <-
  response: "...", // X -- benefits from GPT-4
}
来源示例 8(ruby):
## [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
assistant_response = {
  message_is_conversation_continuation: "True", # <-
  number_of_messages_in_conversation_so_far: "1", # <-
  user_sentiment: "Aggravated", # <-
  query_type: "Hardware Issue", # <-
  response_tone: "Validating and solution-oriented", # <-
  response_requirements: "Propose options for repair or replacement.", # <-
  user_requesting_to_talk_to_human: "False", # <-
  enough_information_in_context: "True", # <-
  response: "..." # X -- benefits from GPT-4
}

puts(assistant_response)
取舍是一次GPT-4完成全部,还是两次顺序请求、由GPT-3.5做分析再GPT-4回答。前者请求少,后者可能处理更快;需比较最终response占比、小模型节省时间、额外一次往返开销,并用生产样本测量。示例假设拆分有利。
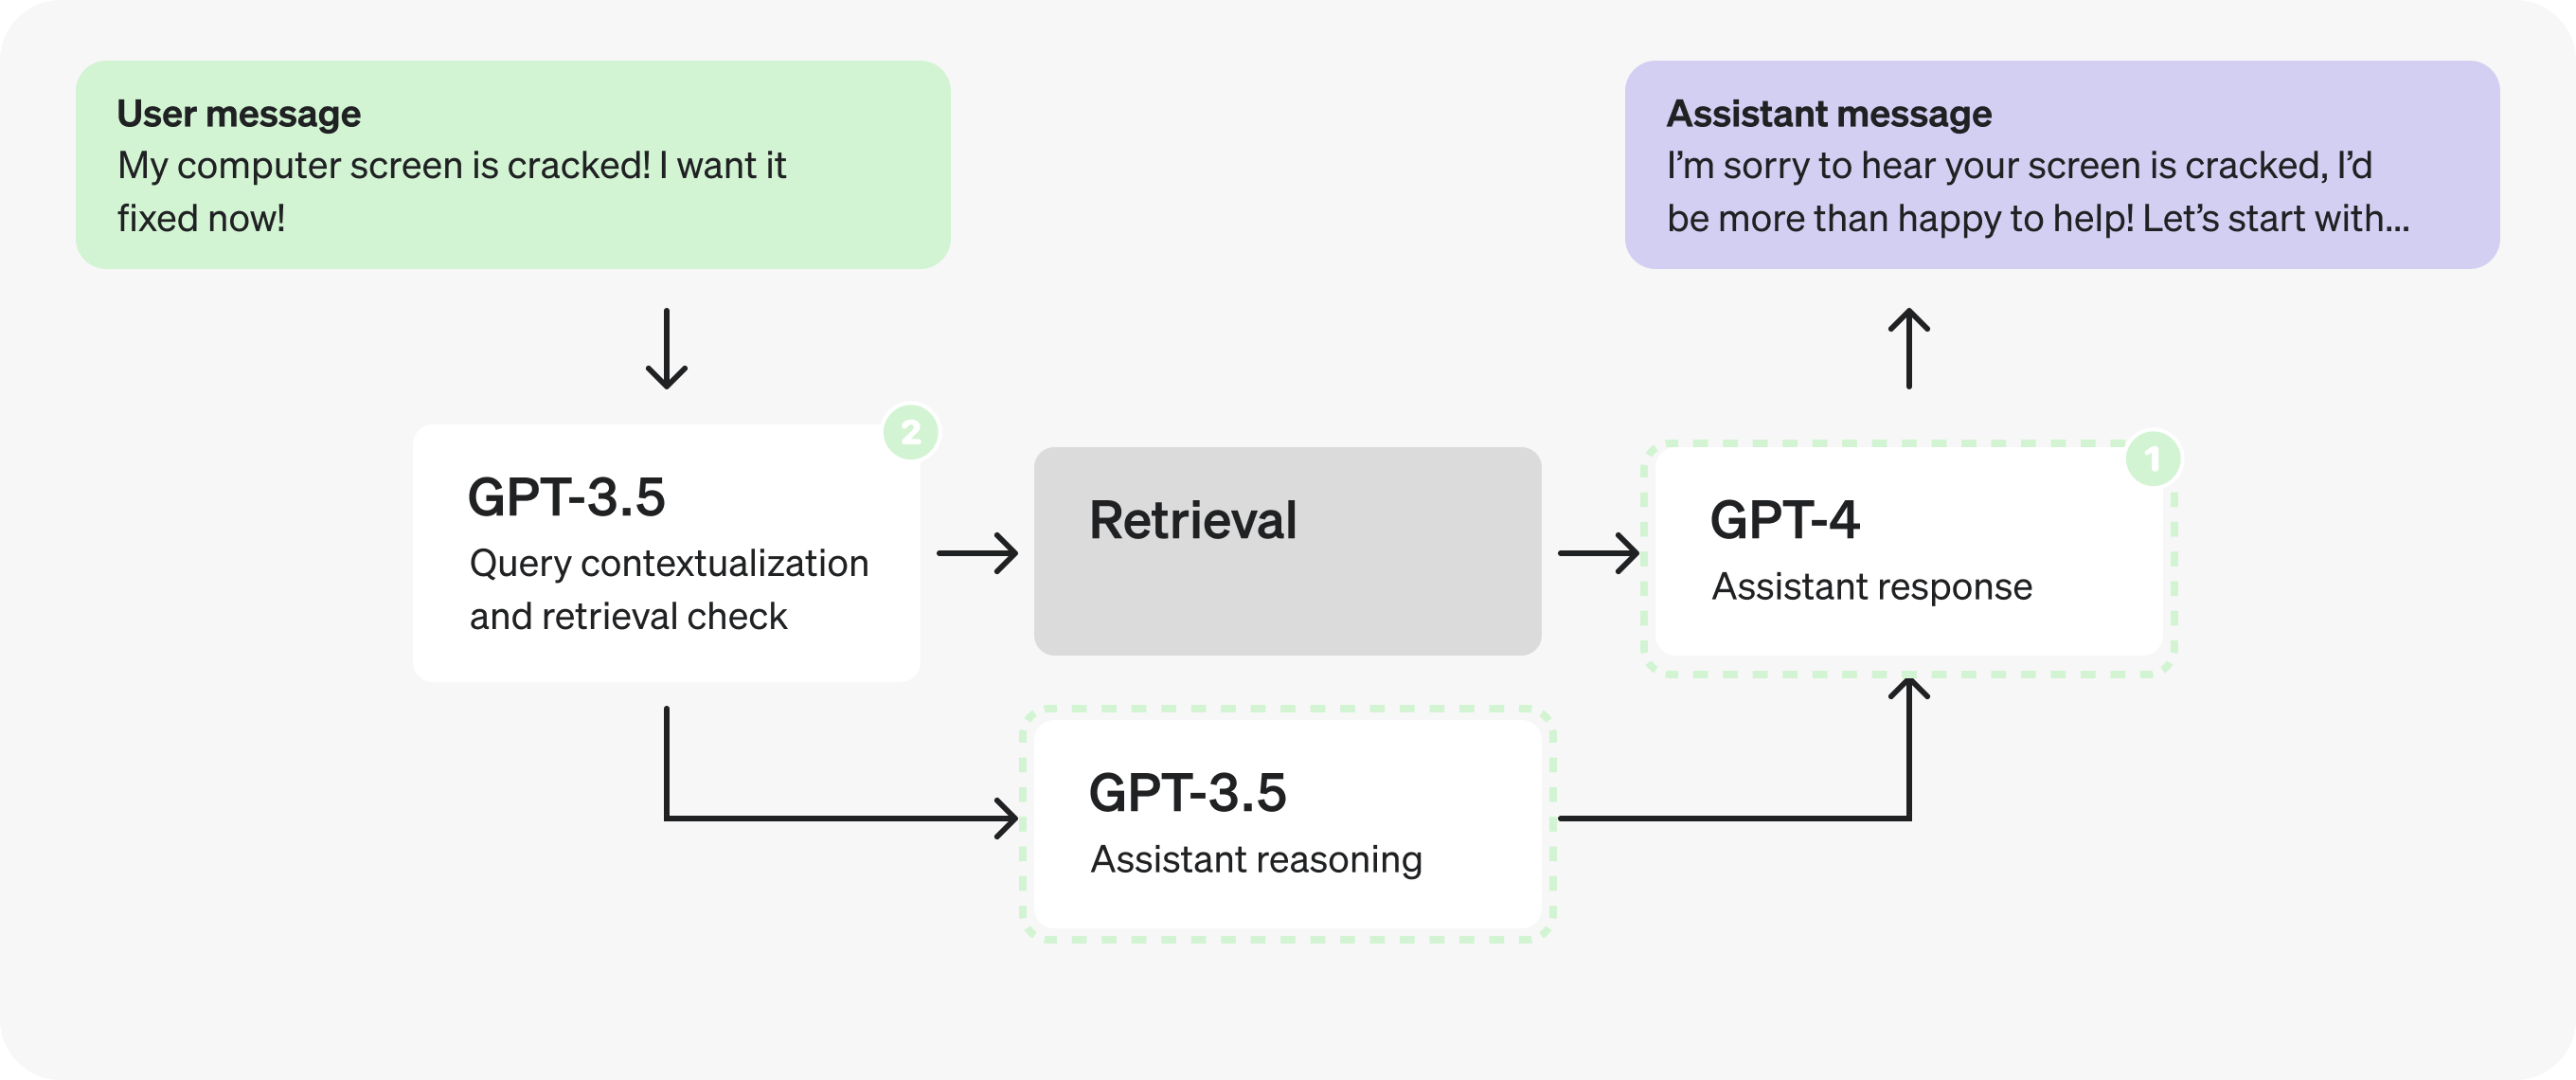
把response与enough_information_in_context放在第二个提示词,避免两次都传检索上下文。
助手提示词:分析
交给GPT-3.5,可用精选示例微调;移除response、enough_information_in_context及检索资料。
来源示例 9(example-chat):
系统指令:你是有帮助的客服机器人,依据历史会话用JSON填写字段。例:用户抱怨电脑屏幕破了;字段依次为延续会话True、消息数1、情绪恼怒、硬件问题、理解感受且面向解决的语气、提出维修或换货方案、未要求人工False。与前例相比,移除了信息足够和最终回答字段,也不传检索资料。源示例末尾逗号按原样保留,仅作提示词示意。
SYSTEM: You are a helpful customer service bot.

Based on the previous conversation, respond in a JSON to determine the required
fields.

## Example

User: "My freaking computer screen is cracked!"

Assistant Response:
{
  "message_is_conversation_continuation": "True",
  "number_of_messages_in_conversation_so_far": "1",
  "user_sentiment": "Aggravated",
  "query_type": "Hardware Issue",
  "response_tone": "Validating and solution-oriented",
  "response_requirements": "Propose options for repair or replacement.",
  "user_requesting_to_talk_to_human": "False",
}
助手提示词:回答
交给GPT-4,接收上一分析JSON与检索资料,仅生成enough_information_in_context及response。
来源示例 10(example-chat):
系统指令:你是有帮助的客服机器人,结合检索资料及预先分类的分析字段回答。分析字段来自先前GPT-3.5调用的JSON。例:用户抱怨电脑屏幕破裂,返回enough_information_in_context(上下文是否足够)和response(最终答复)。实际相关信息放入检索上下文占位符。
SYSTEM: You are a helpful customer service bot.

Use the retrieved context, as well as these pre-classified fields, to respond to
the user's query.

## Reasoning Fields
` ` `
[reasoning json determined in previous GPT-3.5 call]
` ` `

## Example

User: "My freaking computer screen is cracked!"

Assistant Response:
{
  "enough_information_in_context": "True",
  "response": "..."
}

USER: # Relevant Information
` ` `
[retrieved context]
` ` `
分析阶段已不依赖检索结果,可与检索相关步骤并行。
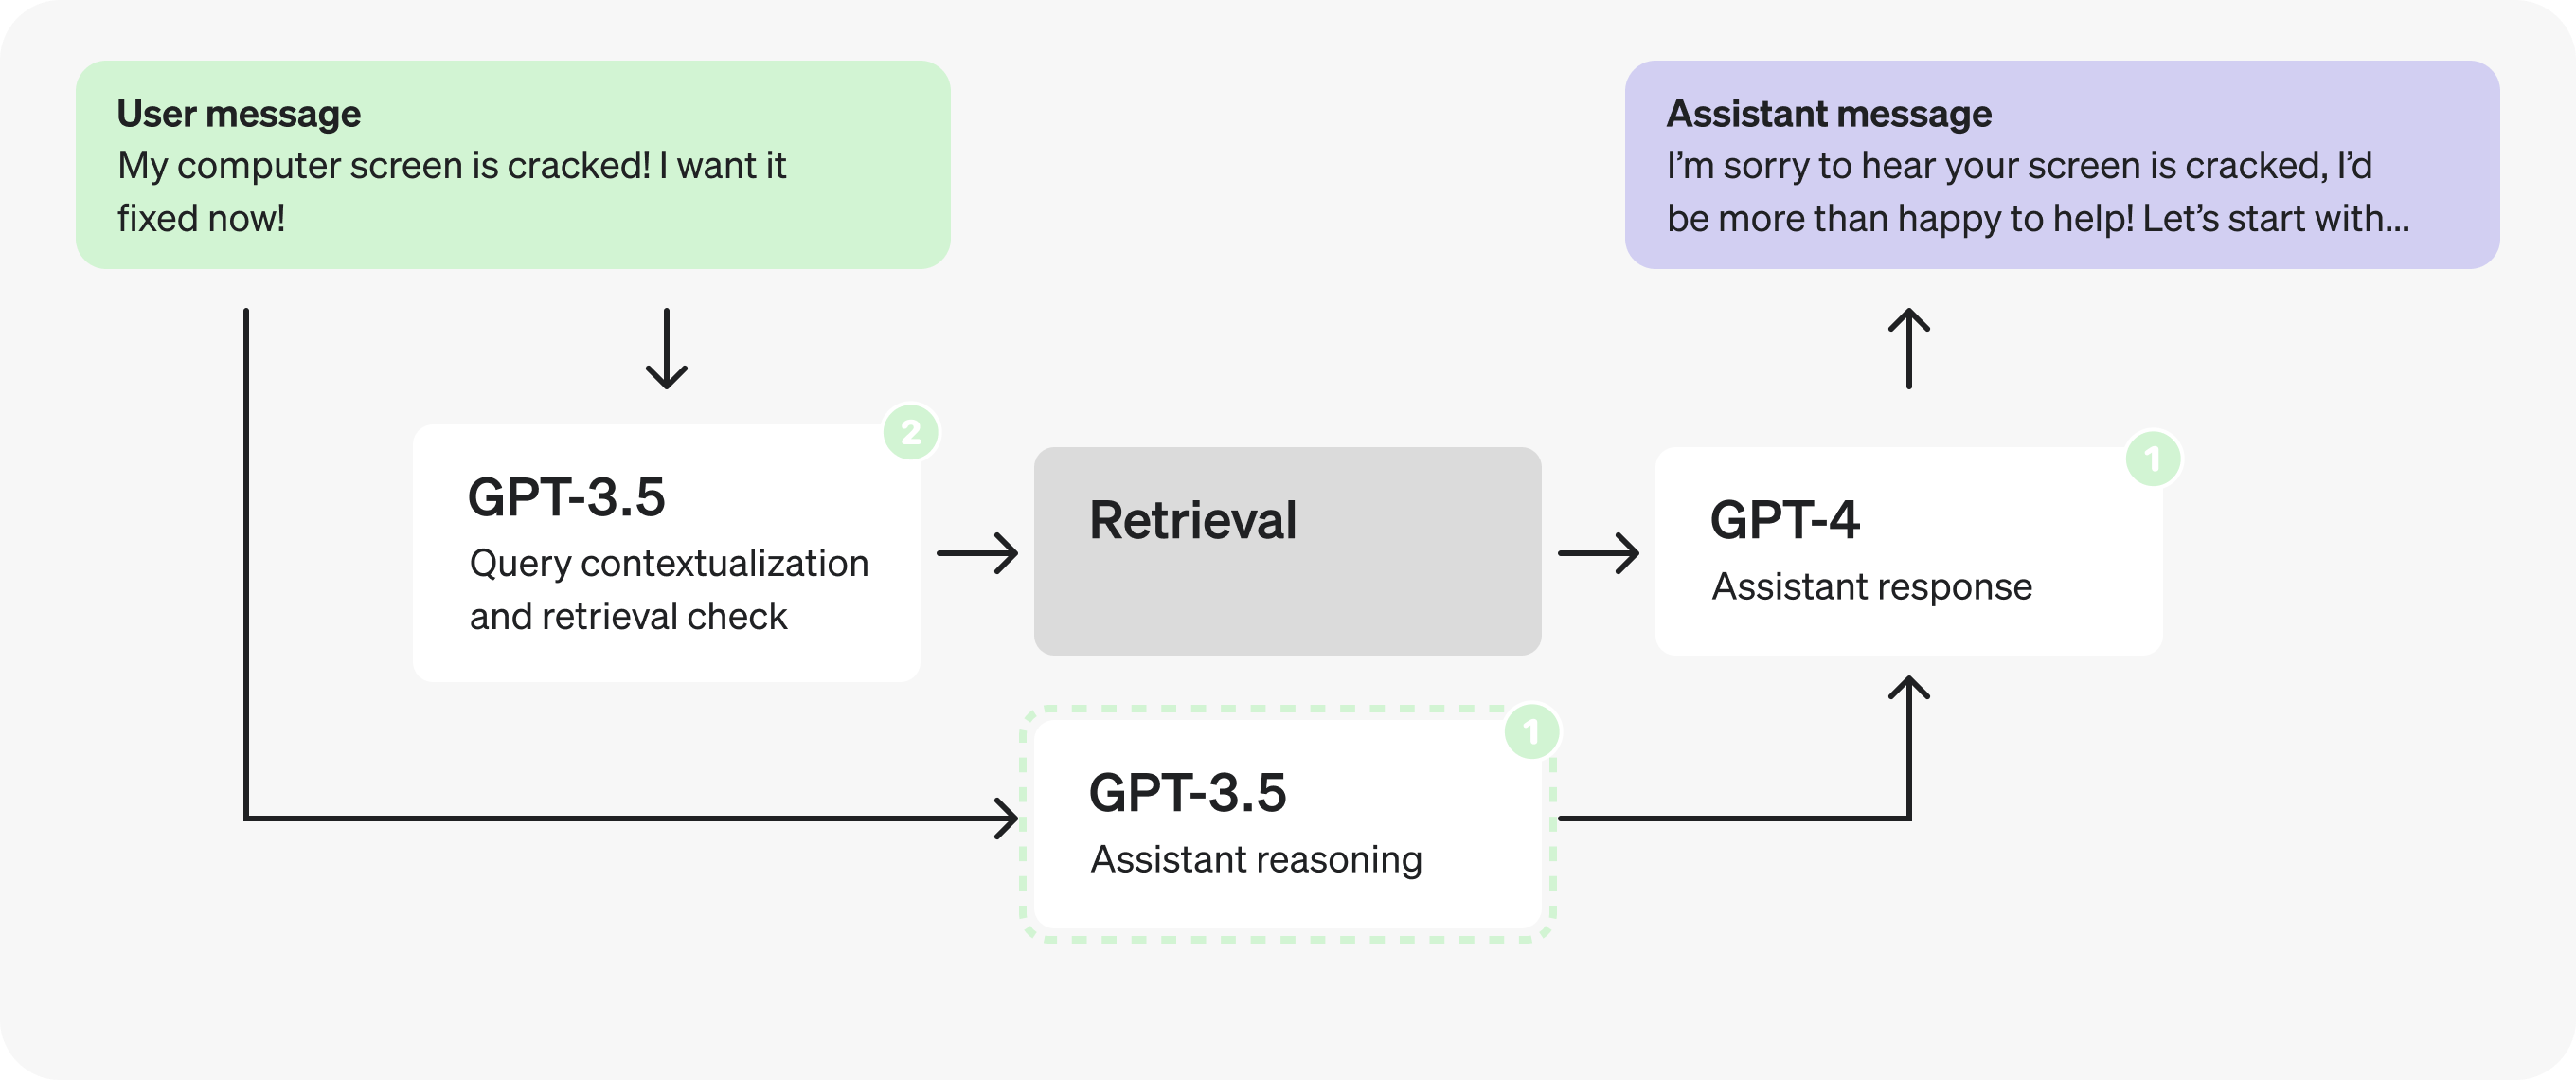
第三部分:优化结构化输出
再检查分析阶段:
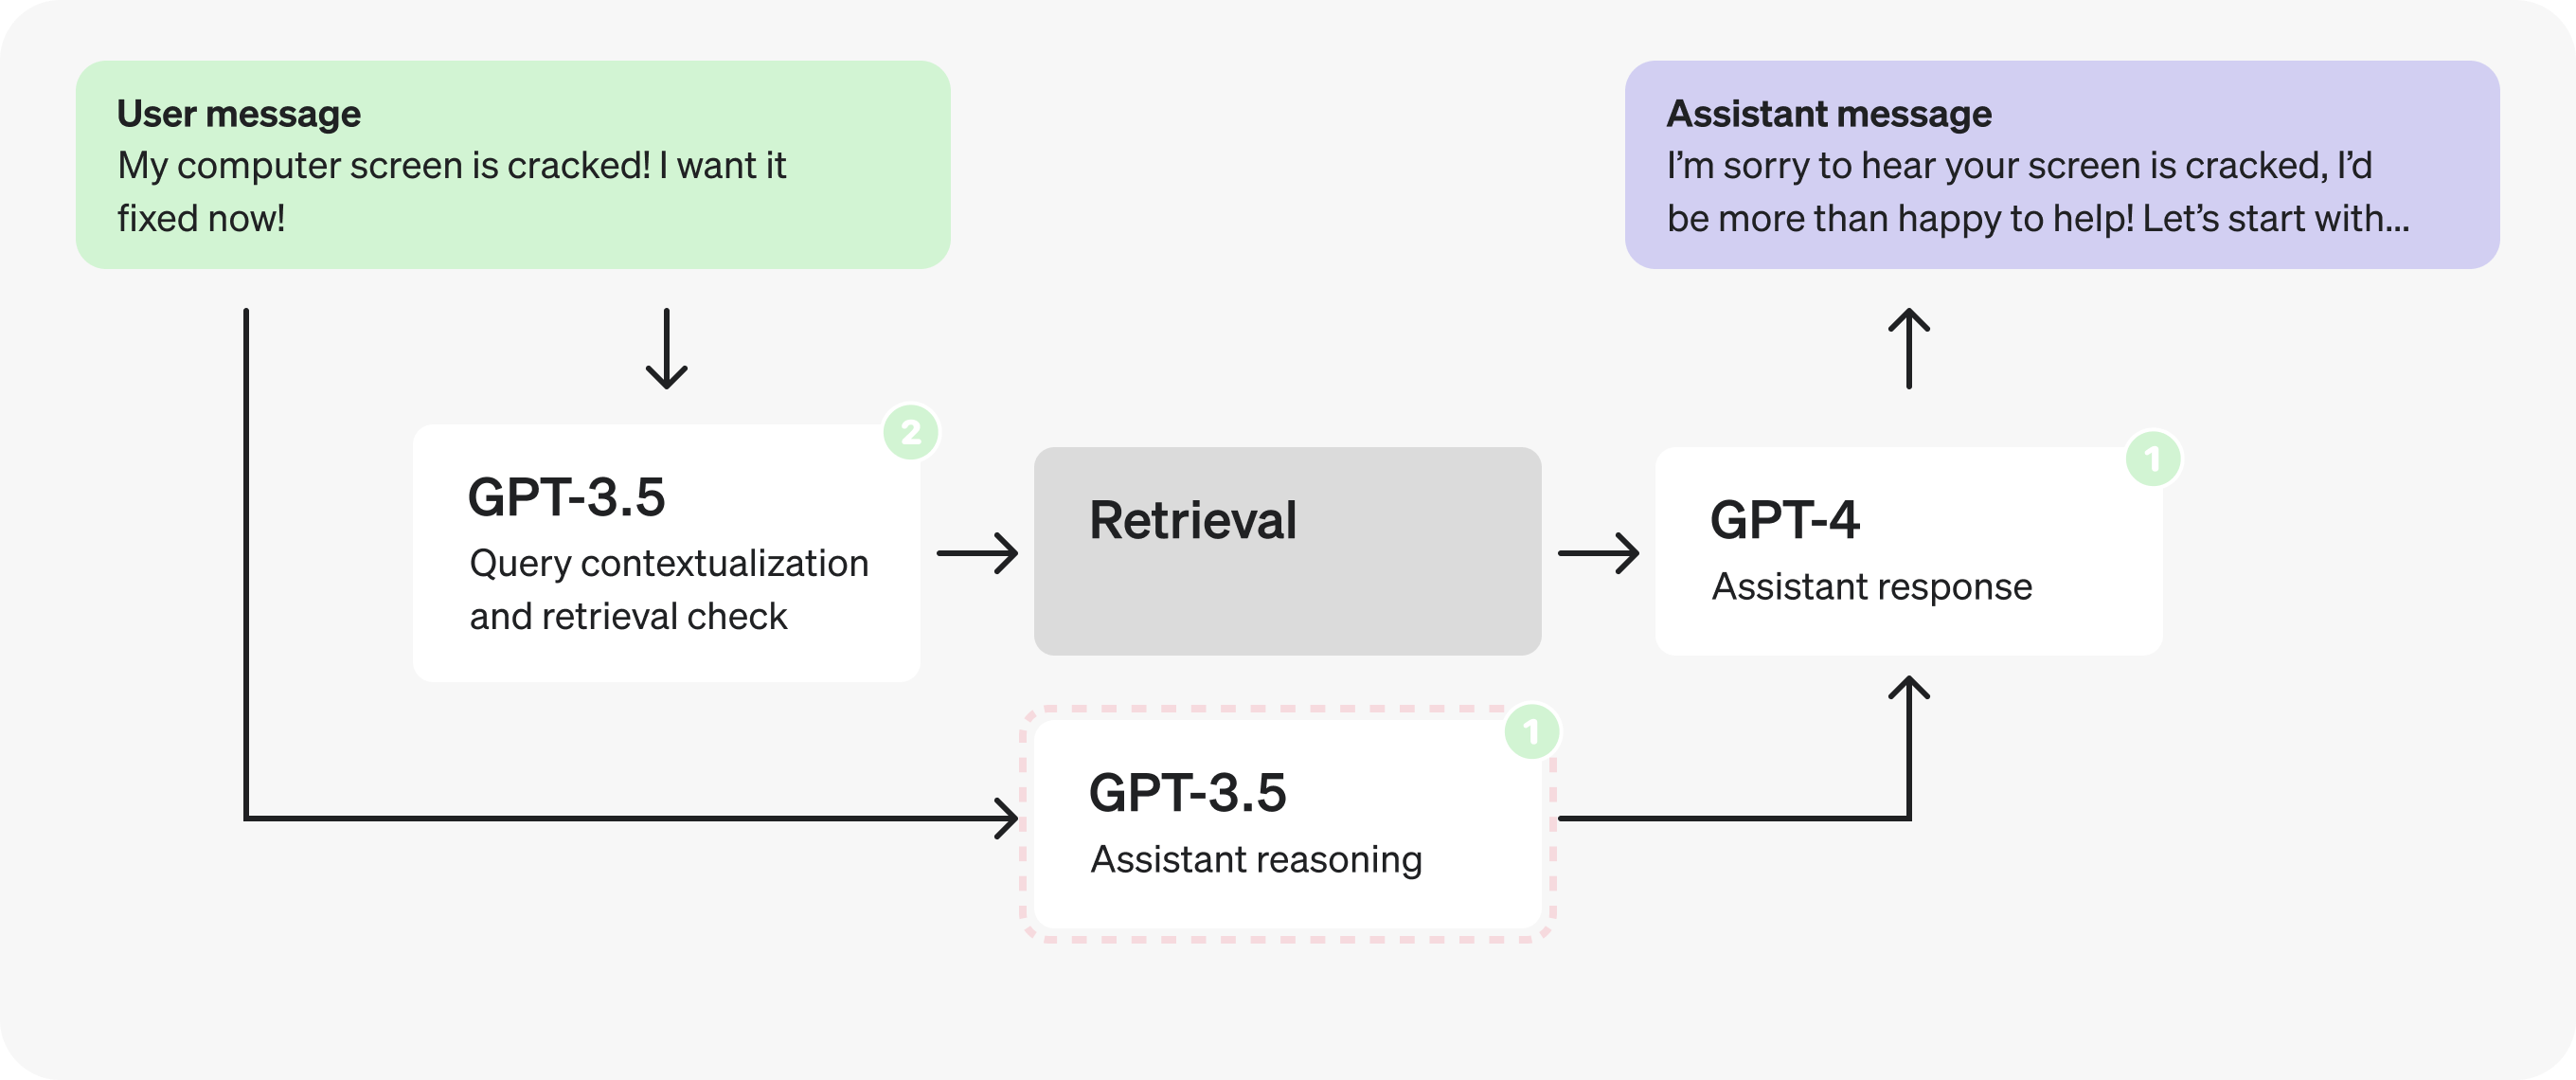
原JSON字段名较长:
来源示例 11(javascript):
// [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
{
  message_is_conversation_continuation: "True", // <-
  number_of_messages_in_conversation_so_far: "1", // <-
  user_sentiment: "Aggravated", // <-
  query_type: "Hardware Issue", // <-
  response_tone: "Validating and solution-oriented", // <-
  response_requirements: "Propose options for repair or replacement.", // <-
  user_requesting_to_talk_to_human: "False", // <-
}
来源示例 12(ruby):
## [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
reasoning = {
  message_is_conversation_continuation: "True", # <-
  number_of_messages_in_conversation_so_far: "1", # <-
  user_sentiment: "Aggravated", # <-
  query_type: "Hardware Issue", # <-
  response_tone: "Validating and solution-oriented", # <-
  response_requirements: "Propose options for repair or replacement.", # <-
  user_requesting_to_talk_to_human: "False" # <-
}

puts(reasoning)
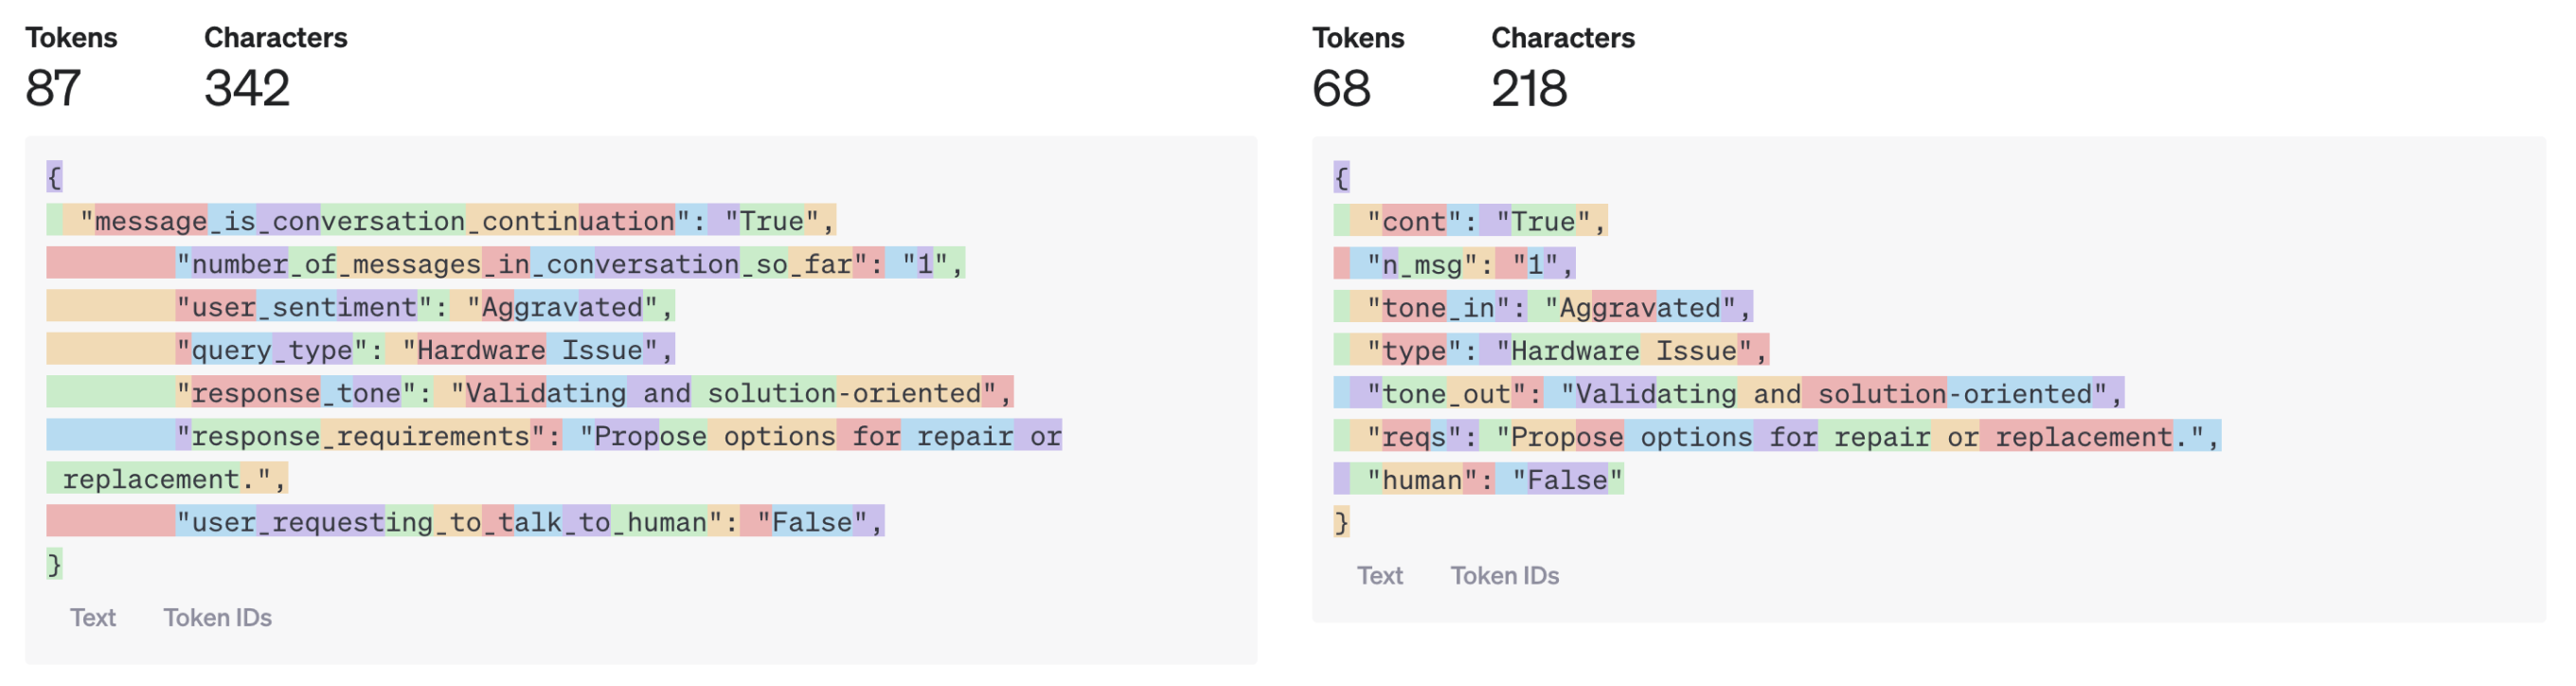
缩短字段名,将解释放入提示词注释,可减少输出词元:
来源示例 13(javascript):
// [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
{
  cont: "True", // whether last message is a continuation
  n_msg: "1", // number of messages in the continued conversation
  tone_in: "Aggravated", // sentiment of user query
  type: "Hardware Issue", // type of the user query
  tone_out: "Validating and solution-oriented", // desired tone for response
  reqs: "Propose options for repair or replacement.", // response requirements
  human: "False", // whether user is expressing want to talk to human
}
来源示例 14(ruby):
## [中文] 来源客服机器人示例的提示词/对象片段;保留字段名和输入,按本节解释合并任务、拆分分析与回答或缩短字段。它不是独立完整应用,也不是当前模型推荐。
reasoning = {
  cont: "True", # whether last message is a continuation
  n_msg: "1", # number of messages in the continued conversation
  tone_in: "Aggravated", # sentiment of user query
  type: "Hardware Issue", # type of the user query
  tone_out: "Validating and solution-oriented", # desired tone for response
  reqs: "Propose options for repair or replacement.", # response requirements
  human: "False" # whether user wants to talk to a human
}

puts(reasoning)
源示例减少19个输出词元,在GPT-3.5可能只省几毫秒,GPT-4可能最多省约一秒;这不是本地实测。大输出收益可能更明显。
也可用单字符字段或数组进一步压缩,但可能损害质量,应测试再决定。
示例回顾
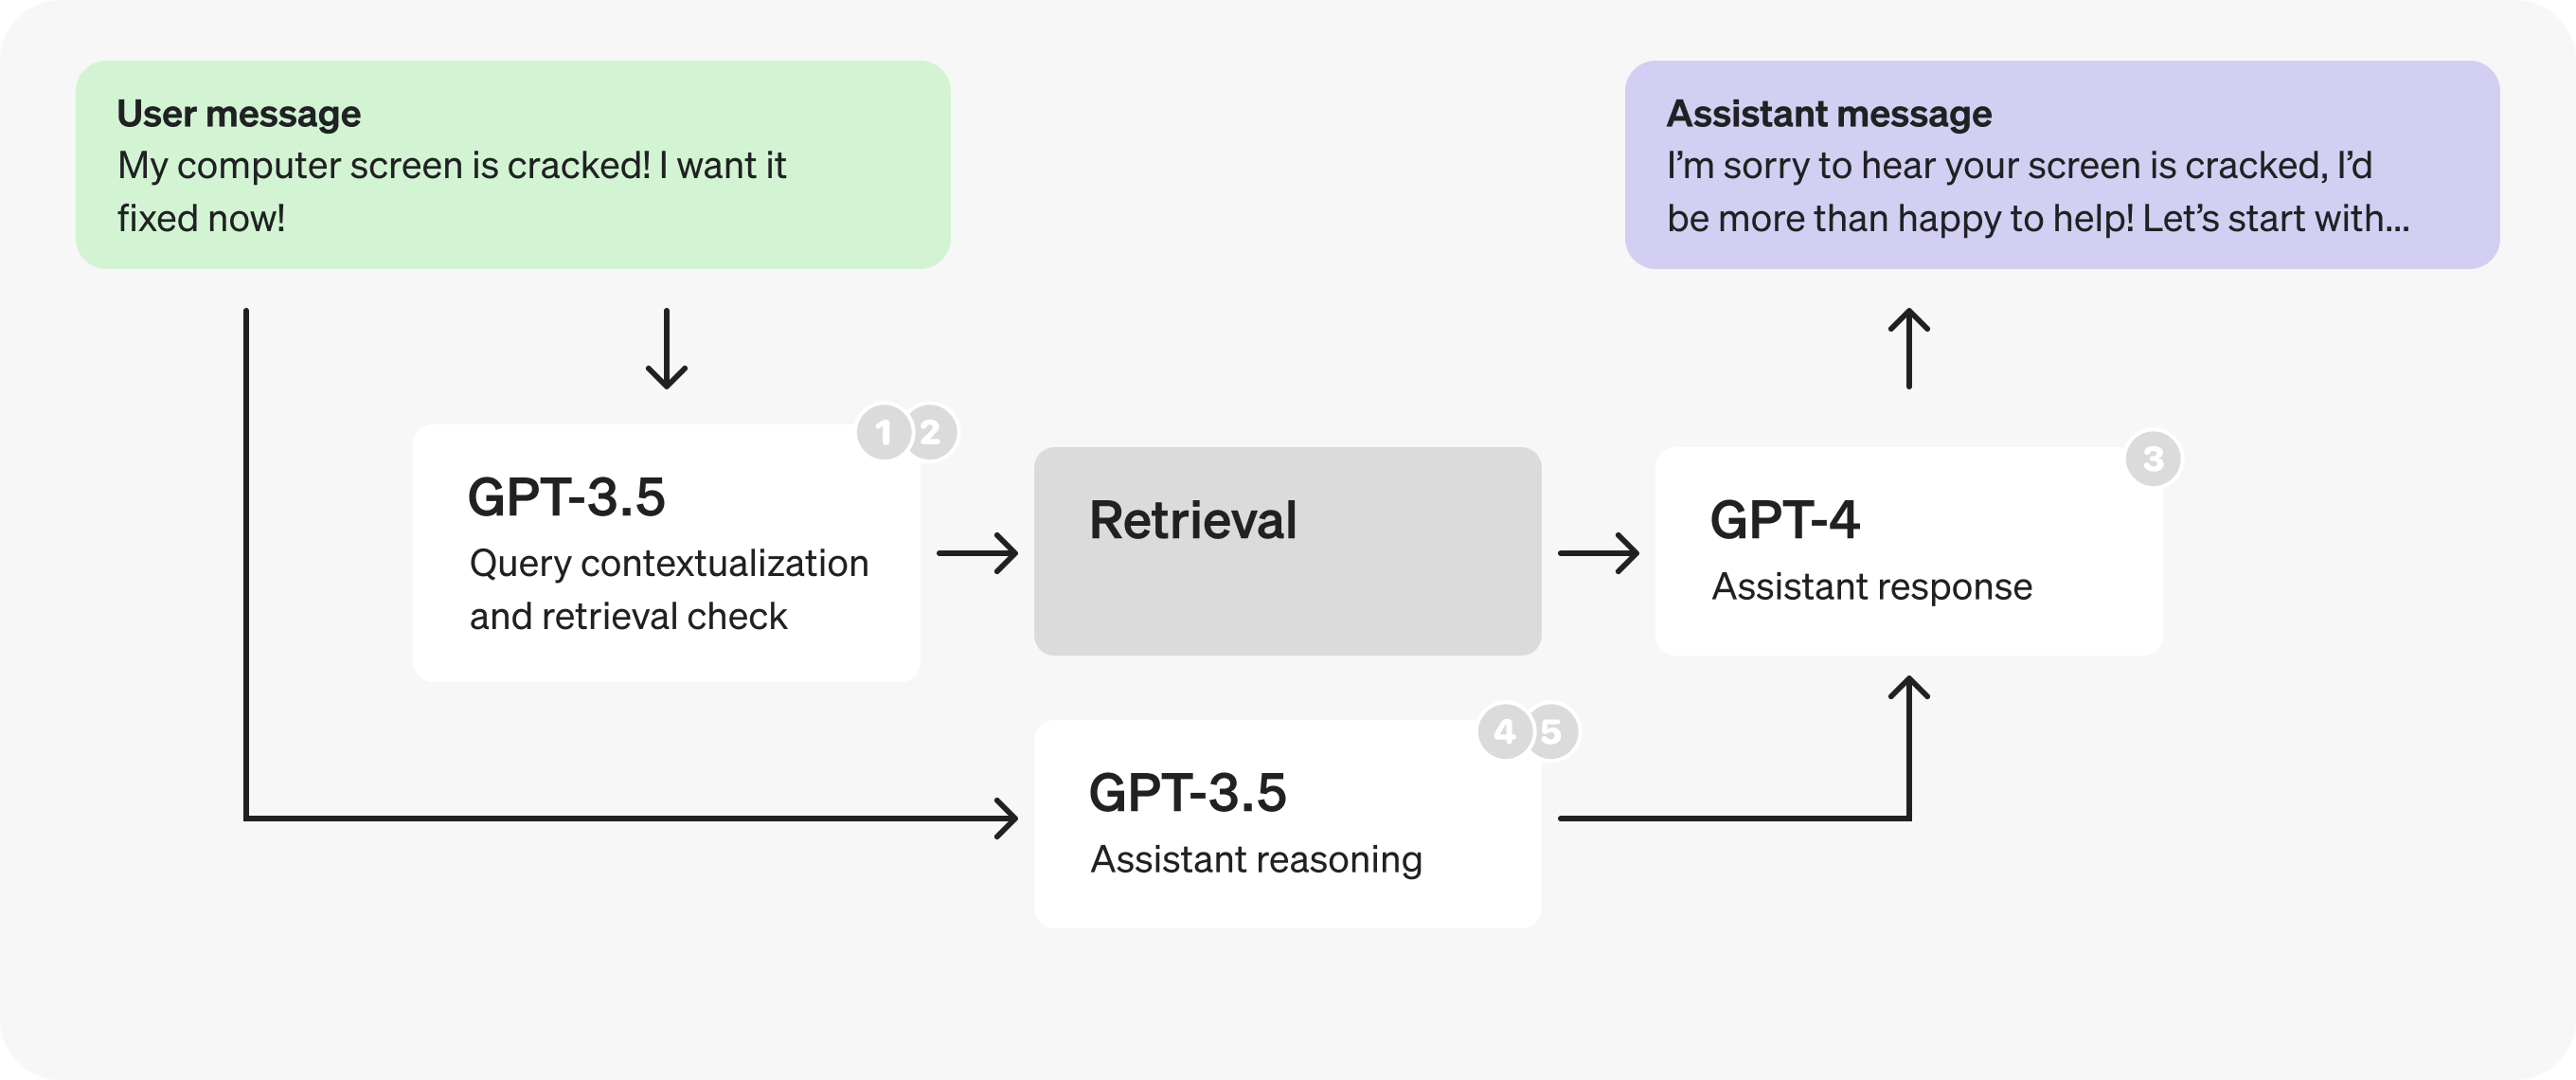
合并上下文化与检索判断;用较小微调模型完成该步骤;拆分助手分析和回答,将分析交小模型;并行检索和分析;缩短字段名并将说明移入提示词,减少输出。实际应用按测量选择,不要求全套照搬。
















更多建议: