
 TRAE-AI编程



OpenAI 嵌入向量
第三代嵌入模型
text-embedding-3-small和text-embedding-3-large已推出。官方页面的模型发布提示指出,这两款模型具有更低的成本、更好的多语言表现,并提供控制输出向量维度的新参数。这里的发布提示指第三代嵌入模型。
什么是嵌入向量?
OpenAI 的文本嵌入用于衡量文本字符串之间的关联程度。嵌入向量常用于:
- 搜索:按照与查询文本的相关性对结果排序。
- 聚类:将相似的文本分为一组。
- 推荐:推荐文本内容相关的项目。
- 异常检测:识别与其他项目关联很弱的离群项。
- 多样性衡量:分析相似度的分布。
- 分类:将文本归入与其最相似的标签。
嵌入向量是一组浮点数构成的向量(列表)。两个向量之间的距离用于衡量关联程度:距离越小,关联通常越强;距离越大,关联通常越弱。
嵌入模型的费用请参见定价。请求根据输入中的词元(token)数量计费。
如何获取嵌入向量
将文本和嵌入模型名称(例如 text-embedding-3-small)一起发送到Embeddings API 端点,即可获得嵌入向量。
下面是不同语言的获取示例。
来源示例1(javascript)
程序中的自然语言译释2:
将你的文本字符串放在这里。
// [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
来源示例2(python)
本段复用的中文释义:译释2。
## [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
from openai import OpenAI

client = OpenAI()

response = client.embeddings.create(
    input="Your text string goes here", model="text-embedding-3-small"
)

print(response.data[0].embedding)
来源示例3(go)
程序中的自然语言译释1:
将你的文本字符串放在这里。
// [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
package main

import (
    "context"
    "fmt"

    "github.com/openai/openai-go/v3"
)

func main() {
    client := openai.NewClient()

    embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{
            OfString: openai.String("Your text string goes here."),
        },
    })
    if err != nil {
        panic(err)
    }

    fmt.Println(len(embedding.Data[0].Embedding))
}
来源示例4(java)
程序中的自然语言译释3:
食物很美味,而且服务员……
// [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;

var embedding =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .input("The food was delicious and the waiter...")
                .build());

System.out.println(embedding.data().get(0).embedding());
来源示例5(csharp)
程序中的自然语言译释4:
食物很美味,服务员也很友善。
程序中的自然语言译释38:
维度数量:
// [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
    "The food was delicious and the waiter was friendly."
);

Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");
来源示例6(ruby)
本段复用的中文释义:译释3。
## [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
require "openai"

client = OpenAI::Client.new

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: "The food was delicious and the waiter..."
)

puts(response.data.fetch(0).embedding)
来源示例7(bash)
本段复用的中文释义:译释2。
## [中文] 把示例文本发送给嵌入模型,返回向量及用量;文本输入是待编码内容,不是要求模型执行的指令。
curl https://api.openai.com/v1/embeddings \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "input": "Your text string goes here",
    "model": "text-embedding-3-small"
  }'
响应中包含嵌入向量(浮点数列表)及其他元数据。你可以提取向量,将其存入向量数据库,用于不同场景。
来源示例8(json):以下保留协议载荷、配置、返回示意或语法定义;省略号及片段不代表完整可运行程序。
{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
text-embedding-3-small 默认输出 1536 维向量,text-embedding-3-large 默认输出 3072 维向量。通过 dimensions 参数,可以缩短向量,同时保留其表达概念的能力。应用场景中介绍了更多维度调整细节。
嵌入模型
OpenAI 提供两款第三代嵌入模型,模型 ID 中以 -3 标识。更多背景见嵌入模型 v3 发布说明。
费用按输入词元计量。以下是官方正文给出的“每美元约可处理多少页文本”的换算示例,假设每页约 800 个词元;它不是中文实际页数或固定报价,实际费用以定价页为准。
| 模型 | 每美元约可处理的页数 | MTEB 评测表现 | 最大输入(词元) |
|---|---|---|---|
| text-embedding-3-small | 62,500 | 62.3% | 8192 |
| text-embedding-3-large | 9,615 | 64.6% | 8192 |
| text-embedding-ada-002 | 12,500 | 61.0% | 8192 |
应用场景
以下使用 Amazon 食品评论数据集展示典型用法。
获取数据集的嵌入向量
该数据集包含截至 2012 年 10 月 Amazon 用户发表的 568,454 条食品评论。示例选取最近的 1,000 条评论。评论为英文,情感通常偏正面或负面。每条记录包含 ProductId(产品 ID)、UserId(用户 ID)、Score(评分)、Summary(评论标题)和 Text(评论正文),例如:
| 产品 ID | 用户 ID | 评分 | 评论标题 | 评论正文 |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | 优质狗粮(Good Quality Dog Food) | 我买过好几种 Vitality 罐装食品…… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | 与广告不符(Not as Advertised) | 收到的产品标签写着大粒咸味花生…… |
将评论标题与正文合并为一段文本,再由模型将合并文本编码为一个向量。对应笔记本为 Get_embeddings_from_dataset.ipynb。
来源示例9(javascript)
程序中的自然语言译释5:
一杯香浓的咖啡。
程序中的自然语言译释6:
一杯清新爽口的花草茶。
// [中文] 对评论文本生成向量并写入CSV;ada_embedding是沿用示例的数据列名,不表示使用ada模型。
// [中文] 各语言的数据准备方式不同;Python沿用包含combined列的df,其他语言展示少量评论的保存流程。
import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
来源示例10(python)
## [中文] 沿用前文含combined列的df,为评论生成向量;写入CSV前创建output目录。
## [中文] ada_embedding是原例沿用的列名,不表示使用ada模型。
from pathlib import Path

from openai import OpenAI

client = OpenAI()


def get_embedding(text, model="text-embedding-3-small"):
    text = text.replace("\n", " ")
    return client.embeddings.create(input=[text], model=model).data[0].embedding


df["ada_embedding"] = df.combined.apply(
    lambda x: get_embedding(x, model="text-embedding-3-small")
)
Path("output").mkdir(exist_ok=True)
df.to_csv("output/embedded_1k_reviews.csv", index=False)
来源示例11(go)
程序中的自然语言译释7:
已保存output/embedded_1k_reviews.csv。
本段复用的中文释义:译释5、译释6。
// [中文] 对评论文本生成向量并写入CSV;ada_embedding是沿用示例的数据列名,不表示使用ada模型。
// [中文] 各语言的数据准备方式不同;Python沿用包含combined列的df,其他语言展示少量评论的保存流程。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "encoding/csv"
    "encoding/json"
    "fmt"
    "log"
    "os"
    "strings"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    ctx := context.Background()
    reviews := []string{"A rich cup of coffee.", "A bright herbal tea."}
    if err := os.MkdirAll("output", 0755); err != nil {
        return err
    }
    file, err := os.Create("output/embedded_1k_reviews.csv")
    if err != nil {
        return err
    }
    defer file.Close()
    writer := csv.NewWriter(file)
    if err := writer.Write([]string{"combined", "ada_embedding"}); err != nil {
        return err
    }
    for _, review := range reviews {
        vector, err := embedding(ctx, &client, strings.ReplaceAll(review, "\n", " "))
        if err != nil {
            return err
        }
        encoded, err := json.Marshal(vector)
        if err != nil {
            return err
        }
        if err := writer.Write([]string{review, string(encoded)}); err != nil {
            return err
        }
    }
    writer.Flush()
    if err := writer.Error(); err != nil {
        return err
    }
    if err := file.Close(); err != nil {
        return err
    }
    fmt.Println("Saved output/embedded_1k_reviews.csv")
    return nil
}

func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
    response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
    })
    if err != nil {
        return nil, err
    }
    return response.Data[0].Embedding, nil
}
来源示例12(java)
本段复用的中文释义:译释5、译释6。
// [中文] 对评论文本生成向量并写入CSV;ada_embedding是沿用示例的数据列名,不表示使用ada模型。
// [中文] 各语言的数据准备方式不同;Python沿用包含combined列的df,其他语言展示少量评论的保存流程。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;

static String csvField(String value) {
  return "\"" + value.replace("\"", "\"\"") + "\"";
}

List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
  writer.write("combined,ada_embedding\n");
  for (String review : reviews) {
    var embedding =
        client
            .embeddings()
            .create(
                EmbeddingCreateParams.builder()
                    .model("text-embedding-3-small")
                    .inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
                    .build())
            .data()
            .get(0)
            .embedding();
    writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
  }
}
System.out.println(output);
来源示例13(csharp)
本段复用的中文释义:译释5、译释6、译释7。
// [中文] 对评论文本生成向量并写入CSV;ada_embedding是沿用示例的数据列名,不表示使用ada模型。
// [中文] 各语言的数据准备方式不同;Python沿用包含combined列的df,其他语言展示少量评论的保存流程。
using System.Text.Json;
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

string[] reviews = ["A rich cup of coffee.", "A bright herbal tea."];
Directory.CreateDirectory("output");
using StreamWriter writer = new("output/embedded_1k_reviews.csv");
await writer.WriteLineAsync("combined,ada_embedding");
foreach (string review in reviews)
{
    float[] vector = await EmbedAsync(client, review.Replace("\n", " ", StringComparison.Ordinal));
    string encoded = JsonSerializer.Serialize(vector);
    await writer.WriteLineAsync($"{CsvField(review)},{CsvField(encoded)}");
}
Console.WriteLine("Saved output/embedded_1k_reviews.csv");

static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
    OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
    return result.ToFloats().ToArray();
}

static string CsvField(string value) => "\"" + value.Replace("\"", "\"\"", StringComparison.Ordinal) + "\"";
来源示例14(ruby)
本段复用的中文释义:译释5、译释6。
## [中文] 对评论文本生成向量并写入CSV;ada_embedding是沿用示例的数据列名,不表示使用ada模型。
## [中文] 各语言的数据准备方式不同;Python沿用包含combined列的df,其他语言展示少量评论的保存流程。
require "csv"
require "fileutils"
require "json"
require "openai"

client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: reviews.map { |review| review.tr("\n", " ") }
)

FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
  csv << ["combined", "ada_embedding"]
  response.data.each do |embedding|
    csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
  end
end
从已保存的文件重新加载数据,可以运行:
来源示例15(python)
## [中文] 从CSV读取数据,用literal_eval解析向量的字面值,再用前文的NumPy别名np转换为数组。
from ast import literal_eval
import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(literal_eval).apply(np.array)
缩减嵌入向量的维度
较长的向量通常比短向量花费更多。例如,将向量存入向量存储以便检索时,向量越长,需要的计算、内存和存储资源通常越多。
两款第三代模型采用了允许开发者在性能与成本之间取舍的训练技术。创建向量时传入 dimensions 参数,可以缩短向量,相当于去掉序列末尾的一部分数值,同时保留表达概念的能力。例如,官方报告在 MTEB 基准上,将 text-embedding-3-large 缩短至 256 维后,其表现仍优于未经缩短的 1536 维 text-embedding-ada-002。维度与性能关系详见发布说明。
通常推荐在创建向量时使用 dimensions 参数。有些情况下需要在生成后手工改变维度;此时必须像下面示例一样对缩短后的向量重新归一化。
来源示例16(javascript)
程序中的自然语言译释8:
测试123。
// [中文] 先生成向量,截取前256个分量,再计算L2范数并重新归一化;范数为零时保留零向量。
// [中文] 这是生成后手工缩短的示例;创建时缩短优先使用dimensions参数。
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

// [中文] 只保留向量前256个分量。
const shortened = response.data[0].embedding.slice(0, 256);
// [中文] 计算截短向量的L2范数,随后用它归一化。
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
来源示例17(python)
本段复用的中文释义:译释8。
## [中文] 先生成向量,截取前256个分量,再计算L2范数并重新归一化;范数为零时保留零向量。
## [中文] 这是生成后手工缩短的示例;创建时缩短优先使用dimensions参数。
from openai import OpenAI
import numpy as np

client = OpenAI()


def normalize_l2(x):
    x = np.array(x)
    if x.ndim == 1:
        norm = np.linalg.norm(x)
        if norm == 0:
            return x
        return x / norm
    else:
        norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
        return np.where(norm == 0, x, x / norm)


response = client.embeddings.create(
    model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)

## [中文] 截取前256维,随后重新做L2归一化。
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)

print(norm_dim)
来源示例18(java)
本段复用的中文释义:译释8。
// [中文] 先截取前256维,再以double精度累计平方和并做L2归一化;零向量保持为零。
// [中文] Java原例为调用片段,需已有客户端及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;

private static List<Double> normalizeL2(List<Float> embedding) {
  double norm =
      Math.sqrt(embedding.stream().mapToDouble(value -> value.doubleValue() * value).sum());
  return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}

var embedding =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .input("Testing 123")
                .encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
                .build());

List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));
来源示例19(csharp)
本段复用的中文释义:译释8。
// [中文] 截取前256维后,以double精度计算范数并归一化,最后将double数组输出为JSON。
// [中文] 生成后手动截短需要重新归一化;创建时可优先使用dimensions参数。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");

float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => (double)value * value));
double[] normalized =
    magnitude == 0
        ? shortened.Select(value => (double)value).ToArray()
        : shortened.Select(value => value / magnitude).ToArray();

Console.WriteLine(System.Text.Json.JsonSerializer.Serialize(normalized));
来源示例20(ruby)
本段复用的中文释义:译释8。
## [中文] 先生成向量,截取前256个分量,再计算L2范数并重新归一化;范数为零时保留零向量。
## [中文] 这是生成后手工缩短的示例;创建时缩短优先使用dimensions参数。
require "openai"

client = OpenAI::Client.new

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: :float
)

shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }

puts(normalized)
动态调整维度使使用方式更灵活。例如,某向量数据库最多支持 1024 维,仍可以使用 text-embedding-3-large,并将 dimensions 设为 1024,使输出从默认的 3072 维缩短为 1024 维,以一定精度换取更小的向量。
使用嵌入搜索进行问答
在许多场景中,模型训练数据没有包含回答用户问题所需的关键事实。解决办法之一是将补充信息放入模型的上下文窗口。这对许多任务有效,但会增加词元成本。Question_answering_using_embeddings.ipynb 探讨了这种做法与基于嵌入向量进行搜索之间的取舍。
来源示例21(javascript)
程序中的自然语言译释9:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
程序中的自然语言译释10:
你负责回答有关2022年冬奥会的问题。
程序中的自然语言译释11:
哪些运动员获得了2022年冬奥会冰壶项目的金牌?
程序中的自然语言译释121:
使用下方文章回答问题。如果找不到答案,请说“我不知道”。
文章:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
// [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
// [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
来源示例22(python)
程序中的自然语言译释122:
使用下方有关2022年冬奥会的文章回答后续问题。如果找不到答案,请写“我不知道”。
文章:
[此处插入wikipedia_article_on_curling变量的文章正文]
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
本段复用的中文释义:译释10、译释11。
## [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
## [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."

Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""

response = client.chat.completions.create(
    messages=[
        {
            "role": "system",
            "content": "You answer questions about the 2022 Winter Olympics.",
        },
        {"role": "user", "content": query},
    ],
    model=GPT_MODEL,
    temperature=0,
)

print(response.choices[0].message.content)
来源示例23(go)
程序中的自然语言译释123:
使用文章回答问题。如果找不到答案,请写“我不知道”。
文章:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
本段复用的中文释义:译释9、译释10、译释11。
// [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
// [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "fmt"
    "log"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
        Model: "gpt-4.1-mini", Temperature: openai.Float(0), Messages: []openai.ChatCompletionMessageParamUnion{
            openai.SystemMessage("You answer questions about the 2022 Winter Olympics."),
            openai.UserMessage("Use the article to answer the question. If the answer cannot be found, write \"I don't know.\"\n\nArticle: At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?")},
    })
    if err != nil {
        return err
    }
    fmt.Println(completion.Choices[0].Message.Content)
    return nil
}
来源示例24(java)
程序中的自然语言译释124:
使用下方有关2022年冬奥会的文章回答后续问题。如果找不到答案,请写“我不知道”。
文章:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
本段复用的中文释义:译释9、译释10、译释11。
// [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
// [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

String article =
    "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
    "Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
        + "If the answer cannot be found, write \"I don't know.\"\n\n"
        + "Article:\n"
        + article
        + "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";

ChatCompletionCreateParams params =
    ChatCompletionCreateParams.builder()
        .model("gpt-4.1-mini")
        .addSystemMessage("You answer questions about the 2022 Winter Olympics.")
        .addUserMessage(question)
        .temperature(0)
        .build();

client.chat().completions().create(params).choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
来源示例25(csharp)
程序中的自然语言译释125:
使用文章回答问题。如果找不到答案,请写“我不知道”。
文章:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
本段复用的中文释义:译释9、译释10、译释11。
// [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
// [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-4.1-mini";
ChatClient client = new(model, key);

string article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
string query = $"Use the article to answer the question. If the answer cannot be found, write I don't know.\nArticle: {article}\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletion result = await client.CompleteChatAsync(
    [new SystemChatMessage("You answer questions about the 2022 Winter Olympics."), new UserChatMessage(query)],
    new ChatCompletionOptions { Temperature = 0 });
Console.WriteLine(result.Content[0].Text);
来源示例26(ruby)
程序中的自然语言译释126:
使用下方文章回答问题。如果找不到答案,请说“我不知道”。
文章:
在2022年冬奥会上,英国赢得女子冰壶金牌,瑞典赢得男子冰壶金牌。
问题:哪些运动员获得了2022年冬奥会冰壶项目的金牌?
本段复用的中文释义:译释9、译释10、译释11。
## [中文] 将冰壶赛事材料和问题一起放进用户消息,系统消息限定冬奥会问答;材料没有答案时要求回答不知道。
## [中文] 本段演示给模型补充上下文,尚未实现向量检索;先准备文章和本语言所需的客户端或前文变量。
require "openai"

client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
  Use the article below to answer the question. If the answer cannot be found, say "I don't know."

  Article:
  #{article}

  Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION

response = client.chat.completions.create(
  model: "gpt-4.1-mini",
  messages: [
    {
      role: :system,
      content: "You answer questions about the 2022 Winter Olympics."
    },
    {
      role: :user,
      content: question
    }
  ],
  temperature: 0
)

puts(response.choices.fetch(0).message.content)
使用嵌入向量搜索文本
为了取回最相关的文档,计算查询向量与各文档向量的余弦相似度,然后返回得分最高的文档。对应笔记本为 Semantic_text_search_using_embeddings.ipynb。
来源示例27(javascript)
程序中的自然语言译释12:
番茄酱中口感顺滑的豆子。
程序中的自然语言译释13:
带橙味的黑巧克力。
程序中的自然语言译释14:
美味的豆子。
本段复用的中文释义:译释5。
// [中文] 给查询与评论生成同一模型的向量,计算余弦相似度,按得分从高到低返回最相关评论。
// [中文] Python沿用df、get_embedding和cosine_similarity;其他语言的少量内置评论不是完整Amazon数据集。
import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

// [中文] 最后一个输入是查询,取它的向量与候选比较。
const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  // [中文] 将点积除以两个向量的L2范数乘积。
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
来源示例28(python)
本段复用的中文释义:译释14。
## [中文] 给查询与评论生成同一模型的向量,计算余弦相似度,按得分从高到低返回最相关评论。
## [中文] Python沿用df、get_embedding和cosine_similarity;其他语言的少量内置评论不是完整Amazon数据集。
def search_reviews(df, product_description, n=3, pprint=True):
    embedding = get_embedding(product_description, model="text-embedding-3-small")
    df["similarities"] = df.ada_embedding.apply(
        lambda x: cosine_similarity(x, embedding)
    )
    res = df.sort_values("similarities", ascending=False).head(n)
    return res


res = search_reviews(df, "delicious beans", n=3)
来源示例29(go)
程序中的自然语言译释15:
撒上海盐的酥脆饼干。
程序中的自然语言译释16:
加入香草、口味温和的奶酪。
程序中的自然语言译释17:
香辣烤坚果。
程序中的自然语言译释18:
口感清爽的气泡水。
本段复用的中文释义:译释5、译释6、译释12、译释13、译释14。
// [中文] 给查询与评论生成同一模型的向量,计算余弦相似度,按得分从高到低返回最相关评论。
// [中文] Python沿用df、get_embedding和cosine_similarity;其他语言的少量内置评论不是完整Amazon数据集。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "fmt"
    "log"
    "math"
    "sort"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    ctx := context.Background()
    texts := []string{"A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."}
    vectors := make([][]float64, len(texts))
    for i, text := range texts {
        vector, err := embedding(ctx, &client, text)
        if err != nil {
            return err
        }
        vectors[i] = vector
    }
    query, err := embedding(ctx, &client, "delicious beans")
    if err != nil {
        return err
    }
    matches := nearest(query, vectors)
    for _, match := range matches[:min(3, len(matches))] {
        fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
    }
    return nil
}

func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
    response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
    })
    if err != nil {
        return nil, err
    }
    return response.Data[0].Embedding, nil
}

func cosineSimilarity(a, b []float64) float64 {
    var dot, left, right float64
    for i := range a {
        dot += a[i] * b[i]
        left += a[i] * a[i]
        right += b[i] * b[i]
    }
    // [中文] 点积除以两个向量的范数乘积,得到余弦相似度。
    return dot / math.Sqrt(left*right)
}

type match struct {
    Index      int
    Similarity float64
}

func nearest(query []float64, vectors [][]float64) []match {
    matches := make([]match, len(vectors))
    for i, vector := range vectors {
        matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
    }
    sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
    return matches
}
来源示例30(java)
本段复用的中文释义:译释5、译释12、译释13、译释14。
// [中文] 给查询与评论生成同一模型的向量,计算余弦相似度,按得分从高到低返回最相关评论。
// [中文] Python沿用df、get_embedding和cosine_similarity;其他语言的少量内置评论不是完整Amazon数据集。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;

List<String> reviews =
    List.of(
        "A rich cup of coffee.",
        "Smooth beans in tomato sauce.",
        "Dark chocolate with orange.");
var reviewEmbeddings =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .inputOfArrayOfStrings(reviews)
                .build())
        .data();
List<Float> query =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .inputOfArrayOfStrings(List.of("delicious beans"))
                .build())
        .data()
        .get(0)
        .embedding();

IntStream.range(0, reviews.size())
    .boxed()
    .sorted(
        Comparator.comparingDouble(
                (Integer index) ->
                    cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
            .reversed())
    .limit(3)
    .map(reviews::get)
    .forEach(System.out::println);
来源示例31(csharp)
本段复用的中文释义:译释5、译释6、译释12、译释13、译释14、译释15、译释16、译释17、译释18。
// [中文] 为函数源码和自然语言查询生成同一模型的向量,按余弦相似度排序;乘法前转为double以提高累计精度。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

string[] texts = ["A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."];
OpenAIEmbeddingCollection batch = await client.GenerateEmbeddingsAsync(texts);
float[][] vectors = batch.Select(item => item.ToFloats().ToArray()).ToArray();
float[] query = await EmbedAsync(client, "delicious beans");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
    Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}

static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
    OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
    return result.ToFloats().ToArray();
}

static double CosineSimilarity(float[] left, float[] right)
{
    double dot = 0, leftNorm = 0, rightNorm = 0;
    for (int i = 0; i < left.Length; i++)
    {
        dot += (double)left[i] * right[i];
        leftNorm += (double)left[i] * left[i];
        rightNorm += (double)right[i] * right[i];
    }
    return dot / Math.Sqrt(leftNorm * rightNorm);
}
来源示例32(ruby)
本段复用的中文释义:译释5、译释12、译释13、译释14。
## [中文] 给查询与评论生成同一模型的向量,计算余弦相似度,按得分从高到低返回最相关评论。
## [中文] Python沿用df、get_embedding和cosine_similarity;其他语言的少量内置评论不是完整Amazon数据集。
require "openai"

client = OpenAI::Client.new
reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange."
]

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: reviews + ["delicious beans"]
)

query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
  dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
  magnitude = Math.sqrt(embedding.sum { |value| value**2 })
  query_magnitude = Math.sqrt(query.sum { |value| value**2 })
  dot_product / (magnitude * query_magnitude)
end

results = reviews.map.with_index do |review, index|
  {
    review: review,
    score: similarity.call(response.data.fetch(index).embedding)
  }
end.sort_by { |result| -result.fetch(:score) }.first(3)

puts(results)
使用嵌入向量搜索代码
代码搜索的工作方式与文本搜索类似。Code_search.ipynb 给出从仓库各 Python 文件中提取函数的方法,再使用 text-embedding-3-small 对每个函数建立向量索引。
搜索时,用同一模型将自然语言查询转换成向量,再计算它与每个函数向量之间的余弦相似度。余弦相似度最高的函数最相关。
来源示例33(javascript)
程序中的自然语言译释19:
Completions API测试。
// [中文] 给函数源码与自然语言查询生成向量,按余弦相似度对源码排序;代码字符串是被搜索的数据。
// [中文] Python沿用含code列的df及前文辅助函数;本段未包含遍历仓库提取函数的实现。
import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

// [中文] 最后一个输入是查询,取它的向量与候选比较。
const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  // [中文] 将点积除以两个向量的L2范数乘积。
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
来源示例34(python)
本段复用的中文释义:译释19。
## [中文] 给函数源码与自然语言查询生成向量,按余弦相似度对源码排序;代码字符串是被搜索的数据。
## [中文] Python沿用含code列的df及前文辅助函数;本段未包含遍历仓库提取函数的实现。
df["code_embedding"] = df["code"].apply(
    lambda x: get_embedding(x, model="text-embedding-3-small")
)


def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
    embedding = get_embedding(code_query, model="text-embedding-3-small")
    df["similarities"] = df.code_embedding.apply(
        lambda x: cosine_similarity(x, embedding)
    )

    res = df.sort_values("similarities", ascending=False).head(n)
    return res


res = search_functions(df, "Completions API tests", n=3)
来源示例35(go)
本段复用的中文释义:译释19。
// [中文] 给函数源码与自然语言查询生成向量,按余弦相似度对源码排序;代码字符串是被搜索的数据。
// [中文] Python沿用含code列的df及前文辅助函数;本段未包含遍历仓库提取函数的实现。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "fmt"
    "log"
    "math"
    "sort"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    ctx := context.Background()
    texts := []string{"def add(a, b): return a + b", "def complete(prompt): return prompt"}
    vectors := make([][]float64, len(texts))
    for i, text := range texts {
        vector, err := embedding(ctx, &client, text)
        if err != nil {
            return err
        }
        vectors[i] = vector
    }
    query, err := embedding(ctx, &client, "Completions API tests")
    if err != nil {
        return err
    }
    matches := nearest(query, vectors)
    for _, match := range matches[:min(3, len(matches))] {
        fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
    }
    return nil
}

func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
    response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
    })
    if err != nil {
        return nil, err
    }
    return response.Data[0].Embedding, nil
}

func cosineSimilarity(a, b []float64) float64 {
    var dot, left, right float64
    for i := range a {
        dot += a[i] * b[i]
        left += a[i] * a[i]
        right += b[i] * b[i]
    }
    // [中文] 点积除以两个向量的范数乘积,得到余弦相似度。
    return dot / math.Sqrt(left*right)
}

type match struct {
    Index      int
    Similarity float64
}

func nearest(query []float64, vectors [][]float64) []match {
    matches := make([]match, len(vectors))
    for i, vector := range vectors {
        matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
    }
    sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
    return matches
}
来源示例36(java)
本段复用的中文释义:译释19。
// [中文] 给函数源码与自然语言查询生成向量,按余弦相似度对源码排序;代码字符串是被搜索的数据。
// [中文] Python沿用含code列的df及前文辅助函数;本段未包含遍历仓库提取函数的实现。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;

List<String> functions =
    List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .inputOfArrayOfStrings(functions)
                .build())
        .data();
List<Float> query =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .input("Completions API tests")
                .build())
        .data()
        .get(0)
        .embedding();
IntStream.range(0, functions.size())
    .boxed()
    .sorted(
        Comparator.comparingDouble(
                (Integer index) ->
                    cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
            .reversed())
    .map(functions::get)
    .forEach(System.out::println);
来源示例37(csharp)
本段复用的中文释义:译释19。
// [中文] 以源字符串的向量查找最近邻;点积和范数使用double精度,候选仍包含源字符串自身。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

string[] texts = ["def add(a, b): return a + b", "def complete(prompt): return prompt"];
List<float[]> vectors = [];
foreach (string text in texts)
{
    vectors.Add(await EmbedAsync(client, text));
}
float[] query = await EmbedAsync(client, "Completions API tests");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
    Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}

static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
    OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
    return result.ToFloats().ToArray();
}

static double CosineSimilarity(float[] left, float[] right)
{
    double dot = 0, leftNorm = 0, rightNorm = 0;
    for (int i = 0; i < left.Length; i++)
    {
        dot += (double)left[i] * right[i];
        leftNorm += (double)left[i] * left[i];
        rightNorm += (double)right[i] * right[i];
    }
    return dot / Math.Sqrt(leftNorm * rightNorm);
}
来源示例38(ruby)
本段复用的中文释义:译释19。
## [中文] 给函数源码与自然语言查询生成向量,按余弦相似度对源码排序;代码字符串是被搜索的数据。
## [中文] Python沿用含code列的df及前文辅助函数;本段未包含遍历仓库提取函数的实现。
require "openai"

client = OpenAI::Client.new
functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }"
]

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: functions + ["Completions API tests"]
)

query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
  dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
  magnitude = Math.sqrt(embedding.sum { |value| value**2 })
  query_magnitude = Math.sqrt(query.sum { |value| value**2 })
  dot_product / (magnitude * query_magnitude)
end

results = functions.map.with_index do |source, index|
  {
    source: source,
    score: similarity.call(response.data.fetch(index).embedding)
  }
end.sort_by { |result| -result.fetch(:score) }

puts(results)
使用嵌入向量进行推荐
向量距离越短,表示内容越相似,因此嵌入向量也适合推荐任务。Recommendation_using_embeddings.ipynb 展示一个基础推荐器:输入字符串列表和一个“源”字符串,计算各自的向量,再按照与源字符串的相似度从高到低排序。
笔记本中的具体示例使用 AG 新闻数据集,抽样保留 2,000 条新闻描述,为任一源新闻返回最相似的 5 篇文章。
来源示例39(javascript)
程序中的自然语言译释20:
猎豹是一种奔跑很快的陆地动物。
程序中的自然语言译释21:
游隼是一种飞行很快的鸟。
程序中的自然语言译释22:
陆龟移动缓慢。
// [中文] 选择一个源字符串的向量,与全部候选向量比较并排序;示例没有排除源字符串本身。
// [中文] Python依赖embedding_from_string及embeddings_utils.py中的距离和近邻辅助函数。
import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

// [中文] 以第一个字符串作为推荐查询,候选仍包含它自身。
const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
来源示例40(python)
程序中的自然语言译释23:
返回给定字符串的最近邻。
## [中文] 选择一个源字符串的向量,与全部候选向量比较并排序;示例没有排除源字符串本身。
## [中文] Python依赖embedding_from_string及embeddings_utils.py中的距离和近邻辅助函数。
def recommendations_from_strings(
    strings: list[str],
    index_of_source_string: int,
    model="text-embedding-3-small",
) -> list[int]:
    """Return nearest neighbors of a given string."""

    # [中文] 为全部候选字符串生成向量。
    # get embeddings for all strings
    embeddings = [embedding_from_string(string, model=model) for string in strings]

    # [中文] 取出源字符串对应的查询向量。
    # get the embedding of the source string
    query_embedding = embeddings[index_of_source_string]

    # [中文] 调用embeddings_utils.py的函数,计算源向量与候选向量的余弦距离。
    # get distances between the source embedding and other embeddings (function from embeddings_utils.py)
    distances = distances_from_embeddings(
        query_embedding, embeddings, distance_metric="cosine"
    )

    # [中文] 调用辅助函数,得到按距离排列的近邻索引。
    # get indices of nearest neighbors (function from embeddings_utils.py)
    indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
        distances
    )
    return indices_of_nearest_neighbors
来源示例41(go)
本段复用的中文释义:译释20、译释21、译释22。
// [中文] 选择一个源字符串的向量,与全部候选向量比较并排序;示例没有排除源字符串本身。
// [中文] Python依赖embedding_from_string及embeddings_utils.py中的距离和近邻辅助函数。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "fmt"
    "log"
    "math"
    "sort"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    ctx := context.Background()
    texts := []string{"A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."}
    vectors := make([][]float64, len(texts))
    for i, text := range texts {
        vector, err := embedding(ctx, &client, text)
        if err != nil {
            return err
        }
        vectors[i] = vector
    }
    query := vectors[0]
    matches := nearest(query, vectors)
    for _, match := range matches {
        fmt.Println(match.Index)
    }
    return nil
}

func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
    response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
    })
    if err != nil {
        return nil, err
    }
    return response.Data[0].Embedding, nil
}

func cosineSimilarity(a, b []float64) float64 {
    var dot, left, right float64
    for i := range a {
        dot += a[i] * b[i]
        left += a[i] * a[i]
        right += b[i] * b[i]
    }
    // [中文] 点积除以两个向量的范数乘积,得到余弦相似度。
    return dot / math.Sqrt(left*right)
}

type match struct {
    Index      int
    Similarity float64
}

func nearest(query []float64, vectors [][]float64) []match {
    matches := make([]match, len(vectors))
    for i, vector := range vectors {
        matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
    }
    sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
    return matches
}
来源示例42(java)
本段复用的中文释义:译释20、译释21、译释22。
// [中文] 按余弦距离为文本排序;先将各维分量提升为double,再累计点积与平方和。
// [中文] Java原例为调用片段,需适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;

List<String> strings =
    List.of(
        "A cheetah is a fast land animal.",
        "A peregrine falcon is a fast bird.",
        "A tortoise moves slowly.");

var embeddings =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .inputOfArrayOfStrings(strings)
                .build())
        .data();

List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
    IntStream.range(0, embeddings.size())
        .boxed()
        .sorted(
            Comparator.comparingDouble(
                (Integer index) -> {
                  List<Float> candidate = embeddings.get(index).embedding();
                  double dotProduct = 0;
                  double queryMagnitude = 0;
                  double candidateMagnitude = 0;
                  for (int dimension = 0; dimension < query.size(); dimension++) {
                    double queryValue = query.get(dimension);
                    double candidateValue = candidate.get(dimension);
                    dotProduct += queryValue * candidateValue;
                    queryMagnitude += queryValue * queryValue;
                    candidateMagnitude += candidateValue * candidateValue;
                  }
                  return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
                }))
        .toList();

System.out.println(nearestNeighbors);
来源示例43(csharp)
本段复用的中文释义:译释20、译释21、译释22。
// [中文] 比较待分类评论与正负标签向量;乘法前转为double,再累计点积和范数。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

string[] texts = ["A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."];
List<float[]> vectors = [];
foreach (string text in texts)
{
    vectors.Add(await EmbedAsync(client, text));
}
float[] query = vectors[0];
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked)
{
    Console.WriteLine(match.Index);
}

static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
    OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
    return result.ToFloats().ToArray();
}

static double CosineSimilarity(float[] left, float[] right)
{
    double dot = 0, leftNorm = 0, rightNorm = 0;
    for (int i = 0; i < left.Length; i++)
    {
        dot += (double)left[i] * right[i];
        leftNorm += (double)left[i] * left[i];
        rightNorm += (double)right[i] * right[i];
    }
    return dot / Math.Sqrt(leftNorm * rightNorm);
}
来源示例44(ruby)
本段复用的中文释义:译释20、译释21、译释22。
## [中文] 选择一个源字符串的向量,与全部候选向量比较并排序;示例没有排除源字符串本身。
## [中文] Python依赖embedding_from_string及embeddings_utils.py中的距离和近邻辅助函数。
require "openai"

client = OpenAI::Client.new
strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly."
]

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: strings
)

query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
  dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
  magnitude = Math.sqrt(embedding.sum { |value| value**2 })
  query_magnitude = Math.sqrt(query.sum { |value| value**2 })
  dot_product / (magnitude * query_magnitude)
end

recommendations = response.data.map.with_index do |embedding, index|
  {
    index: index,
    text: strings.fetch(index),
    similarity: similarity.call(embedding.embedding)
  }
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }

puts(recommendations)
二维数据可视化
向量的大小会随底层模型复杂程度而变化。Visualizing_embeddings_in_2D.ipynb 使用 t-SNE 算法,将高维数据转换为二维坐标,以便可视化。
按评论星级为各点着色:
- 1 星:红色。
- 2 星:深橙色。
- 3 星:金色。
- 4 星:蓝绿色。
- 5 星:深绿色。
示例可视化大致形成三个簇,其中一个主要由负面评论构成。
来源示例45(python)
程序中的自然语言译释24:
使用t-SNE对Amazon评论评分的语言向量进行可视化。
## [中文] 用literal_eval解析CSV中的向量,再通过t-SNE投影到二维并按评分绘图。
## [中文] 本段依赖含Score列的评论CSV,简化示例中仅含combined和ada_embedding的文件不能直接替代。
from ast import literal_eval
import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(literal_eval).to_list())

## Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")
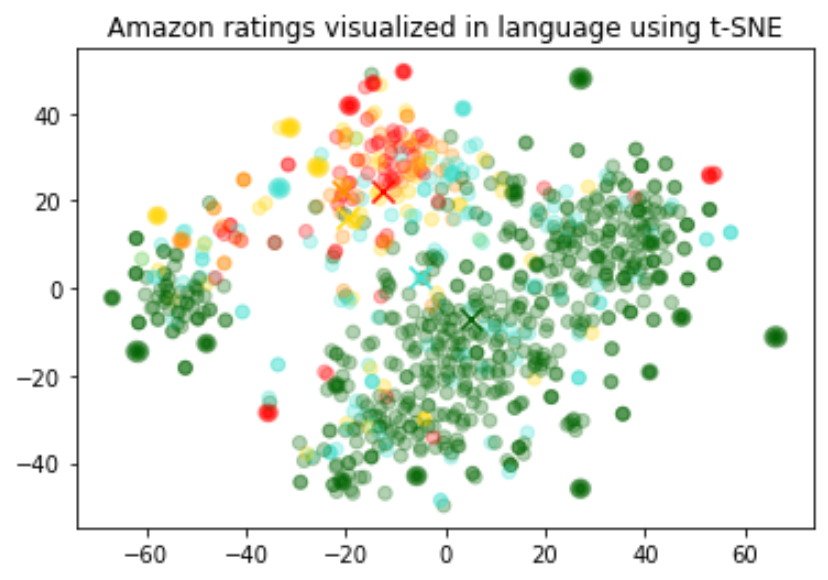
图:评论向量的二维投影。颜色对应1至5星评分;原图约呈现三个簇,其中一个以负面评论为主。
将嵌入向量用作机器学习的文本特征编码器
Regression_using_embeddings.ipynb 展示将向量作为通用自由文本特征编码器的做法。当机器学习模型的部分相关输入为自由文本时,加入嵌入向量可以改善模型表现。嵌入向量也能编码类别特征;当类别名称本身有意义且数量很多(例如职位名称)时,这种用法尤其有价值。官方示例指出,在该任务中,相似度嵌入通常优于搜索嵌入。
官方观察到,向量表示通常信息丰富且密集。例如,用 SVD 或 PCA 将输入维度减少 10%,通常也会使特定下游任务的表现下降。这里保留官方数据集实验的观察,不将其写成所有数据集的保证。
下面先划分训练集和测试集,供随后的回归与分类示例使用。
来源示例46(python)
## [中文] 使用已有df中的向量与评分,以固定随机种子划分80%训练集和20%测试集,供后续两段使用。
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
使用嵌入特征进行回归
向量也可用于预测数值。这里根据评论正文预测星级。由于向量包含丰富的语义信息,即使评论数量不多,也能取得一定预测效果。
示例将评分视为 1 到 5 之间的连续变量,允许算法预测浮点数。机器学习算法最小化预测值与真实评分之间的距离。官方示例实验的平均绝对误差为 0.39,即平均相差不到半颗星。
来源示例47(python)
## [中文] 创建100棵树的随机森林回归器,在前文训练集拟合,再对测试向量预测连续评分。
from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
## [中文] 使用训练集向量与星级拟合回归器。
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)
使用嵌入特征进行分类
Classification_using_embeddings.ipynb 不再预测 1 到 5 之间任意数值,而是将评论划分为 1 星至 5 星五个类别。
训练后,模型对 1 星和 5 星评论的预测明显好于情感更细微的 2 至 4 星评论,可能是因为极端评分的情感表达更强烈。
来源示例48(python)
## [中文] 创建100棵树的随机森林分类器,在前文训练集拟合,再对测试向量预测离散星级。
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
## [中文] 使用训练集向量与星级拟合分类器。
clf.fit(X_train, y_train)
preds = clf.predict(X_test)
零样本分类
Zero-shot_classification_with_embeddings.ipynb 展示如何在没有已标注训练数据时分类。先为各类别的名称或简短说明生成向量,再将新文本的向量与各类别向量比较,选择相似度最高的类别。
来源示例49(javascript)
程序中的自然语言译释25:
负面。
程序中的自然语言译释26:
正面。
程序中的自然语言译释27:
咖啡很快送到了,味道也很好。
// [中文] 为正面和负面标签生成向量,再与评论向量比较;选择更相似的标签作为零样本分类结果。
// [中文] Python还把评分映射为情感标签并去掉3星评论;各语言的待分类示例文本不完全相同。
import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

// [中文] 最后一个输入是待分类评论,前两个输入为类别标签。
const review = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  // [中文] 将点积除以两个向量的L2范数乘积。
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
来源示例50(python)
程序中的自然语言译释28:
示例评论。
本段复用的中文释义:译释25、译释26。
## [中文] 为正面和负面标签生成向量,再与评论向量比较;选择更相似的标签作为零样本分类结果。
## [中文] Python还把评分映射为情感标签并去掉3星评论;各语言的待分类示例文本不完全相同。
df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
    {1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)

labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]


def label_score(review_embedding, label_embeddings):
    return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
        review_embedding, label_embeddings[0]
    )


prediction = (
    "positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)
来源示例51(go)
本段复用的中文释义:译释25、译释26、译释28。
// [中文] 为正面和负面标签生成向量,再与评论向量比较;选择更相似的标签作为零样本分类结果。
// [中文] Python还把评分映射为情感标签并去掉3星评论;各语言的待分类示例文本不完全相同。
// [中文] 本Go片段省略package声明;作为独立程序使用时需补上适当的包声明。
import (
    "context"
    "fmt"
    "log"
    "math"

    "github.com/openai/openai-go/v3"
)

func main() {
    if err := run(); err != nil {
        log.Fatal(err)
    }
}

func run() error {
    client := openai.NewClient()
    ctx := context.Background()
    negative, err := embedding(ctx, &client, "negative")
    if err != nil {
        return err
    }
    positive, err := embedding(ctx, &client, "positive")
    if err != nil {
        return err
    }
    review, err := embedding(ctx, &client, "Sample Review")
    if err != nil {
        return err
    }
    score := cosineSimilarity(review, positive) - cosineSimilarity(review, negative)
    prediction := "negative"
    if score > 0 {
        prediction = "positive"
    }
    fmt.Println(prediction)
    return nil
}

func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
    response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
        Model: openai.EmbeddingModelTextEmbedding3Small,
        Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
    })
    if err != nil {
        return nil, err
    }
    return response.Data[0].Embedding, nil
}

func cosineSimilarity(a, b []float64) float64 {
    var dot, left, right float64
    for i := range a {
        dot += a[i] * b[i]
        left += a[i] * a[i]
        right += b[i] * b[i]
    }
    // [中文] 点积除以两个向量的范数乘积,得到余弦相似度。
    return dot / math.Sqrt(left*right)
}
来源示例52(java)
本段复用的中文释义:译释25、译释26、译释28。
// [中文] 为正面和负面标签生成向量,再与评论向量比较;选择更相似的标签作为零样本分类结果。
// [中文] Python还把评分映射为情感标签并去掉3星评论;各语言的待分类示例文本不完全相同。
// [中文] Java原例为API调用片段,需已有client及适用的外层类或方法;未作为独立Java文件编译。
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;

var embeddings =
    client
        .embeddings()
        .create(
            EmbeddingCreateParams.builder()
                .model("text-embedding-3-small")
                .inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
                .build())
        .data();

List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");
来源示例53(csharp)
本段复用的中文释义:译释25、译释26、译释28。
// [中文] 计算向量余弦相似度;乘法前转为double,再累计点积和范数。
using OpenAI.Embeddings;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);

float[] negative = await EmbedAsync(client, "negative");
float[] positive = await EmbedAsync(client, "positive");
float[] review = await EmbedAsync(client, "Sample Review");
double score = CosineSimilarity(review, positive) - CosineSimilarity(review, negative);
Console.WriteLine(score > 0 ? "positive" : "negative");

static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
    OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
    return result.ToFloats().ToArray();
}

static double CosineSimilarity(float[] left, float[] right)
{
    double dot = 0, leftNorm = 0, rightNorm = 0;
    for (int i = 0; i < left.Length; i++)
    {
        dot += (double)left[i] * right[i];
        leftNorm += (double)left[i] * left[i];
        rightNorm += (double)right[i] * right[i];
    }
    return dot / Math.Sqrt(leftNorm * rightNorm);
}
来源示例54(ruby)
本段复用的中文释义:译释25、译释26、译释27。
## [中文] 为正面和负面标签生成向量,再与评论向量比较;选择更相似的标签作为零样本分类结果。
## [中文] Python还把评分映射为情感标签并去掉3星评论;各语言的待分类示例文本不完全相同。
require "openai"

client = OpenAI::Client.new
labels = ["negative", "positive"]

response = client.embeddings.create(
  model: "text-embedding-3-small",
  input: labels + ["The coffee arrived quickly and tastes great."]
)

review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
  dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
  magnitude = Math.sqrt(embedding.sum { |value| value**2 })
  review_magnitude = Math.sqrt(review.sum { |value| value**2 })
  dot_product / (magnitude * review_magnitude)
end

negative, positive = response.data.first(2).map do |embedding|
  similarity.call(embedding.embedding)
end
puts((positive > negative) ? "positive" : "negative")
为冷启动推荐获取用户与产品向量
对某用户的全部评论向量取平均,可得到用户向量;对某产品的全部评论向量取平均,可得到产品向量。User_and_product_embeddings.ipynb 使用 50,000 条评论的子集,使每个用户和产品覆盖更多评论。
在独立测试集上,示例按评分绘制用户向量与产品向量的相似度,以评估这种表示是否有用。实验表明,即使用户尚未收到产品,这种方法也能以优于随机猜测的水平预测用户是否喜欢该产品。
来源示例55(python)
## [中文] 按UserId和ProductId分组,分别对该组评论向量求平均,得到用户向量和产品向量。
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)
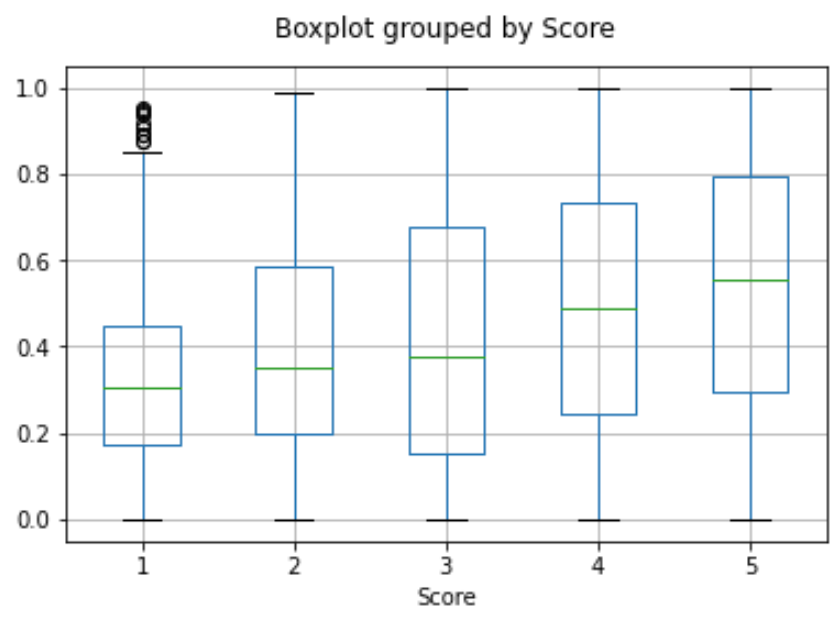
图:按评分分组,观察用户向量与产品向量相似度的分布,用于评估冷启动推荐方法。
聚类
聚类用于理解大量文本数据。向量为各段文本提供有语义意义的表示,因此可以在无监督情况下发现数据中的潜在分组。
Clustering.ipynb 示例发现四个不同簇:一个围绕狗粮,一个围绕负面评论,另两个围绕正面评论。
来源示例56(python)
## [中文] 将评论向量堆叠为矩阵,用KMeans分成4簇,再将每条记录的簇编号写回df。
import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
## [中文] 在评论向量矩阵上拟合聚类模型。
kmeans.fit(matrix)
## [中文] 把KMeans给出的簇编号写回每条评论。
df["Cluster"] = kmeans.labels_
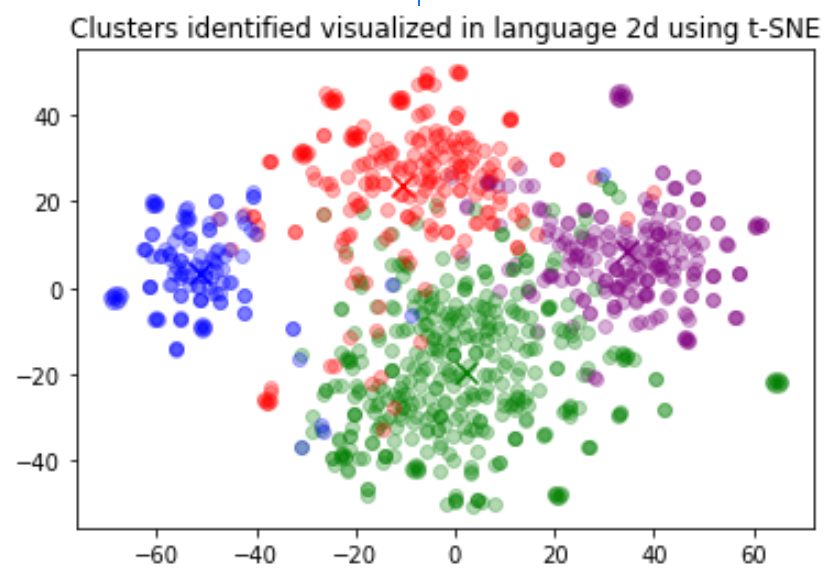
图:四个簇的二维可视化。对应示例发现的分组分别与狗粮、负面评论以及两组正面评论有关。
常见问题
生成向量前,如何知道字符串包含多少词元?
在 Python 中,可用 OpenAI 的分词器 tiktoken将字符串拆分为词元。
来源示例57(python)
程序中的自然语言译释29:
返回文本字符串的词元数量。
程序中的自然语言译释30:
tiktoken很棒!
## [中文] 加载指定分词编码,编码字符串并统计词元个数;cl100k_base适用于第三代嵌入模型。
import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")
text-embedding-3-small 等第三代嵌入模型使用 cl100k_base 编码。更多说明和代码见 Cookbook 的使用 tiktoken 统计词元。
如何快速检索最近的 K 个向量?
要快速搜索大量向量,官方推荐使用向量数据库。Cookbook 的向量数据库示例介绍了如何结合向量数据库和 OpenAI API 使用。
应该选择哪一种距离函数?
官方推荐余弦相似度。距离函数的选择通常不会带来很大差别。
OpenAI 嵌入向量已归一化为单位长度,因此:
- 只计算点积就能稍快地求出余弦相似度。
- 按余弦相似度与欧氏距离排序,得到的顺序相同。
可以把自己的向量公开到网上吗?
可以。客户拥有输入模型的数据和模型输出,嵌入向量也包含在内。你需要确保发送给 API 的内容不违反适用法律和使用条款。
第三代嵌入模型了解近期事件吗?
text-embedding-3-large 和 text-embedding-3-small 不掌握 2021 年 9 月之后发生的事件。与文本生成模型相比,这通常不构成同等程度的限制,但在个别边缘场景中可能降低表现。
本章关联阅读:文件搜索。
















更多建议: