
 TRAE-AI编程



OpenAI Promptfoo 入门
Promptfoo是用于评测和红队测试 AI 应用、智能体的开源库。可定义测试案例和检查项,衡量行为、比较模型或提示词、调查失败,也能用对抗输入探查安全风险。Promptfoo 是 OpenAI 的一部分。
本指南从小型评测开始:在终端运行翻译示例,或让 Codex 为应用建立评测。
从命令行开始
安装 Node.js 22.22.0或更新版本,然后选择运行方式。示例会用测试案例比较不同模型的翻译。
来源示例 1(bash):
## [中文] 用Node.js方式初始化翻译评测示例;需Node.js 22.22.0或更新版本。
npx promptfoo@latest init --example getting-started
cd getting-started
使用Python方式时,激活Python 3.10+虚拟环境;pip包装器同样需要Node.js 22.22.0或更新版本。
来源示例 2(bash):
## [中文] 在Python 3.10+虚拟环境使用包装器;仍需满足Node.js版本要求。
pip install promptfoo
promptfoo init --example getting-started
cd getting-started
示例创建promptfooconfig.yaml,包含翻译提示词、模型提供商和测试案例。每个测试含检查预期短语的断言。在终端配置OpenAI API密钥,使用自己的密钥替换占位符:
来源示例 3(bash):
## [中文] 为当前终端设置OPENAI_API_KEY;替换密钥占位符,勿把真实密钥写入共享稿件。
export OPENAI_API_KEY="<your-api-key>"
运行评测并打开结果查看器。实际运行会调用模型并产生API费用。
来源示例 4(bash):
## [中文] 运行评测并打开结果查看器;实际模型调用会产生API费用。
npx promptfoo@latest eval
npx promptfoo@latest view
来源示例 5(bash):
## [中文] 通过Python包装器运行评测和结果查看器,查看断言与延迟,实际调用有费用。
promptfoo eval
promptfoo view
打开本地URL比较输出,检查各断言是否通过。也要直接检查回答本身:通过断言仅说明满足特定条件,不代表整体质量合格。修改配置中的提示词或案例后重新评测。
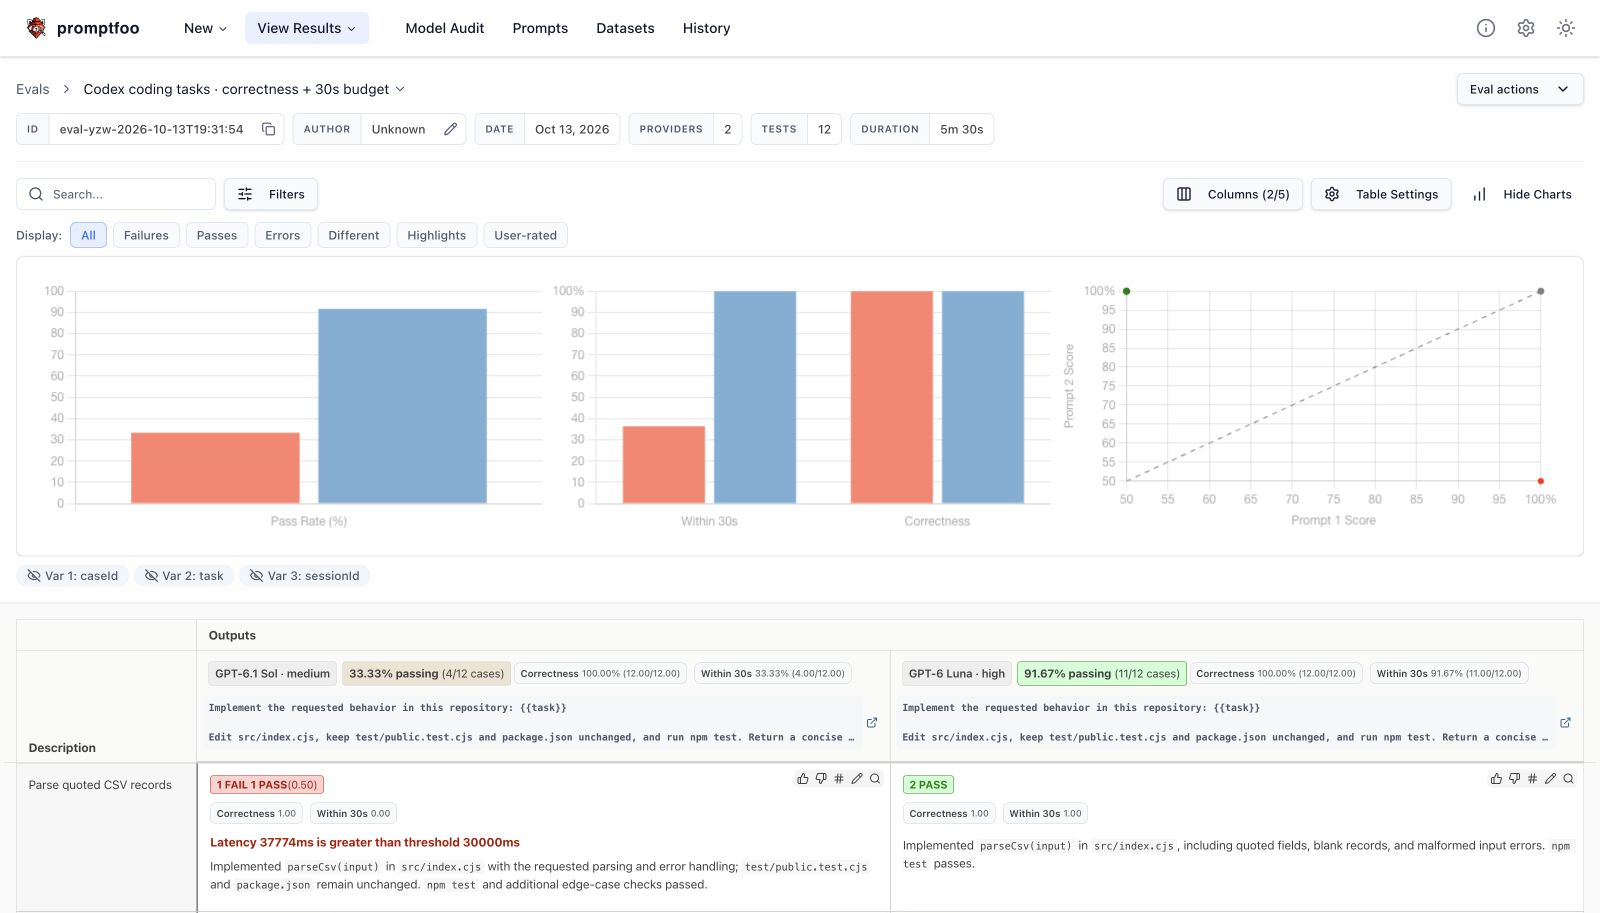
另一个Codex app-server评测在12项编程任务中比较gpt-6.1-sol(medium)和gpt-6-luna(high),同时检查可执行正确性和30秒时间预算。所有实现都通过代码检查;红色结果表示超时,不表示代码错误。
从 Codex 应用开始
通过 Promptfoo插件为Codex提供设置和运行评测的技能。选择 Open in Codex 开始新任务,或 Copy prompt 将提示词粘贴到现有任务。
入门提示词:
来源示例 6(text):
本例中文译文:使用Promptfoo评测并改进此应用的一项重要AI工作流。阅读仓库指令,复用现有评测配置。选择一种面向用户的行为进行测试;目标不清时先问我。根据应用输入建立案例,覆盖常见请求、边界和对抗输入,并用断言定义成功。
运行基线、检查失败,再针对提示词或配置测试一项变更。使用完全相同的案例和断言比较两个版本,报告改善和回归,有数据时包括延迟和费用。保持断言不变,以保证比较有效。
打开带图表的结果,展示具体前后例子并建议保留哪个版本;若没有改善,应明确说明。
Use Promptfoo to evaluate and improve an important AI workflow in this application.

Read the repository instructions and reuse any existing eval setup. Choose a user-facing behavior to test, asking me if the goal is unclear. Build test cases based on the application's inputs, covering common requests, edge cases, and adversarial inputs. Define success with assertions that check the expected behavior.

Run a baseline, inspect the failures, and test one targeted change to the prompt or configuration. Compare both versions using the same cases and assertions. Report improvements and regressions, including latency and cost when available. Keep the assertions fixed so the comparison stays meaningful.

Open the results with charts. Show a few concrete before-and-after examples and recommend which version to keep. If the change does not improve the results, say so.
Codex可能需要你提供凭证或批准环境配置。调用模型的评测可能产生API费用。
















更多建议: