
 TRAE-AI编程



OpenAI 推理最佳实践
本指南介绍推理与非推理模型的分工、适用任务和提示方法。官方原页主要以 o1、o3、o4-mini 与 GPT-4.1、GPT-4o 等较早代际举例;其中“GPT模型”特指该语境中的非推理模型,不能据此认为当前所有 GPT 命名模型都不具备推理能力。当前家族的能力与可用性应结合模型目录和推理模型指南判断。
推理模型与非推理 GPT 模型
o 系列更侧重为复杂任务投入推理:制订策略、规划解决方案,以及根据大量含糊信息作出判断。在数学、科学、工程、金融和法律等需要专业判断的任务中,这类能力可能特别有用,但模型输出仍需按应用要求验证。
较低延迟、成本更低的非推理 GPT 模型更偏向直接执行明确任务。一个工作流可以用推理模型制订计划,再由适合速度与成本要求的模型执行各步骤;两类模型是分工差异,不是所有任务上的单一优劣排序。
怎样选择
| 主要要求 | 原页建议的方向 |
|---|---|
| 速度与成本 | 较低延迟、经济的 GPT 执行模型 |
| 明确定义的任务 | 擅长直接执行明确指令的模型 |
| 准确性与可靠判断 | 在代表性评测中验证推理模型 |
| 复杂、多步骤、含糊的问题 | 可投入更多推理的模型 |
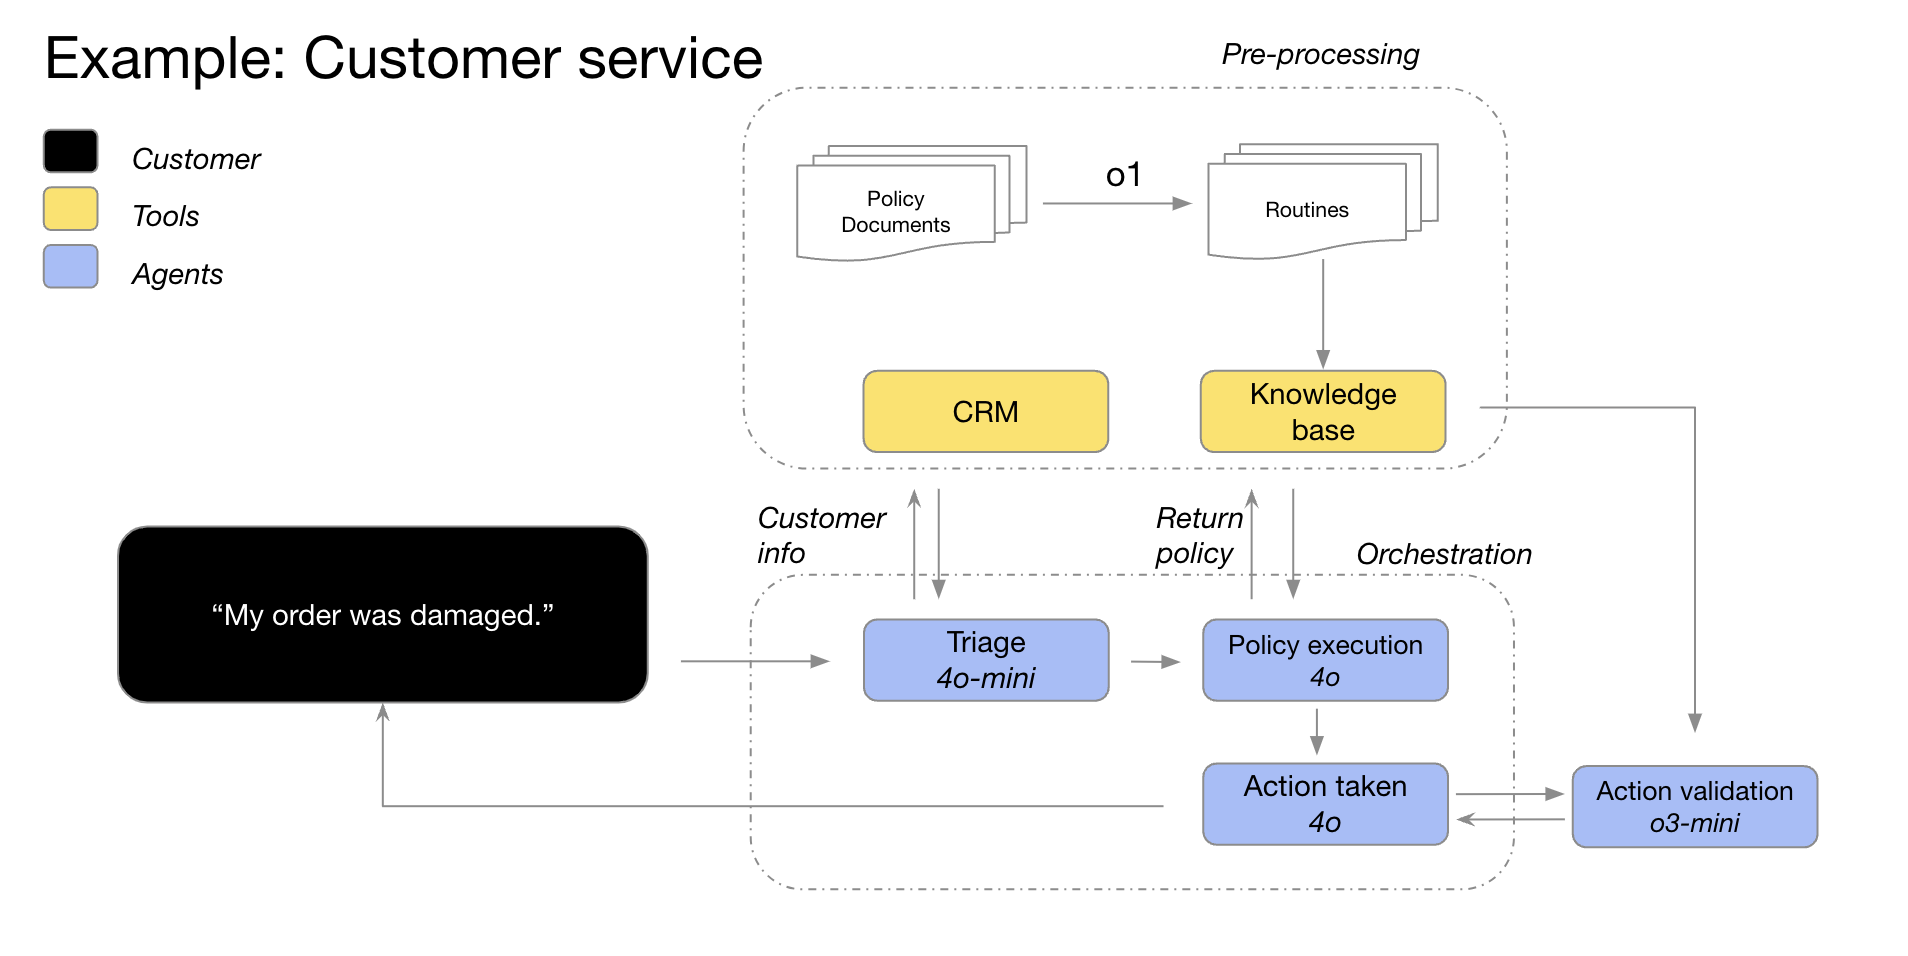
实际应用可以混合使用。例如,原页的客服示意使用 GPT-4o 与 GPT-4o mini 汇总订单、客户、问题与退货政策,再由 o3-mini 判断退货是否符合政策。
何时使用推理模型
以下为原页收集的客户实践与内部观察,不是覆盖全部用途的清单,也不是对任何新项目效果的保证。客户数字保留其案例语境。
1. 处理含糊的任务
当输入信息有限、来源分散或指令存在缺口时,推理模型通常能结合上下文理解意图,也可能先提澄清问题,避免无依据猜测。
Hebbia介绍,在法律与金融知识平台 Matrix 中,o1 可用基础提示词从密集的信贷协议中找出受限支付能力下的可用额度安排,并产出详细、结构清楚的回答。该公司报告,在52%的复杂协议提示上,o1 相比其他模型取得更强结果。
2. 从大量信息中找出关键细节
面对大量非结构化材料时,推理模型可帮助筛选与问题最相关的信息。
Endex的收购分析案例中,o1 检查数十份合同与租约,在脚注发现关键的控制权变更条款:公司出售后,一笔7,500万美元贷款需要立即清偿。案例强调的是从细节中识别可能影响交易的条件。
3. 理解大型数据集中的关联与细微差别
合同、财务报表、保险理赔等材料可能包含数百页密集信息。推理模型可跨文档比较,整合单份文档中并不直接显现的关系,并将政策规则应用到实际问题。
Blue J报告,将税务研究流程从 GPT-4o 切换到 o1 后,跨文档综合推理的端到端表现提高约4倍。该数字属于其报告的特定系统评测。
BlueFlame AI在融资稀释分析中比较约10个模型。任务涉及融资前后估值、反稀释权及循环稀释计算,人工分析可能耗时20—30分钟;该公司介绍,o1 与 o3-mini 能给出计算表,说明对持有10万美元股份者的影响。
4. 多步骤智能体规划
推理模型可担任规划者:拆解问题、制订多步方案,再按各步骤对智能和延迟的要求选择执行模型。
Argon AI用 o1 编排其他模型,选择数据类型并把大问题拆成更小任务。Lindy介绍,o1 通过函数调用读取日历或邮件信息,支持安排会议、发送邮件等工作流;其报告将原有易出错步骤切换至 o1 后可靠性明显改善。真实应用中的工具执行、权限和副作用控制仍由应用负责。
5. 视觉推理
原页在介绍 o1 视觉能力时,强调它能处理结构含糊的图表、表格以及质量不佳的图片。原文“o1是唯一支持视觉的推理模型”属于较早代际表述,当前已有其他支持图像输入的推理模型,不能作为当前限制。
SafetyKit报告,在其最困难的商品图像分类任务中,GPT-4o 准确率约50%,o1 在不改变流水线的情况下达到88%。这是该客户特定数据集的结果。
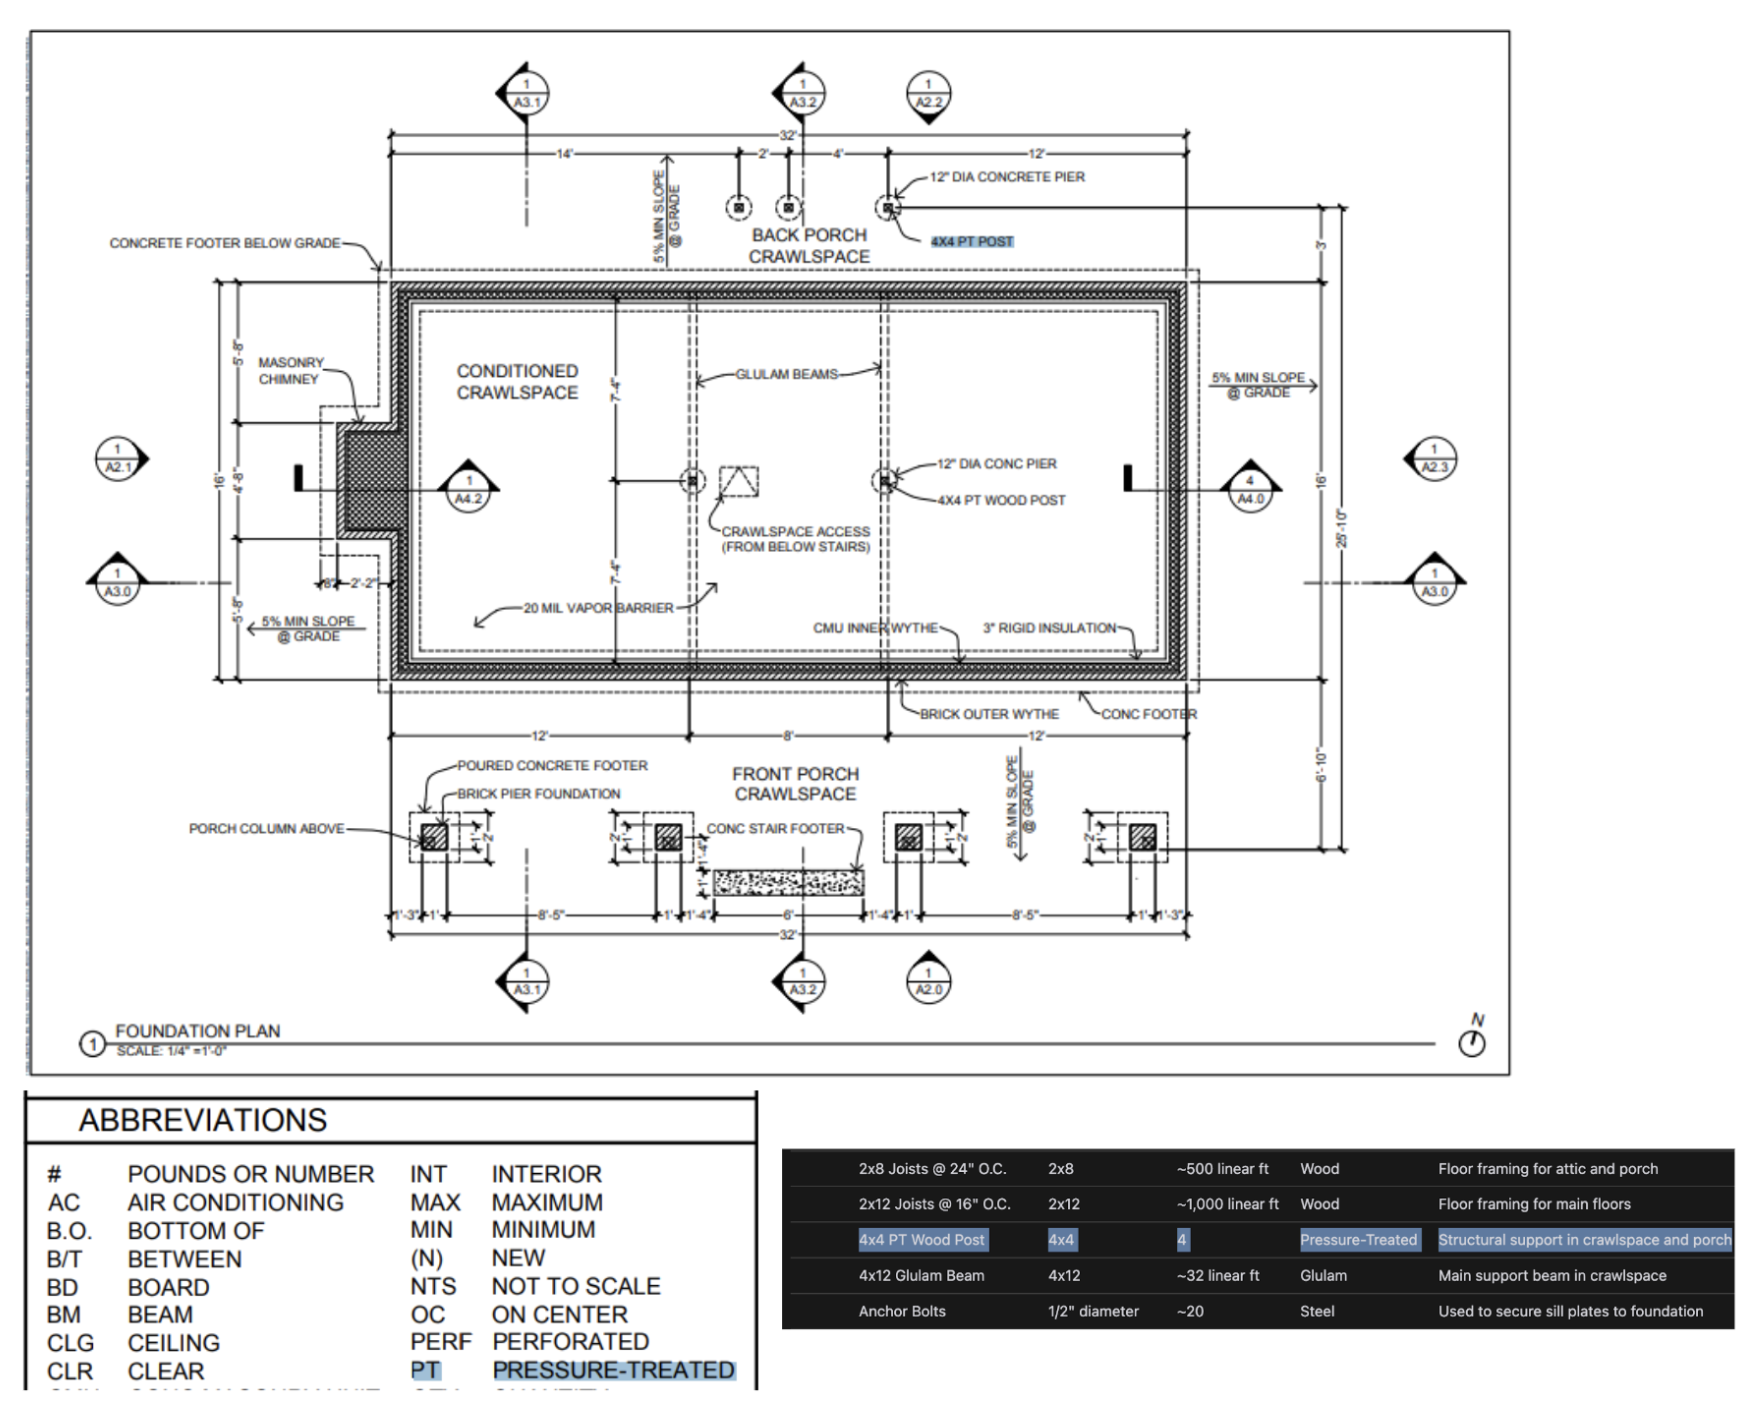
OpenAI 的建筑图纸测试还观察到,o1 能从细节图中识别设备与材料,形成材料清单;它可以把某页图例应用到另一页,例如由图例判断4×4木柱中的“PT”表示经过加压防腐处理。
6. 审查、调试与改进代码
代码审查往往需要跨文件理解差异,却不一定要求最低交互延迟,因此适合测试推理模型。
CodeRabbit介绍,o1 能可靠地发现跨文件代码中较细微的变化,其报告切换到 o 系列后产品转化率提高约3倍。转化率不是通用的代码准确性指标。
较低延迟模型适合快速代码迭代,而推理模型也可承担复杂软件设计。Windsurf报告,在任务定义清楚时,o3-mini 能较稳定地完成高难度编程,并擅长规划和执行复杂软件设计任务。
7. 评估其他模型的回答
模型可作为评测流程中的评审者,结合上下文判断回答质量。相较仅使用预设规则,推理模型可能更能识别微妙差别;医疗等敏感数据场景仍需要严格的评测设计和人工监督。
Braintrust以患者问题摘要评估为例:先由 GPT-4o 等执行模型生成摘要,再由 o1 判断质量。其某客户报告,评审模型的 F1 分数从 GPT-4o 的0.12提高至 o1 的0.74;该结果仅描述对应评测任务。
有效的提示方法
推理模型通常更适合直接、明确的提示。额外要求“逐步思考”不一定提高表现,有时反而不利。
- developer 消息:从
o1-2024-12-17起,相关推理模型支持 developer 消息来承载开发者指令,配合相应的指令优先级行为。应按目标模型与接口支持情况选择角色。 - 简洁直接:清楚说明任务、输入和期望输出,不必添加冗长推理仪式。
- 避免要求暴露思维链:模型会在内部进行推理,无需要求“展示全部思考过程”。
- 使用分隔符:用 Markdown、XML 标签或小节标题区分输入的不同部分。
- 先零样本,再少样本:先尝试不给示例;确有复杂格式要求时再加入少量输入输出示例,并确保与指令严格一致。
- 明确约束:例如要求方案预算低于500美元,应直接写出该限制。
- 明确最终目标:具体列出成功条件,并要求在条件满足前继续检查与改进。
- Markdown 格式:原页说明,从
o1-2024-12-17起的相关模型默认可能避免 Markdown。若需启用,可在 developer 消息首行加入准确字符串Formatting re-enabled。不要将这条旧代际约定套用到所有当前模型。
降低成本并维持准确性
原页区分了不同代际的推理项续接行为:o1、o3-mini、o1-mini、o1-preview 的后续请求会忽略推理项;o3、o4-mini 则会把函数调用相邻的某些推理项纳入上下文,以减少工具续接时重复推理。
对适用模型,官方建议使用 Responses API,允许存储时设置 store: true,通过 previous_response_id 续接,或把先前响应的全部相关输出项回传为下一次输入。系统会利用相关推理项,忽略无关项。更精细地管理上下文时,至少保留最近一次函数调用与上一条用户消息之间的推理项,避免提交工具结果后重新开始推理。
Chat Completions 不能用同样的方式续接内部推理项。多次复杂工具调用的智能体流程可能因此增加推理用量或降低表现;不涉及这类复杂工具续接时,不能据此推断必然有性能下降。当前模型还支持其他推理上下文选项,详见推理模型指南。
















更多建议: