
 TRAE-AI编程



OpenAI 语音成本优化
选择所用 API,了解用量如何计量,并管理语音应用成本。
GPT-Live 用量与成本
GPT-Live 把语音对话与负责推理、工具执行的后端分开。两部分费用分别估算:语音取决于会话时长,后端取决于使用的模型与工具。
语音会话费用
GPT-Live 按当前模型费率逐秒计费,不向上取整到整分钟。
活动时间包含用户说话、助手说话、双方静音及后端工作期间。
估算时,从会话开始计算到关闭,使用 API 报告的时长,不要只计实际播放的音频。静音麦克风不等于关闭会话;对话完成时,关闭会话并收集最终用量。
后端模型与工具价格见 API 定价。
WebRTC 初始化费用
POST /v1/live/sessions 创建 WebRTC 会话时,会先计收初始化阶段的 15 秒语音时长。会话开始运行后,该部分抵扣时长费用。估算时,不要在运行会话时长上再加 15 秒。
例如,下方 90 秒会话已经包含初始化计收的 15 秒,并非按 105 秒计费。评估重连或在用户准备讲话前预创建会话时,应计入创建会话费用。
后端费用
后端调用与语音会话分开计费,方式与无语音应用相同。包括模型输入和输出词元、支持时的缓存输入、图像或工具费用。若应用调用其他服务,也要计入。
后端可独立于语音前端优化。使用成本优化指南减少请求和词元;适用模型的提示词缓存,应把可复用指令、工具定义和稳定内容放在提示词开头。
后端选择也会改变对话长度。优化让用户等得更久或改变任务可靠性时,应比较合计费用。
估算对话成本
只有一段语音会话时:
总费用 = 可计费语音秒数 ÷ 60 × 每分钟语音费率 + 后端费用。
例如,假设语音费率为每分钟 $0.05,90 秒费用为 $0.075;后端模型与工具合计 $0.02,则总费用 $0.095:
| 构成 | 计算 | 费用 |
|---|---|---|
| 语音会话 | 90 秒 ÷ 60 × $0.05 | $0.075 |
| 后端工作 | 模型与工具费用合计 | $0.02 |
| 对话合计 | $0.075 + $0.02 | $0.095 |
以上费率与后端费用只是示例,实际使用当前语音费率、实测后端用量及适用模型和工具价格。任务跨多段会话时,应累计各段时长,并包含会话之间的后端工作。
优化策略
减少不必要对话和等待,帮助用户完成任务,同时保留任务所需的确认与检查。
会话开始前提供相关上下文
启动前收集应用已有权使用的信息。例如订单助手预先获得订单号和当前状态,用户就不必重复或等待额外查询。
上下文应保持最新并聚焦任务。语音模型仅接收对话所需信息,详细记录与工作流留在后端。见会话配置及委派与工具。
减少等待工具的时间
缩短等待能改善体验并降低语音费用。例如后端用 gpt-5.6-luna 配合快速模式,并行执行独立工具。如果因此提前一分钟完成并关闭会话,按前述示例费率可省 $0.05。额外后端费低于节省额时,总费就会下降。
还可以在委派事件到达之前,根据转录片段启动推测性查询。未用到的推测工作也要计入后端成本。
模型、连接、流式与工具优化见降低后端延迟,用语音智能体评估验证有用口头响应时间和任务成功率。
长任务期间关闭会话
语音前端与应用管理的后端可以独立运行。客户端委派的后端工作进程,在语音会话开着或关闭时都能继续。关闭语音会话前保存任务状态与对话上下文。
空闲超时、恢复触发与上下文恢复见关闭空闲会话并恢复。
环境式智能体在后端处理较长任务,例如目标模式中的编程工作时,可关闭语音。用户返回后通过“恢复对话”按钮启动新会话,或由后端完成事件启动新会话并通知结果已就绪。
恢复时,在新会话 input 中加入保存的上下文与已验证结果。例如在新的 WebSocket 连接发送:
来源示例 1(json):
程序文字译释141:帮助用户审查已完成工作,并委派后续任务。
程序文字译释142:已保存任务:添加CSV导出;结果:代码已可审查。
{
  "type": "session.start",
  "session": {
    "model": "gpt-live-1",
    "instructions": "Help the user review completed work and delegate follow-up tasks.",
    "input": [
      {
        "type": "message",
        "role": "developer",
        "content": [
          {
            "type": "input_text",
            "text": "Saved task: add CSV export. Result: code is ready for review."
          }
        ]
      }
    ],
    "delegation": { "type": "client" }
  }
}
等 session.started 后再发音频。历史格式见用既有对话初始化会话。
如果早先会话以 store: true 存储,也可分叉该会话。无论哪种方式,已验证的后端任务状态均留在应用。
按示例费率,每少一分钟空闲语音可省 $0.05,但需与重连费用和体验中断比较。
选择合适后端模型
先选择满足准确性与可靠性要求的模型,再比较包含语音时长、模型用量、工具和重试的总费用。权衡方法见模型选择指南。
大模型若更快完成任务,省下的语音费超过额外词元费,总体可能更便宜;较便宜模型若更慢、重复工具或任务失败,总体可能更贵。
将每个成功任务的费用与完成率、完成时间一起比较。失败尝试和重试也计入,避免较便宜配置因完成更少工作而显得更好。方案设计见语音智能体评估 Cookbook。
监控实际用量
逐会话分别记录语音时长与后端用量。GPT-Live 以秒报告累计语音时长:
来源示例 2(json):字段名、事件类型和示意值保留原样,含义见相邻正文;片段中的省略号不表示完整可运行程序。
{
  "type": "session.usage.updated",
  "event_id": "event_usage_1",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
每次更新替代此前时长快照,不能把快照相加。发送 session.close 后,持续接收直到 session.closed,只记录一次最终 usage.seconds。遵循正常关闭流程,断开前收集最终用量。
Responses 委派通过 response.event 中嵌套的 response.completed 读取后端 usage。按响应 ID 每次只计算一次,保留输入、输出和缓存词元明细以应用相应费率。应用独立运行的后端请求也收集用量。
用代表性对话比较估算与实际合计。仅用于评估的模型调用与应用用量分开,费用与任务成功一同审查。
Realtime API 费用
语音智能体会话按文本、音频与图像模态累计输入输出词元;流式翻译和转录会话按音频时长计费。各模型价格不同,见 gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper、gpt-realtime 等模型页。
对话型 Realtime 由一系列轮次构成:用户输入触发 Response 生成输出。服务器维护由 Items 构成的 Conversation,作为下一轮输入;响应返回后,输出自动加入对话。
翻译与转录使用不同流式架构。客户端持续送入音频,随源音频到达接收翻译音频、转录增量或事件。这类会话不用普通 Response 生命周期,应按时长费率估算与监控,而非按每个 Response 的词元用量。
每次响应的费用
创建 Response 时产生费用,按输入输出词元数量计费,输入转录费用另见下文。当前不收取网络带宽与连接费用。响应可手动创建,也可在启用 VAD 时自动创建。VAD 会过滤空白输入音频,因此除非客户端手动把空白音频加入对话,否则不计为输入词元。
每次 Response 都会向模型发送整个对话。每轮输出作为 Items 加入服务器 Conversation,成为后续输入,因此会话后期轮次更贵。
文本词元可用分词工具估算。用户音频约每 100 毫秒一个词元,助手音频约每 50 毫秒一个词元。计数还含内容外的特殊词元,因此会有少量差异,例如正文 10 个文本词元的用户消息可能计作 12 个。
示例
第一轮包含 100 个指令词元和 20 个用户音频词元,例如由 VAD 检测讲话后加入,总输入 120。创建 Response 后,助手输出包含 20 个音频与 10 个文本词元。
第二轮再加入 25 个用户音频词元,对话此时包括初始指令、首轮用户输入、首轮助手输出和第二轮用户输入。原文示例将第二轮输入写为 110 个文本与 64 个音频词元,另加本轮助手输出词元;音频合计与前述数字的差异已登记待核,未改写原图或原示例。
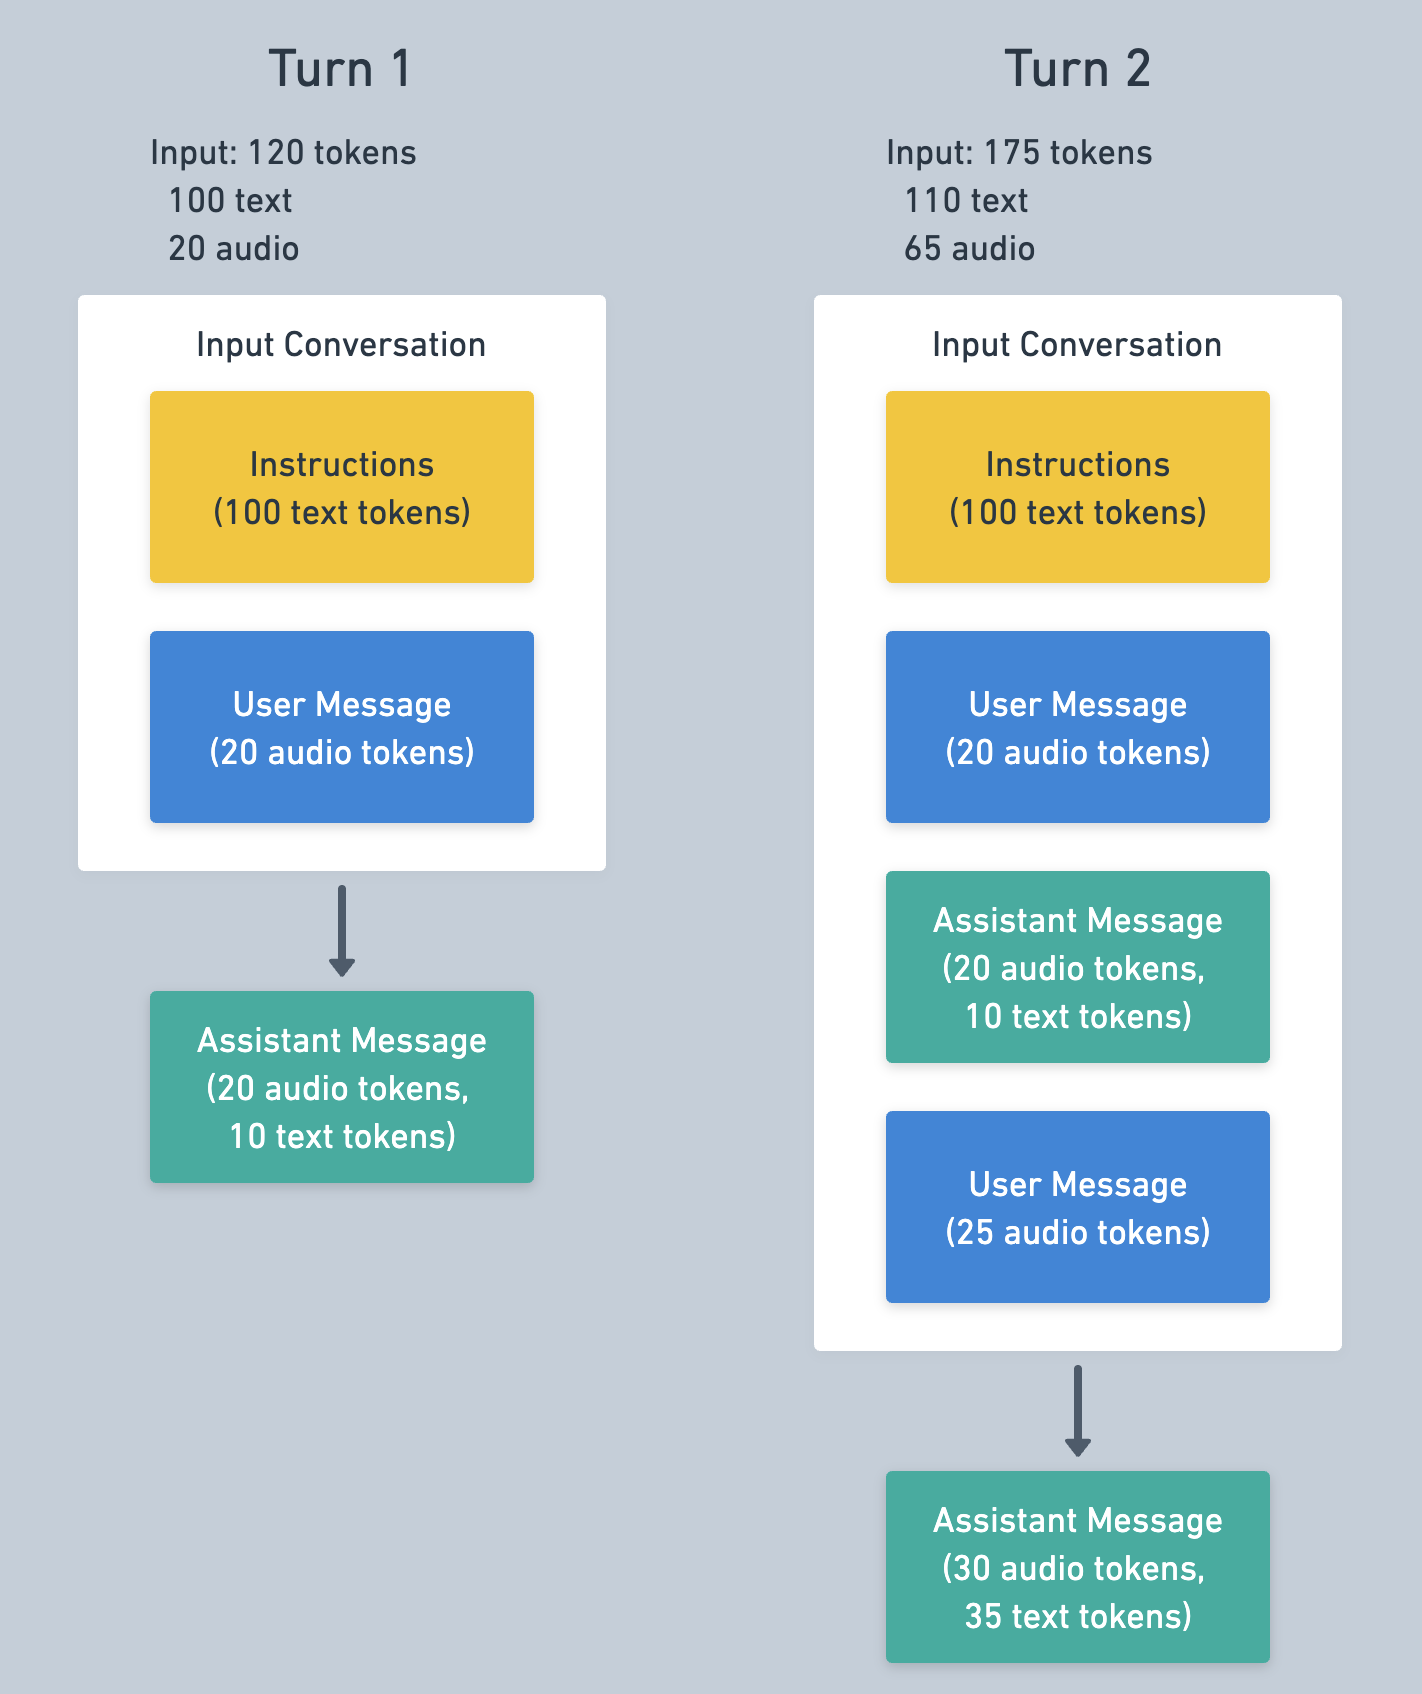
第二轮通常可能缓存首轮消息,从而降低输入费,缓存机制见下文。
从 response.done 读取本次词元用量:
来源示例 3(json):字段名、事件类型和示意值保留原样,含义见相邻正文;片段中的省略号不表示完整可运行程序。
{
  "type": "response.done",
  "response": {
    ...
    "usage": {
      "total_tokens": 253,
      "input_tokens": 132,
      "output_tokens": 121,
      "input_token_details": {
        "text_tokens": 119,
        "audio_tokens": 13,
        "image_tokens": 0,
        "cached_tokens": 64,
        "cached_tokens_details": {
          "text_tokens": 64,
          "audio_tokens": 0,
          "image_tokens": 0
        }
      },
      "output_token_details": {
        "text_tokens": 30,
        "audio_tokens": 91
      }
    }
  }
}
输入转录费用
启用输入转录时,Realtime API 另行计费,其模型与费率不同于语音到语音模型。gpt-transcribe 用于已提交轮次转录,在音频写入输入缓冲并提交后开始。
从 conversation.item.input_audio_transcription.completed 读取用量。字段取决于转录模型:gpt-transcribe 按时长计费,按词元收费的模型返回词元计数。时长用量示例:
来源示例 4(json):
程序文字译释143:你好,能听到我吗?
{
  "type": "conversation.item.input_audio_transcription.completed",
  "transcript": "Hi, can you hear me?",
  "usage": {
    "type": "duration",
    "seconds": 3
  }
}
缓存
Realtime 支持自动提示词缓存,可显著降低多轮输入成本。响应输入匹配以前响应的词元时可复用,但属于尽力实现,不保证命中。
提高命中率的最佳策略是保持历史稳定。移除或改变内容,会从变更点起破坏缓存匹配。指令与工具定义位于对话开头,因此中途修改会降低后续命中率。
截断
对话词元超出模型输入限制时,从最旧消息起丢弃输入。原文举例称,32k 上下文、最大输出 4,096 的模型在截断前可容纳 28,224 个上下文词元;该示例数值已保留为待核,不据此推算所有模型窗口。
客户端可设置小于模型最大值的窗口,以控制用量和费用。下方采用 retention_ratio 类型的截断配置时,通过 token_limits.post_instructions 控制除指令外的最大响应输入词元。设为 1,000 时,超出该输入上限的项目不送入模型。
截断会破坏对话开头附近的缓存,逐轮截断会导致低命中率。可以一次多丢弃一些,增加下次截断前余量。session.truncation.retention_ratio 默认 1.0,仅丢弃必要项目;0.8 表示保留最大窗口的 80%,额外丢弃 20%。
要降低给定模型的单会话成本,可缩小词元窗口并把 retention_ratio 设为小于 1。代价可能是模型每轮可记住的信息减少。
来源示例 5(json):字段名、事件类型和示意值保留原样,含义见相邻正文;片段中的省略号不表示完整可运行程序。
{
  "event": "session.update",
  "session": {
    "truncation": {
      "type": "retention_ratio",
      "retention_ratio": 0.8,
      "token_limits": {
        "post_instructions": 8000
      }
    }
  }
}
也可完全关闭截断,此时对话过长无法创建 Response 就会返回错误,适用于自行管理对话大小:
来源示例 6(json):字段名、事件类型和示意值保留原样,含义见相邻正文;片段中的省略号不表示完整可运行程序。
{
  "event": "session.update",
  "session": {
    "truncation": "disabled"
  }
}
其他优化策略
使用 mini 模型
Realtime 语音到语音模型分普通和 mini,后者明显更便宜,但指令遵循与函数调用等智能表现可能较弱。推荐先用较大模型测试、完善应用与提示词,再尝试用 mini 优化。
编辑对话
除服务器自动截断外,也可手动编辑 Conversation。API 允许客户端完全控制服务器对话,自由增删项目:
来源示例 7(json):字段名、事件类型和示意值保留原样,含义见相邻正文;片段中的省略号不表示完整可运行程序。
{
  "type": "conversation.item.delete",
  "item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}
清理旧消息可降低输入词元与费用,但可能丢失重要内容。常见做法是用摘要替换旧消息:通过 conversation.item.delete 删除,再用 conversation.item.create 添加。
估算费用
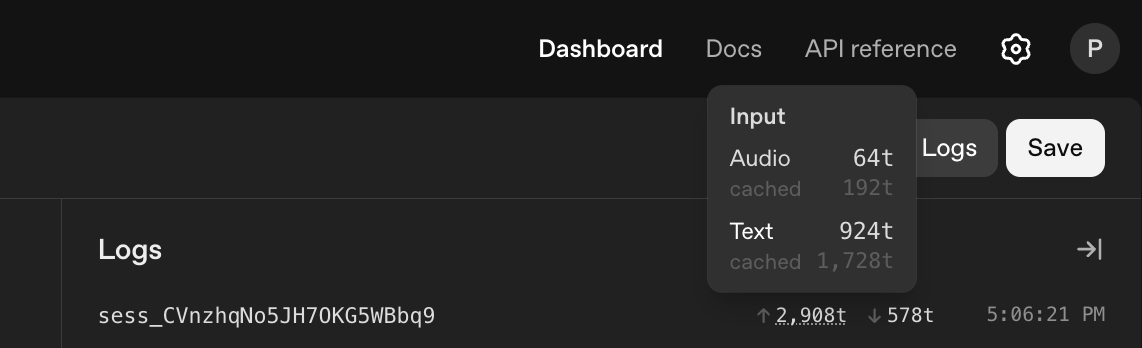
Realtime 词元用量较复杂,事先估算有难度。可以在 Realtime Playground 用预期提示词和函数运行样本会话,测量词元。用量位于 Playground 的 Logs 标签页,会话 ID 旁边。
















更多建议: