
 TRAE-AI编程



OpenAI GPT Actions 数据检索
2026-11-09 15:59 更新
数据检索是 GPT 中 Action 最常执行的任务之一。例如:
- 访问 API,根据关键词搜索获取数据。
- 访问关系型数据库,根据结构化查询获取记录。
- 访问向量数据库,根据语义搜索获取文本片段。
本文分别说明这些检索集成的注意事项。
通过 API 检索数据
许多组织将重要数据保存在第三方软件中,例如 Salesforce 的客户数据、Zendesk 的支持数据、Confluence 的内部流程资料,以及 Google Drive 的业务文档。这些服务通常提供 REST API,供外部系统搜索和获取信息。
构建调用提供商 REST API 的 Action 时,先阅读已有文档,确认以下事项:
- 检索方法。
- 搜索(Search):各服务的搜索语义不同,但通常需要一种接收关键词或查询字符串、返回匹配文档列表的方法。示例见 Google Drive 文件搜索。
- 获取(Get):找到匹配文档后,还需要获取文档的方法。示例见 Google Drive 的 file.get。
- 认证方式。
- 例如,Google Drive 使用 OAuth认证用户,确保只检索用户有权访问的文件。
- OpenAPI 规范文档。
- 某些提供商提供可直接导入 Action 的 OpenAPI 文档,例如 Zendesk。
- 可移除 GPT 不会访问的方法,限制 GPT 能执行的操作范围。
- 对于不提供 OpenAPI 文档的服务,可使用 OpenAI 开发的 ActionsGPT协助创建。
目标是让 GPT 使用 Action 搜索并获取包含相关上下文的文档。GPT 会遵循指令,组合提供的搜索和获取方法完成任务。
通过关系型数据库检索数据
组织用关系型数据库存储各类业务记录,这些记录能为 GPT 提供有价值的上下文。例如,用于帮助用户查询保险理赔状态的 GPT,如果能根据理赔编号查到数据库中的记录,就更有帮助。
构建关系型数据库 Action 时,应考虑:
- 是否提供 REST API。
- 许多关系型数据库不会原生暴露处理查询的 REST API,因此可能需要自行开发或采购中间件,连接 GPT 与数据库。
- 中间件应接收正式查询语句,将其传给数据库,并将返回记录响应给请求方。
- 能否从公网访问。
- 普通 API 通常面向公网访问,而关系型数据库传统上部署在组织应用基础设施内部。GPT 运行在 OpenAI 基础设施上,因此暴露的 API 必须可从防火墙之外访问。
- 复杂查询字符串。
- 关系型数据库使用 SQL 等正式查询语法。需要额外告诉 GPT 支持哪种查询语法;GPT 通常能够根据用户输入生成这种查询。
- 数据库权限。
- 即使数据库支持用户级权限,最终用户也很可能没有直接访问数据库的权限。如果用服务账户提供访问,可考虑仅授予只读权限,避免意外覆盖或删除数据。
目标是让 GPT 编写与用户问题相关的正式查询,通过 Action 提交,再利用返回记录补充回答。
通过向量数据库检索数据
如果希望 GPT 获取相关性更高的搜索结果,可以集成支持语义搜索的向量数据库。市场上有多种托管和自托管方案,可参考部分向量数据库列表。
构建向量数据库 Action 时,应考虑:
- 是否提供 REST API。
- 原文沿用关系型数据库的说明:许多数据库并不原生暴露查询用 REST API,可能需要在 GPT 与数据库之间开发或采购中间件,下文会进一步说明。
- 能否从公网访问。
- 与面向公网的 API 不同,数据库可能部署于组织内部。GPT 位于 OpenAI 基础设施,因此提供给它的 API 必须可从防火墙之外访问。
- 查询嵌入向量。
- 向量数据库通常接收嵌入向量而非纯文本查询。提交前需要通过嵌入 API 将查询转换为向量。适合在 REST API 网关中完成该转换,使 GPT 只需提交纯文本查询字符串。
- 数据库权限。
- 向量数据库通常存储文本片段而非完整文档,可能难以延续原始文档的用户权限。原文提醒:能访问该 GPT 的用户可能因此访问数据库中所有文本片段,设计时应据此规划权限。
向量数据库中间件
如上所述,中间件通常承担两项任务:
- 通过 REST API 暴露向量数据库访问能力。
- 将纯文本查询字符串转换为嵌入向量。
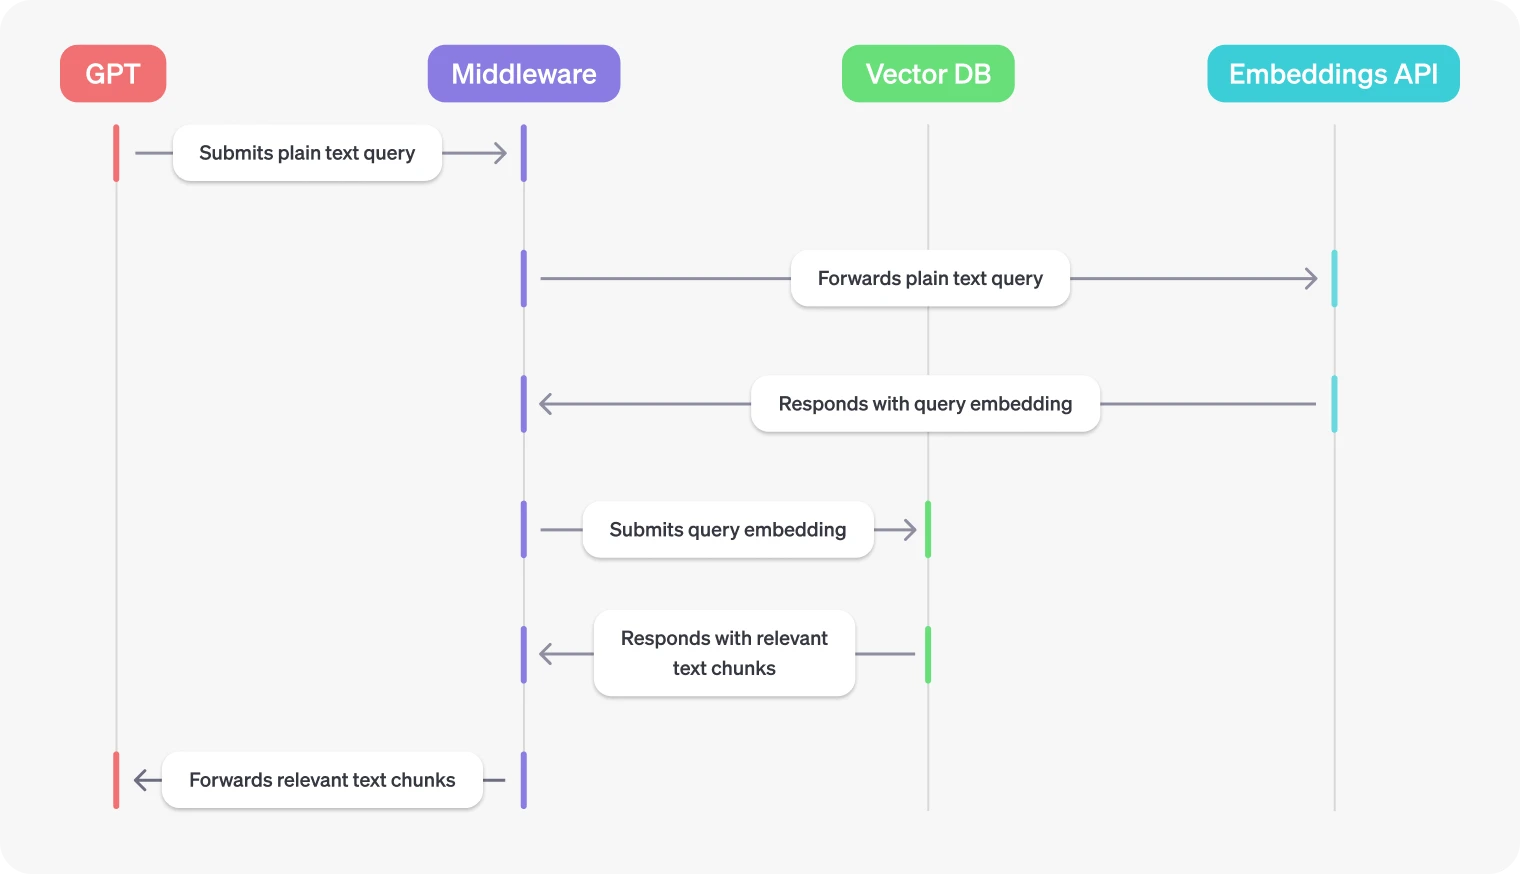
目标是让 GPT 向向量数据库提交相关查询、触发语义搜索,再利用返回的文本片段补充回答。
以上内容是否对您有帮助:
















更多建议: