
 TRAE-AI编程

当你准备让 Claude 帮忙写提交信息,却担心它生成的内容和团队现有规范对不上时,问题通常不在模型能力,而在“规范没有被明确交给它”。要让 Claude 提交信息符合团队规范,最关键的一步是先有一份能被工具读取的规范文件(比如 Conventional Commits 或团队自定义的提交模板),再让 Claude 每次提交前读取并照做。本文先给结论,再讲清为什么需要规范、几种可行做法、最稳的配置文件方案,以及常见反例和边界,帮你把“AI 写提交信息”从随机发挥变成可复现的团队动作。
先看结论
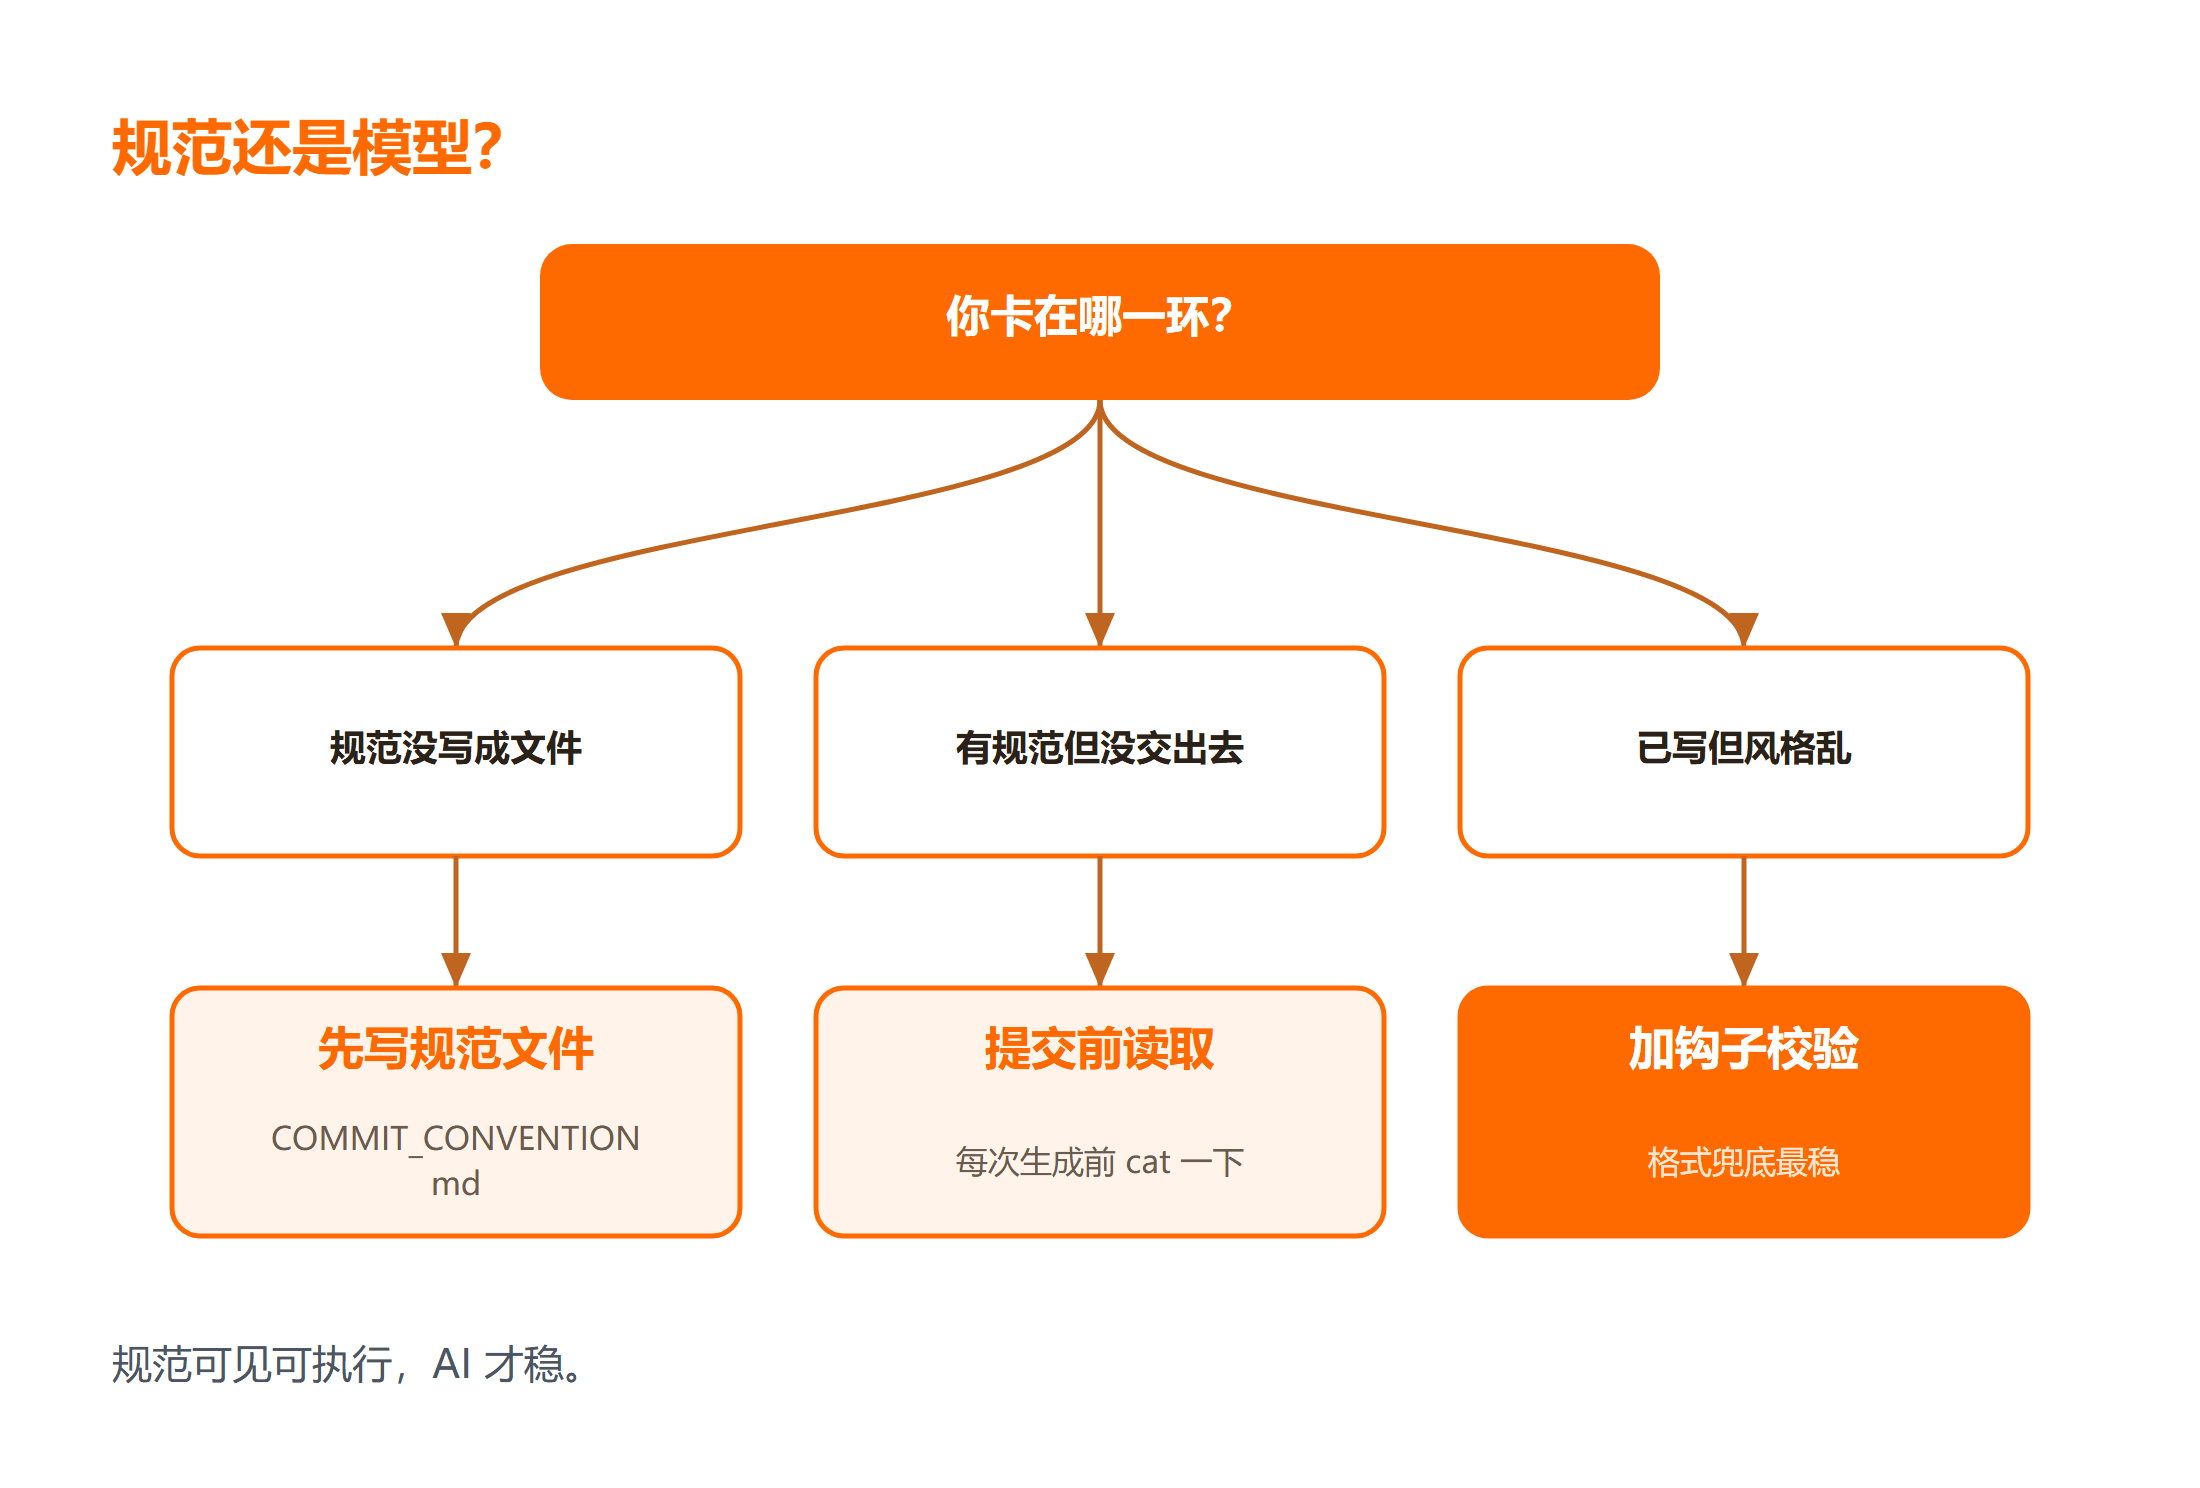
Claude 写提交信息能否符合团队提交规范,取决于“规范是否可见、是否可执行”。三个要点:第一,把规范写成文件(COMMIT_CONVENTION.md 或 Conventional Commits),而不是只存在老人脑子里;第二,提交前显式让 Claude 读取该文件再生成;第三,用提交前钩子或评审步骤兜底校验。只要规范可读取、可校验,Claude 提交信息就能稳定贴合团队要求,否则再强的模型也只会凭训练记忆瞎猜。团队提交规范的本质是“降低协作噪音”,规范越明确,AI 写提交信息越可靠。
一、先弄清楚团队规范长什么样
动手之前,先确认团队到底有没有成文的提交信息规范。很多团队口头说“写清楚就行”,但每个人理解的“清楚”不一样:有人用 fix: 修复登录 bug,有人写“修复了登录的一个问题,顺手改了下样式”。这种不一致会让 git log 难以检索、自动生成变更日志失败。
确认三件事:类型词有哪些(feat / fix / docs / refactor / test / chore 等)、标题长度上限、正文要不要写“为什么而不是怎么做”。如果团队用的是 Claude Code 迁移指引里的规范 那套 Conventional Commits,就直接照它的格式;如果是自定义模板,把模板原文存成文件。规范落地的前提是“先有文字版本”,这也是让 Claude 提交信息可复现的第一道关。
如果团队完全没有成文规范,先别急着让 Claude 写,花十分钟列一份最小版本:类型词清单、标题句式、正文要不要写“为什么”。这份文件不追求完美,能覆盖 80% 的常见提交就够,剩下边界情况靠评审兜底。规范先有、再迭代,比“边写边补”更稳,也方便 Claude 每次都拿到同一份依据。
二、让 Claude 按规范写的几种做法
做法一:每次在提示里粘贴规范摘要。适合临时、低频场景,但容易遗漏、上下文一长就忘。
做法二:把规范写进项目根目录的 COMMIT_CONVENTION.md,提交前让 Claude 先读再写。这是最稳的做法,规范随仓库走,换人或换模型都一致。
做法三:借助 Claude Code 这类工具的配置能力,把规范塞进它的系统提示或项目规则文件,实现“每次自动带规范”。相关能力可参考 Claude Code 企业版设定 里的项目级配置,把规范固化进工具比每次手动粘贴更省心。
三种做法的区别在于“规范离 Claude 有多近”:越靠近、越自动,团队提交规范越不容易被忽略。建议从做法二起步,规范成熟后再上做法三。
三、把规范文件交给 Claude(最稳做法)
在项目根目录新建 COMMIT_CONVENTION.md:
# 提交信息规范
类型:feat / fix / docs / refactor / test / chore
格式:<类型>(<范围>): <一句话标题>
标题 ≤ 50 字,正文说明“为什么”
然后让 Claude 在生成提交信息前先读它:
# 让 Claude 先读取规范再写提交信息
cat COMMIT_CONVENTION.md
git diff --staged --stat
预期是 Claude 输出形如 fix(auth): 修复登录态过期未跳转 的提交信息,类型和范围都贴合规范。安装与基础能力见 Claude Code 安装指引。只要这份规范进了仓库,换工具、换人都只需指向同一个文件,行为自然一致。
四、常见反例与边界
反例一:只说“写得规范点”。AI 写提交信息会退回到训练默认,和团队实际规范脱节。必须给出具体文件。
反例二:规范写在飞书文档里、不进仓库。Claude 读不到,等于没规范。规范必须落在代码仓库可读取的路径。
边界:Claude 能照格式写,但无法替你判断“这次改动到底属于 feat 还是 fix”——业务语义仍要人来定。规范解决的是“格式与语气”,不是“意图判断”。若团队对“破坏性变更”有 BREAKING CHANGE 标识要求,也要写进规范文件,否则 AI 写提交信息会漏标。代码注释规范同理:先定规则文件,再让模型照做。
还有一个常被忽略的点:规范要“可机器校验”才好兜底。把类型词、格式写成提交前钩子能识别的规则,Claude 写错时钩子直接拦下,而不是等评审才发现。规范文件 + 钩子形成闭环,AI 写提交信息才真正可复现,而不是“模型表现好时凑合、表现差时翻车”。
适用边界上,规范文件只解决格式与语气,不替你判断业务语义;和「纯靠记忆写提交信息」对比,文件化规范的可验证性明显更高。实际操作时先运行读取规范的命令,检查 Claude 输出,预期它贴合类型词;若失败就用提交前钩子修复,再验证一次是否通过。还要确认规范本身有人维护:类型词增删、范围名调整,都要同步进文件,否则 Claude 会照着过期规范写,反而制造新的不一致。把规范当活文档,每次评审发现的新约定顺手补进去,比一次性写死更耐久。
常见问题
Q:Claude 写的提交信息能直接 git commit 吗?
建议先让人过一眼类型和范围,再用提交前钩子做格式校验。规范文件加钩子双保险,比完全放手更稳。
Q:小团队也要写规范文件吗?
哪怕三人团队,一份 COMMIT_CONVENTION.md 也能让历史记录清爽、便于回滚。成本极低,收益长期。
Q:Conventional Commits 一定要用英文类型词吗?
不一定。团队可自定义中文类型词,只要写进规范文件、让 Claude 读取即可。关键是“统一且可读”,不是“照搬英文”。
总结
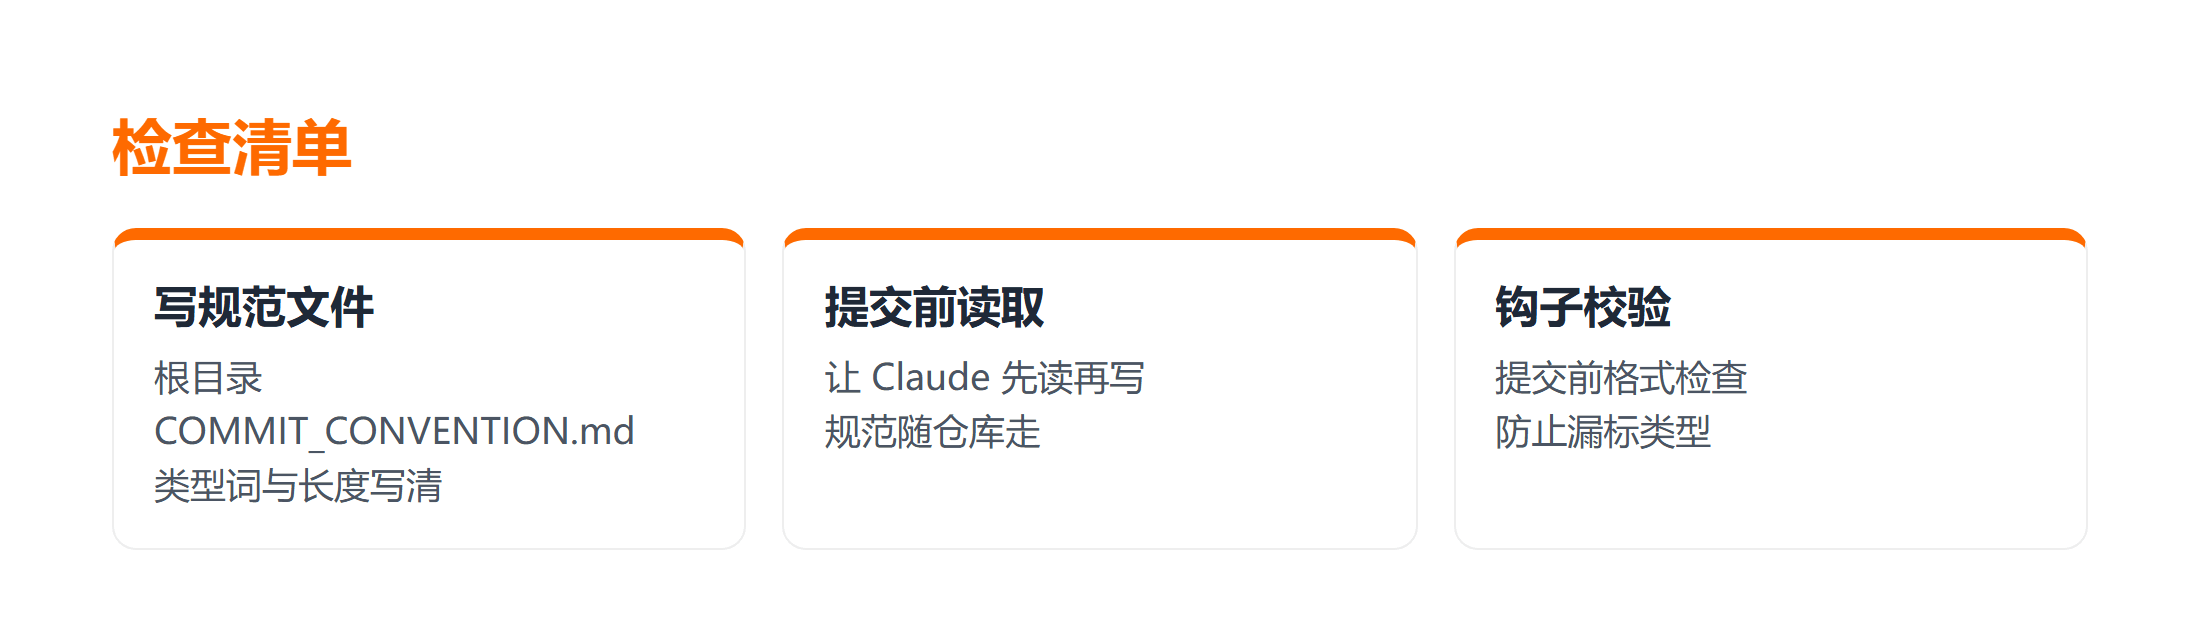
让 Claude 提交信息符合团队规范,核心不是调模型,而是把规范文件化、可读化、可校验化。先有 COMMIT_CONVENTION.md,再让 Claude 提交前读取,最后用钩子兜底。规范越明确,AI 写提交信息越可靠,团队协作噪音越低。



