
 TRAE-AI编程

用 Claude 读报错堆栈,做法分三类:直接贴整段 traceback 让它解释、先让它写最小复现再分析、或者把日志和官方文档一起喂给它做根因推断。先给结论:简单报错用「直接解释」最快,反复出现的疑难用「最小复现 + 文档对照」最稳,纯靠它猜最不可靠。差别在上下文给得全不全、有没有把官方文档一起喂进去。下面按「先分清报错类型 → 再选一种做法 → 然后补上下文与文档 → 最后验证修复」的顺序讲清三种做法的边界与取舍,照着选能少走弯路,也能学会什么时候该信 AI、什么时候要自己查官方文档。
先看结论
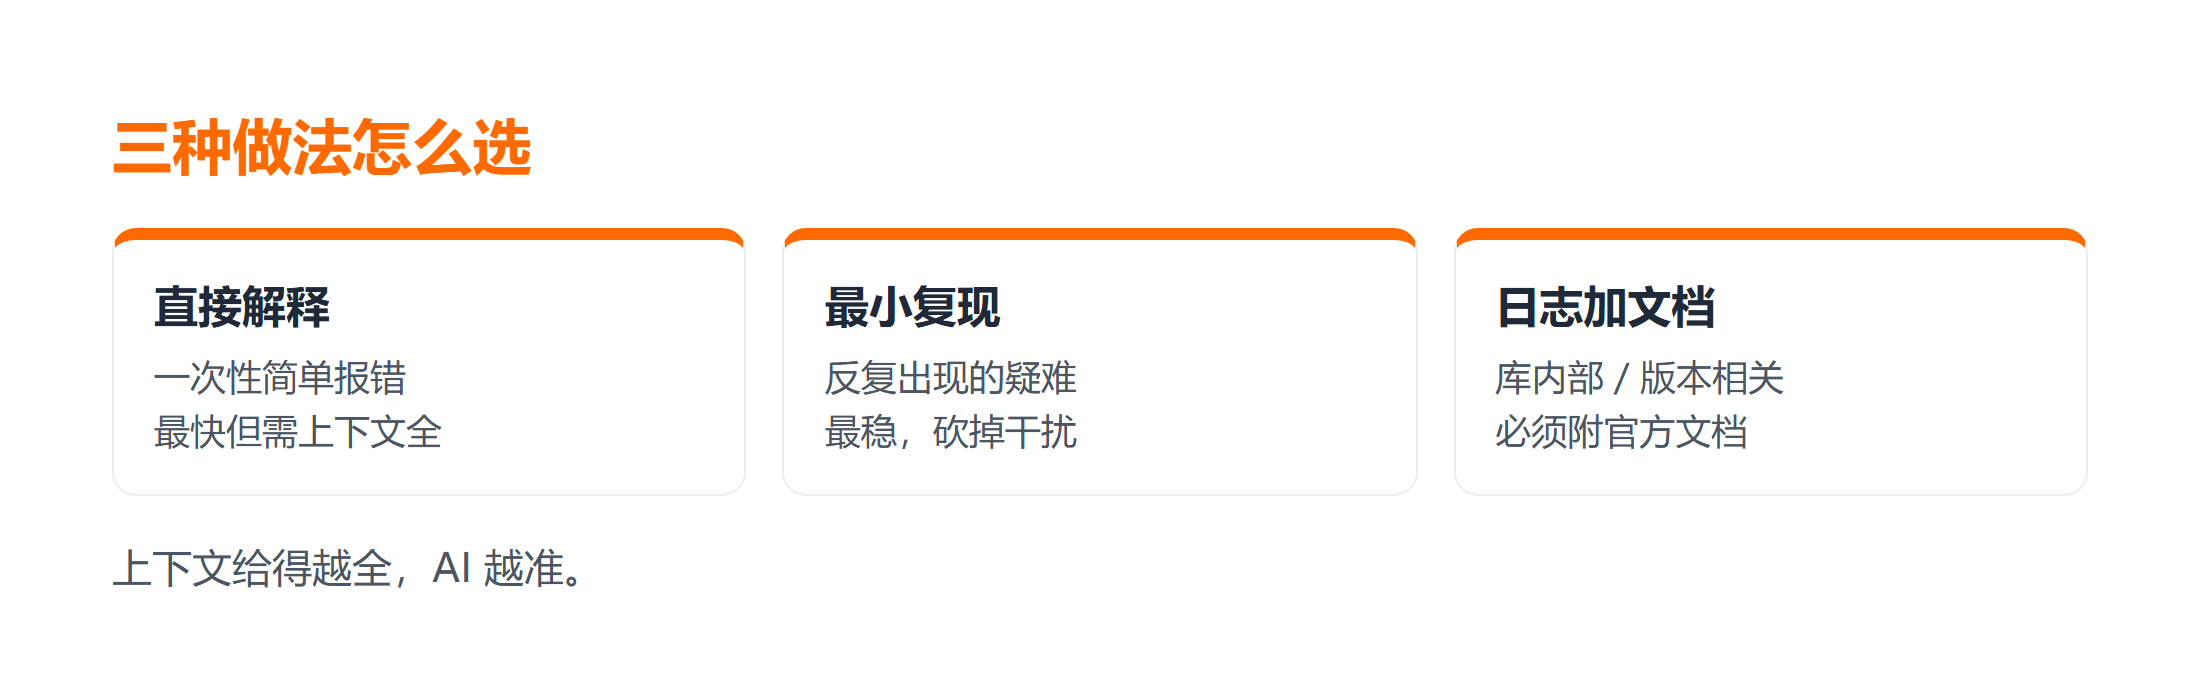
- 一次性简单报错:直接贴 traceback 让 Claude 解释,最快。
- 反复出现的疑难:先造最小复现,再让它分析,最稳。
- 涉及库内部或版本差异:必须附官方文档,别只靠它推断。
- 生产环境破坏性操作:AI 给命令,你人工核对后再执行。
一、先分清报错类型
和用任何 AI 排错一样,先把错误类型摘出来。TypeError、KeyError、NullPointerException 这类名字已经告诉你方向:是类型不对、缺键还是空指针。Claude 对英文报错术语理解更深,直接把原始英文 traceback 贴给它,比先机翻一遍更准。别只截最后一句,要把整段调用链都给它,它才能定位到你的代码那一层。
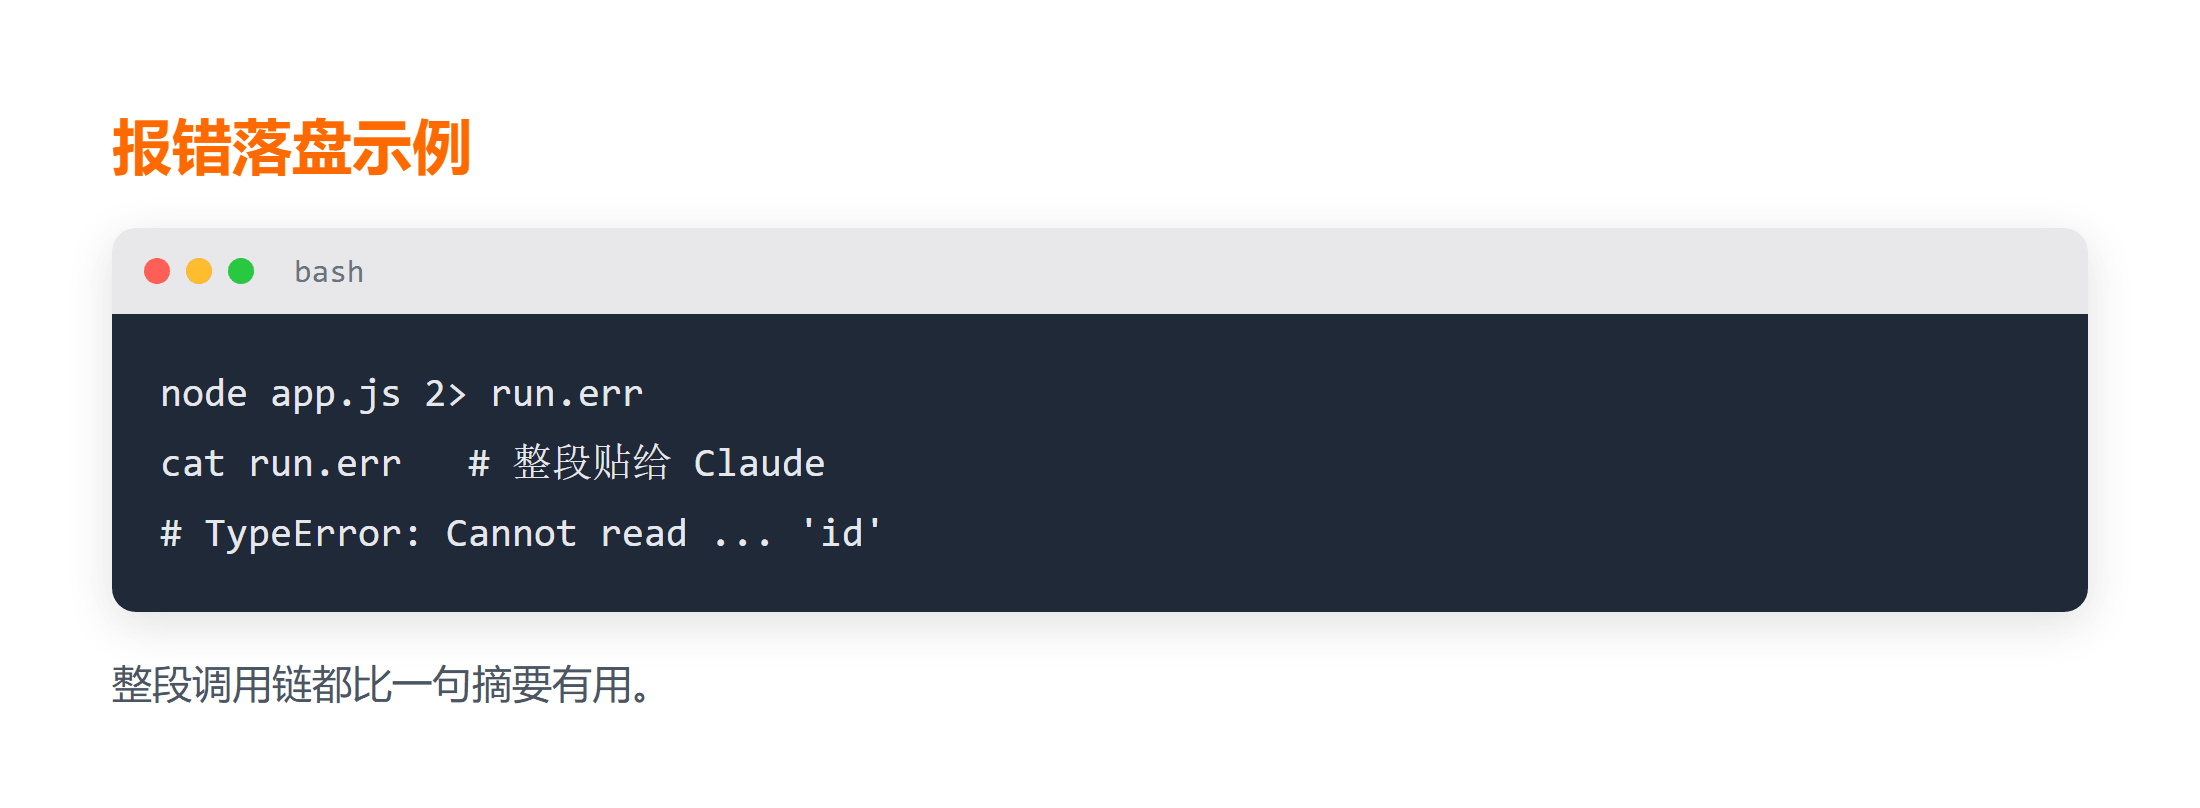
一个快速起步是把报错落盘,整段喂进去:
# 把运行错误完整保存,再整段贴给 Claude
node app.js 2> run.err
cat run.err
TypeError: Cannot read properties of undefined (reading 'id')
at renderUser (app.js:42:13)
at main (app.js:9:5)上面这段,错误类型是 TypeError,崩在 app.js 第 42 行的 renderUser。类型是「读 undefined 的属性」,方向已经很明确:某个对象没拿到预期数据。对 AI 编程工具的术语体系想系统了解,可以先过一遍 AI 编程 Codex Glossary,把常见概念对齐。
分类型时还有个实用技巧:把报错按「能否本地复现」再切一刀。能稳定复现的,直接走最小复现路线;时有时无的,先加日志把触发条件抓出来,再交给 Claude 分析,比反复贴片段高效。复现不了的错误最容易让人误判根因,先花十分钟固定现场,后面省下的排错时间远不止十分钟。
二、做法一:直接解释(最快)
适用边界:报错一眼能看懂类型、且只出现一次。把 traceback 加出错前 5 行代码贴给 Claude,让它输出「根因 / 触发条件 / 修法」三段即可。这种做法省时,但前提是你的描述里已经包含足够上下文。
注意一个失败点:如果你只说「我的程序报 TypeError」,Claude 只能泛泛而谈。必须给「代码 + 报错 + 你期望的结果」三件套。安装与运行环境的差异也会影响复现,遇到环境类问题可参考 AI 编程 Codex 安装,先排除是环境没配好而非代码问题。
直接解释法也有进阶用法:让 Claude 顺带输出「最可能的三个诱因」并按概率排序,而不是只给一个答案。这样当它第一判断不准时,你手里还有备选方向,不用重新组织问题描述。对偶发错误尤其有用,等于一次对话拿到多份排查线索。
三、做法二:最小复现(最稳)
适用边界:报错时有时无、或藏在复杂调用里。这时让 Claude 帮你抽一个最小可复现示例,比直接问强得多。最小复现把干扰项全砍掉,只剩触发条件,AI 和你的判断都更准。
// 最小复现:剥离业务,只留触发条件
function renderUser(u) { return u.id; }   // 第 42 行等价逻辑
renderUser(undefined);                      // 触发 TypeError
把这段给 Claude,它能立刻确认:问题在调用方没保证 u 有值,而不是 renderUser 本身。这种做法在「反复出现的疑难」上稳定性明显更好。想看同类智能体怎么组织多步推理,可翻 OpenClaw 提供商 OpenCode,对照它的执行链路设计。
最小复现的价值不止于排错,它还是你和同事、和库作者沟通的通用语言。把复现脚本贴进 issue,对方能秒级还原你的环境,回复质量立刻不同。养成「先复现再提问」的习惯后,你会发现很多原本以为的疑难,其实卡在自己在调用处漏了一步初始化。
四、做法三:日志加文档联合推断
适用边界:报错来自第三方库内部、或和版本强相关。这时只给代码不够,要把官方文档对应段落也贴进去,让 Claude 在「文档约束」下推断,而不是凭印象编。版本差异、参数默认值、废弃 API 这些,文档才是权威。
给法示例:先贴 traceback,再贴「库名 + 版本 + 官方文档该函数的签名」,要求它「严格按文档判断是否误用」。这样能避免它给出对你当前版本并不存在的 API。插件生态与扩展能力也可参考 AI 编程 Codex 插件,看工具链怎么补齐排错能力。
联合推断时,给文档的方式也有讲究:优先贴官方文档里「函数签名 + 参数约束 + 返回值」那段,而不是泛泛的教程链接。Claude 拿到精确签名,才能严格核对你的调用是否越界;贴教程反而容易让它顺着教程的假设走偏。文档版本也要对齐你的依赖版本,跨大版本的参数变化是最常见的误判来源。
总结
Claude 帮读报错堆栈,三种做法各有适用边界:一次性简单错用「直接解释」最快,反复疑难用「最小复现」最稳,库内部或版本相关必须「日志加文档联合推断」。选择标准是上下文给得全不全、有没有喂官方文档。记住 AI 给的命令你要人工核对,生产破坏性操作更要先看文档再执行,这样既不浪费 AI 的效率,也不丢掉自己的判断。
常见问题
Q:为什么有时候 Claude 给的修复在线上跑不通?
常见原因是版本不一致:它默认按最新版 API 给解法,而你的项目用的是旧版。把库名和版本号一起贴给它,并要求「按该版本文档作答」,命中率会高很多。
Q:最小复现太费时间,有必要吗?
对偶发、难定位的报错非常有必要。复现过程本身就会暴露你忽略的假设,而且给 AI 的输入越干净,它答得越准,总时间反而更短。
Q:AI 说这是库 bug,我该信吗?
先怀疑自己的调用。堆栈指向库内部时,多半是传参不符合它的契约。对照官方文档的入参约束核对一遍,确认真是库的问题再考虑升级或提 issue。
延伸学习
- 华为CodeArts+AI开发教程 零基础实操(维修网站+预约系统)(配套课程,把 AI 编程落到实处)
- 一文看懂 Windows、macOS、Linux、Android、iOS 的区别与选择(笔记,环境差异也是报错高发区)
- 中文与Unicode互转(在线工具,处理编码类报错时常用)



