
 TRAE-AI编程


Qwen 长输入用 XML 标签包
长输入一多,规则和数据就糊在一起:用成对标签把两样隔开,模型定位材料、守住边界的准确度都会上一个台阶。
一、前提与适用
| 适用对象 | 前提 | 不适用 |
|---|---|---|
| 提示词里要塞长文档、多条材料的人 | 材料可按块切分 | 输入只有一两句(标签是纯开销) |
| 提示词里夹了变量,怕和正文混淆 | 能确定变量边界文本 | 目标平台对标签字符有转义限制时 |
| 收到过「把示例当真数据」的输出 | 保留了原始指令可复查 | 模型故障或限流的排查 |
本节示例用 qwen3.7-max;示例参数 temperature=0.7、top_p=0.8 属选取默认值,不是官方推荐。标签包裹是提示词组织的通用实践:官方指南要求背景信息(Context)与任务(Objective)分开交代,标签是让这个「分开」在文本上真正显形的手法。
二、怎么做
三步:约定标签 → 包材料 → 声明引用规则。
第 1 步,约定标签。 每类内容一个成对标签:<文档> 包材料、<问题> 包任务、<规则> 包边界约定。标签名用内容语义命名,一套提示词里不重名。
第 2 步,包材料。 长文档、多片段、变量值全部进标签;标签外的文字只放「怎么用这些标签」的说明。
第 3 步,声明引用规则。 写明「只依据标签内内容回答」;再让判定器查一遍配对完整性——标签没闭合,隔离就是漏的。
## EXPECT: 配对=2 未闭合=0
import re

def audit(text):
    opens = re.findall(r"<([a-z_\u4e00-\u9fa5]+)>", text)
    closes = re.findall(r"</([a-z_\u4e00-\u9fa5]+)>", text)
    return len(set(opens) & set(closes)), len(set(opens) - set(closes))

paired, unclosed = audit("<文档>内容A</文档><问题>内容B</问题>")
print(f"配对={paired} 未闭合={unclosed}")
开工前先看一组反例与正例。
坏写法:
下面是我的资料,你看完回答问题。资料:……(三页长文)……问题:核心卖点是什么?另外这只是示例格式:名称、卖点。长文、问题、示例格式挤在一起——「名称、卖点」这种示例字段很容易被模型当成真实材料去答,边界全靠猜。
改写后的完整提示词:
你是资料核对助手。只依据 <文档> 标签内的内容回答 <问题> 中的问题;<示例> 标签内只是格式示范,不是真实数据。片段里没有的信息回答未提及。

<文档>{{文档内容}}</文档>

<问题>{{核对问题}}</问题>

<示例>输出格式:一句话结论+一行依据。</示例>
最小可跑填法:文档内容 填真实材料,例如「本工具支持导出 CSV 与 Excel 格式,单次导出上限 10 万行」;核对问题 填「核心卖点是什么?支持 PDF 吗?」。随请求参数:模型 qwen3.7-max、enable_thinking=false、temperature=0.7、top_p=0.8——核对类任务关思考更稳也更省。
实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:两个标签均配对、无未闭合;判定器核的是「标签配对完整性」,隔离效果(模型是否只认标签内材料)以实测回复为准。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
文档未提及核心卖点,且不支持导出PDF格式。依据:文档仅说明支持导出CSV与Excel格式及单次导出上限10万行,未涉及核心卖点与PDF导出功能。
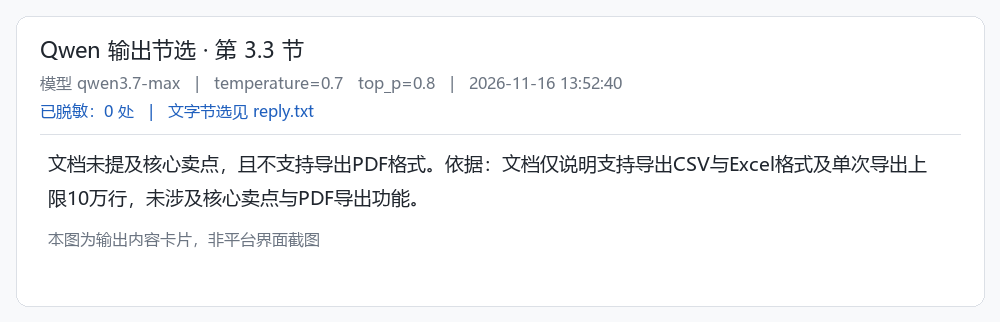
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 项 | 稳的写法 | 不稳的写法与后果 |
|---|---|---|
| 标签名 | 语义命名,一套不重名 | 重名:模型分不清材料类别 |
| 配对 | 成对出现,判定器先查 | 漏闭合:隔离区渗漏 |
| 示例区 | 放独立标签并声明「非真实数据」 | 混进正文:示例被当真数据 |
| 引用规则 | 「只依据标签内内容」写明 | 不写:模型自由取材 |
| 嵌套 | 一层为主,确需嵌套用不同名 | 同名嵌套:配对判定失效 |
标签是文本协议,不依赖平台特性:任何能收发文本的接口都适用。
四、验收清单
| 现象 | 判断依据 | 下一步动作 |
|---|---|---|
| 模型把示例当真数据 | 示例没进独立标签 | 示例进 <示例> 并声明非真实数据 |
| 回答引用了标签外内容 | 没写「只依据标签内」 | 补引用规则,重跑回归 |
| 判定器报未闭合 | 标签漏写闭合半边 | 补全成对,再核对一次 |
| 多段材料被混答 | 各段共用一个标签名 | 分段各自命名,答案分段回收 |
| 标签字符被接口转义 | 平台对尖括号有限制 | 改用双方括号等替代记号,全篇统一 |
用这张清单前先确认一点:标签只是隔离手段,隔离是否生效永远以实测回复为准,判定器只保证语法完整。
五、注意与相关
- 标签三守则:成对、不重名、引用规则写明。
- 「只依据标签内内容」是长输入任务的默认边界,写它比不写稳。
- 来源:Model Studio 提示词指南
https://help.aliyun.com/en/model-studio/prompt-engineering-guide要求背景与任务分开交代。标签命名、引用规则与判定器是教程自己组织的方案。 - 相关:片段投喂与边界契约见 Qwen 的上下文和文件边界在哪;JSON Schema 见 让 Qwen 按字段 Schema 输出 JSON;系统消息分层见 Qwen 提示词系统消息各管什么。
















更多建议: