
 TRAE-AI编程


长文档怎么问 Qwen 才不编造
2026-11-16 18:08 更新
长文档问答的编造,多半不是模型「瞎说」,是问题越出了贴给它的片段;把片段切准、把问题限定在片段内、给每条回答配「未提及」出口,编造空间就收掉了。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用任务 | 合同条款核对、手册检索、多文件摘要等「答案必须在材料里」的场景 |
| 不适用 | 开放分析——模型可以自由发挥的场景谈不上编造 |
| 官方依据 | qwen3.7-max 原生上下文 1,000,000 tokens,最大输入 991,808、思考模式最大输入 983,616;上限够大不等于该整篇投喂 |
二、怎么做
三步把长文档问答收紧到片段口径:
- 切片段再投喂:按问题把文档切成相关片段(按条款、按章节),只贴片段不贴全文。上下文上限参考 1.3 的算法:上限减计划投喂量,留出输出与思维链空间。
- 问题限定片段:提问写明「只依据下面的片段」,并把片段包在独立标记里(包裹写法见 Qwen 长输入用 XML 标签包)。
- 给「未提及」出口:要求每个回答带原文引用,片段里没有的信息一律答「未提及」——模型没有「说不清楚」的合法出口时,才会编。
开工前先看一组对照。
坏写法:
这份售后条款里有什么费用?没贴片段、没限定来源、没给「未提及」出口——模型可能凭常识补出「安装费」「上门费」,条款里根本没有。
改写后的完整提示词:
只依据下面的片段回答。每条回答必须附片段原文引用(连续短句,不超过 30 字);片段里没有的信息,该条一律写「未提及」,不要推测。

【片段开始】
售后服务条款(编号 SV-07):主机自签收之日起质保两年,配件质保一年。运费由买方承担。质保范围不含人为损坏。7 天内非人为故障可退换。
【片段结束】

请逐条列出:该片段提到的所有费用相关项目。
三个动作都在:片段有边界、引用有锚点、「未提及」是合法出口。
拿到回答后,用判定器逐条核对引用锚点:每条事实取前 4 字回片段里找原文,找不到即疑似编造:
## EXPECT: 质保两年=命中 运费自理=未命中
SNIPPETS = {"质保": "主机自签收之日起质保两年,配件质保一年。", "运费": "运费由买方承担。"}

def anchored(claim, key):
    return key in SNIPPETS and claim[:4] in SNIPPETS[key]

print(f"质保两年={'命中' if anchored('质保两年', '质保') else '未命中'} 运费自理={'命中' if anchored('运费自理', '运费') else '未命中'}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:「质保两年」的前 4 字在质保片段原文里,命中;「运费自理」与片段原文「运费由买方承担」措辞不符,未命中——正是要抓的改写型编造。判定器只做锚点抽查,覆盖不了的编造靠「未提及」出口与多次问答交叉兜底。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
1. 运费由买方承担。引用:“运费由买方承担”
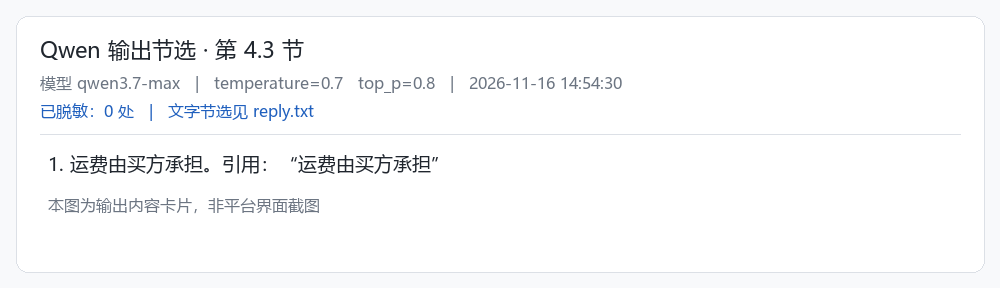
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 投喂量 | 非思考模式最大输入 991,808 tokens;思考模式 983,616,留余量给输出 |
| 输出上限 | 最大输出 131,072 tokens;逐条引用按条数控篇幅(见 控制 Qwen 输出篇幅与禁前言) |
| 引用粒度 | 每条引用截原文连续短句(≤30 字),拼改过的句子不算引用 |
| 未提及口径 | 「未提及」必须整条回答可用,不能拿未提及与编造内容混排 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 锚点核对 | 回答里每条事实都能在片段中找到原文锚点(判定器逐条比对) |
| 无越界回答 | 片段外的问题全部落到「未提及」,无一处编造 |
| 引用可回查 | 每条引用贴回片段原文能逐字对上 |
| 停手条件 | 同一片段连续 3 次问答零编造,该片段可并入批量流程 |
五、注意与相关
判定器的锚点核对是抽查手段,抽不到的编造靠「未提及」出口兜底:出口越明确,编造越少。切片段的粒度选择见 Qwen 的上下文和文件边界在哪;逐条引用的输出格式契约见 Qwen 输出怎么落进表格;把这套流程系统化成检索加问答管道属第 6 章范围。
以上内容是否对您有帮助:
















更多建议: