
 TRAE-AI编程


哪些中文写法让 Qwen 输出不稳
中文提示词的稳定输出,输在三类细节:歧义量词、繁简混排、语气模糊——发送前过一遍审计,比事后重试省得多。
一、前提与适用
| 适用对象 | 前提 | 不适用 |
|---|---|---|
| 提示词产出忽好忽坏的人 | 已能稳定调通模型 | 提示词只试过一次,还没有「忽好忽坏」的样本 |
| 要把中文指令交给团队复用 | 有一份要固化的指令文本 | 纯英文提示词场景(规则同样适用,词表不同) |
| 想排查「为什么这次输出又偏了」 | 保留了当时的原始指令 | 模型本身故障或网络异常的排查 |
本节示例用 qwen3.7-max;示例参数 temperature=0.7、top_p=0.8 属选取默认值,不是官方推荐。官方把「清晰具体」列为发挥模型能力最重要的一步,本节的三类词表就是这一条在中文里的落法。
二、怎么做
三步:审计 → 改写 → 固定输出格式。
第 1 步,审计。 用下面的判定器扫一遍指令文本,命中三类高频不稳写法:歧义量词(一些、若干、几个)、繁简混排(简体正文里混入繁体字)、语气模糊(大概、尽量、随便)。
## EXPECT: 量词=2 繁简=2 语气=2 需改写=6
import re

RULES = [
    ("量词", r"一些|若干|[几二三四五]个"),
    ("繁简", r"[數據處後組織發設運]"),
    ("语气", r"大概|尽量|看着办|随便|差不多"),
]

def audit(text):
    return {name: len(re.findall(pat, text)) for name, pat in RULES}

bad = "帮我整理一些數據,大概列几个要点,尽量简短。"
r = audit(bad)
total = sum(r.values())
print(" ".join(f"{k}={v}" for k, v in r.items()) + f" 需改写={total}")
第 2 步,改写。 逐处替换:量词给数字(列 5 个要点),繁简统一(數據 → 数据),语气词换成可判定的标准(尽量简短 → 每条不超过 20 字)。
第 3 步,固定输出格式。 改写不只补数字,还要约定输出的形状——条数、字段、顺序都写死,模型才没有自由发挥的空间。
开工前先看一组反例与正例。
坏写法:
帮我整理一些數據,大概列几个要点,尽量简短。两处量词(一些、几个)、一处繁简(數據,两个字符各计一次)、两处语气词(大概、尽量)。「整理」没说输出什么格式,「要点」没说数量和方向——模型只能自己猜,每次猜得还不一样。
改写后的完整提示词:
你是中文指令改写助手。请把下面的模糊指令改写成一条清晰具体的指令。
要求:
1. 指出原指令的三类含糊点(歧义量词、繁简混排、语气词)各一处;
2. 改写后指令补充明确的数量、范围与输出格式;
3. 只输出三行,格式固定为:
含糊点:…
改写:…
理由:…

原指令:{{原始指令}}
最小可跑填法:原始指令 填一条真实的不稳指令,例如「帮我整理一些數據,大概列几个要点,尽量简短」。随请求参数:模型 qwen3.7-max、enable_thinking=false、temperature=0.7、top_p=0.8——改写是格式固定的短任务,关思考更稳也更省。
实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:三类各命中 2 处、合计 6 处需改写;判定器核对的是「词表规则命中数」,词表可按团队业务自行增删,但每条规则要保持「命中即需改写」的强度。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
含糊点:“一些”为歧义量词、“數據”属繁简混排、“尽量”为模糊语气词。
改写:请将以下50条简体中文销售数据整理为3个核心要点,以无序列表输出,每条不超过20字。
理由:消除三类含糊并量化数量、限定语言范围与格式,确保输出精准可执行。
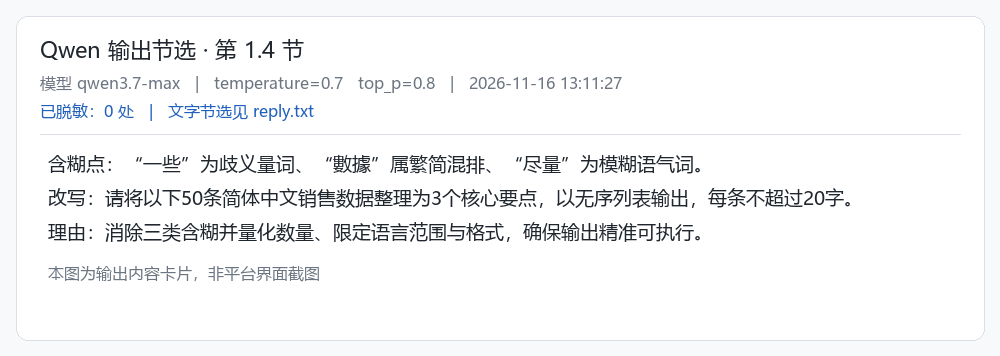
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 项 | 稳的写法 | 不稳的写法与后果 |
|---|---|---|
| 数量表述 | 给数字:列 5 个要点 | 一些、若干、几个:条数每次不同 |
| 字形 | 全文简体,专有名词除外 | 简体正文混繁体字:术语识别易跑偏 |
| 程度标准 | 可判定:每条不超过 20 字 | 大概、尽量、差不多:无法验收 |
| 语言面 | 模型支持 100+ 语言与方言 | 多语言不等于随意混排;同一指令内混排最不稳 |
| 词表维护 | 按团队业务增删规则 | 词表照抄本节,漏掉自家高频词 |
「支持 100+ 语言与方言」说明模型有能力处理繁体或方言,但能力不等于稳定:混排的输出方差主要来自指令侧,不在模型侧。
四、验收清单
| 现象 | 判断依据 | 下一步动作 |
|---|---|---|
| 同一指令输出条数忽多忽少 | 指令里有歧义量词 | 换成数字,写死条数 |
| 专有名词被拆错或翻译走样 | 正文混入繁体字 | 全文统一简体,名词加引号 |
| 输出长短漂移大 | 有「尽量」「大概」类词 | 换成可判定的字数或条数标准 |
| 改写后仍不稳 | 输出格式未固定 | 补格式约定:字段、顺序、条数 |
| 词表误报正常写法 | 规则命中了合理用例 | 缩窄该条规则或删掉,别为过审计改坏指令 |
用这张清单前先确认一点:判定器只是初筛,命中不必然是问题(比如引用原文里的繁体字),改不改以「能不能写出可判定标准」为准。
五、注意与相关
- 三类词表是初筛不是终审:命中后看能不能补出可判定标准,能补才改。
- 「清晰具体」不是堆字数:把模糊词换成可验收的数字与格式,指令反而更短。
- 词表规则本身要可解释:每条规则说得出「为什么命中即不稳」,说不出的就删。
- 来源:阿里云 Model Studio 提示词指南
https://help.aliyun.com/en/model-studio/prompt-engineering-guide把「清晰具体」列为发挥模型能力最重要的一步;Qwen 官方模型总览给出 100+ 语言与方言的多语言能力。本节的中文词表与判定器是教程为讲清「中文写法审计」自己组织的方案。 - 相关:模糊要求换约束的完整框架见 把模糊要求换成 Qwen 能核对的约束;采样参数与稳定性见 Qwen 采样参数与成本。
















更多建议: