
 TRAE-AI编程


H3 请求生命周期
「中间件为什么不返回就继续往下走?」「为什么 handler 忘了写 return,接口返回 200 但内容为空?」「404 到底是谁发的?」——这三个问题都指向同一件事:H3 处理一个请求的固定顺序。
这一节把请求从进入到返回拆成四个阶段,每个阶段做什么、挂了哪个钩子、失败了谁兜底,都在下面。
四个阶段总览
| 阶段 | 做什么 | 涉及的钩子 |
|---|---|---|
| 1. 接收请求 | 运行时把 HTTP 请求交给 server.fetch |
无 |
| 2. 接受请求 | 构造 H3Event,调用全局 onRequest |
onRequest |
| 3. 分发请求 | 匹配路由,跑全局中间件,最后跑命中的 handler | 无(中间件在此执行) |
| 4. 发送响应 | 把返回值转成 Response,调用 onResponse |
onResponse |
阶段 1:接收请求
浏览器或 fetch() 发起请求后,服务端的 fetch 处理器收到一个标准 Request 对象:
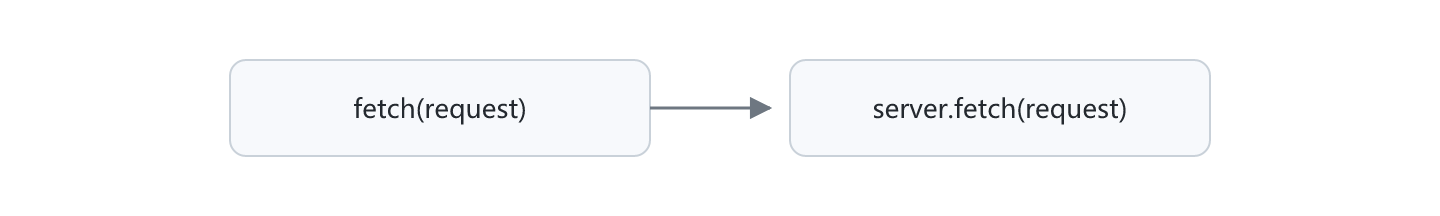
fetch(request) 进入后交给 server.fetch(request),界面上只有这一跳。
这一步由 srvx 的入口接管,H3 还没开始处理。server.fetch 这个统一接口由 srvx 提供——它同时也补上了 Node.js 的兼容层,让「标准 fetch 语义」在 Node 里也能成立。
阶段 2:接受请求
H3 从进来的请求构造出 H3Event,先调全局 onRequest,再把事件交给应用主处理器(即 app.handler):
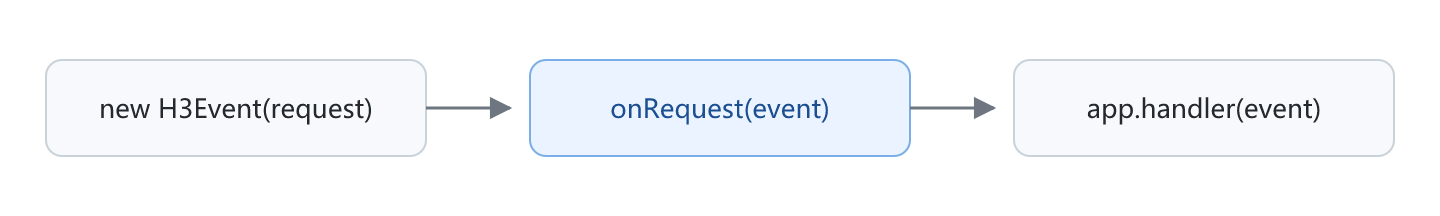
蓝色方框是全局钩子:先构造事件,再走 onRequest,最后进入应用主处理器。
H3Event 是这一本书里出现频率最高的对象。后续所有 handler、中间件、工具函数拿到的都是它,event.req / event.res / event.url / event.context 都挂在上面(结构见 4.2)。
💡
onRequest是最早能插手的位置。适合做请求 ID 注入、访问日志起点、限流计数这类「进入即记录」的事。
阶段 3:分发请求
H3 按 request.url 与 request.method 匹配路由,然后先跑全局中间件,再跑命中的路由 handler。中间件之间通过 next() 串联,形成一条可拦截的调用链。这条链实际分「下沉」「上浮」两段,用时序图展开:
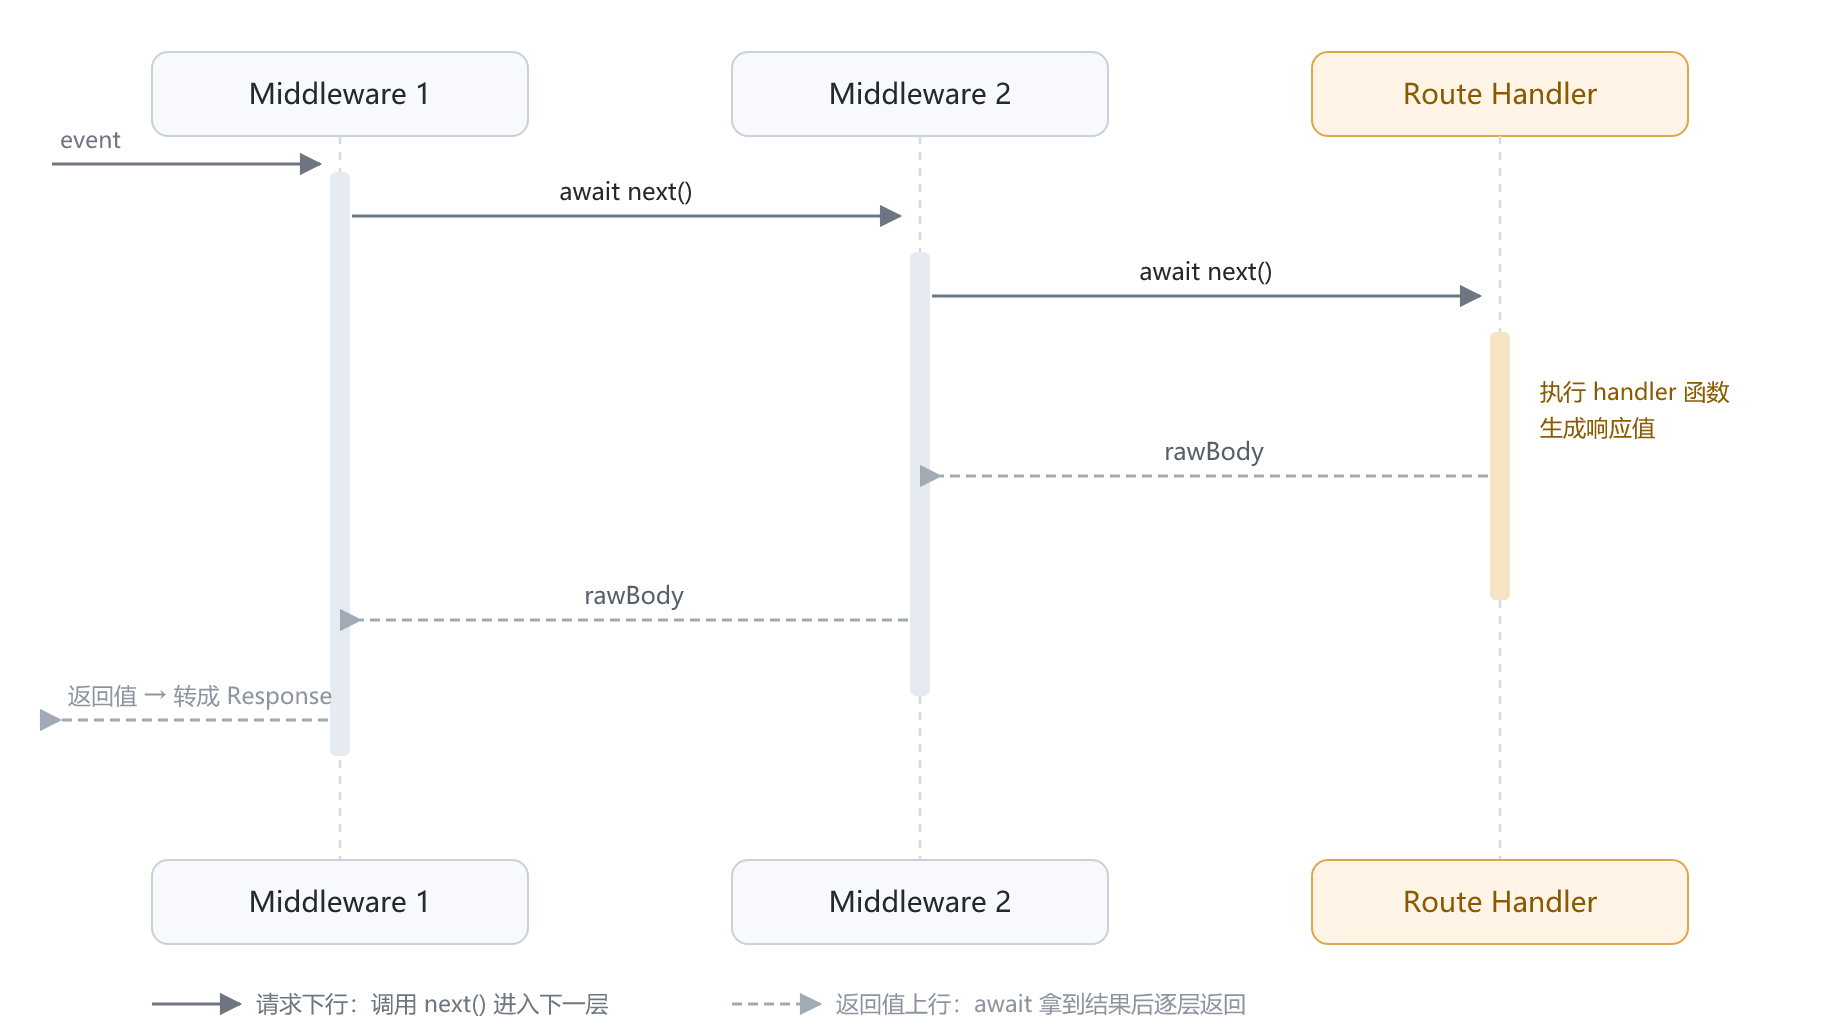
图里三个参与者上下各出现一次,中间竖直虚线是各自的生命周期;生命线上的浅色竖条表示「它正在执行」。读法是:
await next()由左向右,一层层往下叫,直到Route Handler真正产出值;- 路由 handler 返回后,
rawBody由右向左虚线回传,一层层上浮; - 每个中间件的执行被
await next()切成两段——调用前是请求处理,调用后是响应处理。
这就是「洋葱」的形状。H3 用显式的 next() 表达,而不是像 Koa 那样靠中间件自身的 async 语义隐式约定,好处是「我要不要往下走」写在代码里,读代码时不必推断。
💡 变量名
rawBody说明了一件事:中间件拿到的不是最终的Response,而是下一层返回的原始值。你可以在上浮阶段改它(比如把对象换成Response、或包装成统一结构),也可以原样返回。返回undefined就等于把这个值弄丢了。
🚀 一个实现细节:匹配路径时 H3 内部用的是 srvx 的
FastURL,而不是new URL(req.url).pathname。原因是后者要为每个请求构造完整 URL 对象,在高并发下是可观的固定开销。
阶段 4:发送响应
handler 的返回值被转换成标准 Response,onResponse 钩子拿到最终响应,然后交回 server fetch。
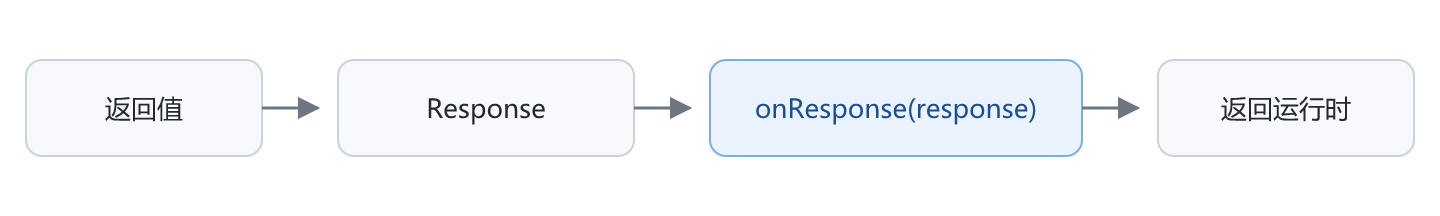
转换规则(对象转 JSON、流原样发送、null 转空体等)在 2.5 节详列。
三条必须记住的分支规则
生命周期里最容易记混的是「不返回会发生什么」。规则只有三条,但方向不同:
| 情形 | 结果 |
|---|---|
中间件返回了值(非 undefined,且不是 next() 的结果) |
立即短路,后续中间件与 handler 都不执行,直接以该值作为响应 |
| 中间件都不返回,且路由 handler 也不返回 | 最终 404 |
| 路由 handler 命中但不返回 | 200 + 空响应体 |
这三条解释了开头那三个疑问:
- 中间件忘写
return→ 不短路,请求继续往下走(多数时候正是你要的)。 - handler 忘写
return→ 你得到 200 和空内容,而不是报错。空响应不会报错,这是排查「接口返空」时最该先怀疑的地方。 - 404 不是 handler 发的,是「没有任何一环产出响应」的兜底结果。
// 中间件 1 直接返回 → 后面的中间件和 handler 都不会执行
app
  .use(() => "Middleware 1")
  .use(() => "Middleware 2")
  .get("/", () => "Hello");
// 请求 / 得到的是 "Middleware 1",不是 "Hello"
在哪个阶段做什么
| 你想做的事 | 该放在哪 |
|---|---|
| 注入请求 ID、记录开始时间 | 全局 onRequest 钩子,或第一个中间件 |
| 鉴权、限流、CORS | 全局中间件(路径可限定,见 2.3) |
| 记录最终状态码、耗时 | onResponse 钩子,或包一层 await next() 的中间件 |
| 统一错误上报 | onError 中间件(嵌套应用场景下比全局钩子可靠,见 2.6) |
| 具体业务逻辑 | 路由 handler |
⚠️ 官方对全局中间件有一条明确建议:能用可组合的工具函数就别用全局中间件。全局中间件会让执行顺序隐式依赖注册顺序,应用一旦变大就难以预测。这也是第 3 章「路由规则」想解决的问题——响应头、重定向、跨域、缓存这些横切逻辑用配置声明,比堆中间件更可控。
延伸阅读
- 路由如何被匹配、模式如何归一化:见 2.2 路由
- 中间件的注册、路径限定与短路规则:见 2.3 中间件
- handler 的三种写法与惰性加载:见 2.4 事件处理器
- 用路由规则替代重复中间件:见 3.1 路由规则入门
















更多建议: