
 TRAE-AI编程


H3Event 事件对象
每个 HTTP 请求进来,H3 都会构造一个 H3Event,然后把它交给中间件、交给路由 handler,直到响应发出。它同时握着三样东西:进来的请求、待发的响应、贯穿全程的共享上下文。
理解 H3Event 的关键是分清「哪个字段属于哪一层」——event.req 是标准的、只读的请求;event.url 是解析并归一化过的路径;event.res 是还没发出去的响应预备区,可以直接改;event.context 是给你自由存放数据的抽屉。
四个核心属性
| 属性 | 类型 | 能改吗 | 用途 |
|---|---|---|---|
event.req |
标准 Request 加运行时扩展 |
只读(引用) | 读方法、头、请求体 |
event.url |
URL(srvx 的 FastURL) |
pathname 可写 |
读路径、查询参数 |
event.res |
status、statusText、headers、errHeaders |
可改 | 准备响应状态与头 |
event.context |
普通对象 | 可改 | 跨工具共享请求级数据 |
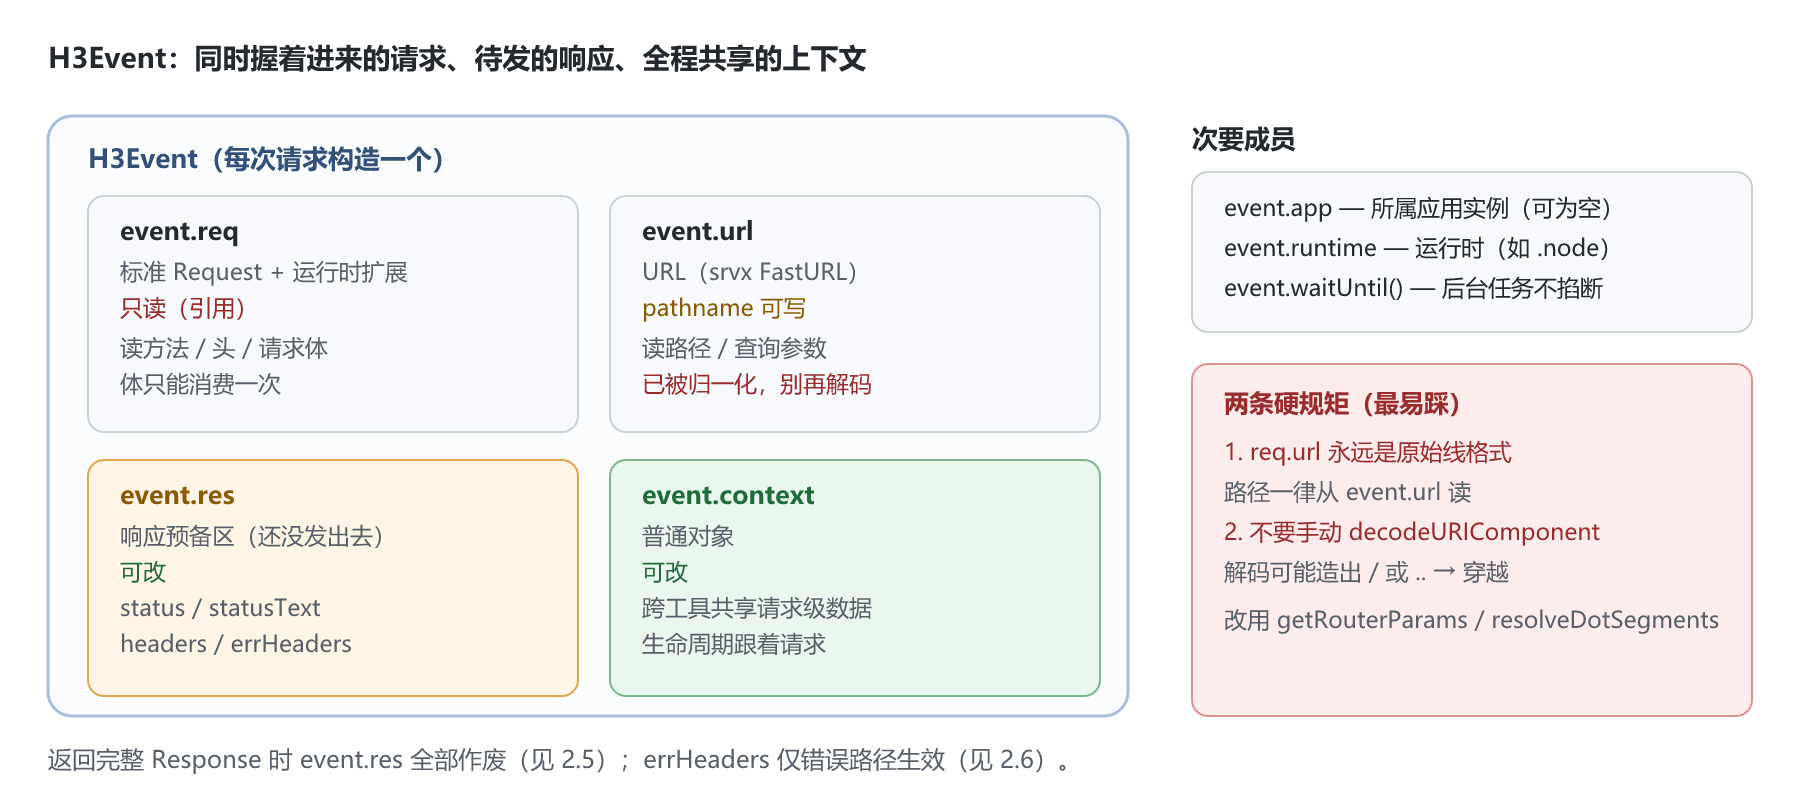
另有三个次要成员:event.app(所属应用实例,可能为空)、event.runtime(运行时上下文,如 event.runtime.node)、event.waitUntil()(见后文)。
req:标准 Request,加运行时的扩展字段
event.req 是 Web 标准的 Request,所以在浏览器端学到的用法直接可用:req.method、req.headers、req.text()、req.json()、req.formData()、req.body。
import { H3 } from "h3";

const app = new H3().post("/echo", async (event) => {
  // 头是标准 Headers 对象,取值一律返回字符串或 null
  const type = event.req.headers.get("content-type");

  // 请求体只能消费一次:下面三行同时写会抛「body already used」
  if (type?.includes("application/json")) {
    return await event.req.json();
  }
  return await event.req.text();
});
除了标准字段,srvx 还给 req 补了运行时相关的扩展(如客户端 IP、原始 socket),具体字段随运行时不同,需要时查 srvx 文档。不要 再用 v1 的 event.node.req 去拿原生对象,v2 里那条路走 event.runtime.node。
url:路径已经归一化,别自己再解码
这是整节最需要认真读的地方。event.url 是解析后的 URL,searchParams、search、hash 全都在;特殊之处在于 pathname 已经被归一化过一次。
它归一化什么
规则只有一句话:只解掉「不必要」的转义,也就是那种「代理、文件系统、你自己调用 decodeURIComponent 都会当成字面字符,而 H3 的匹配器却把两者当不同字符串」的转义。
| 请求路径 | event.url.pathname |
为什么 |
|---|---|---|
/%61dmin |
/admin |
不保留字符被多余编码 |
/a%2eb |
/a.b |
同上 |
/a%21b |
/a!b |
下游会解码 |
/%40handle |
/@handle |
下游会解码 |
/a/%2e%2e/b |
/b |
URL 解析器先处理掉了点段 |
/x%2fy |
/x%2fy |
分隔符,必须保持编码 |
/x%5cy |
/x%5cy |
分隔符,必须保持编码 |
/100%25 |
/100%25 |
解了会暴露嵌套转义 |
/a%20b |
/a%20b |
空格反正会被重新编码 |
/caf%C3%A9 |
/caf%C3%A9 |
非 ASCII 反正会被重新编码 |
被解码的集合 = RFC 3986 §2.3 的非保留字符(字母、数字、-、.、_、~)加上 !、$、&、'、(、)、*、+、,、:、;、=、@、[、]、|,再去掉 %2f 和 %25。这个范围比 decodeURI 更宽——decodeURI 会保留 RFC 3986 的全部保留字符,而在一段已经解析好的路径里,只有 / 才是结构性的。
为什么值得这么麻烦
因为不归一化就会出现这类绕过:/%61dmin 在字符串比较里不等于 /admin,会从 /admin 守卫的缝隙里滑过去,却又被下游按 /admin 处理。归一化的效果是——路由匹配、use() 匹配、你自己读 event.url.pathname 的判断,三者比较的是同一个字符串。
配套的两条硬规矩:
event.req.url永远是原始线格式。非规范路径下它和event.url.pathname不一致,所以路径一律从event.url读,绝不用event.req.url自己切——按一个字符串的偏移去切另一个,正是挂载前缀和代理目标错位的根源。- 不要自己
decodeURIComponent(event.url.pathname)。解码可能凭空造出一个/或..,而路由和中间件从没见过它;这个值一旦流向文件系统或上游 URL,就是路径穿越。
需要解码形态的路由参数,用工具函数:getRouterParams(event, { decode: true })(解码其余部分,但保留编码后的分隔符);需要给路径做作用域判断,用 resolveDotSegments(path) 先规范化。这两个函数分别在 6.2 和 6.6 讲。
畸形编码怎么办
/foo%、/%ZZ 这类没有可归一化形式的路径,会在任何 handler 运行之前被直接拒绝,返回 400 Bad Request。想让它们以原始路径放行,用 4.1 里的 allowMalformedURL 配置项——放行意味着你把「路径长什么样」的判断权完全交给下游,只在明确知道下游怎么处理时才开。
⚠️ 归一化发生在
H3Event构造函数里,所以mockEvent()造出来的事件、以及直接调app.handler(event)的路径同样覆盖。这一点很重要:单元测试里手写的 event 不会绕过这条规则。
res:还没发出去的响应
event.res 是响应预备区,四个字段:
| 字段 | 说明 |
|---|---|
status |
状态码,默认 200 |
statusText |
状态文本,一般不用改 |
headers |
响应头,标准 Headers 对象 |
errHeaders |
仅用于错误响应的头,正常路径不会带上 |
import { H3, HTTPError } from "h3";

const app = new H3().get("/data", (event) => {
  // 正常响应头:状态码与缓存策略
  event.res.status = 200;
  event.res.headers.set("cache-control", "no-store");

  // errHeaders 只在走错误路径时生效,用来给错误响应补 CORS 等头
  event.res.errHeaders.set("access-control-allow-origin", "*");

  if (!event.req.headers.get("x-api-key")) {
    throw new HTTPError({ status: 401, message: "缺 api key" });
  }
  return { ok: true };
});
errHeaders 是 2.6 里那条「抛错后准备的头全丢」的正解:正常响应头随 res 一起被丢弃,只有 errHeaders 会被合并进错误响应。
反过来,一旦 handler 返回完整的 Response,event.res 上的状态与头就全部作废——Response 已经是最终结果,H3 不再改动它。这条在 2.5 用图讲过,出错时最难排查,因为代码看着完全正常。
context:请求级共享抽屉
event.context 是个普通对象,任何工具函数、中间件、handler 都能读写,生命周期跟着请求走。
| 已知键 | 由谁写入 | 说明 |
|---|---|---|
params |
路由匹配 | 路由参数,形如 { id: "42" } |
middlewareParams |
use() 匹配 |
带路径中间件捕获的参数 |
matchedRoute |
路由匹配 | 命中的路由记录,含 meta |
sessions |
会话工具 | 已解析的会话缓存 |
routeRules |
路由规则 | 当前路由合并后的只读规则集 |
clientAddress |
运行时 | 受信任的客户端地址 |
basicAuth |
requireBasicAuth |
通过校验后的用户名与 realm |
timing |
setServerTiming |
收集到的 Server-Timing 条目 |
官方 API 页只列了前五个,routeRules、clientAddress、timing 是读类型定义才看得到的,实际很常用——尤其 routeRules,想在 handler 里读当前路由合并后的规则(比如判断是否 cors: true)就靠它。
自定义键没有命名空间的隔离,建议统一加前缀,避免和未来新增的内置键撞名:
// 加上团队前缀,降低与内置键冲突的概率
event.context.acmeUser = { id: 7 };
💡
context只在单次请求内有效。跨请求要缓存,用模块级变量或专门的缓存工具,不要指望context。
waitUntil 与 runtime
waitUntil(promise) 告诉运行时「这个异步操作还没完,别急着关掉执行环境」。它不会让响应等这个操作——响应照常立即返回,只是后台任务不会被提前掐断:
import { H3 } from "h3";

const app = new H3().get("/", (event) => {
  // 埋点上报放到后台,不拖慢响应
  event.waitUntil(
    fetch("https://telemetry.example.com/collect", {
      method: "POST",
      body: JSON.stringify({ path: event.url.pathname }),
    }).then(() => undefined),
  );
  return "ok";
});
需要「请求彻底结束后释放资源」(定时器、上游连接、打开的文件),用 onDispose(event, cb) 而不是 waitUntil——前者在每个运行时上都可靠,后者依赖运行时支持。
event.runtime 是运行时上下文的入口,Node 下就是 event.runtime.node,里面有原生 req/res。需要 srvx 之外的底层能力时才用它,业务代码里出现它通常意味着可以换个写法。
已弃用的四个属性
v2 保留了以下属性但已标记弃用,未来的版本可能移除:
| 弃用属性 | 替代写法 |
|---|---|
event.path |
event.url.pathname + event.url.search |
event.method |
event.req.method |
event.headers |
event.req.headers |
event.node |
event.runtime.node |
从 v1 迁过来的代码几乎都会命中这四条,逐条替换的完整清单见 8.1。
排查表
| 现象 | 最可能原因 | 处理 |
|---|---|---|
路由参数里出现 %2F,且 id 段数不对 |
分隔符按规范保持编码,属预期 | 用 getRouterParams(event, { decode: true }) |
event.url.pathname 与 event.req.url 里的路径不一致 |
请求带了多余的转义,被归一化 | 以 event.url 为准 |
自己解码后出现 /../,读出越权文件 |
手动 decodeURIComponent 造出了点段 |
改用 resolveDotSegments 并做作用域校验 |
| 抛错后 CORS 头消失 | 头设在 res.headers 上 |
改设 res.errHeaders |
返回 new Response() 后状态码不对 |
Response 是最终结果 |
状态码设在 Response 构造参数里 |
某个 handler 里没有 event.context.params |
该请求没走路由匹配(如全局中间件短路) | 检查中间件是否提前 return |
| 后台任务偶发没执行完 | 用了裸 fetch 未 waitUntil |
包进 event.waitUntil() |
延伸阅读
H3Event在四个阶段里被谁读写:见 2.1 请求生命周期- 路由模式自身的归一化规则:见 2.2 路由
- 返回值如何变成
Response、res何时失效:见 2.5 发送响应 errHeaders与错误响应的完整规则:见 2.6 错误处理
















更多建议: