
 TRAE-AI编程

很多人写 PyTorch 代码时照抄教程,训练前调用 model.train(),推理前调用 model.eval(),却说不清这两行到底干了什么。先给结论:model.train() 是把模型切成训练模式,开启 dropout 随机丢弃和批归一化的批次统计更新;model.eval() 则反过来关掉它们,让输出稳定可复现。用错的代价很具体——该评估时忘了切评估模式,同一个输入每次结果都不一样;该训练时没切训练模式,批归一化不更新,模型学不动。本文用一个能观察到差异的最小例子,讲清这两个开关控制的是什么、什么时候必须调用、以及用错后的典型症状和修复方法。想先补整体背景,可以先了解人工智能与神经网络的基本概念,再回来看这两个开关。
一、先看它到底切换了什么
model.train() 和 model.eval() 是模块的方法,作用是把模型里所有子模块的 training 标志设为 True 或 False。它们本身不训练、不计算,只是切换状态。真正受这个状态影响的主要是两类层。
- Dropout 层:训练模式下按概率随机把一部分神经元输出置零,用来防止过拟合;评估模式下全部保留。
- 批归一化层(BatchNorm):训练模式下用当前批次数据更新均值和方差,并累计到全局统计;评估模式下直接用累计的全局统计,不再随批次变动。
除了这两类层,普通全连接、卷积层对训练模式不敏感。所以如果模型里既没有 dropout 也没有批归一化,切不切模式对输出几乎没影响——这也是很多人照抄代码没出问题的原因,直到某天模型里加了 BatchNorm,结果突然变得诡异。想系统理解这些层在网络里的位置,可以翻 人工智能基础教程。
二、用最小例子观察差异
下面这段代码构造一个含 dropout 的模型,分别在训练模式和评估模式下对同一个输入连续推理,你能直接看到差别。
import torch
import torch.nn as nn

class DemoNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.drop = nn.Dropout(p=0.5)
        self.fc = nn.Linear(4, 2)

    def forward(self, x):
        return self.fc(self.drop(x))

model = DemoNet()
x = torch.ones(1, 4)

model.train()
a1 = model(x); a2 = model(x)
print("训练模式两次是否相同:", torch.equal(a1, a2))

model.eval()
b1 = model(x); b2 = model(x)
print("评估模式两次是否相同:", torch.equal(b1, b2))
# 预期结果(未在本机执行):训练模式为 False,评估模式为 True
关键就在 model.train() 和 model.eval() 这两行。同一个输入,训练模式下 dropout 每次随机丢弃不同神经元,两次输出不同;评估模式下 dropout 关闭,两次输出完全一致。这个可复现性的差异,正是推理阶段必须切评估模式的根本原因。
三、什么时候必须调用
把调用时机按阶段固定下来,就不会乱。
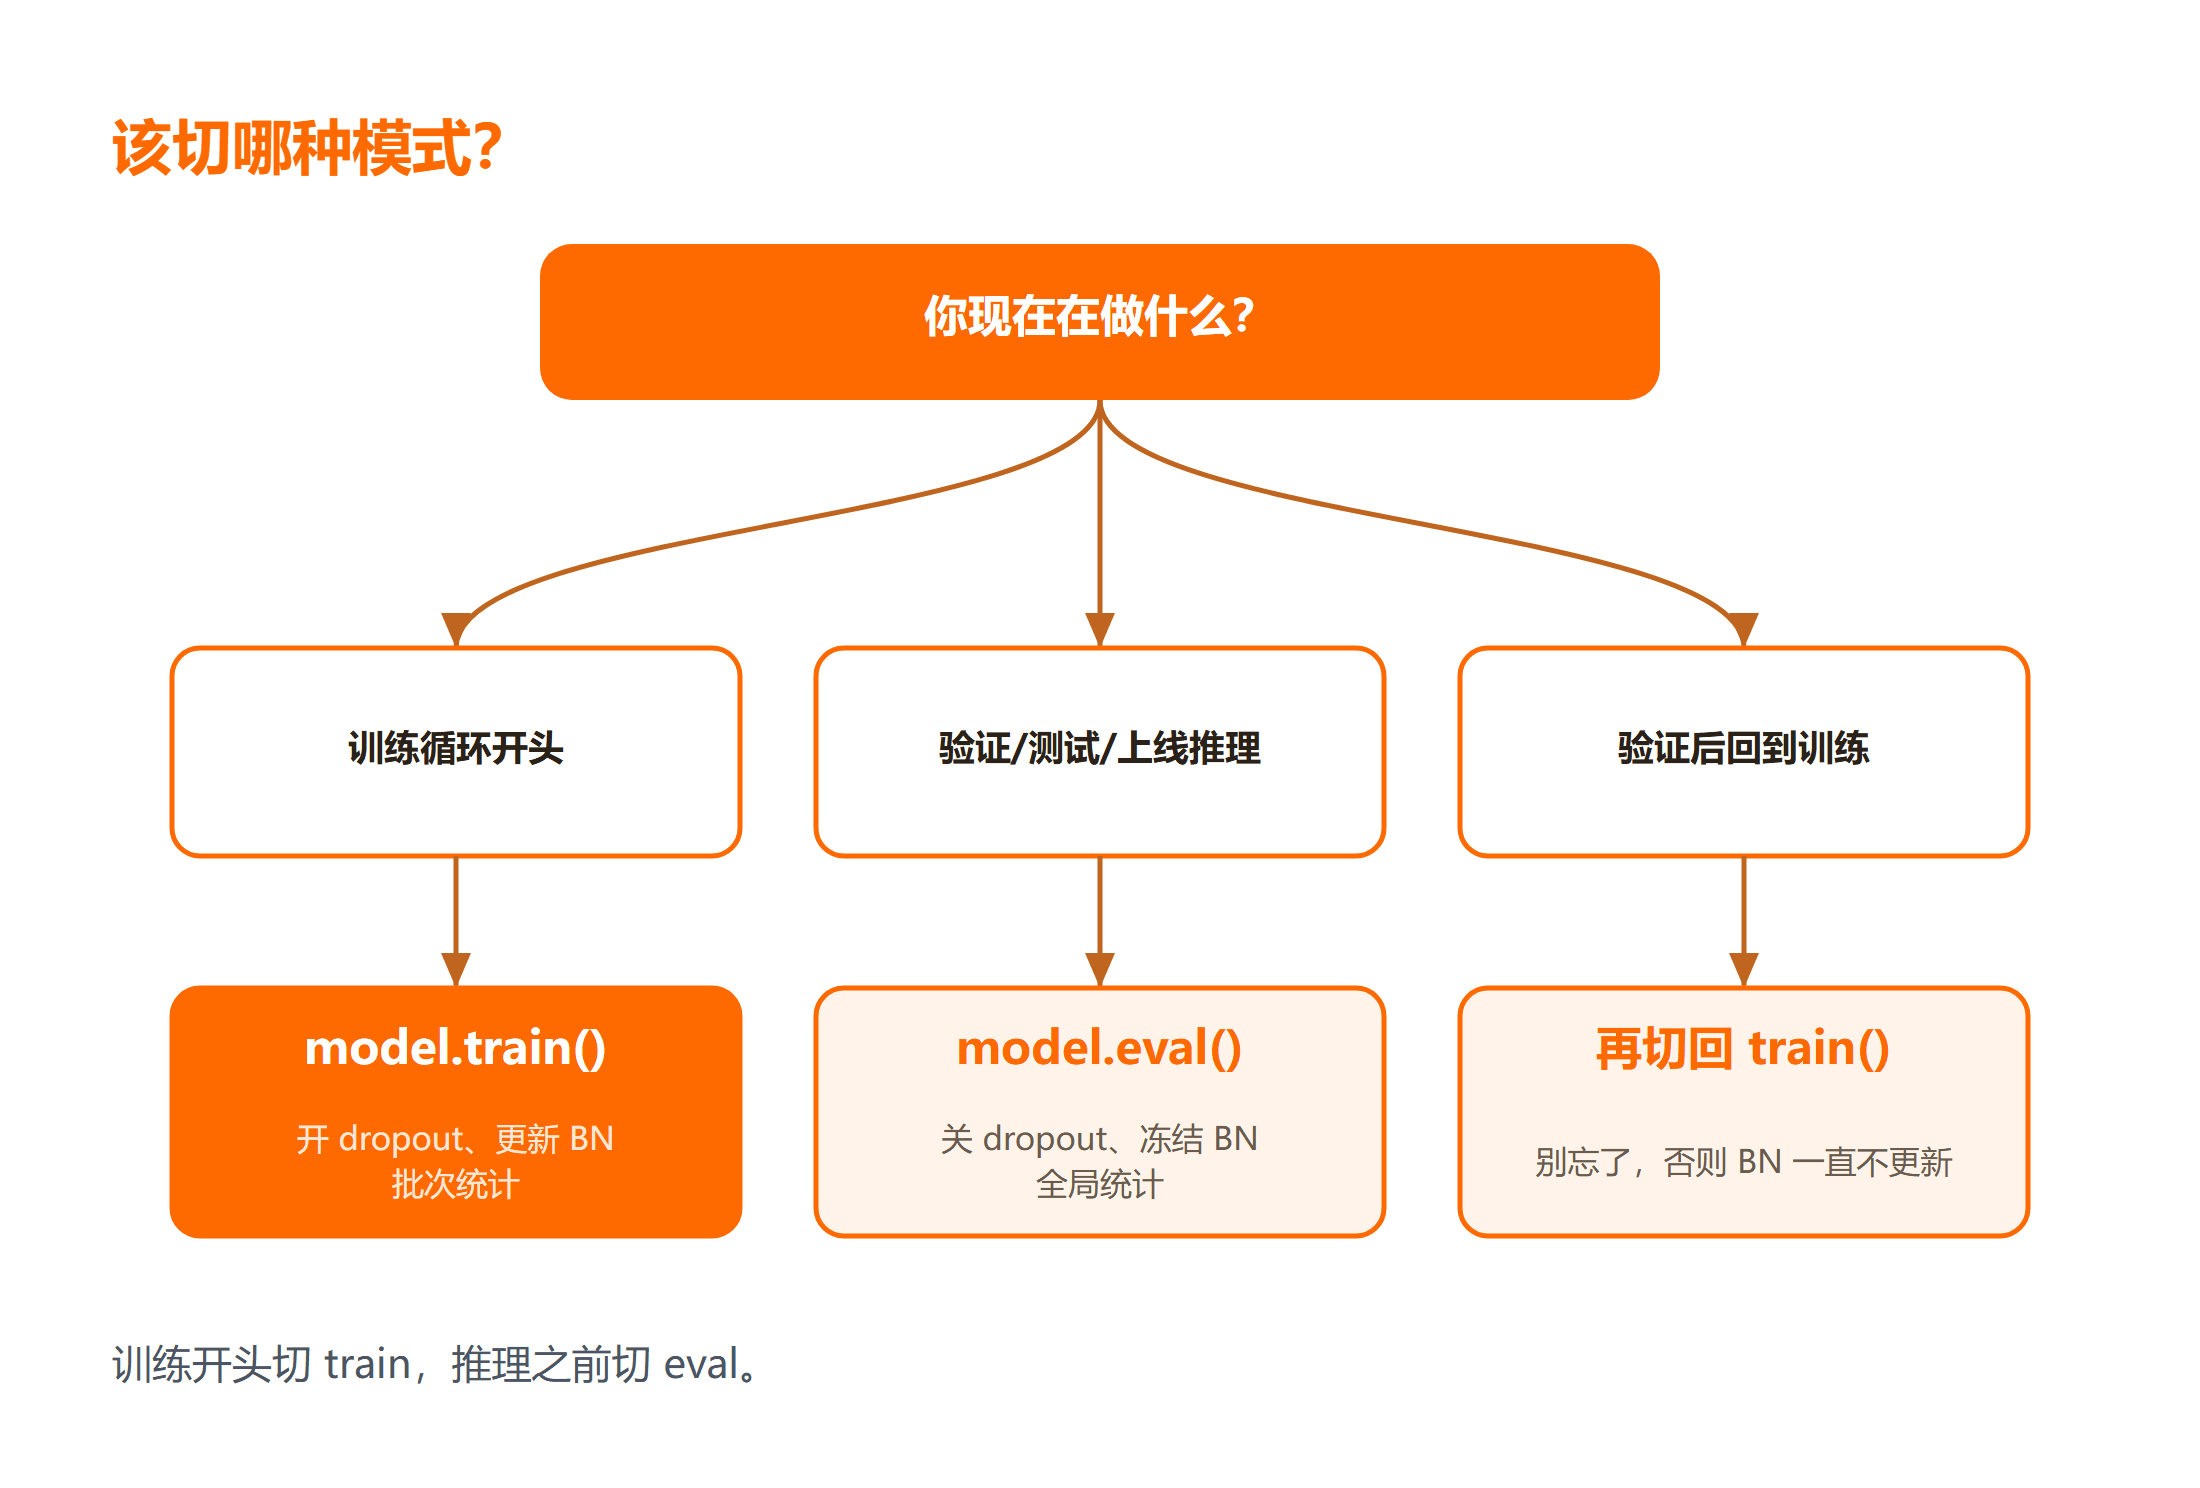
训练循环开始时调用一次 model.train()。它作用于整个训练阶段,不必每个 batch 都调。典型写法是在 epoch 循环外或循环开头调用,然后跑完所有批次。只有当你中途穿插了评估,再回到训练时才需要重新切回训练模式。
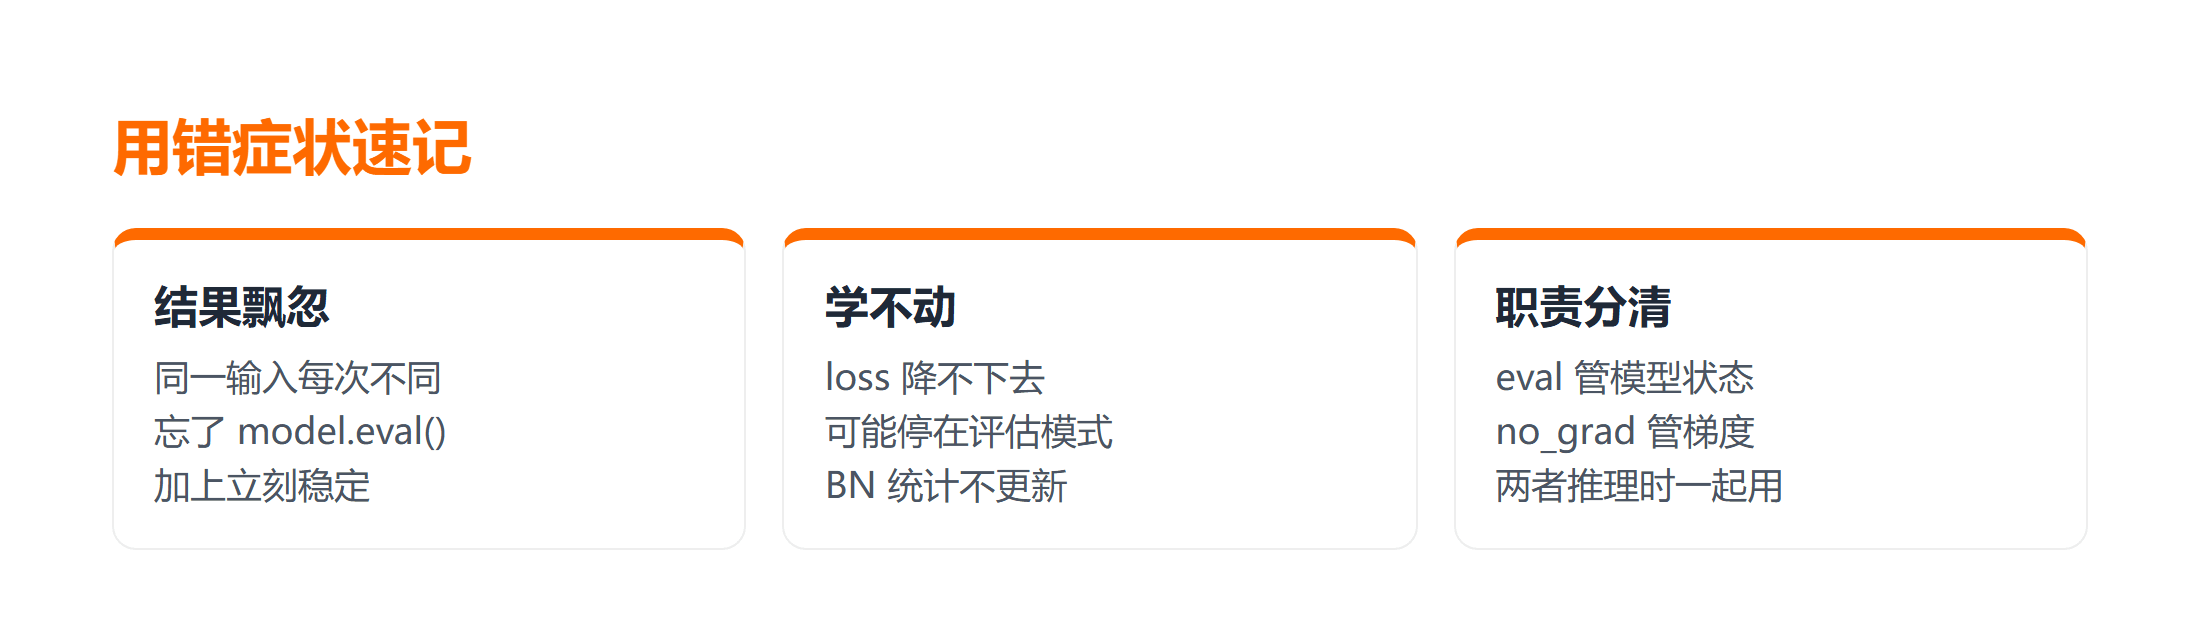
评估或推理前调用 model.eval()。验证集评估、测试、上线推理,都要先切。而且评估阶段通常配合 torch.no_grad() 使用,后者负责关闭梯度计算、省显存,两者职责不同,别混为一谈。
model.eval()                 # 切评估模式:关 dropout、冻结 BN 统计
with torch.no_grad():        # 关梯度:省内存、加快推理
    out = model(x)
验证集评估后别忘了切回训练模式。这是最容易被忽略的边界:很多训练脚本每个 epoch 先训练、再验证,验证时调了 eval(),下一个 epoch 忘记调 train(),于是后面的训练一直在评估模式下跑,BatchNorm 不更新,效果越来越差。要把训练、验证、推理这套流程用顺,建议先过一遍 AI 人工智能教程 把基础打牢。
四、用错的典型症状与排查
把几种常见症状和根因对应起来,遇到问题能快速定位。
- 同一个输入推理结果每次不同:几乎可以确定忘了
model.eval(),dropout 还在随机工作。加上这行再测,输出立刻稳定。 - 训练 loss 降不下去、模型学不动:检查是不是误在训练时停在评估模式,导致 BatchNorm 不更新统计。确认每轮训练开头有
model.train()。 - 训练正常、验证指标却很怪:验证时没切
eval(),指标里混入了 dropout 的随机性,多跑几次数值飘忽。切评估模式后指标会稳定下来。 - 切了 eval 结果还是不稳定:排查输入数据有没有随机增强、模型里有没有自定义随机层,别把所有不稳定都归咎于模式开关。
- 版本与适用边界:
train()/eval()的行为在不同 PyTorch 版本间基本一致,但自定义层如果重写了train()方法却没正确处理self.training标志,可能不按预期切换,这类问题要结合具体层的实现看。
⚠️ 注意:
model.eval()不会保存或恢复模型参数,它只改状态标志。别把它当成"冻结模型",要冻结参数得设置requires_grad=False。
五、动手核对清单
拿到一段训练或推理代码,按这个顺序自查模式切换是否到位。
- 前置:确认模型里有 dropout 或 BatchNorm,这些层才会受模式影响;
- 训练:每个 epoch 训练开头有
model.train(),中途没被验证打断后忘记切回; - 推理:验证、测试、上线推理前先
model.eval(),再配torch.no_grad(); - 验证:同一输入连续推理两次,评估模式下结果应完全一致;
- 失败处理:结果飘忽查 eval,学不动查 train,都正常再查数据增强和自定义层。
总结
model.train() 和 model.eval() 是一对状态开关,控制的是 dropout 和批归一化的行为,不是训练动作本身。训练阶段用 train() 开启随机性与批次统计更新,推理阶段用 eval() 关掉它们换取稳定输出。记住"训练开头切 train、推理之前切 eval、验证之后切回 train"这三句话,就能避开绝大多数模式用错的坑。
要点带走:
train()/eval()只切状态,不训练、不改参数;- 同一输入结果飘忽,先查有没有
model.eval(); - 训练学不动,查是不是停在评估模式导致 BN 不更新;
eval()配合torch.no_grad()用,前者管模式、后者管梯度。
常见问题
Q:模型里没有 dropout 和 BatchNorm,还需要调 train()/eval() 吗?
A:对输出几乎没影响,可以省略。但保持一致的模式切换是好习惯,尤其当以后给模型加层时不用改调用逻辑。
Q:model.eval() 和 torch.no_grad() 有什么区别?
A:eval() 切模型状态,关 dropout、冻结 BN 统计;no_grad() 关自动求导、省显存。一个管模型行为,一个管计算图,推理时通常一起用。
Q:为什么我加了 eval(),验证结果偶尔还是有波动?
A:先确认 eval 之后没有再误调 train;再查数据加载是否带随机增强、模型里是否有自定义随机层。模式只是影响稳定的因素之一。
延伸学习
- 想看社区里 PyTorch 的入门整理,翻 人工智能的基石——pytorch 这篇笔记;
- 想系统补 Python 基础,可以了解 AI零基础入门:人人都能用上的人工智能课;
- 想补整体 AI 概念,可以系统学一遍 人工智能概览教程。



