
 TRAE-AI编程

用 AI 辅助数据库设计时,最容易出的问题是它照着直觉把能想到的字段全堆上去,结果表里有大量冗余字段,更新时处处要同步。避免字段冗余的核心做法是:先让 AI 产出实体与关系,再按范式逐项收敛,最后用最小例子验证更新异常。本文基于 DeepSeek 与 TRAE 的能力,用一个订单表的最小例子讲清怎么识别冗余、怎么收敛。你会看到冗余字段长什么样、第三范式怎么用、以及一段可以照抄的收敛检查清单。看完你既能用 AI 把表结构快速搭出来,也知道哪里必须自己把关,而不是被一堆看似合理的字段带着走。今天这篇文章,编程狮就把这块讲透。
一、为什么 AI 设计的表容易冗余
AI 辅助数据库设计这件事,难点不在"出字段",而在"出得克制"。模型倾向于把用户提到的每个名词都变成一列,因为那样看起来更"完整"。理解了这点,才明白为什么要先做实体关系、再收敛。先过一遍 DeepSeek 中文教程 的提示词写法,能更好理解下面的收敛步骤。
1.1 触发条件
只要你是让 AI 一次性产出整张表结构,而不是先让它区分实体与属性,就存在字段冗余的风险。尤其当需求里出现"用户姓名、下单人姓名、收货人姓名"这类近义表述时,AI 常常各开一列。
⚠️ 注意:冗余字段不只是占空间,它会在更新时制造不一致:改了一处忘了另一处,数据就自相矛盾。设计阶段多花十分钟收敛,比上线后写同步脚本划算得多。
1.2 常见误解
很多人以为"字段多就等于信息全"。但数据库范式的目的恰恰是去掉重复、让每件事只存一处。真正稳妥的做法是先建模再填字段,而不是反过来。一个典型的反例是把"用户地址"同时放在订单表和个人资料表,用户搬家后两处不一致,你永远不知道哪个是对的。先建模再填字段,就是把"地址属于用户"这件事先定下来,订单表只记一个用户编号。
二、方案一:先建实体关系再填字段(最推荐)
这是避免字段冗余的第一道做法,适合所有表设计场景,代价只是多一轮对话。这是表结构设计保持干净的前提。
- 先让 AI 只输出实体和它们之间的关系,不要出字段;
- 确认实体划分合理后,再让每个实体独立出字段;
- 把跨实体的重复信息下沉到所属实体,主表里只留外键。
-- 收敛前:订单表里堆了用户名
CREATE TABLE orders (
  id INT, user_name VARCHAR(50), user_phone VARCHAR(20), product_name VARCHAR(100)
);
-- 收敛后:用户与商品独立成表,订单只留外键
CREATE TABLE orders ( id INT, user_id INT, product_id INT );
上面这段做的是把重复信息从订单表挪走。执行后你应在数据库里运行一遍更新,预期用户改名只改一处,订单表不再存可变冗余字段,更新异常自然消失。
如果 AI 仍然把用户名塞进订单,回到对话里补一句"订单只存外键,用户名属于用户表"。
三、方案二:用第三范式逐项检查
光分实体还不够,你还得证明没有传递依赖,并把范式检查配置成建表前的固定动作。这一道做法的关键是:对每张表逐列问"它依赖主键吗、还是依赖另一个非主键",把后者下沉。相关能力可以参考 TRAE 插件能力 的辅助建模用法。
对以下字段做第三范式检查,标出传递依赖:
- orders.user_name 依赖 user_id,不直接依赖主键 → 冗余,下沉到 users 表
- orders.product_name 依赖 product_id → 冗余,下沉到 products 表
上面这段让 AI 把冗余字段逐条点名,数据库范式从一句口号变成可执行的检查项。凡是被标为传递依赖的字段,都该移出当前表。这一步听起来学术,实际就是用大白话问:这条信息是不是离开了别的那一列就没法独立存在。如果是,它就该待在别处,而不是赖在主表里凑数,否则更新会失败。
💡 小提示:性能反范式是另一回事,但一定要先有范式版本再谈反范式,不要一上来就堆冗余字段。
四、方案三与横向对比
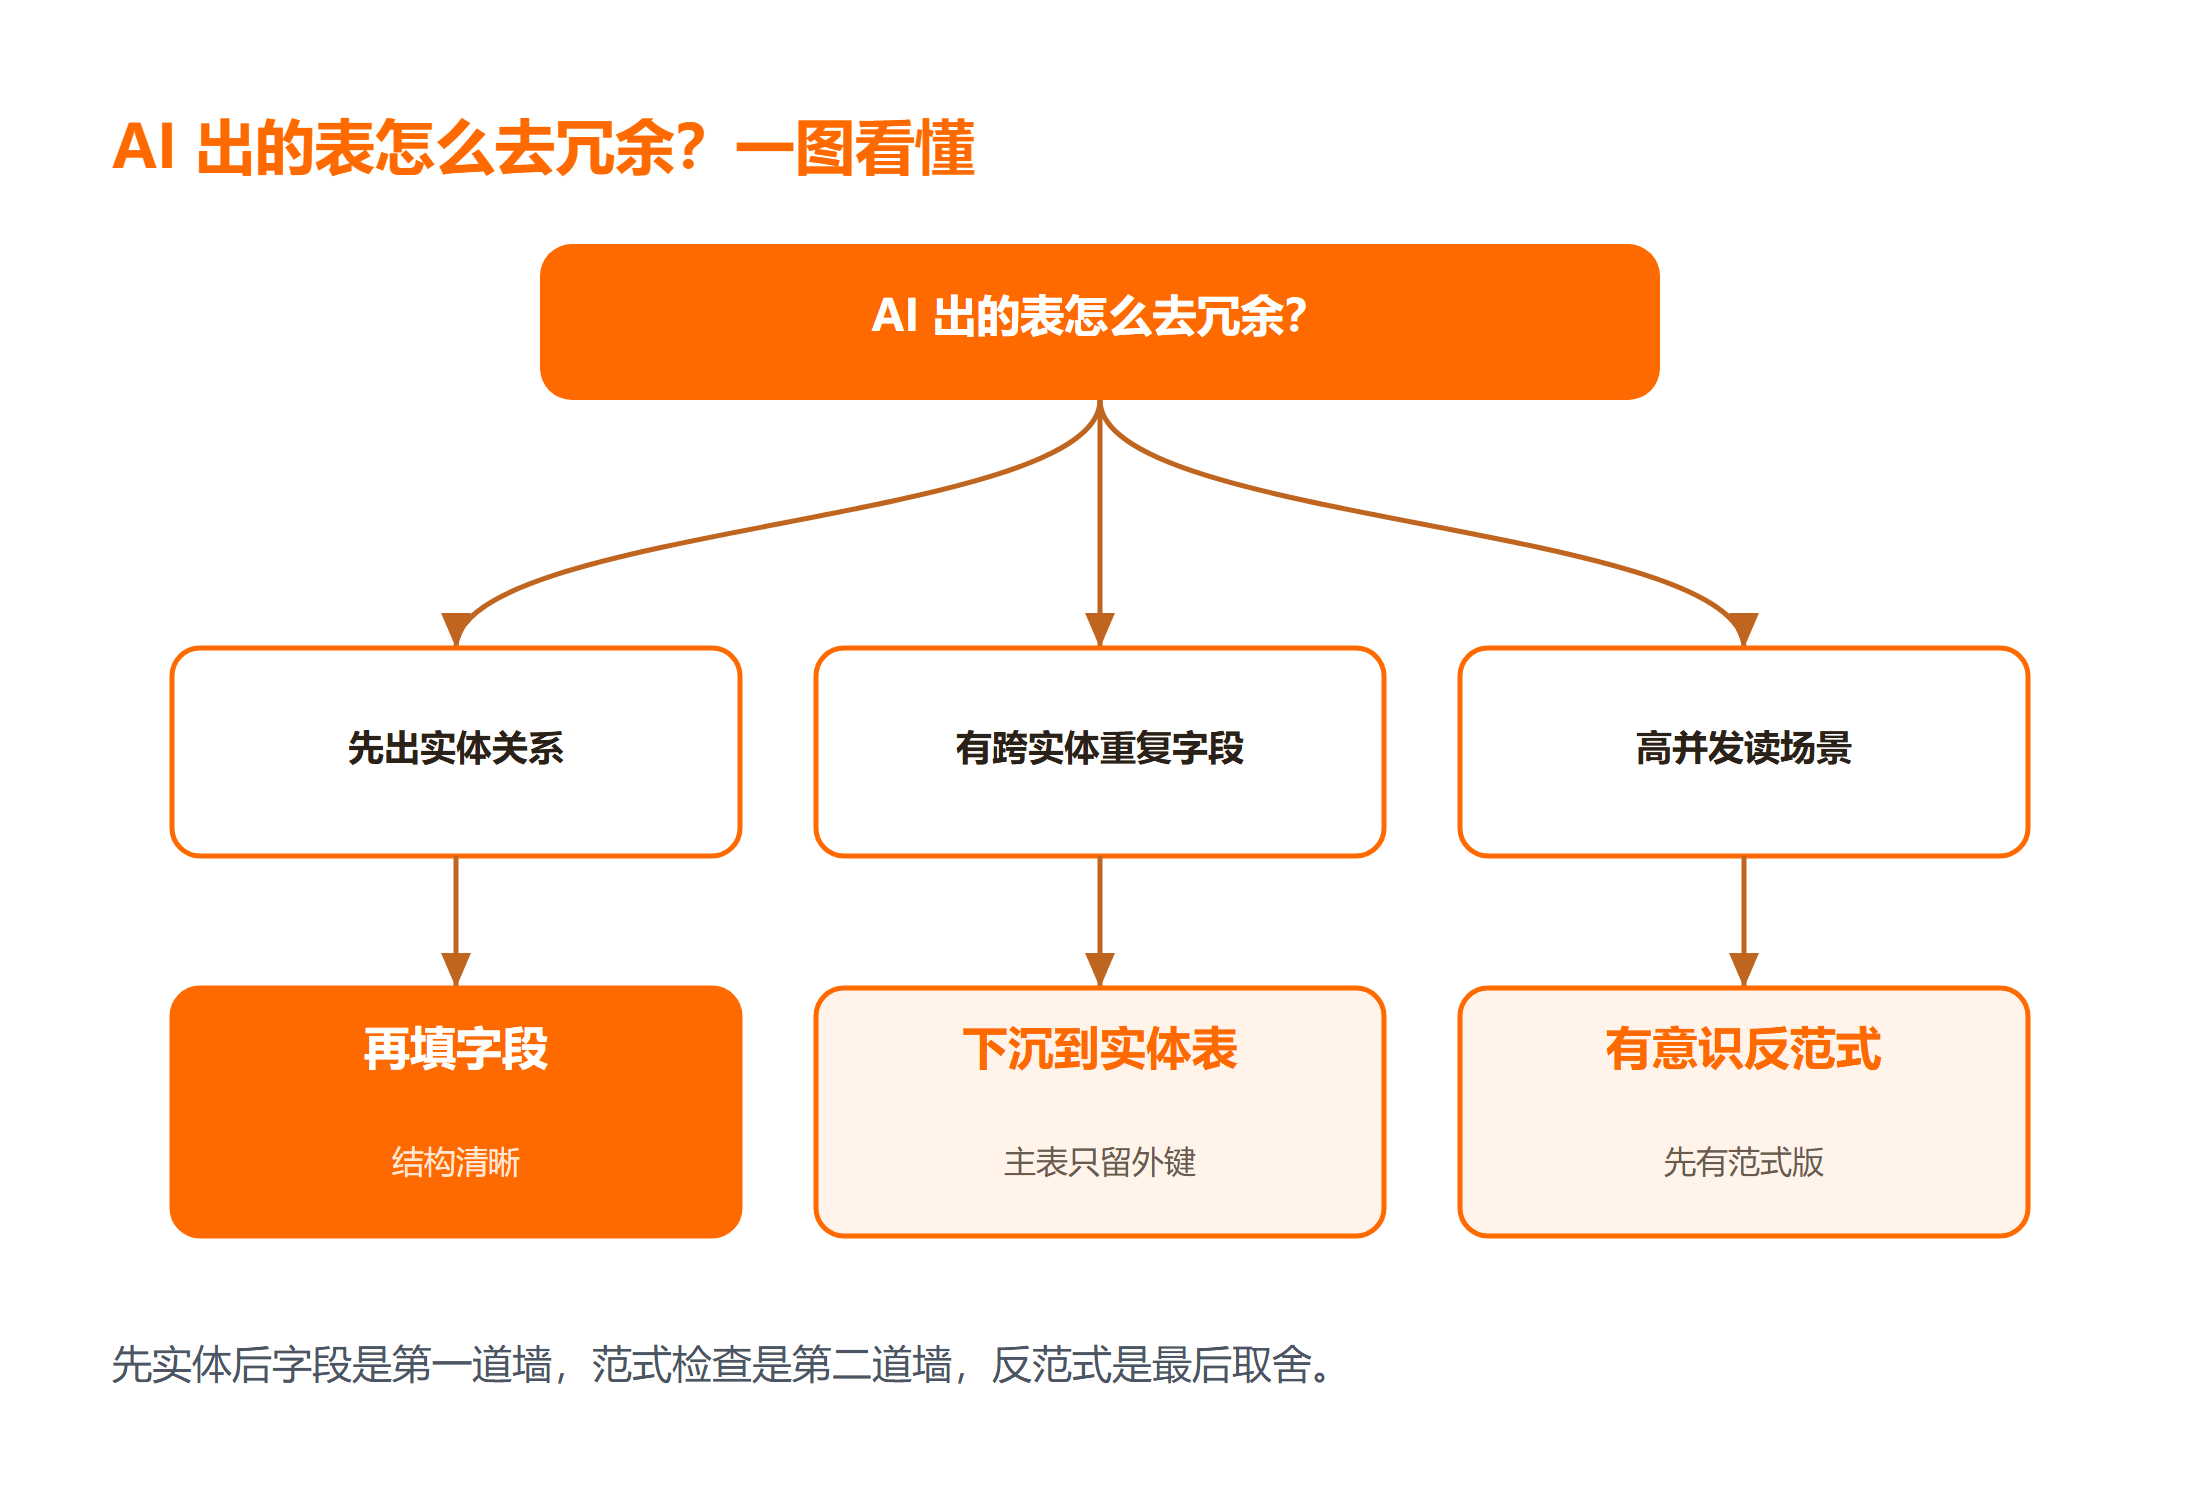
把三类做法摆在一起看,选择很清楚:
| 做法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 先实体后字段 | 新表设计 | 结构清晰 | 多一轮对话 |
| 第三范式检查 | 已有表整改 | 精准去冗余 | 要理解依赖 |
| 反范式缓存 | 高并发读 | 查询快 | 需维护同步 |
五、踩坑清单
把读者最容易卡住的三个点列出来:
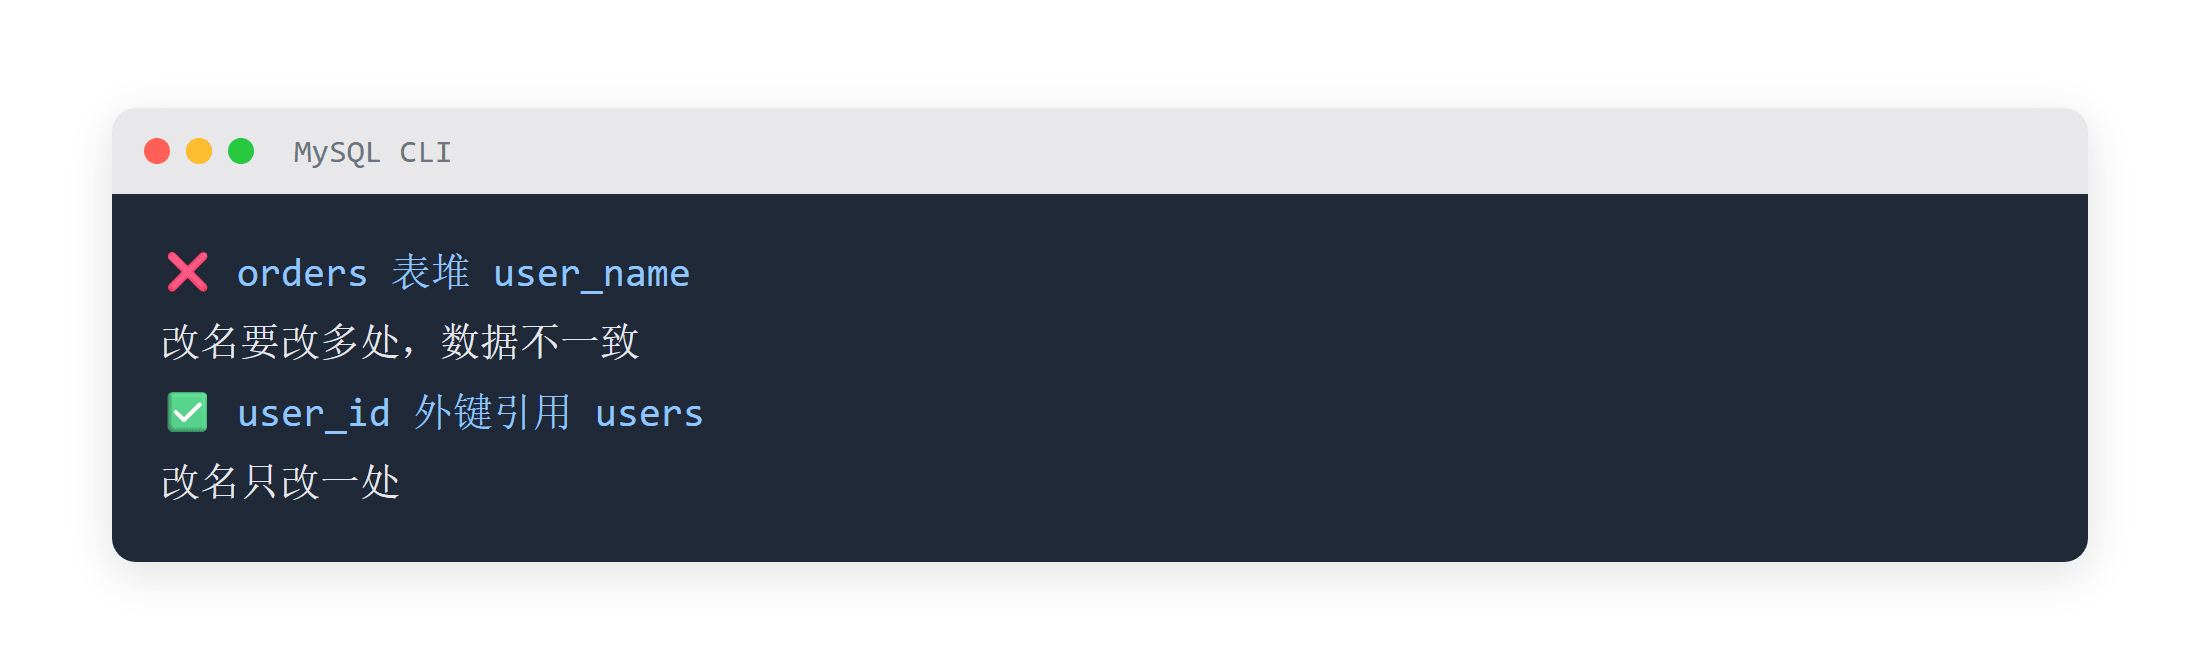
- 近义字段各开一列:现象是 user_name、buyer_name 共存。原因是没先分实体。解决办法是先建实体关系再填字段。
- 把可变信息堆在主表:现象是改名要改多处。解决办法是用外键引用,冗余字段下沉。
- 忽略字段数量上限:现象是单表字段爆炸,查询变慢、维护困难。解决办法是先对照 MySQL 单表字段数量的合理上限,把过宽的表拆成多张,而不是硬塞进一列。具体的设计异常排查可看 TRAE 问题排查 的章节,里面列了常见的建表报错与含义。
总结
AI 辅助数据库设计不可怕,可怕的是字段只增不减。先建实体关系、按第三范式收敛、再谈必要的反范式,三件事叠起来,你就能快速出表又不留冗余。要点带走:先实体后字段是第一道墙;范式检查是第二道墙;反范式是最后的有意识取舍。下一步,去把你项目里字段最乱的那张表,按今天的三步做一次收敛。
延伸学习
想把数据库设计这块系统补齐,可以按这个顺序来:
- 先过一遍 TRAE AI 开发 Django 课程,把 AI 开发流程练熟;
- 设计前确认字段边界,参考 MySQL 字段数量限制 的最佳实践;
- 画表关系图时,Mermaid 流程图 能直接帮你出图。
常见问题
Q:AI 出的表能直接建库吗?
A:不建议直接建。先让它只出实体关系,确认划分合理后再出字段,最后用范式逐项收敛。AI 倾向把名词都变成列,直接建库很容易留下冗余字段和同步隐患。
Q:反范式是不是一定不好?
A:不是。高并发读场景下,适当冗余能减少连表、提升查询速度。但前提是你先有一份范式正确的版本,再基于性能和读路径做有意识的反范式,而不是一开始就把冗余当默认。
Q:已有表怎么低成本去冗余?
A:先做第三范式检查,把传递依赖的字段逐条点名并下沉到所属实体,主表只留外键。改动前用最小例子验证更新异常是否消失,再逐步迁移历史数据。



