
 TRAE-AI编程

做后端去重,先看清数据规模、一致性要求和部署形态,再在内存集合、数据库唯一约束、Redis 集合、布隆过滤器四类方案里选型。后端服务在处理日志、消息、爬虫结果或订单时几乎都会遇到重复数据,选错方案会要么撑不住并发,要么把正常数据误删。属于同一份数据被多次写入,是这类问题最典型的表现。理解每种方案的边界,比记住写法更重要,因为绝大多数线上故障不是不会写,而是用错了场景。本文先给结论,再按场景拆解三种最常见的坑,帮你按业务挑对去重方案。
先看结论
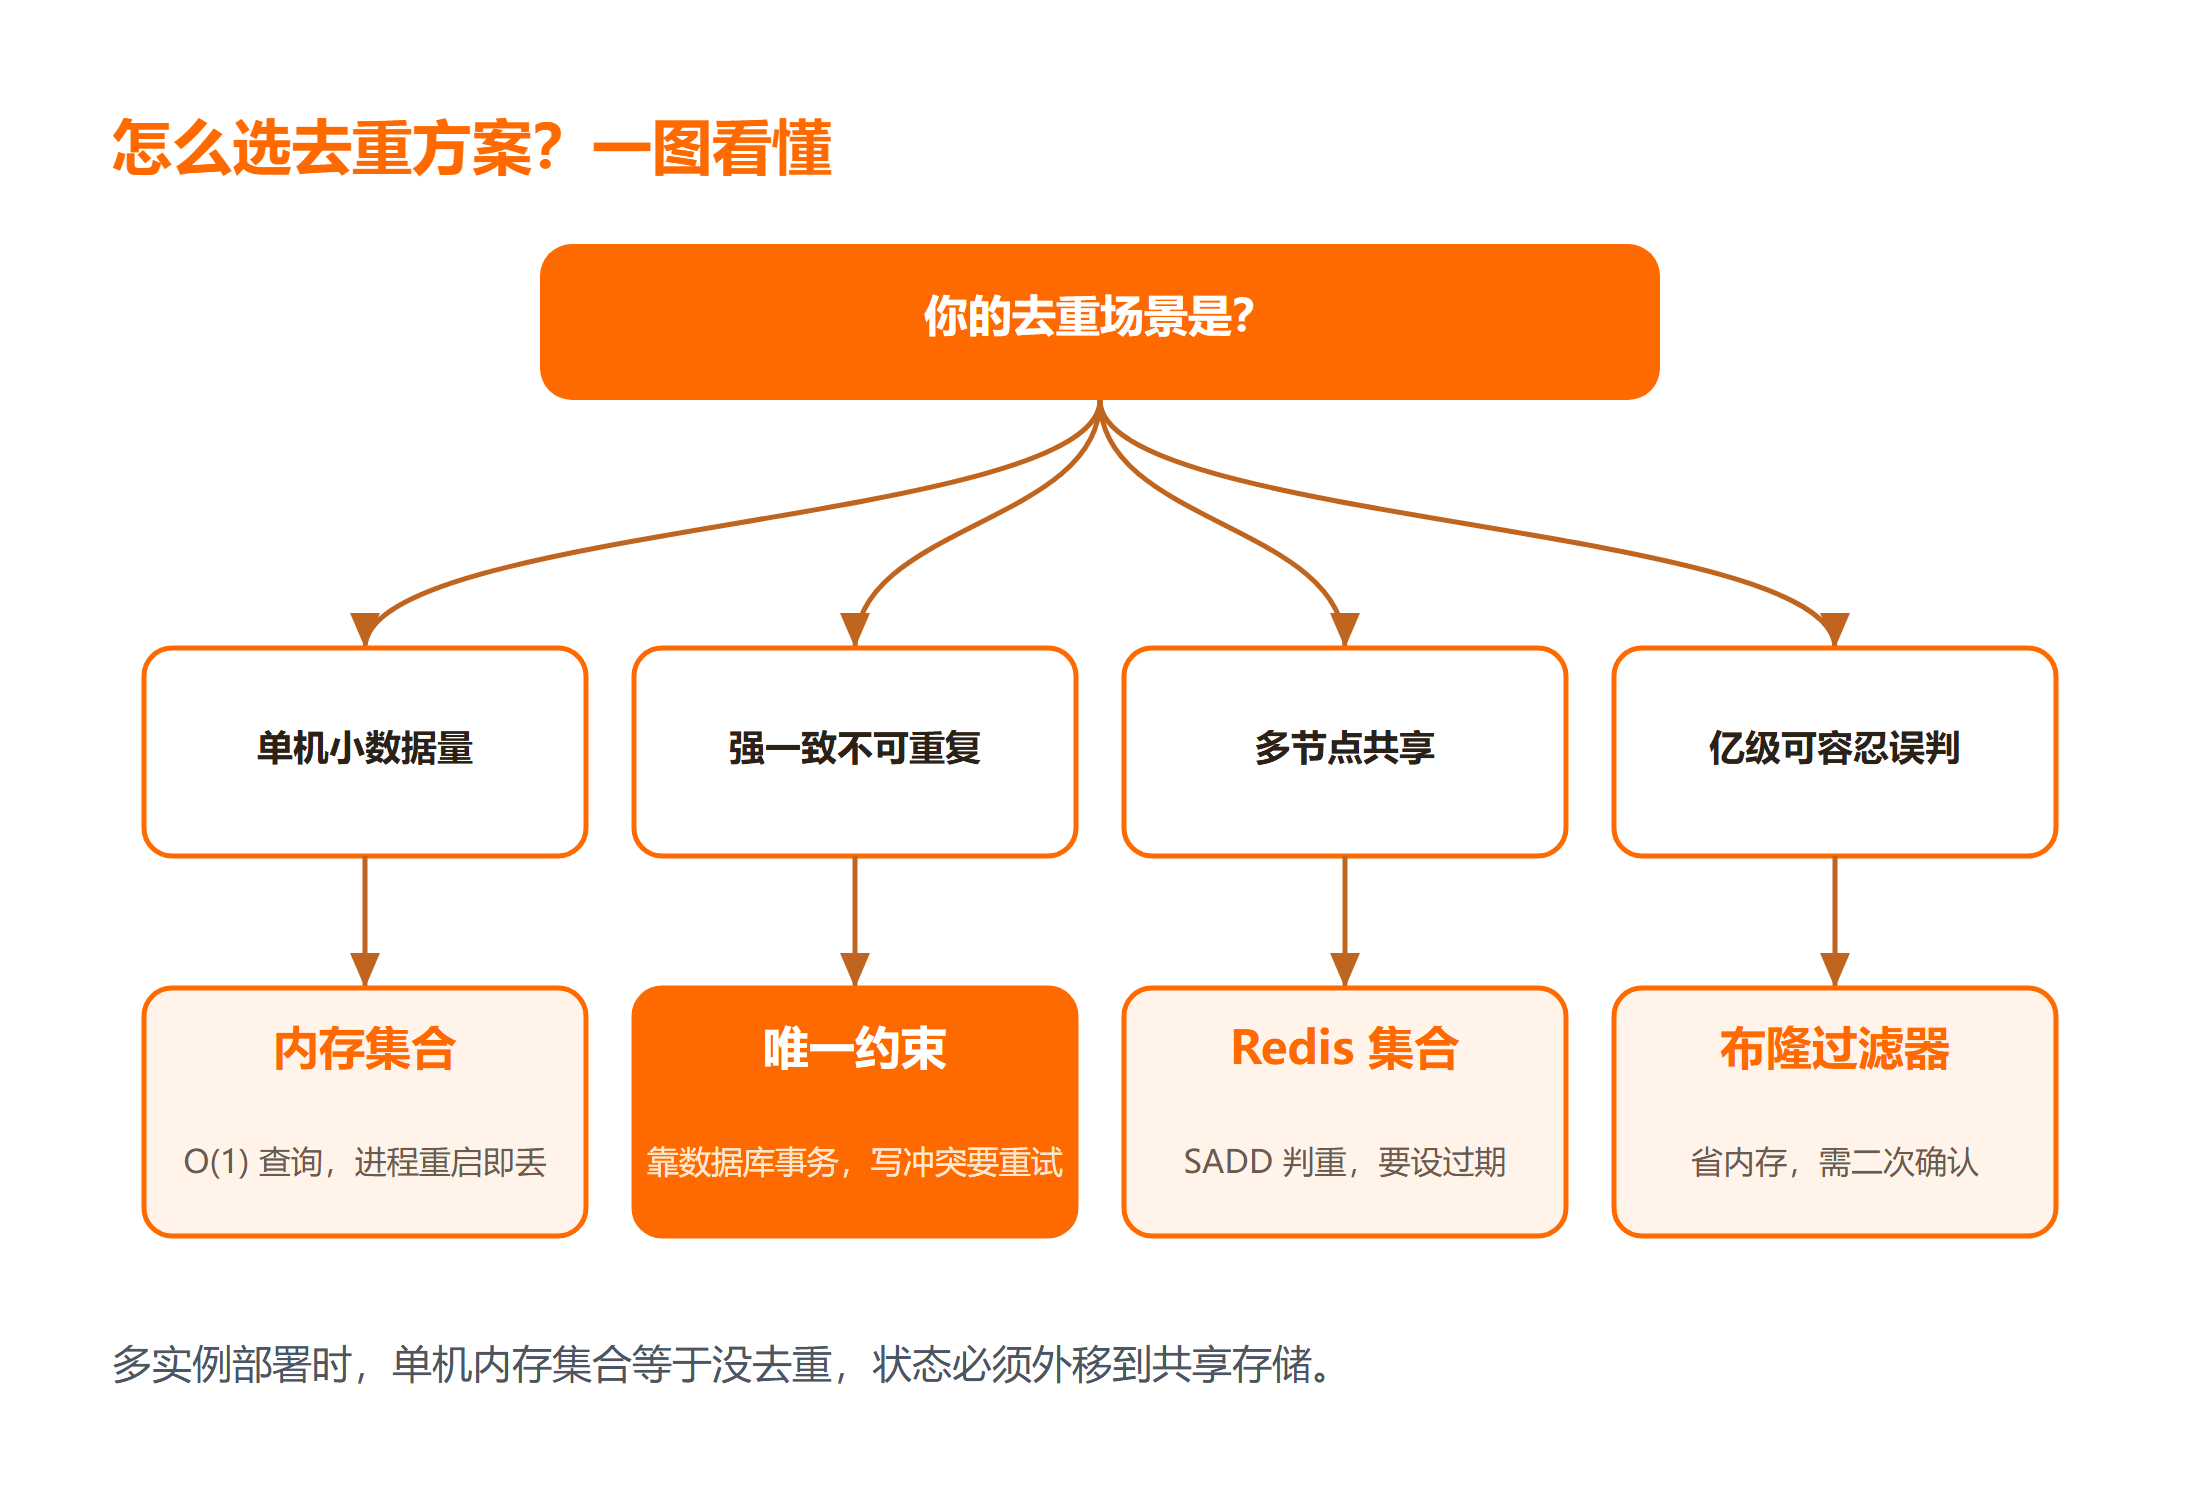
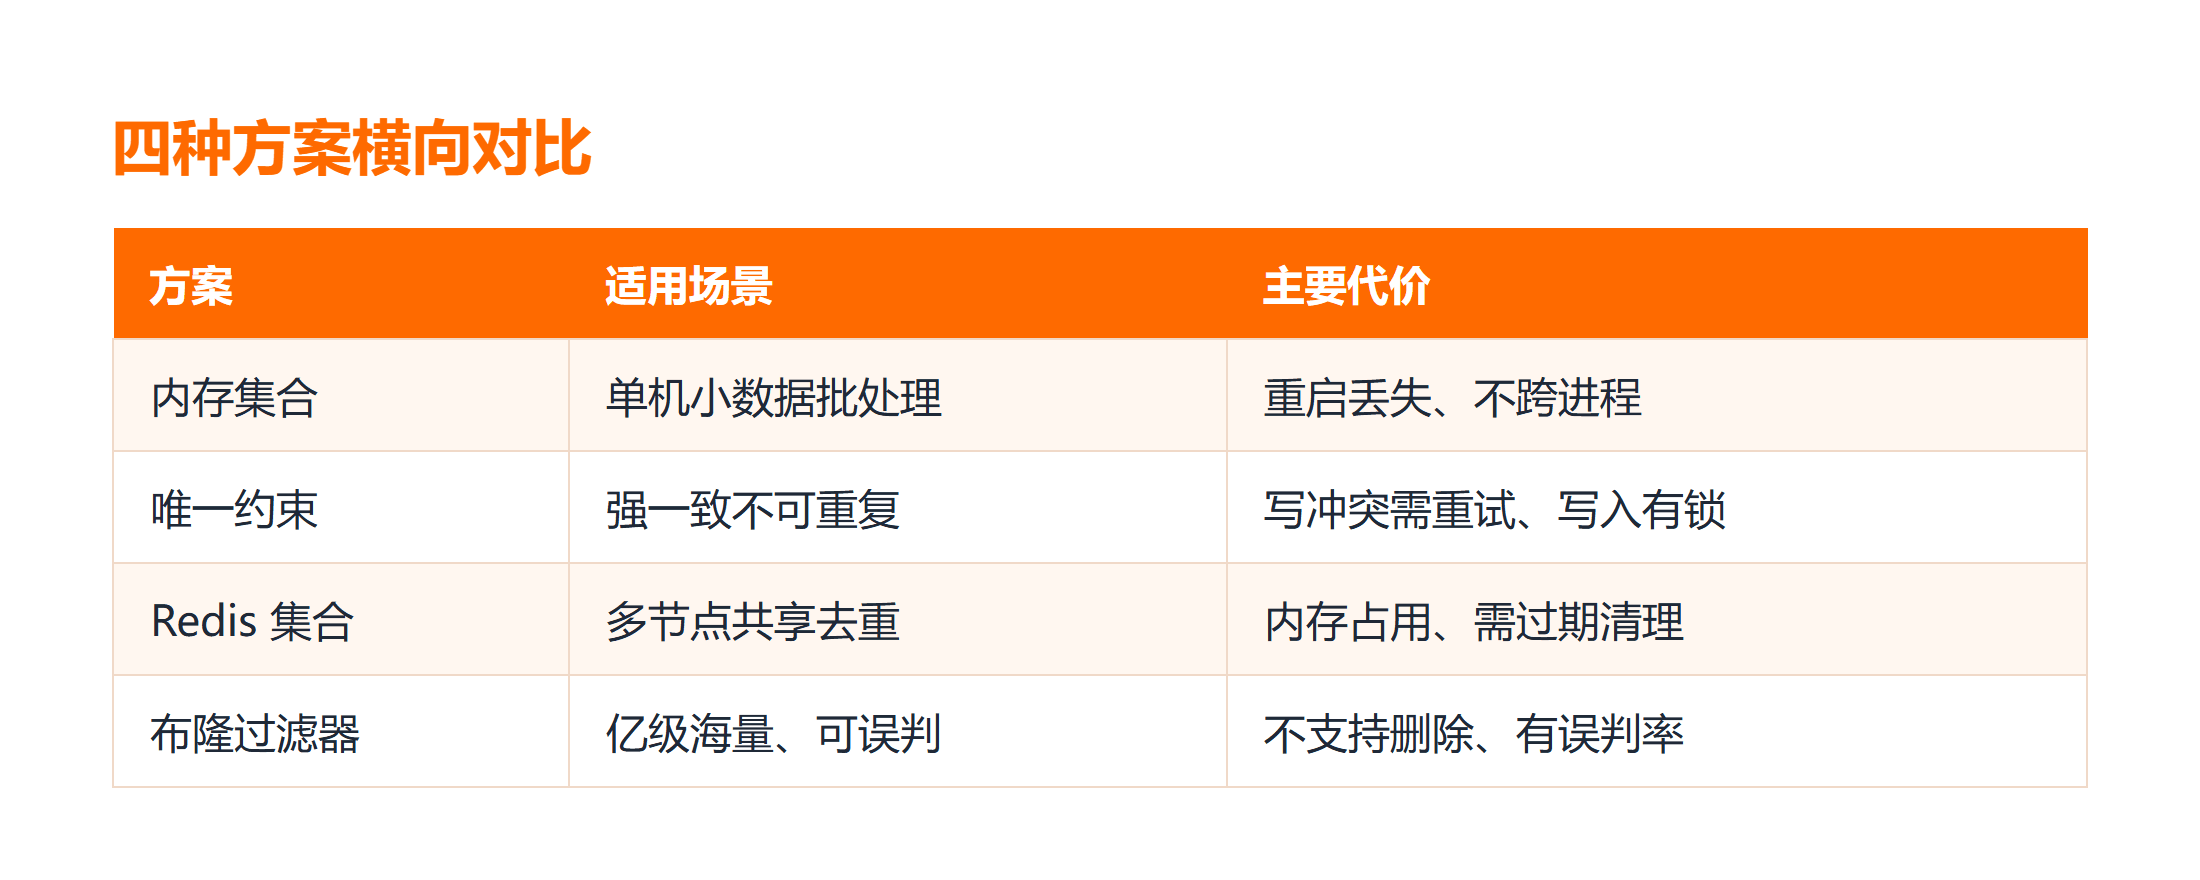
去重没有银弹,选型先看三个维度:数据量(单机几千条还是亿级)、一致性(允许重复漏判吗)、部署(单进程还是多节点)。对应的四类去重方案是:内存集合适合单机小数据;数据库唯一约束适合强一致、不怕写冲突重试;Redis 集合适合多节点共享去重;布隆过滤器适合海量且能接受极小误判的场景。下面三个坑分别对应"分布式误用单机方案""唯一约束没接住并发""误删正常数据",是新手最高频的失误。选错去重方案会要么撑不住并发,要么把正常数据误删。
一、内存集合:只适合单机小数据量
最朴素的做法是把见过的元素放进一个 HashSet,每来一条数据先判断是否在集合里。它的优势是 O(1) 查询、代码最少,缺点是数据只活在单个进程的内存里,进程重启就丢,多节点部署时各节点各算各的,等于没去重。想系统了解 Java 这门后端主力语言,可以看 Java 后端开发。
import java.util.HashSet;
import java.util.Set;

public class DedupDemo {
    private static final Set<String> seen = new HashSet<>();

    public static boolean isNew(String item) {
        // 返回 true 表示第一次见到,false 表示已存在
        return seen.add(item);
    }

    public static void main(String[] args) {
        System.out.println(isNew("order-1001")); // true
        System.out.println(isNew("order-1001")); // false
    }
}
这段代码在单进程批处理里完全够用,例如一次性清洗一份几万行的本地文件,或者单元测试里保证夹具不重复。但如果你把它写进一个多实例部署的接口,节点 A 和节点 B 各自维护集合,同一条数据会同时被两个节点判定为"新",去重彻底失效。判断是不是该用内存集合,只需要问一句:这份去重状态需要跨进程共享吗?需要就跳过这一节。另外内存集合会把全部去重键驻留堆内存,数据量大到百万级时 GC 压力和内存占用都会明显上升,这也是它被淘汰的常见原因。
二、数据库唯一约束:强一致但怕并发冲突
当去重要求"绝对不能重复"(比如用户邮箱、订单号),最稳的数据库去重方案是直接建唯一索引。数据库会用锁和事务保证两条相同记录无法同时落库,比任何应用层方案都可靠。代价是写入冲突时要捕获异常并重试,而不是简单忽略。更多查询与索引语法可参考 SQL 查询语法。
-- 给订单号加唯一约束,重复插入会直接报错
ALTER TABLE orders ADD UNIQUE KEY uk_order_no (order_no);

-- 冲突时转成"已存在"语义,而不是抛错中断业务
INSERT INTO orders (order_no, amount)
VALUES ('order-1001', 99)
ON DUPLICATE KEY UPDATE amount = VALUES(amount);
这里最大的坑是:很多团队只写了 INSERT,没处理唯一键冲突,于是高并发下大量请求因为违反约束而抛异常,接口成功率掉到很低。正确做法是把冲突当成正常分支——用 ON DUPLICATE KEY UPDATE 或在代码里捕获 DuplicateKeyException 后走"已存在"逻辑。唯一约束解决的是"一致性",不是"性能":它能保证不重复,但每次写入都要走索引检查,超高写入量下会成为瓶颈,那时就要考虑把热键下沉到 Redis 做前置拦截。运行上面的 INSERT 时如果违反唯一键,修复方式是捕获重复键异常后走"已存在"分支,而不是让接口抛错;用命令查看表的索引也能提前确认约束是否真的建上。
三、Redis 集合与布隆过滤器:分布式与海量场景
多节点共享去重,最常用的是 Redis 的 SET 结构,用 SADD 的返回值判断元素是否首次出现,所有节点访问同一个 Redis,状态自然统一。Redis 去重方案适合千万级数据,缺点是集合会一直占用内存,需要给 key 设过期时间或定期清理。关于缓存与集合的更多用法见 Redis 缓存方案。
# 返回 1 表示第一次加入(新数据),返回 0 表示已存在(重复)
SADD dedup:orders order-1001
# 给去重集合加 7 天过期,避免无限膨胀
EXPIRE dedup:orders 604800
当数据量到亿级、且能接受"极小概率把正常数据判为重"时,布隆过滤器更省内存:它用一组哈希位图回答"一定没见过"或"可能见过"。注意它不支持删除,且存在误判——所以常见做法是布隆过滤器做第一道粗筛,命中后再用 Redis 集合或数据库精确确认。布隆过滤器本身也有容量与误判率的权衡:预估元素越多、要求的误判率越低,需要的位数组就越大,初始化时要按业务峰值留余量,别等上线后才发现误判率超标。
总结
去重方案的本质是"在内存、一致性、容量之间做取舍"。单机小数据用内存集合最省事;要强一致就上数据库唯一约束并处理好并发冲突;多节点共享选 Redis 集合;亿级且能容忍误判用布隆过滤器。三个坑——把内存集合当分布式去重、唯一约束不接冲突分支、误删正常数据——占掉了新手八成的返工时间。
落地时可以用一张速查清单自查:第一,数据规模有没有超过百万且需要常驻内存;第二,多实例部署时去重状态是否外移到了共享存储;第三,唯一约束的写入是否真的接住了冲突分支;第四,用到布隆过滤器时是否保留了二次精确确认。四个问题都回答清楚,方案基本不会跑偏。动手前先回答规模、一致性、部署这三问,选型就不会偏,再结合本文给的代码片段落地,就能避开大多数去重事故。配置去重方案前,先用测试环境造一条重复数据验证是否真的生效,比上线后靠客诉发现更省心。
常见问题
Q:为什么我的内存去重在服务器上就失效了?
多半是因为服务部署了多个实例,每个实例各维护一个 HashSet,彼此看不到对方的状态。把去重状态外移到 Redis 或数据库,就能让所有实例共享同一份判重结果。
Q:布隆过滤器误判会不会把正常数据删掉?
单纯的布隆过滤器只能告诉你"一定没见过"或"可能见过",不能直接用于删除。正确姿势是它做粗筛,真正删除或拦截前再用精确结构(Redis 集合、唯一约束)二次确认,避免误删。
Q:唯一约束冲突了该怎么写才不报错?
用 ON DUPLICATE KEY UPDATE(MySQL)或在代码里捕获重复键异常后走"已存在"分支,把冲突当作正常业务结果,而不是让接口抛错。



