 TRAE-AI编程

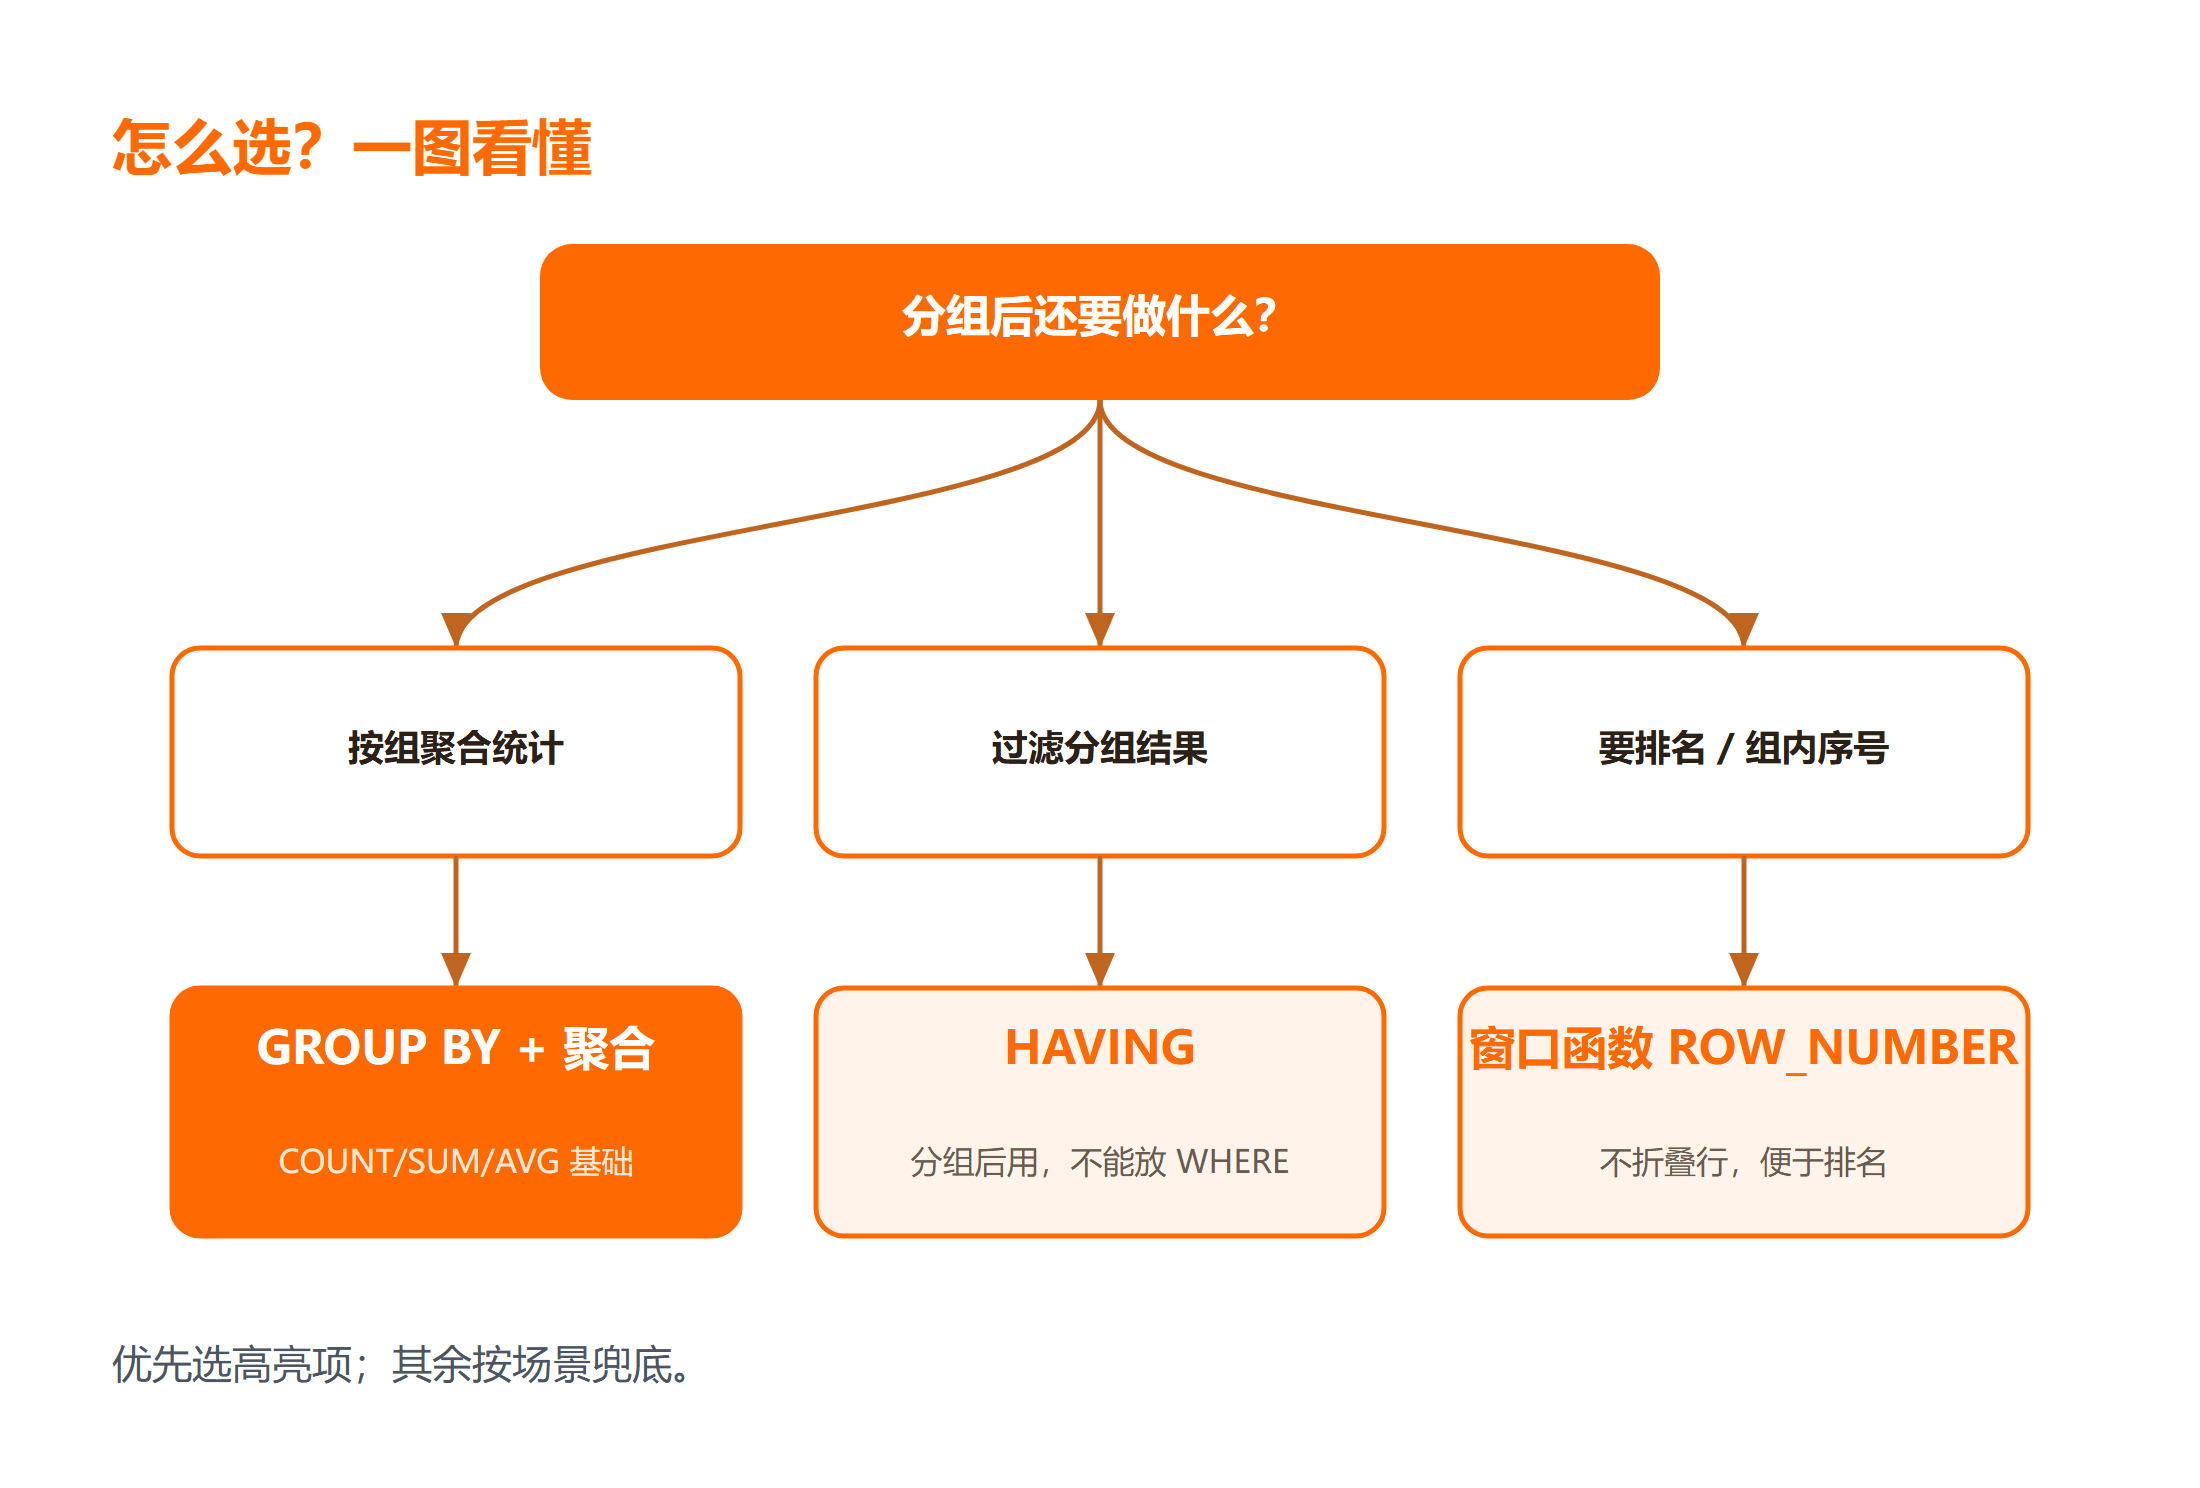
做 MySQL 统计分组时,先记住三句话:单表聚合用 GROUP BY + 聚合函数;先分组再筛选用 HAVING;需要分组内排名用窗口函数 ROW_NUMBER。这三条分别对应“算总数”“筛掉整组”“组内排序”三种最常见需求,选错方式往往不是立刻语法报错,而是结果悄悄不对。本文用同一张订单表贯穿三种实现,把输入输出、执行顺序和最常见的几个误区一次讲清,让你写完就能直接用,也能在报错时快速定位。无论你是刚接触 SQL 的新手,还是正在准备面试的开发者,只要把这三种方式吃透,绝大多数 mysql统计分组 需求都能稳稳拿下,不必再四处拼凑零散的代码片段。
一、先看结论:MySQL 统计分组怎么选
下面这张方法选择表,建议先截图保存,它是全文的导航。当你拿到一个分组需求,先对照“适用场景”和“不推荐场景”做判断,再按“推荐顺序”落地。
| 方式 | 适用场景 | 不推荐场景 | 推荐顺序 |
|---|---|---|---|
| GROUP BY + 聚合函数 | 按某列分组后算总数、求和、平均值等汇总指标 | 需要对分组内的每一行单独排名、取明细 | 1(最常用,首选) |
| HAVING 过滤分组 | 分组后按聚合结果过滤,例如只保留订单数大于 5 的用户 | 在分组前就能用 WHERE 过滤的普通条件 | 2(紧接 GROUP BY 之后) |
| 窗口函数 ROW_NUMBER | 需要在每个分组内部做排名、取 Top N、累计求和 | MySQL 5.6 及更早版本;简单汇总不需要排名 | 3(组内精细分析时使用) |
mysql统计分组 的本质,是把“按维度切片”和“对切片做计算”两件事组合起来。第一组方式负责切片加汇总,第二组方式负责结果再过滤,第三组方式则在不破坏原行的前提下给出组内序号。很多人写错,是因为没想清楚自己到底要“汇总后的少数几行”,还是要“明细行再加上组内序号”——这两件事对应的写法完全不同。
选型的判断顺序也很直接:先问“我要不要分组后过滤”,再问“我要不要组内排名”。如果两者都不需要,单纯聚合就足够;如果既要聚合又要排名,窗口函数通常比嵌套子查询更清晰、更易维护。编程狮在相关教程里也反复强调,理解执行顺序是避开误区的前提,这一点会在第三、四节展开说明。
最后提醒一句:这三种方式不是互斥的,真实业务里经常组合出现,比如先用 WHERE 过滤、再 GROUP BY 聚合、再用 HAVING 过滤分组,最后在外层用窗口函数排名。把基础打牢,组合就水到渠成。
二、环境与最小示例
我们建一张订单表作为全文唯一示例数据源。它足够简单,又能覆盖“按用户分组”“按状态过滤”“按金额汇总”等典型场景。下面代码逐行都有中文注释。
-- 创建一张订单表,用于贯穿全文示例
CREATE TABLE `orders` (
  `id`         INT            NOT NULL AUTO_INCREMENT, -- 订单主键,自增
  `user_id`    INT            NOT NULL,                -- 用户编号,作为分组维度
  `amount`     DECIMAL(10,2)  NOT NULL,                -- 订单金额,用于求和与平均
  `status`     VARCHAR(20)    NOT NULL,                -- 订单状态,用于条件过滤
  `created_at` DATE           NOT NULL,                -- 下单日期,用于按天分组
  PRIMARY KEY (`id`)                                   -- 主键约束
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;              -- 使用 InnoDB 与 utf8mb4 字符集

-- 插入几条示例数据,覆盖多用户与多状态
INSERT INTO `orders` (`user_id`, `amount`, `status`, `created_at`) VALUES
  (1, 100.00, \\\'paid\\\',     \\\'2026-09-01\\\'), -- 用户1 已支付
  (1, 200.00, \\\'paid\\\',     \\\'2026-09-02\\\'), -- 用户1 已支付
  (2, 150.00, \\\'refunded\\\', \\\'2026-09-01\\\'), -- 用户2 已退款
  (2,  50.00, \\\'paid\\\',     \\\'2026-09-03\\\'), -- 用户2 已支付
  (3, 300.00, \\\'paid\\\',     \\\'2026-09-02\\\'); -- 用户3 已支付

-- 最简 GROUP BY:按用户聚合,统计每个用户的订单数
SELECT
  `user_id`,            -- 分组维度列,必须出现在 GROUP BY 中
  COUNT(*) AS `cnt`     -- 聚合函数,统计每组的行数
FROM `orders`
GROUP BY `user_id`;     -- 按用户编号分组,相同 user_id 合并成一组
(以下为说明性代码,未在本机执行;预期结果:返回 3 行,user_id 分别为 1、2、3,cnt 分别为 2、2、1。)
这张最小示例表就是后面所有演化的起点。理解它,你就理解了 MySQL 分组统计 的全部骨架:一张表、一个分组维度、一个聚合指标。后续所有复杂度,都是在这副骨架上叠加过滤、排名与多维度。建议你在本地把这张表真正建出来跑一遍,比只读文字印象深得多。在本地数据库运行这些建表语句,检查输出行数是否符合预期,配置好字符集后再做聚合练习,验证统计口径是否对齐。
三、方式一:GROUP BY + 聚合函数
这是 mysql统计分组 的第一板斧,也是使用频率最高的一招。核心语法是“GROUP BY 维度列 + 聚合函数”。下面演示如何同时统计每个用户的订单数、总金额与平均金额。
-- 同时统计每个用户的订单数、总金额、平均金额
SELECT
  `user_id`,                  -- 分组列,必须出现在 GROUP BY 中
  COUNT(*)        AS `cnt`,   -- 统计每组行数,包含 NULL 行
  SUM(`amount`)   AS `total`, -- 对金额求和,自动忽略 NULL 值
  AVG(`amount`)   AS `avg_amt`-- 对金额求平均,自动忽略 NULL 值
FROM `orders`
GROUP BY `user_id`;           -- 按用户分组,每组产出一行汇总

-- 常见错误:SELECT 中出现了既不在 GROUP BY 也不在聚合函数的列
SELECT
  `user_id`,
  `status`,                   -- 错误:status 既未分组也未聚合
  COUNT(*) AS `cnt`
FROM `orders`
GROUP BY `user_id`;           -- 在开启 ONLY_FULL_GROUP_BY 时会直接报错
(以下为说明性代码,未在本机执行;预期结果:第一段返回 3 行汇总;第二段在默认开启 ONLY_FULL_GROUP_BY 的 MySQL 5.7+ 中报错。)
COUNT、SUM、AVG 是最常用的三个聚合函数。COUNT(*) 统计组内所有行,COUNT(列) 只统计该列非 NULL 的行;SUM 与 AVG 都会自动跳过 NULL,但要注意 AVG 是“非空值之和除以非空值个数”,而不是除以总行数,这点在金额为 NULL 时会让均值偏高,统计口径要提前和业务方对齐。
最关键的限制是 SELECT 非聚合列问题。在开启 ONLY_FULL_GROUP_BY(MySQL 5.7 起默认开启)时,SELECT 后面只能出现 GROUP BY 中的列,或者被聚合函数包裹的列。原因很直观:分组后一组可能对应多行,数据库无法确定该取哪一行的值来展示。想要保留某个非分组列,正确做法是用 MAX()/MIN() 等聚合函数包裹,或改用下一节要讲的窗口函数。这也是 mysql统计分组 最容易踩的第一个坑。
聚合函数还能配合 DISTINCT 去重统计,例如 COUNT(DISTINCT user_id) 统计不重复用户数;SUM(DISTINCT amount) 则只对不重复金额求和。GROUP BY 也支持多列组合,例如 GROUP BY user_id, status 会按“用户 + 状态”两个维度切分,每组代表一个用户的一种状态。想系统练手可以看 MySQL 教程,里面从单列分组到多列分组、从聚合到过滤都有渐进式示例,跟着敲一遍会形成肌肉记忆。
四、方式二:HAVING 过滤分组
方式二解决的是“分组之后还要再筛一次”的需求。比如“只保留下单超过一次的用户的场景”,就必须用 HAVING,因为“下单次数”是聚合之后才存在的指标。
-- 只保留订单数大于 1 的用户,这是典型的分组后过滤
SELECT
  `user_id`,
  COUNT(*) AS `cnt`
FROM `orders`
GROUP BY `user_id`
HAVING COUNT(*) > 1;          -- 对分组后的聚合结果再过滤

-- 对比:WHERE 在分组前过滤,不能引用聚合结果
SELECT
  `user_id`,
  COUNT(*) AS `cnt`
FROM `orders`
WHERE `status` = \\\'paid\\\'       -- 分组前先过滤已支付订单
GROUP BY `user_id`
HAVING COUNT(*) > 1;          -- 再过滤下单不止一次的已支付用户
(以下为说明性代码,未在本机执行;预期结果:第一段返回 user_id 1、2(cnt 均为 2);第二段仅返回 user_id 1(只有 1 号有两笔 paid)。)
WHERE 与 HAVING 的根本区别在于执行时机。标准执行顺序是:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY。WHERE 在分组之前生效,因此不能使用聚合函数;HAVING 在分组之后生效,可以引用 COUNT()、SUM() 等聚合结果。把能用 WHERE 过滤的条件写在 WHERE 里,能先减少参与分组的行数,既语义正确又性能更好。
一个典型误区是把“分组前就能判断的条件”也写进 HAVING,例如 HAVING status = \\'paid\\'。虽然某些宽松模式下可能侥幸得到结果,但它在语义上绕过了分组前过滤,既慢又容易在严格模式下报错。正确姿势永远是:普通列条件放 WHERE,聚合结果条件放 HAVING。
HAVING 子句里也可以同时出现多个条件,用 AND / OR 连接,例如 HAVING SUM(amount) > 100 AND COUNT(*) >= 2。需要快速查阅语法细节时,可以参考 MySQL 速查手册 里的分组统计条目,对照练习能少走很多弯路。和第三节一样,HAVING 也能配合多列 GROUP BY 一起使用,过滤维度越细,分组统计的颗粒度就越高。
五、方式三:窗口函数与常见误区
窗口函数是 mysql统计分组 的进阶形态。它最大的特点是“不改变行数”:在不折叠分组的前提下,为每一行计算“组内指标”,非常适合排名、累计、Top N 这类需求。下面用 ROW_NUMBER 给每个用户按金额降序排名。
-- 为每个用户按金额降序排名,输出每一行及其组内名次
SELECT
  `user_id`,
  `amount`,
  ROW_NUMBER() OVER (                   -- 窗口函数:组内行号
    PARTITION BY `user_id`              -- 按用户分组(窗口分区)
    ORDER BY `amount` DESC              -- 组内按金额降序
  ) AS `rn`
FROM `orders`;
(以下为说明性代码,未在本机执行;预期结果:用户 1 的两行分别得到 rn=1(200.00)与 rn=2(100.00)。)
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 报错 Expression #2 of SELECT list is not in GROUP BY | 开启了 ONLY_FULL_GROUP_BY,SELECT 列未聚合也未分组 | 把该列用聚合函数包裹,或移出 SELECT,或改用窗口函数 |
| HAVING 里引用普通列却返回空或报错 | 把本应放 WHERE 的列写进了 HAVING | 将普通列条件移到 WHERE,只留聚合条件在 HAVING |
| 分组后结果少了某些维度 | GROUP BY 漏写了组合维度列(如同时按用户和状态分组时只写了用户) | 补全所有需要的维度列到 GROUP BY |
| NULL 被并入同一组导致统计偏差 | 多个 NULL 在 GROUP BY 中被视为相等,合并成一组 | 先用 COALESCE 把 NULL 替换为占位值,再分组 |
| 窗口函数报错 FUNCTION ROW_NUMBER does not exist | 使用的是 MySQL 5.6 或更早版本,不支持窗口函数 | 升级到 MySQL 8.0,或用子查询加变量模拟排名 |
mysql统计分组 在进阶阶段最常遇到的就是上面这几类问题。窗口函数尤其要注意:它没有 GROUP BY 的“折叠”语义,PARTITION BY 只决定计算范围,原表的每一行都会保留。如果你期望结果只有一行一组,那应该用 GROUP BY 而不是窗口函数;反之,如果你既要明细又要组内序号,窗口函数就是最优解。
除了 ROW_NUMBER,常用的窗口函数还有 RANK()(并列同名次、名次跳跃)、DENSE_RANK()(并列同名次、名次不跳跃)、SUM() OVER(组内累计)等。它们都遵循“PARTITION BY 分区 + ORDER BY 排序”的框架,掌握一个就能举一反三。当排错表里的现象出现时,对照“常见原因”与“修复方向”基本都能快速收敛。
总结
mysql统计分组 的三板斧可以浓缩成一句话:聚合用 GROUP BY + 聚合函数,过滤整组用 HAVING,组内排名用窗口函数。实际写 SQL 时,先想清楚“我要的是汇总结果还是明细加序号”,再决定用哪一类。执行顺序(WHERE 先于 GROUP BY 先于 HAVING)是理解一切的关键,ONLY_FULL_GROUP_BY 的报错几乎都能从这张顺序图里找到原因。把本文的示例表在本地跑一遍,对照排错表逐项验证,你就能把 MySQL 分组统计 从“会写”提升到“写对、写得稳”。编程狮建议初学者在动手前先画一遍执行顺序,再落笔写代码,能显著降低返工率,也更容易在 Code Review 里一次通过。
延伸学习
- MySQL 入门课程 —— 从零到上手的分组统计实战视频。
- MySQL 表结构笔记 —— 笔记:快速查看与理解表字段,为分组选维度打基础。
- MySQL8 教程 —— 系统学习窗口函数与 8.0 新特性。
常见问题
Q:GROUP BY 之后 SELECT 只能写分组列吗?
是的,在开启 ONLY_FULL_GROUP_BY(MySQL 5.7+ 默认)时,SELECT 列表里的非聚合列必须出现在 GROUP BY 中,否则会直接报错。如果你确实需要保留某列,可以用 MAX()、MIN() 等聚合函数包裹,或者改用窗口函数,在不折叠行的前提下取出该列。理解这条限制,是写好 mysql统计分组 的第一步,也是排错表里第一类报错的根因。
Q:HAVING 和 WHERE 到底怎么分工?
按执行顺序记最稳:WHERE 在 GROUP BY 之前,用来过滤原始行,不能引用聚合结果;HAVING 在 GROUP BY 之后,用来过滤分组,可以引用 COUNT()、SUM() 等聚合结果。凡是分组前就能判断的普通条件都放 WHERE,既语义正确又能减少参与分组的行数、提升性能。需要按聚合指标二次筛选时,才轮到 HAVING 上场。
Q:为什么我的 NULL 值统计总是不对?
因为在 GROUP BY 中,所有 NULL 会被视为相等并合并进同一组,导致“未知维度”和“真实维度”混在一起,从而拉低或拉高汇总值。修复方法是先用 COALESCE(列, \\'未知\\') 把 NULL 替换成占位值再分组,或先用 WHERE 列 IS NOT NULL 过滤掉脏数据。这也是 MySQL 分组统计 中容易被忽略的一个细节,配合排错表第四行一起看会更清楚。