 免费 AI IDE

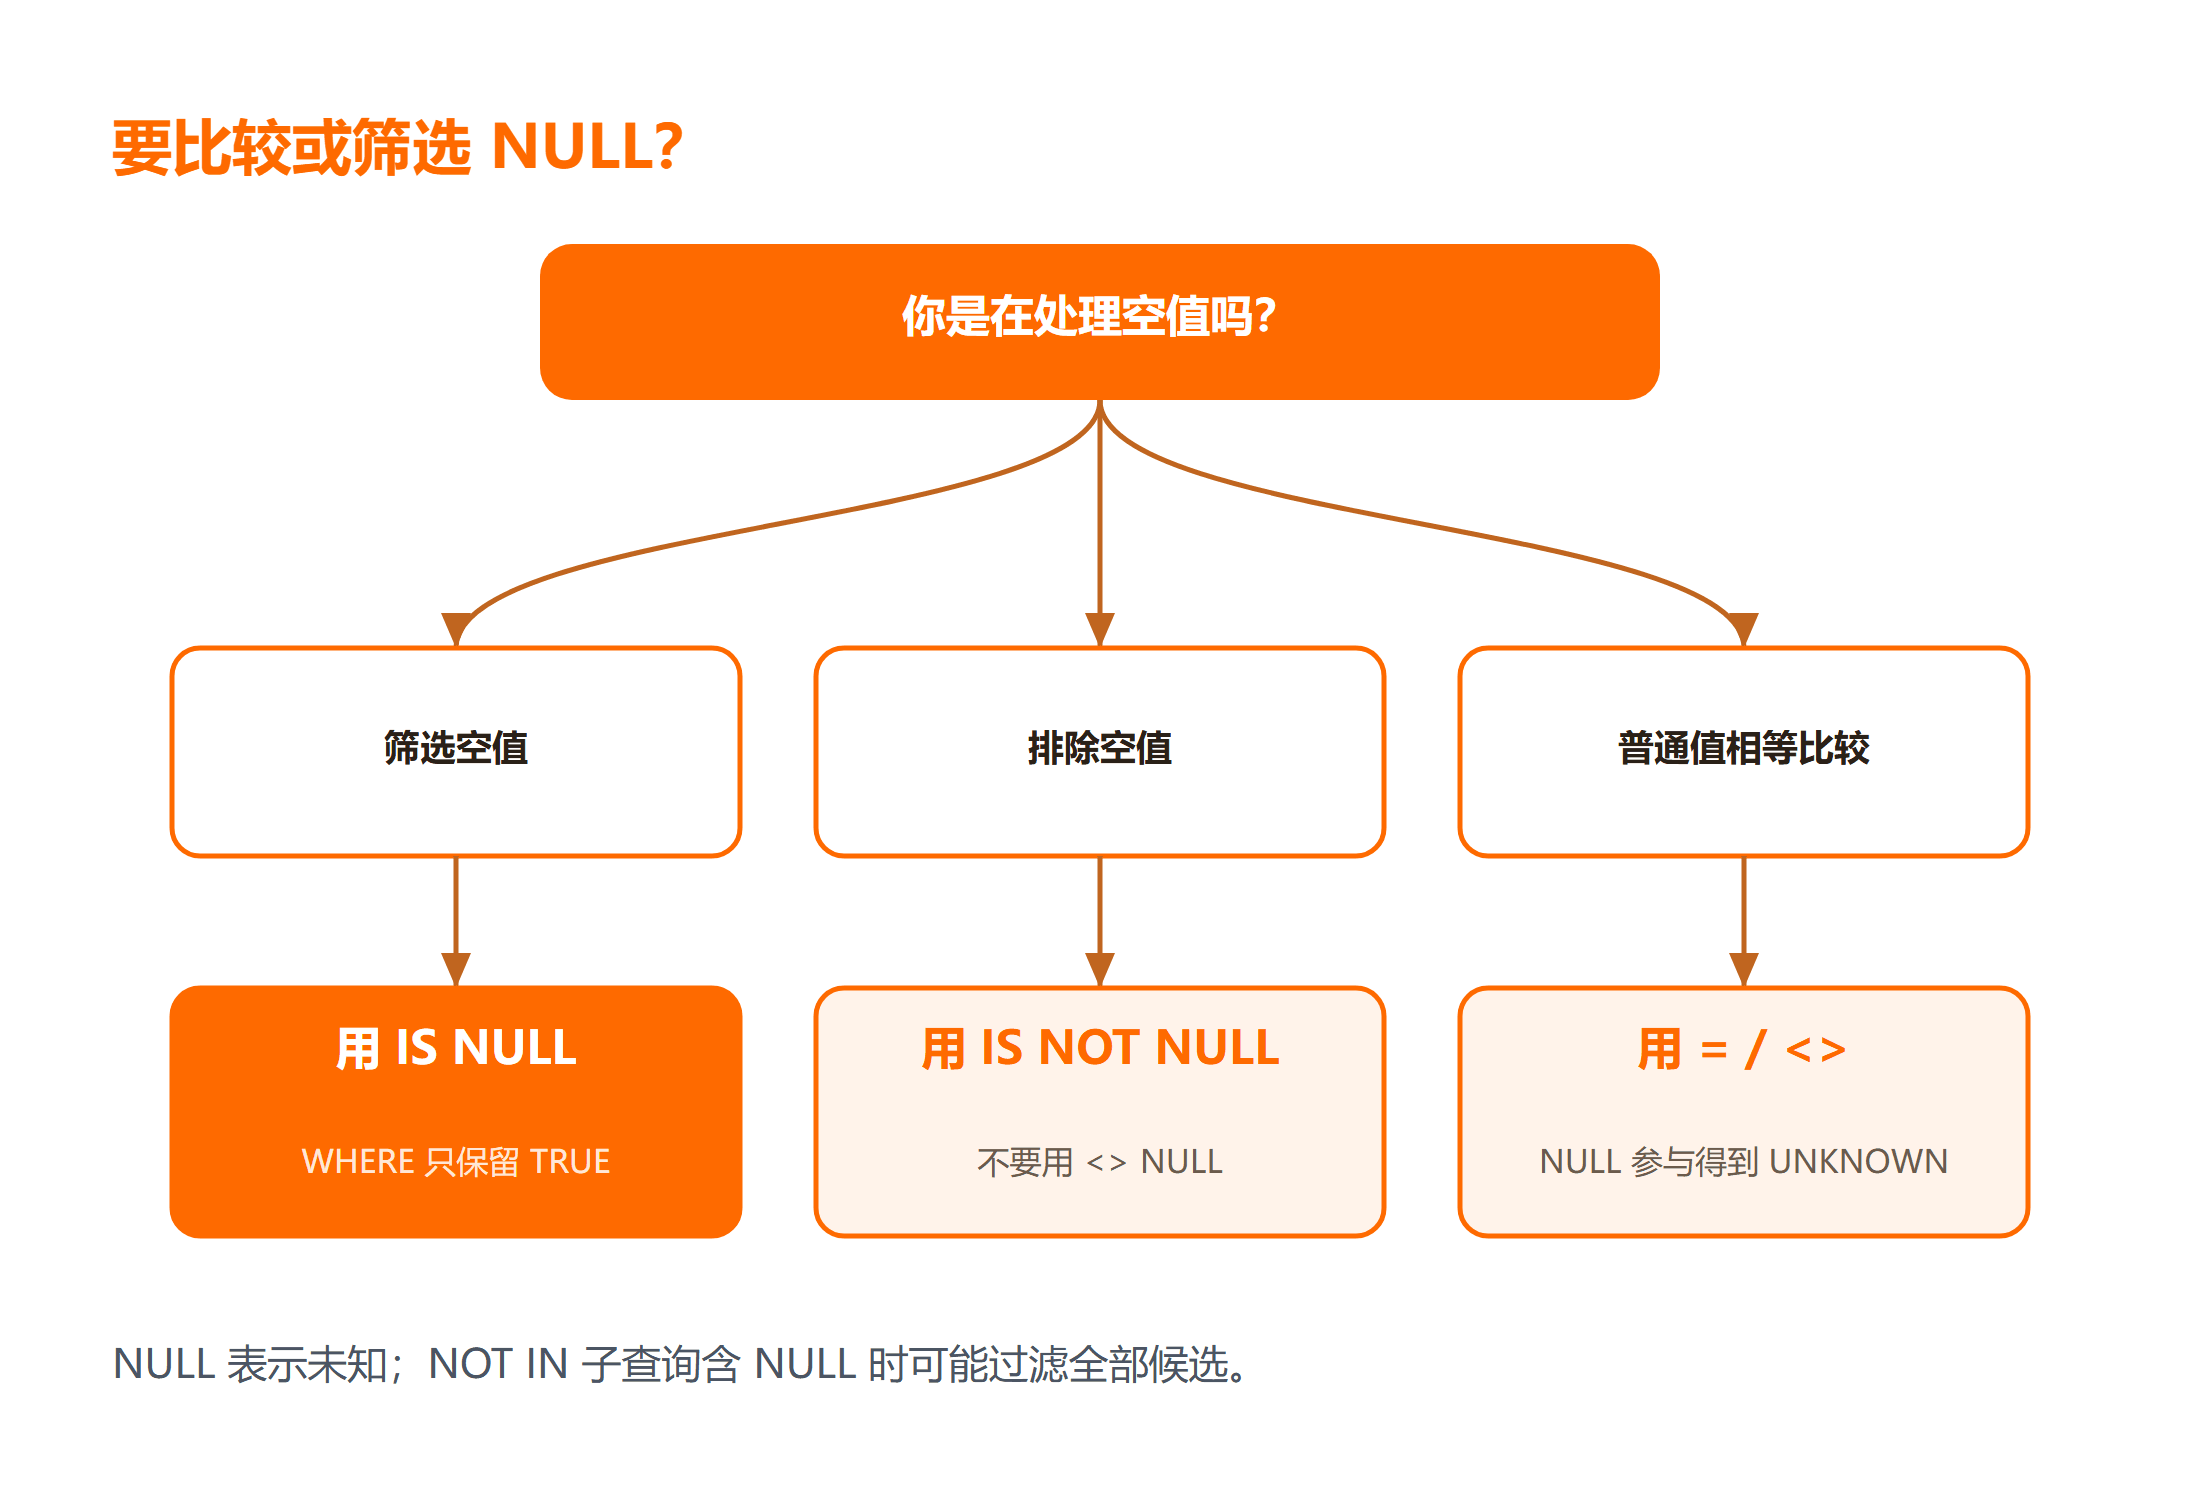
SQL 里的 NULL 表示“未知”,不是一个能与别的值直接比较的普通值。score = NULL 的结果不是 TRUE,而是 UNKNOWN;WHERE 只保留 TRUE,所以筛选空值必须写 score IS NULL。
这个差异会继续影响 <>、NOT、IN、聚合和唯一约束。本文用“成绩未录入”案例把 SQL 三值逻辑讲清,并在 Python 自带的 SQLite 内存数据库执行最小示例。示例结论适用于常见关系型数据库;NULL-safe 比较和约束细节仍需核对具体产品版本、实际字段设计与 ORM 行为。
一、先看结论:NULL 判断的核心规则
| 你的目标 | 正确写法 | 错误写法 | 原因 |
|---|---|---|---|
| 判断为空 | score IS NULL |
score = NULL |
= NULL 返回 UNKNOWN |
| 判断非空 | score IS NOT NULL |
score <> NULL |
<> NULL 也返回 UNKNOWN |
| 不是 10 分或未录入 | score <> 10 OR score IS NULL |
NOT(score = 10) |
NOT UNKNOWN 仍是 UNKNOWN |
| 排除子查询中的 NULL | NOT EXISTS (...) |
NOT IN (子查询含 NULL) |
NOT IN 可能整批返回 UNKNOWN |
| 统计非空值数量 | COUNT(score) |
COUNT(*) |
COUNT(score) 忽略 NULL |
| 统计总行数 | COUNT(*) |
COUNT(score) |
COUNT(*) 统计所有行 |
| 把 NULL 当 0 参与计算 | COALESCE(score, 0) |
直接 AVG(score) |
需确认业务是否允许 |
一句话:NULL 表示未知,判断空值用 IS NULL,复杂条件必须显式处理 UNKNOWN 分支。
二、NULL 不是 0、空字符串或字符串 'null'
建一张最小成绩表:小狮是 0 分,阿橙尚未录入,小码是 10 分。0 是已知数值,NULL 是未知状态,两者不能混用。
-- 创建成绩表
CREATE TABLE scores(name TEXT, score INTEGER);

-- 插入三条数据:0 分、NULL、10 分
INSERT INTO scores VALUES
  ('小狮', 0),
  ('阿橙', NULL),
  ('小码', 10);
字符串 'NULL' 也只是四个字符,不具有空值语义。把缺失数据写成 0 或空字符串,会让平均分、筛选和业务规则都产生歧义。
| 值 | 含义 | 是否已知 | 参与 = NULL 比较 |
|---|---|---|---|
0 |
已知数值 0 | 是 | 结果 UNKNOWN |
'' |
长度为 0 的字符串 | 是 | 结果 UNKNOWN |
'NULL' |
四个字符的普通字符串 | 是 | 结果 UNKNOWN |
NULL |
未知或缺失 | 否 | 结果 UNKNOWN |
设计字段时先说明“未知”“不适用”“尚未录入”是否需要区分,必要时增加状态列,而不是让一个 NULL 承担所有含义。
如果 SELECT、WHERE 和聚合还是陌生概念,可以先浏览 SQL基础教程;理解查询执行顺序后,再看 NULL 会容易很多。
三、等号遇到 NULL 为什么得到 UNKNOWN
PostgreSQL比较运算文档 说明,普通比较只要任一输入是 NULL,结果就是 NULL,也就是 UNKNOWN。因为数据库不知道缺失的分数是多少,自然也无法断言它等于另一个未知值。
-- 错误写法:= NULL 不会返回任何行
SELECT name FROM scores WHERE score = NULL;

-- 正确写法:IS NULL 判断空值
SELECT name FROM scores WHERE score IS NULL;
本文在 Python 3 的 sqlite3 内存数据库实际执行:
第一条返回 []
第二条返回 [('阿橙',)]
这就是 SQL NULL 判断应使用 IS NULL 的直接证据。判断非空则写 IS NOT NULL,不要写 <> NULL。
WHERE 会把 FALSE 和 UNKNOWN 都过滤掉,只留下 TRUE。因此“查不到”不一定说明比较为假,也可能是表达式落入 UNKNOWN。分析复杂条件时,把每个子表达式分别查出来比盯着最终行数更可靠。
| 表达式 | 结果 | WHERE 是否保留 |
|---|---|---|
score = 10 且 score 为 10 |
TRUE | 保留 |
score = 10 且 score 为 0 |
FALSE | 过滤 |
score = 10 且 score 为 NULL |
UNKNOWN | 过滤 |
score = NULL |
UNKNOWN | 过滤 |
四、SQL 三值逻辑会怎样传播
PostgreSQL逻辑运算文档 给出了 TRUE、FALSE、UNKNOWN 三值表。几个最容易出错的组合如下:
| 表达式 | 结果 | 直觉解释 |
|---|---|---|
TRUE AND UNKNOWN |
UNKNOWN | 另一项未知,整体无法确认 |
FALSE AND UNKNOWN |
FALSE | 已有一项为假,整体必假 |
TRUE OR UNKNOWN |
TRUE | 已有一项为真,整体必真 |
FALSE OR UNKNOWN |
UNKNOWN | 另一项决定结果,但它未知 |
NOT UNKNOWN |
UNKNOWN | 对未知取反仍然未知 |
NULL = NULL |
UNKNOWN | 两个未知值不能断言相等 |
这也解释了下面查询为什么不包含阿橙:
-- 查询“不是 10 分”的学生
-- 阿橙的 score = 10 是 UNKNOWN,NOT UNKNOWN 仍是 UNKNOWN,所以不会被返回
SELECT name FROM scores WHERE NOT(score = 10);
实际输出只有:
小狮
阿橙的 score = 10 是 UNKNOWN,NOT UNKNOWN 仍是 UNKNOWN。若业务要求“不是 10 分或尚未录入”,必须明确写:
-- 显式包含 NULL 分支:不是 10 分,或者成绩未录入
SELECT name
FROM scores
WHERE score <> 10 OR score IS NULL;
该查询在本机实际返回:
小狮
阿橙
SQL NULL 判断不能靠日常语言里的“不是”直接推导,要把未知分支单独列出。
五、IN 和 NOT IN 为何特别容易踩坑
value IN (1, 2, NULL) 可以理解成多个等号用 OR 连接。若 value 不是 1 或 2,与 NULL 的比较仍是 UNKNOWN,最终结果可能不是 FALSE。
NOT IN 再对结果取反,UNKNOWN 仍然是 UNKNOWN,常导致整批数据意外消失。
-- 子查询里只要可能返回 NULL,就要小心
-- 如果 blocked_user_id 中存在 NULL,NOT IN 可能返回 0 行
SELECT id
FROM users
WHERE id NOT IN (SELECT blocked_user_id FROM blocks);
这类现象常被简称为 NOT IN NULL 陷阱。真正的问题不是语法不能执行,而是 UNKNOWN 逻辑让最终条件不再为 TRUE。排查时先运行子查询并统计空值数量,再决定过滤 NULL 还是改写为 NOT EXISTS。
更稳的反连接通常是 NOT EXISTS,并在关联条件里明确列对应关系:
-- 用 NOT EXISTS 改写反连接,避免 NOT IN 遇 NULL 返回 0 行
SELECT u.id
FROM users AS u
WHERE NOT EXISTS (
  SELECT 1
  FROM blocks AS b
  WHERE b.blocked_user_id = u.id
);| 写法 | 子查询含 NULL 时 | 语义是否清晰 | 建议 |
|---|---|---|---|
NOT IN (子查询) |
可能返回 0 行 | 容易误解 | 先统计 NULL,或改写 |
NOT EXISTS (关联子查询) |
不受 NULL 影响 | 较清晰 | 反连接优先考虑 |
LEFT JOIN ... WHERE 右表 IS NULL |
需注意 WHERE 过滤 | 可读性一般 | 明确关联条件后再用 |
不同数据库的优化器会改变执行计划,但语义首先要正确。若你使用 PostgreSQL,可以参考 PostgreSQL入门教程 继续验证;使用 MySQL、SQL Server 或 Oracle 时,也要在对应环境测试 NULL 与索引行为。
六、聚合、排序和 NULL-safe 比较的边界
COUNT(score) 忽略 NULL,COUNT(*) 统计行数。对示例表,前者是 2,后者是 3。AVG、SUM 通常也忽略 NULL;如果用 COALESCE(score, 0) 把未知分数改成 0 再平均,业务含义已经改变,必须确认这正是需求。
-- COUNT(score) 忽略 NULL,结果为 2
SELECT COUNT(score) FROM scores;

-- COUNT(*) 统计所有行,结果为 3
SELECT COUNT(*) FROM scores;

-- AVG(score) 忽略 NULL,只对 0 和 10 求平均
SELECT AVG(score) FROM scores;| 聚合写法 | 是否忽略 NULL | 示例结果 | 说明 |
|---|---|---|---|
COUNT(score) |
是 | 2 | 只统计非空分数 |
COUNT(*) |
不适用 | 3 | 统计所有行 |
AVG(score) |
是 | 5 | 只对 0 和 10 求平均 |
SUM(score) |
是 | 10 | 忽略 NULL |
COALESCE(score, 0) |
否 | 把 NULL 当 0 | 业务含义可能改变 |
需要把两个可空字段按“都为空算相等”比较时,PostgreSQL 可用 IS NOT DISTINCT FROM;MySQL 有 NULL-safe 运算符 <=>。它们不是通用等号替换,跨数据库项目应封装并测试。
-- PostgreSQL:NULL-safe 相等,两个 NULL 也算相等
SELECT * FROM scores WHERE score IS NOT DISTINCT FROM NULL;

-- MySQL:NULL-safe 相等运算符
-- SELECT * FROM scores WHERE score <=> NULL;
排序时 NULL 在前还是在后也存在产品差异,不要依赖默认顺序。排错可按三步走:
- 先把条件表达式单独 SELECT 出来;
- 再为 NULL、0、空字符串和正常值各放一行测试数据;
- 最后检查 ORM 是否把
None/null正确翻译成IS NULL。
这三步覆盖了 SQL 三值逻辑里最常见的三类出错位置:语义、建模和框架生成语句。
七、LEFT JOIN 与 CHECK 约束中的 NULL
LEFT JOIN 也容易把问题藏起来。连接失败时,右表字段会变成 NULL;如果随后在 WHERE 中写 right_table.status = 'active',这些行会因 UNKNOWN 被过滤,效果接近 INNER JOIN。
-- 想保留左表所有行时,右表过滤条件应放在 ON 中
SELECT u.id, b.status
FROM users AS u
LEFT JOIN blocks AS b
  ON b.user_id = u.id AND b.status = 'active';
想保留左表行时,应把右表过滤条件放进 ON,或在 WHERE 里明确接受 NULL,并用测试数据验证。
CHECK 约束同样受三值逻辑影响。许多数据库中,约束表达式为 UNKNOWN 时不会像 FALSE 那样拒绝行;如果字段必须存在,除了 CHECK(score >= 0) 还需要 NOT NULL。
-- 如果 score 必须存在,NOT NULL 和 CHECK 都要写
CREATE TABLE scores_v2(
  name TEXT,
  score INTEGER NOT NULL CHECK(score >= 0)
);
唯一约束对多个 NULL 的处理也存在产品差异,不能只凭一套数据库经验设计跨库模型。
应用层展示时,还要把未知值与“查询失败”分开。数据库返回 NULL 是一条合法数据状态,连接超时或 SQL 错误则是操作失败。把两者都显示成 0,会同时破坏数据质量和故障可观测性。
八、排错清单与测试用例
| 现象 | 常见原因 | 修复方式 |
|---|---|---|
score = NULL 查不到数据 |
= NULL 返回 UNKNOWN |
改用 IS NULL |
score <> NULL 查不到数据 |
<> NULL 返回 UNKNOWN |
改用 IS NOT NULL |
NOT(score = 10) 漏掉 NULL 行 |
NOT UNKNOWN 仍是 UNKNOWN |
显式加 OR score IS NULL |
NOT IN 突然返回 0 行 |
子查询含 NULL | 先统计 NULL,或改 NOT EXISTS |
AVG(score) 结果偏高或偏低 |
AVG 忽略 NULL | 确认是否用 COALESCE |
LEFT JOIN 后行数变少 |
WHERE 过滤了右表 NULL | 把右表条件下沉到 ON |
| CHECK 约束没拦住 NULL | 约束表达式为 UNKNOWN | 配合 NOT NULL |
| ORM 把 null 翻译错 | 框架生成语句不符合预期 | 打印 SQL 并检查参数绑定 |
测试用例不能只放正常值。至少覆盖:
| 测试输入 | 验证目标 |
|---|---|
score = 0 |
已知 0 不等于 NULL |
score = NULL |
IS NULL 能查到 |
score = 10 |
正常比较返回 TRUE |
'' 空字符串 |
与 NULL 行为不同 |
'NULL' 字符串 |
只是普通字符串 |
| 子查询含 NULL | NOT IN 与 NOT EXISTS 差异 |
COUNT(score) / COUNT(*) |
聚合忽略 NULL |
| LEFT JOIN 右表为 NULL | WHERE 与 ON 过滤差异 |
总结
SQL NULL 不能用等号筛选,因为 NULL 表示未知,普通比较会得到 UNKNOWN,而 WHERE 只保留 TRUE。IS NULL 负责空值判断,复杂条件则要显式处理未知分支。
你需要特别记住:
NOT UNKNOWN仍是 UNKNOWN;NOT IN的子查询含 NULL 时可能过滤全部候选;- 聚合忽略 NULL 不等于把它当 0;
- NULL-safe 相等语法因数据库而异;
- LEFT JOIN 的右表过滤条件要分清 ON 和 WHERE。
把边界数据放进测试表,是理解 SQL 三值逻辑最快的方法。
延伸学习
- 需要系统练习查询语法,可跟着 SQL入门课程 学习;
- 日常记不住聚合与条件语法时,查 MySQL速查手册;
- 想确认字段是否允许空值,可结合 MySQL表结构检查笔记 查看真实表定义。
常见问题
Q:NULL 和空字符串一样吗?
A:不一样。空字符串是长度为 0 的已知字符串,NULL 表示未知或缺失。两者的比较、索引和聚合行为不同。
Q:能不能用 COALESCE 统一把 NULL 变成 0?
A:语法上可以,业务上未必正确。只有“未知就按 0 处理”符合需求时才这样写;否则会把缺失数据伪装成真实零值。
Q:为什么 NOT IN 突然返回 0 行?
A:子查询结果可能含 NULL,使比较落入 UNKNOWN。检查子查询数据,并优先评估语义更清楚的 NOT EXISTS。
Q:所有数据库都支持 IS NOT DISTINCT FROM 吗?
A:不支持。PostgreSQL 支持该谓词,MySQL 常用 <=>。跨数据库代码应查对应文档并建立 NULL 对照测试。