
 TRAE-AI编程

MySQL 慢查询要先用慢查询日志和 EXPLAIN 抓住慢语句,再按缺失索引、全表扫描、锁等待等根因逐项修复,并用数据验证是否真的变快。最快的起手式是打开 slow_query_log,按执行时间排序捞出最慢的几条 SQL,再逐条 EXPLAIN 看执行计划。很多团队一遇到接口变慢就凭感觉加索引,结果加了一堆却没解决根因,反而拖慢了写入。下面按「定位—修复—验证」三步讲清,让你把慢接口救回来,而不是在没数据支撑的情况下瞎猜。无论慢在单条 SQL 还是批量任务,这套流程都能帮你把问题收敛到具体根因,而不是停留在「数据库有点慢」这种含糊判断上。
先看结论
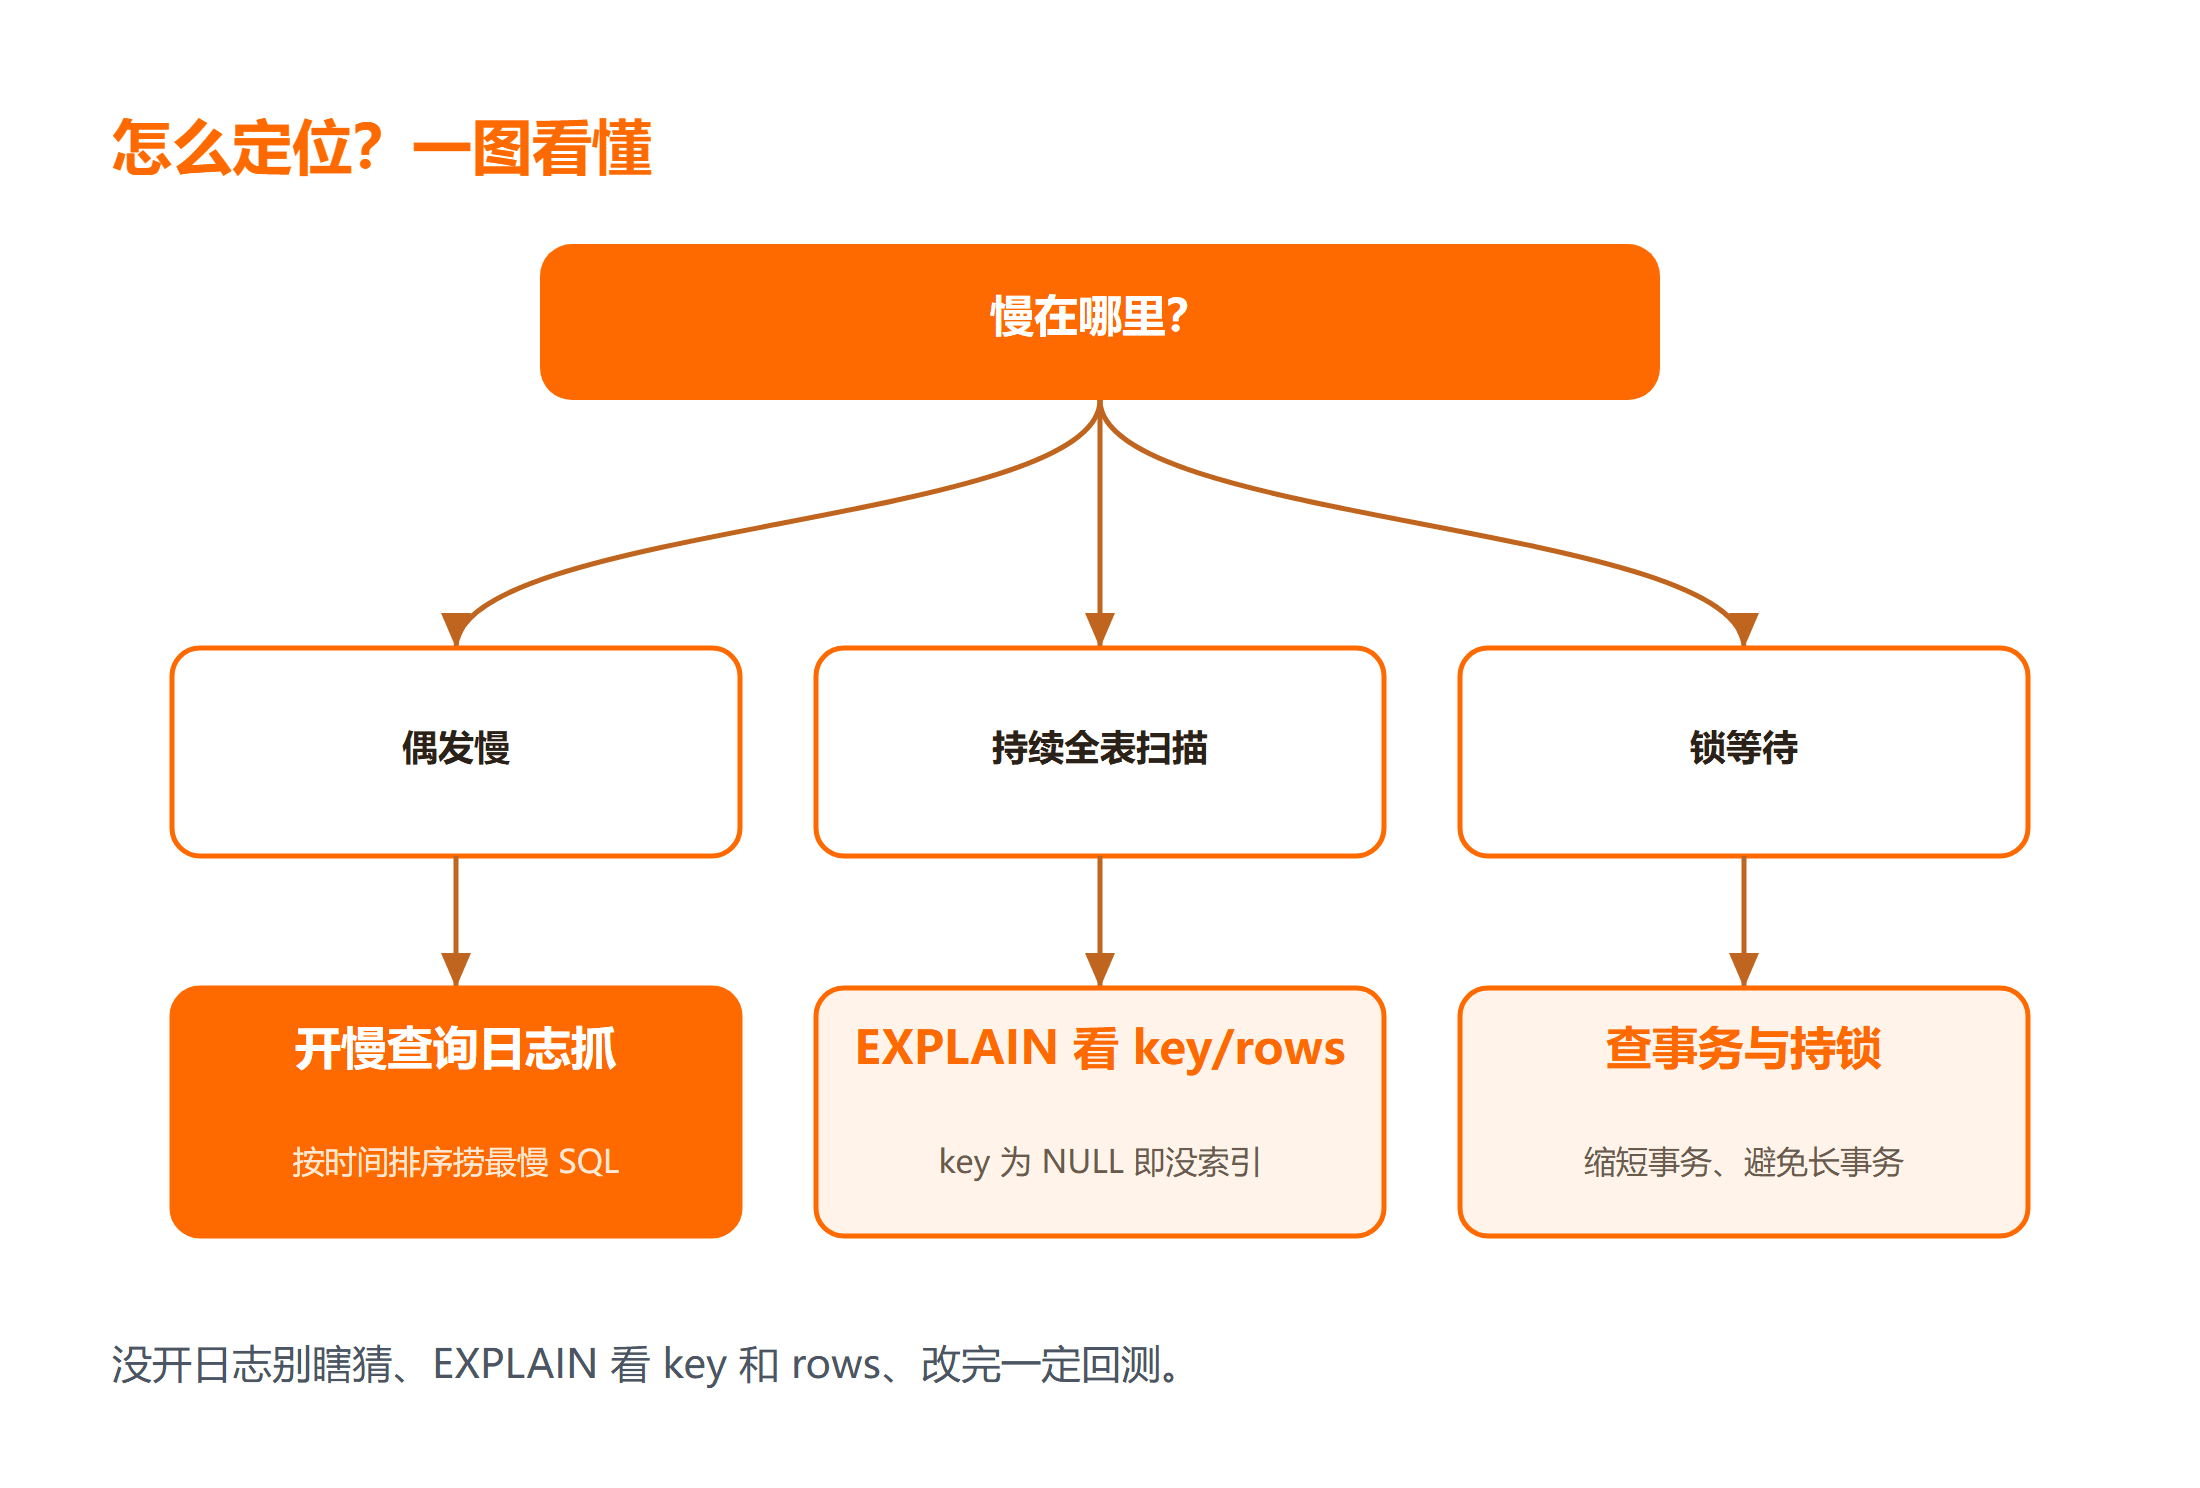
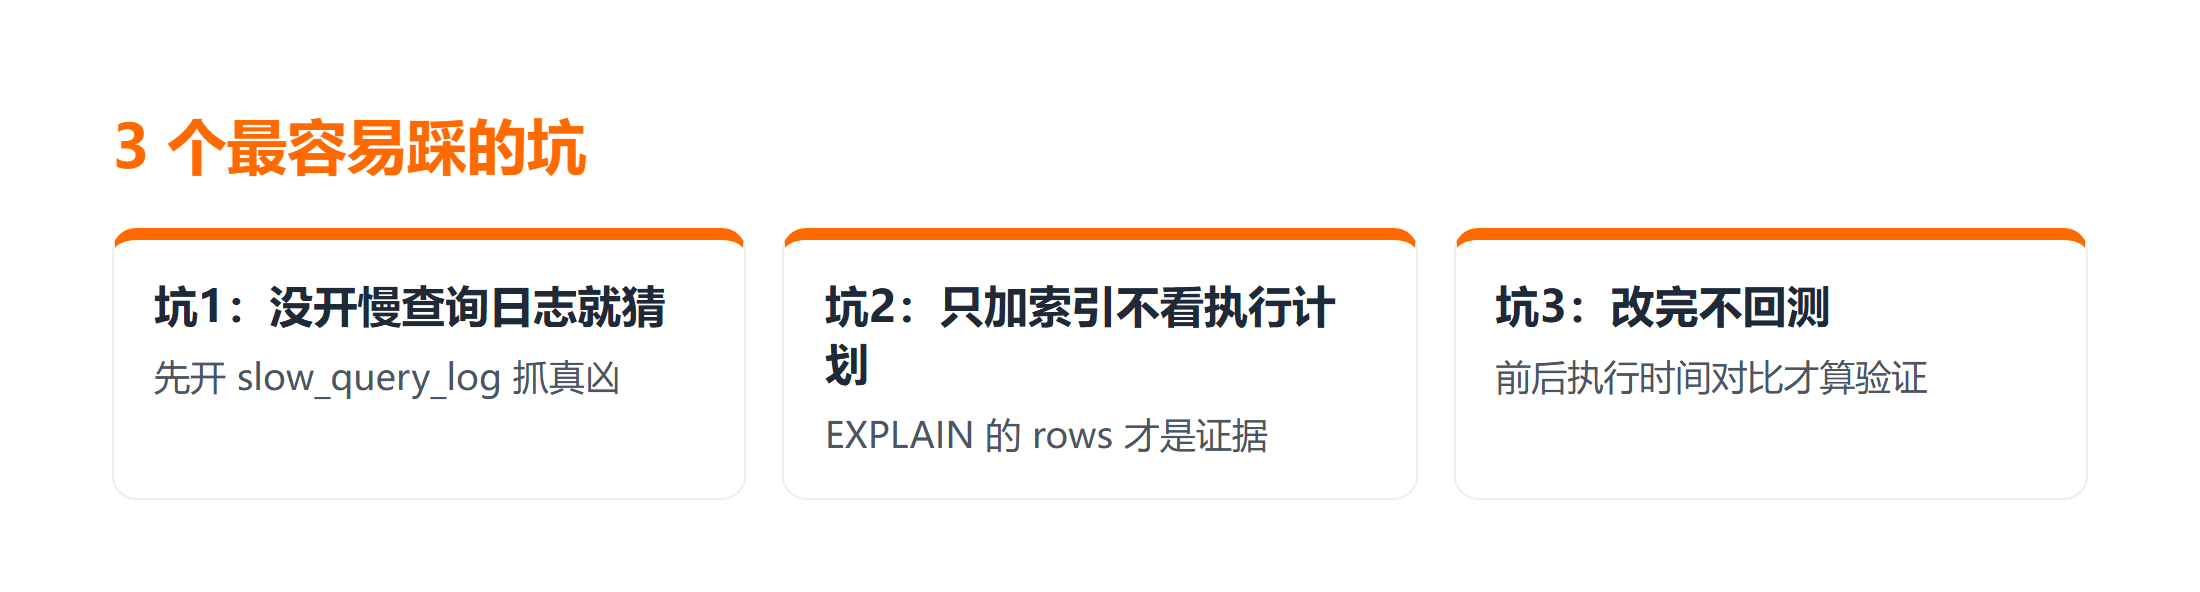
先把结论摆清楚:慢查询治理是「先抓后治再验」,绝不是凭感觉加索引。第一步用慢查询日志把最慢的 SQL 抓出来,第二步用 EXPLAIN 看清是没走索引还是锁等待,第三步按根因选加索引、改写 SQL 或解锁,最后用前后执行时间对比验证。口诀是:没开日志别瞎猜、EXPLAIN 看 key 和 rows、改完一定回测,索引优化才有意义。这里要明确一个适用边界:慢查询不一定是 SQL 写得差,也可能是数据量增长后原来的索引不再划算,或是并发锁冲突,所以定位动作比修复动作更关键,方向错了加再多索引也没用。
一、开慢查询日志:先把最慢的 SQL 抓出来
没开日志之前,你根本不知道慢在哪。临时开启慢查询日志,把超过阈值的语句落盘,再按执行时间排序捞出矛头。线上调完记得关掉或调大阈值,避免日志无限膨胀。基础排查流程在 MySQL 教程 有完整示例可参考。
-- 临时开启慢查询日志,超过 1 秒的记录
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
光抓出来还不够,要会读日志里的字段:Query_time 是实际耗时,Rows_examined 是扫描行数,Rows_sent 是返回行数。如果 Rows_examined 远大于 Rows_sent,基本就是扫了太多行;如果两者都大,那可能是结果集本身就大。这一步的目的,是把「感觉慢」变成「哪条 SQL、扫了多少行、花了多久」的可量化事实,后面所有修复都围绕它展开。
二、用 EXPLAIN 看清执行计划
抓到慢 SQL 后,EXPLAIN 是关键的一步。重点看三列:type 是不是 ALL(全表扫描)、key 是不是 NULL(没走索引)、rows 是不是远大于预期。这三列能直接告诉你慢在「扫得多」还是「没索引」。MySQL8 教程 对 EXPLAIN 输出字段讲得更细,值得配合看。
-- 定位慢语句后看执行计划
EXPLAIN SELECT * FROM orders WHERE user_id = 10086;
-- key=NULL 且 type=ALL → 全表扫描,需要加索引
EXPLAIN 的 Extra 列也别漏看:出现 Using filesort 说明排序没用上索引,出现 Using temporary 说明用了临时表,这两者往往就是慢的根源。再结合 filtered 字段判断过滤效率,就能把「慢」拆解成更具体的子问题——是缺索引、是排序开销、还是结果集太大,分别有不同的修复手段,不能一律用加索引掩盖。
三、按根因修复并验证
根因通常三类:缺索引就补、写法烂就改、锁等待就拆事务。补索引最省事,但要确认索引列干净、符合最左前缀;写法问题如 LIKE '%x%'、隐式转换,要靠改写;锁等待则缩短事务、避免长事务持锁。改完必须回测,用执行时间或 EXPLAIN 的 rows 对比前后。MySQL 速查手册 列了常见慢查询改写模板。这份清单把全表扫描、隐式转换、函数包裹列成对照表,排查时逐项打勾比凭记忆快得多,也避免漏掉低频但致命的写法。实际工作中慢查询很少是单一原因:同一句 SQL 可能既缺索引、又写了 SELECT *、还带了隐式转换,这时要先补索引再改写法,否则只看一边会误判根因,白加一堆索引。
-- 修复:在过滤列上建索引,让 EXPLAIN 的 key 从 NULL 变成有值
CREATE INDEX idx_orders_uid ON orders(user_id);
-- 回测:rows 应明显下降,响应时间缩短
修复之后一定要验证,否则很容易陷入「以为好了其实没好」。更系统的写法参考 SQL 教程 的事务与查询优化小节,里面给了一批可直接套的改写范式。验证的动作要形成闭环:改前记录执行时间和 rows,改后同口径再跑一次,两边对比确认下降才算通过,而不是只看「感觉快了」。这是慢查询治理和普通调优最本质的区别。验证时还要注意缓存和环境差异:同一 SQL 在从库和主库、冷数据和热数据下表现可能不同,最好在贴近生产的只读实例上回测。把回测结果记录进工单,下次再慢就能直接对照历史,形成可复用的治理档案。
实操检查清单
- 前置:先确认 MySQL 版本与权限,配置好可临时开启慢查询日志的会话。
- 操作:运行开启日志与 EXPLAIN 的命令,观察实际输出与执行计划。
- 检查:看 EXPLAIN 的 key、type、rows,预期看到索引命中且扫描行数下降。
- 失败处理:若加索引仍慢,按「缺索引 → 烂写法 → 锁等待」逐条排查并重新验证。
- 适用边界:该流程适用于 OLTP 慢接口;离线批处理要另算资源与并发成本。
总结
回到开头:慢查询怎么定位,核心是「日志抓、EXPLAIN 看、按根因修、回测验」四步闭环。别在没开慢查询日志时瞎猜,也别加完索引不回测就以为好了。把 EXPLAIN 的 key、type、rows 三列读熟,绝大多数慢语句都能在十分钟内定位到是缺索引、烂写法还是锁等待。治理慢查询拼的不是经验玄学,而是这套可复现的流程,谁都能照着做出来。
常见问题
Q:long_query_time 设多少合适?
开发期可设 0.1~1 秒抓得细,线上设 1~2 秒避免日志过大。调优阶段建议先小后大,逐步收窄。
Q:EXPLAIN 的 rows 是真实扫描行数吗?
是优化器的估算值,未必精确,但数量级对定位是否全表扫描足够可靠,不必追求精确。
Q:加了索引还是慢怎么办?
看是否隐式转换、列上套函数,或联合索引没走最左前缀;也可能是锁等待而非索引问题,要分项排查。
Q:慢查询日志会拖慢数据库吗?
开启本身开销很小,但日志无限增长会占磁盘,定位完应关掉或调大阈值,别长期开着。
Q:回测怎么才算验证通过?
同一 SQL 的执行时间明显下降、EXPLAIN 的 rows 显著减少,且业务口径结果一致,才算通过,否则视为未修复。



