 TRAE-AI编程

语音识别(ASR)是把人的声音信号自动转成文字的技术,核心是把连续的声波先变成特征,再用模型判断每个片段对应哪个字或词。你在用输入法语音转文字、给视频加字幕时常遇到这样的需求:说出来的话要又快又准地变成可编辑文本。本文用初学者能跟上的方式,讲清 ASR 到底是什么、识别流水线分几步、传统方案和端到端方案怎么选,以及用哪些指标判断识别得好不好、落地时容易踩哪些坑。看完你能判断自己项目该用哪种识别方案,以及第一步从哪里下手。今天这篇文章,编程狮就把这块讲透。
一、语音识别到底是什么
用一句判断句给定义:语音识别是一类把音频波形映射为文字序列的任务,它介于信号处理和自然语言处理之间,目标是让机器“听懂”人说了什么。
打个比方,就像一位速记员边听边把话语转成稿子,先分辨每个音节,再结合上下文把同音字纠正成正确的词。模型做的也是这套:先从声音里提特征,再结合语言习惯猜出最可能的文字。
1.1 触发条件
当你需要把大量语音变成可搜索、可编辑的文字时,ASR 最值得上。典型场景是会议记录、字幕生成、语音助手唤醒后的指令解析,这些场景里人工转写太慢太贵。
⚠️ 注意:ASR 不是“录下来就能出字”。它高度依赖训练数据和领域适配,医疗、法律等专有词汇多的场景,通用模型容易翻车。想补齐 AI 基础,可先过一遍 人工智能教程。
1.2 常见误解
有人认为“识别就是把声音对应到拼音”。其实关键在于语言模型会做上下文纠错:听到“yuyin”时,模型要结合前后文判断是“语音”还是“雨音”。这也是它和单纯发音词典的区别。
二、识别流水线分几步(最小示例)
下面用伪代码展示一条经典 ASR 流水线的核心步骤。这段代码演示的是从读音频到输出文字的主干流程。
import numpy as np

wave = load_audio("speech.wav", sr=16000)     # 读 16k 采样音频
feats = extract_mfcc(wave, n_mfcc=13)         # 第一步:提梅尔倒谱特征
tokens = acoustic_model(feats)                # 第二步:声学模型出音素概率
text = language_model.rescore(tokens)         # 第三步:语言模型纠正上下文
result = decoder.decode(text)                 # 第四步:解码出最终文字
上面这段做的是把原始波形先压成紧凑特征,再逐段给出发音概率,最后靠语言模型把概率串成通顺句子。预期结果(未在本机执行,依据公开论文与官方文档)是 result 是一段和原话高度一致的汉字串,同音错误被上下文纠回。
💡 小提示:采样率统一到 16k 是行业惯例,过高不会更准反而更慢;如果输入是 8k 电话音,模型也要用电话音数据训练,否则识别率会明显下降。
三、传统混合与端到端怎么选
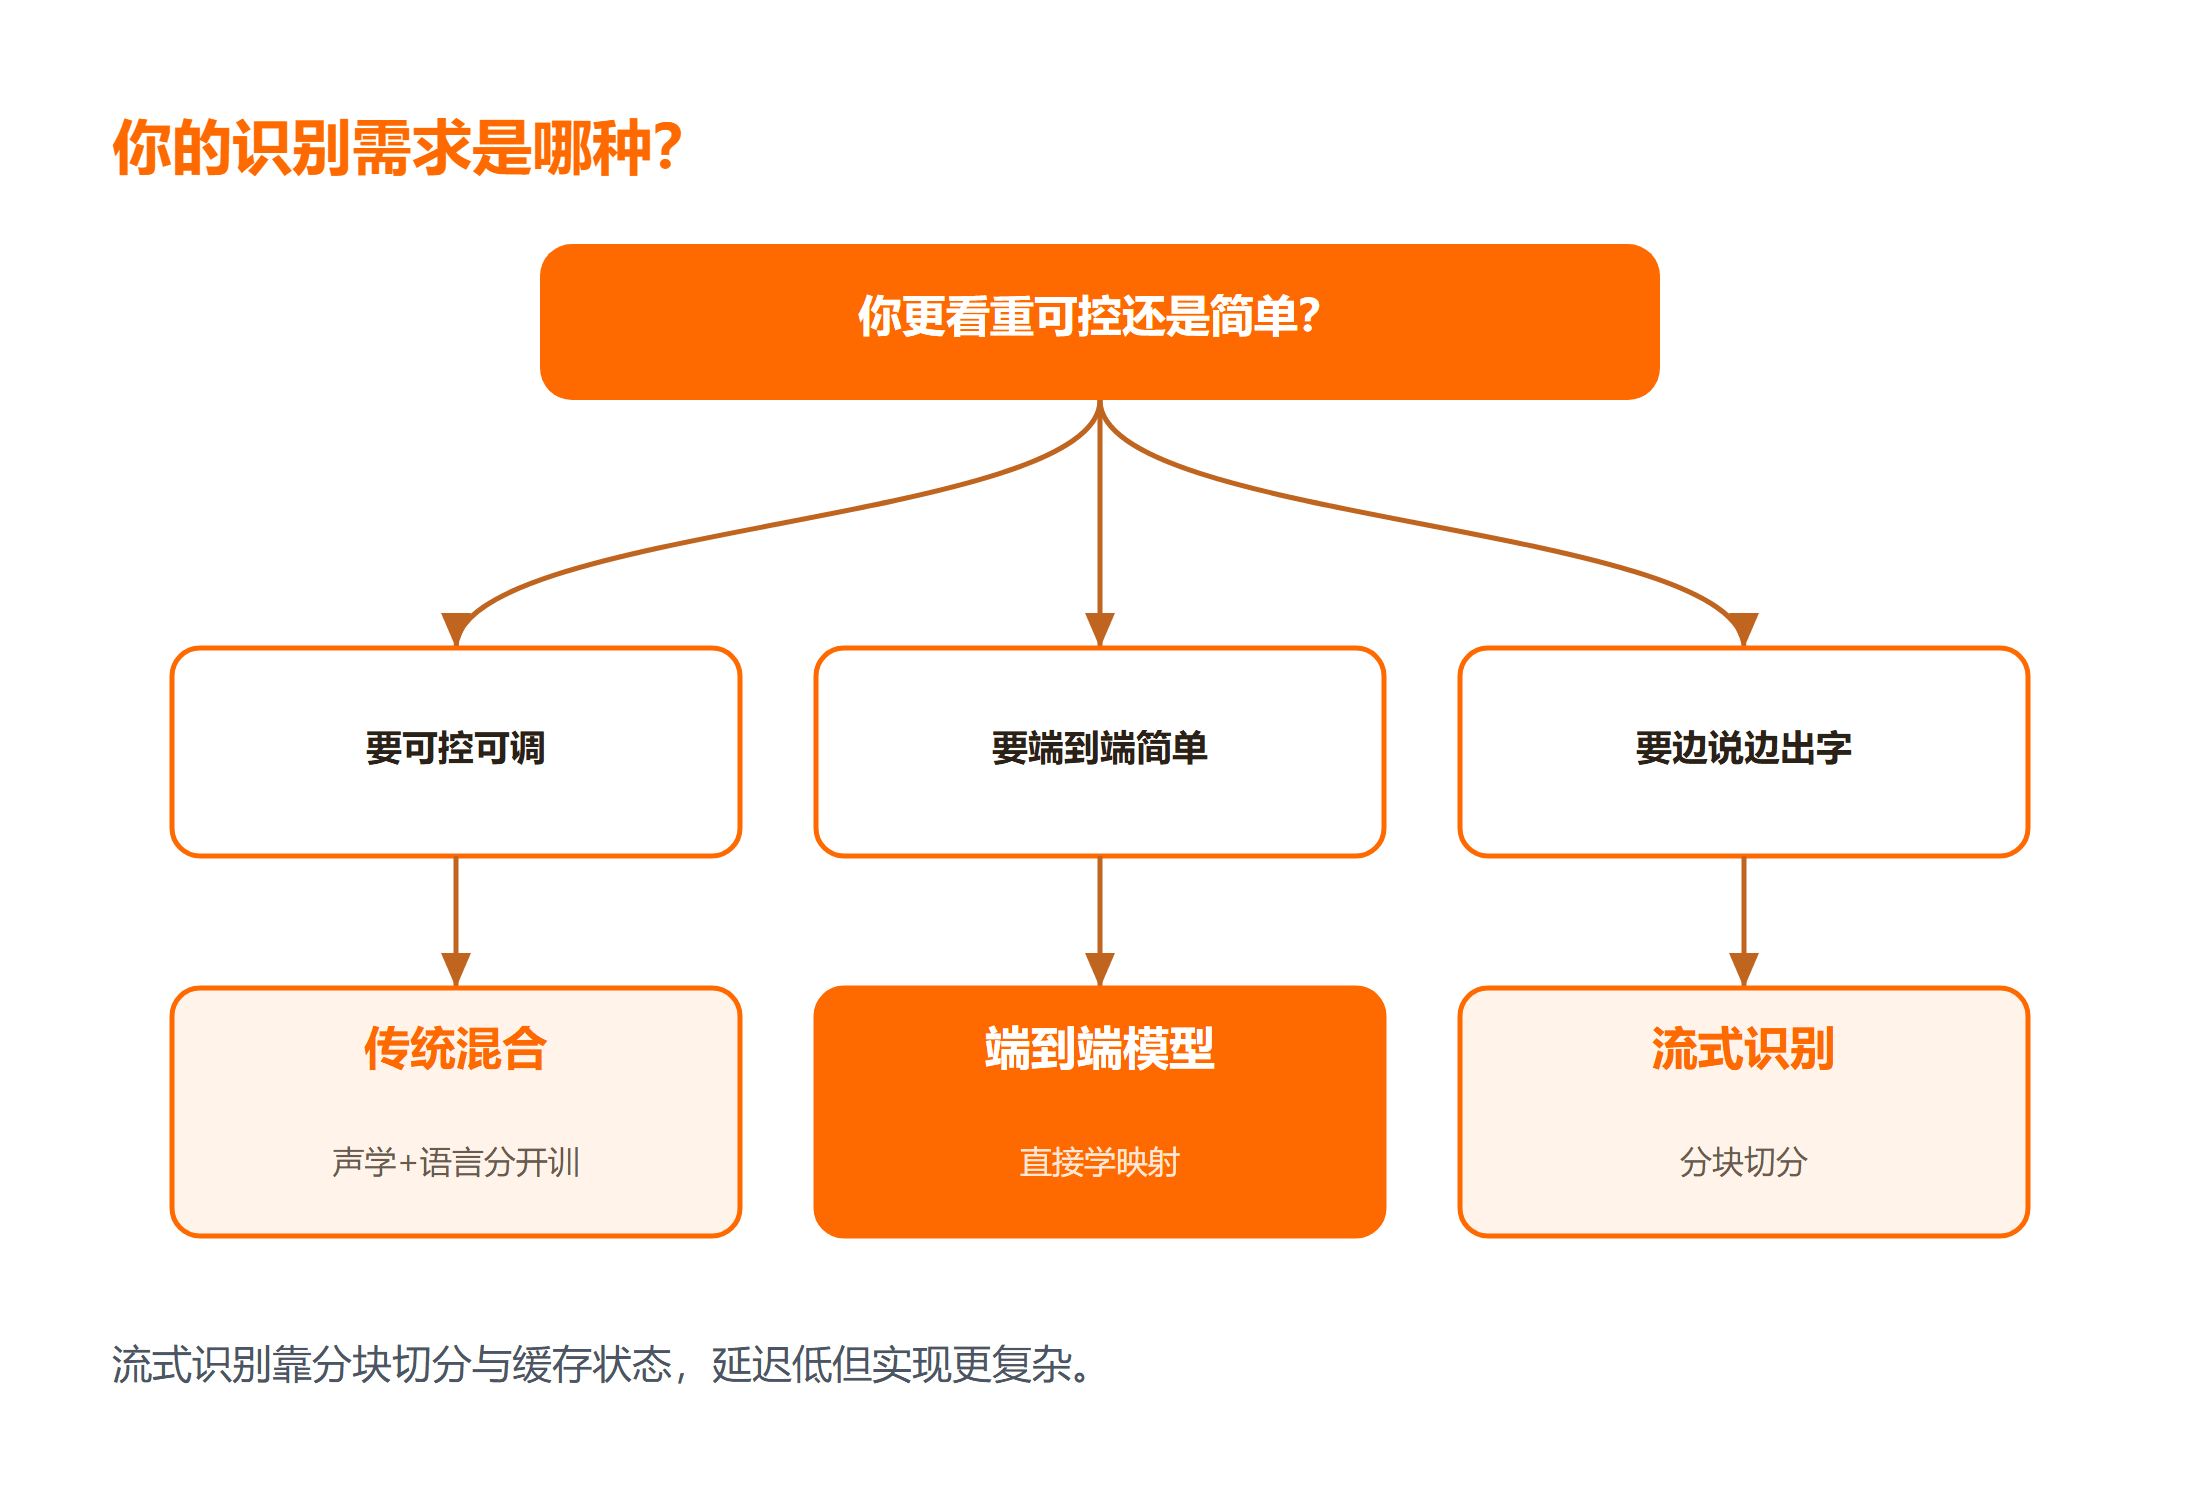
传统混合系统把声学模型、发音词典、语言模型分开训练,每块可单独替换,解释性强;端到端模型直接从音频学到文字,结构更简单,但需要更多数据和算力。
3.1 版本与适用边界
早期系统(如 HMM-GMM)依赖手工特征;深度学习时代声学模型换成神经网络;近年端到端(如 CTC、Transducer)成为主流。适用边界是:小数据、要可控就用混合;大数据、追上限就上端到端。关于神经网络结构的背景,可参考 神经网络类型。
3.2 失败的表现
失败通常有两种:一是在安静环境还老错同音字,说明语言模型权重没调好;二是噪声下整体崩盘,说明声学模型没见过这类数据。两者都要靠带标注的验证集来定位,不能只听感觉。
四、衡量识别好坏看哪些指标
光说“挺准的”不够,工程上主要看三个指标:字错率(WER)、实时率(RTF)和鲁棒性。
| 指标 | 含义 | 关注点 |
|---|---|---|
| 字错率 WER | 删改替错误占比 | 越低越好 |
| 实时率 RTF | 处理耗时与音频时长比 | 流式要小 |
| 鲁棒性 | 噪声方言下表现 | 远场抗干扰 |
实际怎么算 WER?把识别结果和人工标注逐字对齐,统计插入、删除、替换三类错误的总数,再除以标注总字数。工程上你会先准备一批标准录音和对应文本,配置好评测脚本后运行一次,就能拿到 WER 与 RTF 两个数字。检查分数前要先验证测试集和线上场景分布一致,否则数字再好看也说明不了问题。很多团队把这些指标接入回归测试,每次模型更新都自动跑一遍,方便横向对比版本强弱。若发现某批数据 WER 异常,先排查是不是标注口径变了,而不是急着换模型。
⚠️ 边界提醒:WER 只看字不对词,长句里一个断句错可能拉高整体;流式场景还要盯 RTF,否则说话人等得着急。
五、落地时容易踩的坑
- 现象:安静时还老错同音字。原因:语言模型没适配领域词。修复:加入领域热词或微调语言模型,再在验证集上比对 WER。
- 现象:一有背景音就乱码。原因:训练数据太干净。修复:做数据增强,混入噪声样本,重训声学模型。
- 现象:标点全无、读起来费劲。原因:模型只出字没出标点。修复:后接一个标点恢复模型,或选自带 ITN 的识别服务。
# 给识别结果补标点的片段(非完整脚本)
raw = asr_model.transcribe(audio)        # 得到无标点文本
punct = punctuation_model.restore(raw)   # 恢复逗号句号
# 预期 punct 形如“今天天气真好,我们去散步。”(未在本机执行)
总结
语音识别是把声波转成文字的技术,核心流水线为特征提取、声学模型、语言模型和解码四步。落地记住三点:语言模型负责上下文纠错,同音字靠它;端到端结构更简单但吃数据;用 WER、RTF、鲁棒性三指标客观判断好坏。想系统理解 AI 术语,可补 AI 术语翻译笔记。
要点带走:
- 识别不是一对一拼音映射,上下文纠错了同音字;
- 采样率 16k 是惯例,电话音要专用模型;
- 上线不能只看“感觉准”,要用 WER 和 RTF 量化。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何调用语音能力;
- 想理解 AI 基础,读 AI 核心概念笔记;
- 动手前补 AI Python 课程 了解工程实现。
常见问题
Q:ASR 和 TTS 是相反的关系吗?
A:功能上相反:ASR 是语音转文字,TTS 是文字转语音,常被一起用在语音助手里。但技术上两套独立模型,一个解决“听懂”,一个解决“发声”,不能互相替代。
Q:端到端一定比混合系统好?
A:不一定。端到端在大语料下上限更高、流程更短,但小数据或需要可解释、可单独替换模块时,混合系统反而更稳、更省资源,选哪个看数据量和可控性要求。
Q:为什么识别准了却还要做标点恢复?
A:很多 ASR 只输出纯汉字串,没有逗号句号,人和机器都难读。标点恢复(ITN)把“今天天气真好我们去散步”变成带标点的句子,是上线前几乎必做的一步后处理。