 TRAE-AI编程

在 Java 里遍历 Map,最常用的是三种写法:用 entrySet 一次拿到键值对、用 keySet 先拿键再取值、用 Java8 的 forEach 配合 Lambda 直接消费。三种写法可读性不同,entrySet 效率最好、forEach 最简洁。很多初学者分不清该用哪一个,结果写出了多遍历一次的低效代码。本文用最小示例讲清三种写法的写法、效率和边界,并给出一张选型表,看完你就能按场景选对遍历方式,不再为 Map 遍历发愁。无论你是刚接触集合框架,还是复习巩固想确认细节,都能照着示例直接在本机跑通,先验证正常路径、再处理失败路径。
先看结论
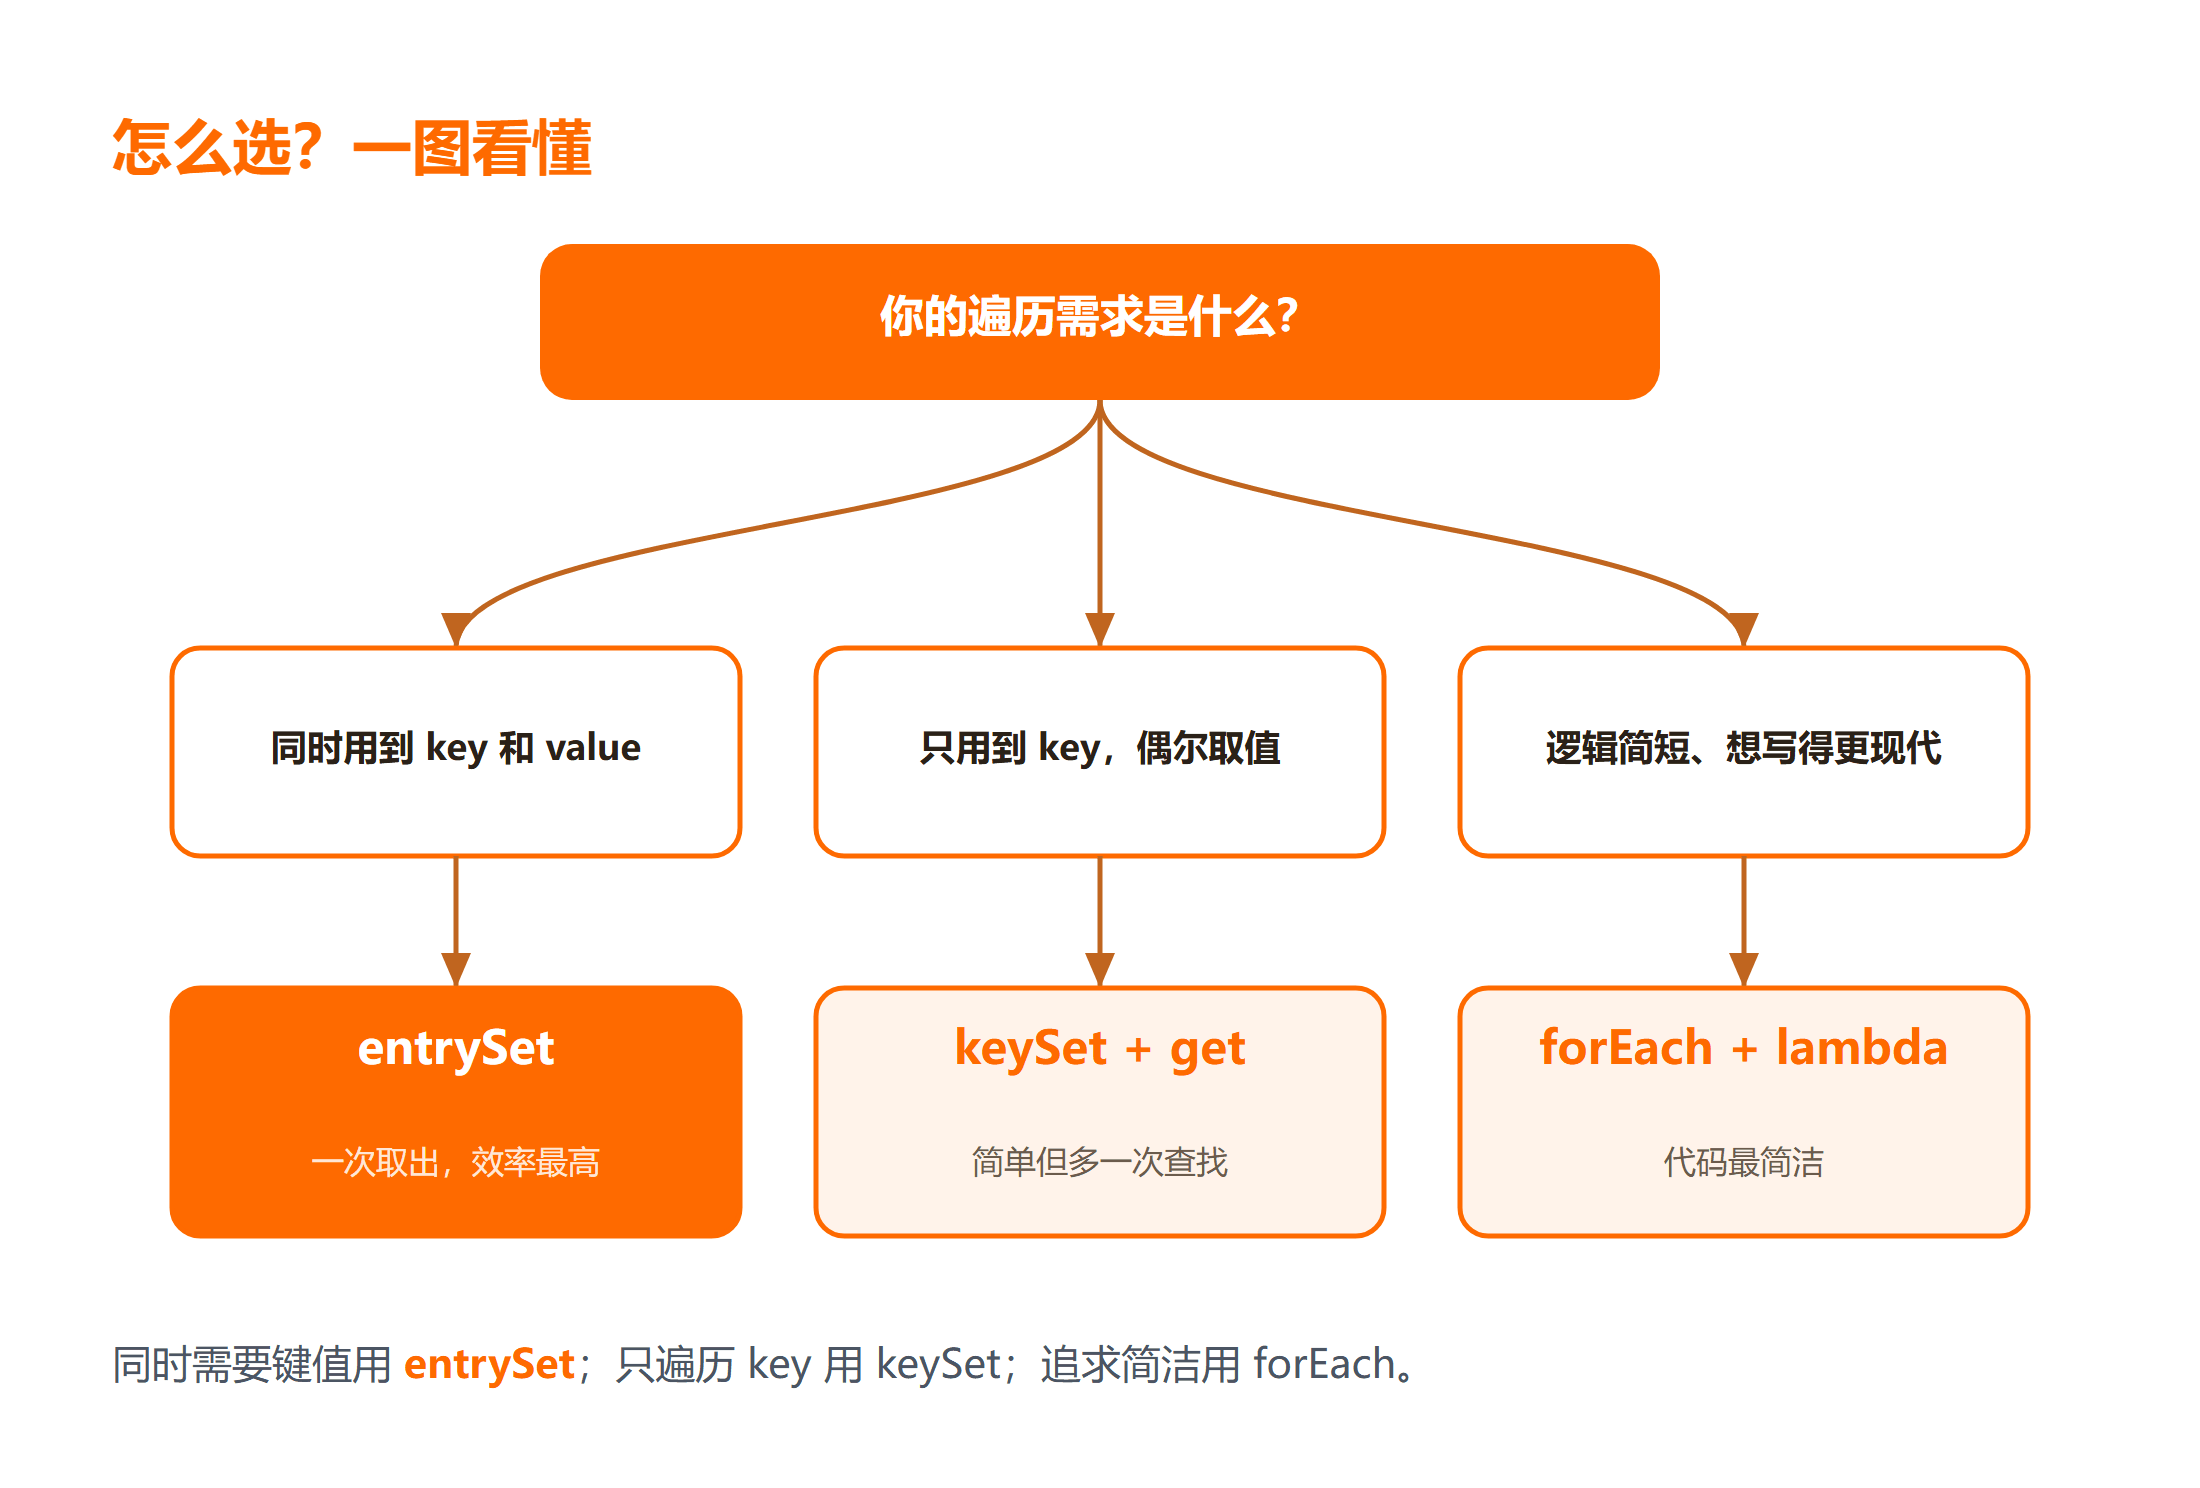
先给你一张选型表,省得在三种写法之间纠结:
| 你想做的事 | 推荐写法 | 原因 |
|---|---|---|
| 既要用键又要用值 | entrySet |
一次拿齐键值对,不二次查表,效率最好 |
| 只需要键、顺手取值 | keySet |
写法直观,但要注意会多一次 get |
| 追求代码简洁、明确支持 Java8+ | forEach + Lambda |
一行搞定,可读性最高 |
一句话记住:要效率用 entrySet,要简洁用 forEach,keySet 只在只用键时更顺手。
一、entrySet:一次拿到键值对(推荐)
entrySet 返回的是“键和值打包好”的视图,每轮循环直接拿到 Map.Entry,不需要再回表查一次值,是三种写法里效率最好的。
import java.util.HashMap;
import java.util.Map;

public class Demo {
    public static void main(String[] args) {
        Map<String, Integer> map = new HashMap<>();
        map.put("apple", 3);
        map.put("banana", 5);
        for (Map.Entry<String, Integer> entry : map.entrySet()) {
            System.out.println(entry.getKey() + " = " + entry.getValue());
        }
    }
}
上面这段先建了一个字符串到整数的 Map,塞进两对数据,然后用增强 for 循环遍历 entrySet。预期结果(未在本机执行):程序运行后逐行输出 apple = 3 和 banana = 5,说明 entrySet 拿到了每一个键值对。如果你还不熟悉 Java 的集合框架,可以先过一遍 Java 基础教程 里 Map 与 Set 的章节再回来读。
在动手写遍历代码前,先在本地运行一个最小样例,确认 JDK 版本和编译环境无误:用 javac 编译后再用 java 运行,检查控制台是否逐行打印键值对。预期输出应当与插入顺序无关,但每个键只出现一次;若发现某个键的值被覆盖,说明之前 put 进了同名的键,需要回到插入逻辑排查。失败处理上,最常见的两类异常是 NullPointerException——多半是 Map 本身为 null,或 value 为 null 时被自动拆箱触发——以及 ConcurrentModificationException——在 for-each 遍历时直接调用 map.remove 删元素就会触发,正确做法是用迭代器的 remove 方法,或改用 removeIf。验证改动是否安全,最稳的办法是在单元测试里断言遍历结果与手算一致。
关于迭代器本身的设计,那篇 Java 迭代器接口详解 从接口层面讲了集合遍历的统一机制,想理解 for-each 背后是怎么调用 iterator 的可以对照着看。从版本边界上说,entrySet 和增强 for 从 Java5 起就稳定可用,兼容性完全不用愁。
二、keySet:先拿键再取值
keySet 只返回“键”的集合,循环里拿到键之后,还要用 map.get(key) 再取一次值。写法直观,但在大 Map 上会比 entrySet 多一次哈希查找。
for (String key : map.keySet()) {
    System.out.println(key + " = " + map.get(key));
}
这段和上一段输出完全一样,只是取了键之后再回头查值。预期结果(未在本机执行):同样逐行输出 apple = 3 和 banana = 5。适用场景是“你其实只需要键”的时候,比如只统计有哪些键存在;一旦键值都要,就别用它,改用 entrySet 省掉那次多余的 get。
三、forEach + Lambda:最简洁的写法
Java8 引入的 forEach 配合 Lambda,把遍历压缩成一行,可读性最高,但前提是项目明确跑在 Java8 或更高版本上。
map.forEach((key, value) -> System.out.println(key + " = " + value));
这段和上两段输出一致,表达却最克制。预期结果(未在本机执行):依旧逐行输出 apple = 3 和 banana = 5。需要安装的运行时是 JDK8 及以上,编译用 javac Demo.java,运行用 java Demo。如果你的工程还停在 Java7,编译会直接报错 lambda 不支持,修复办法是把语言级别调到 8 以上再编译验证。
四、横向对比与踩坑清单
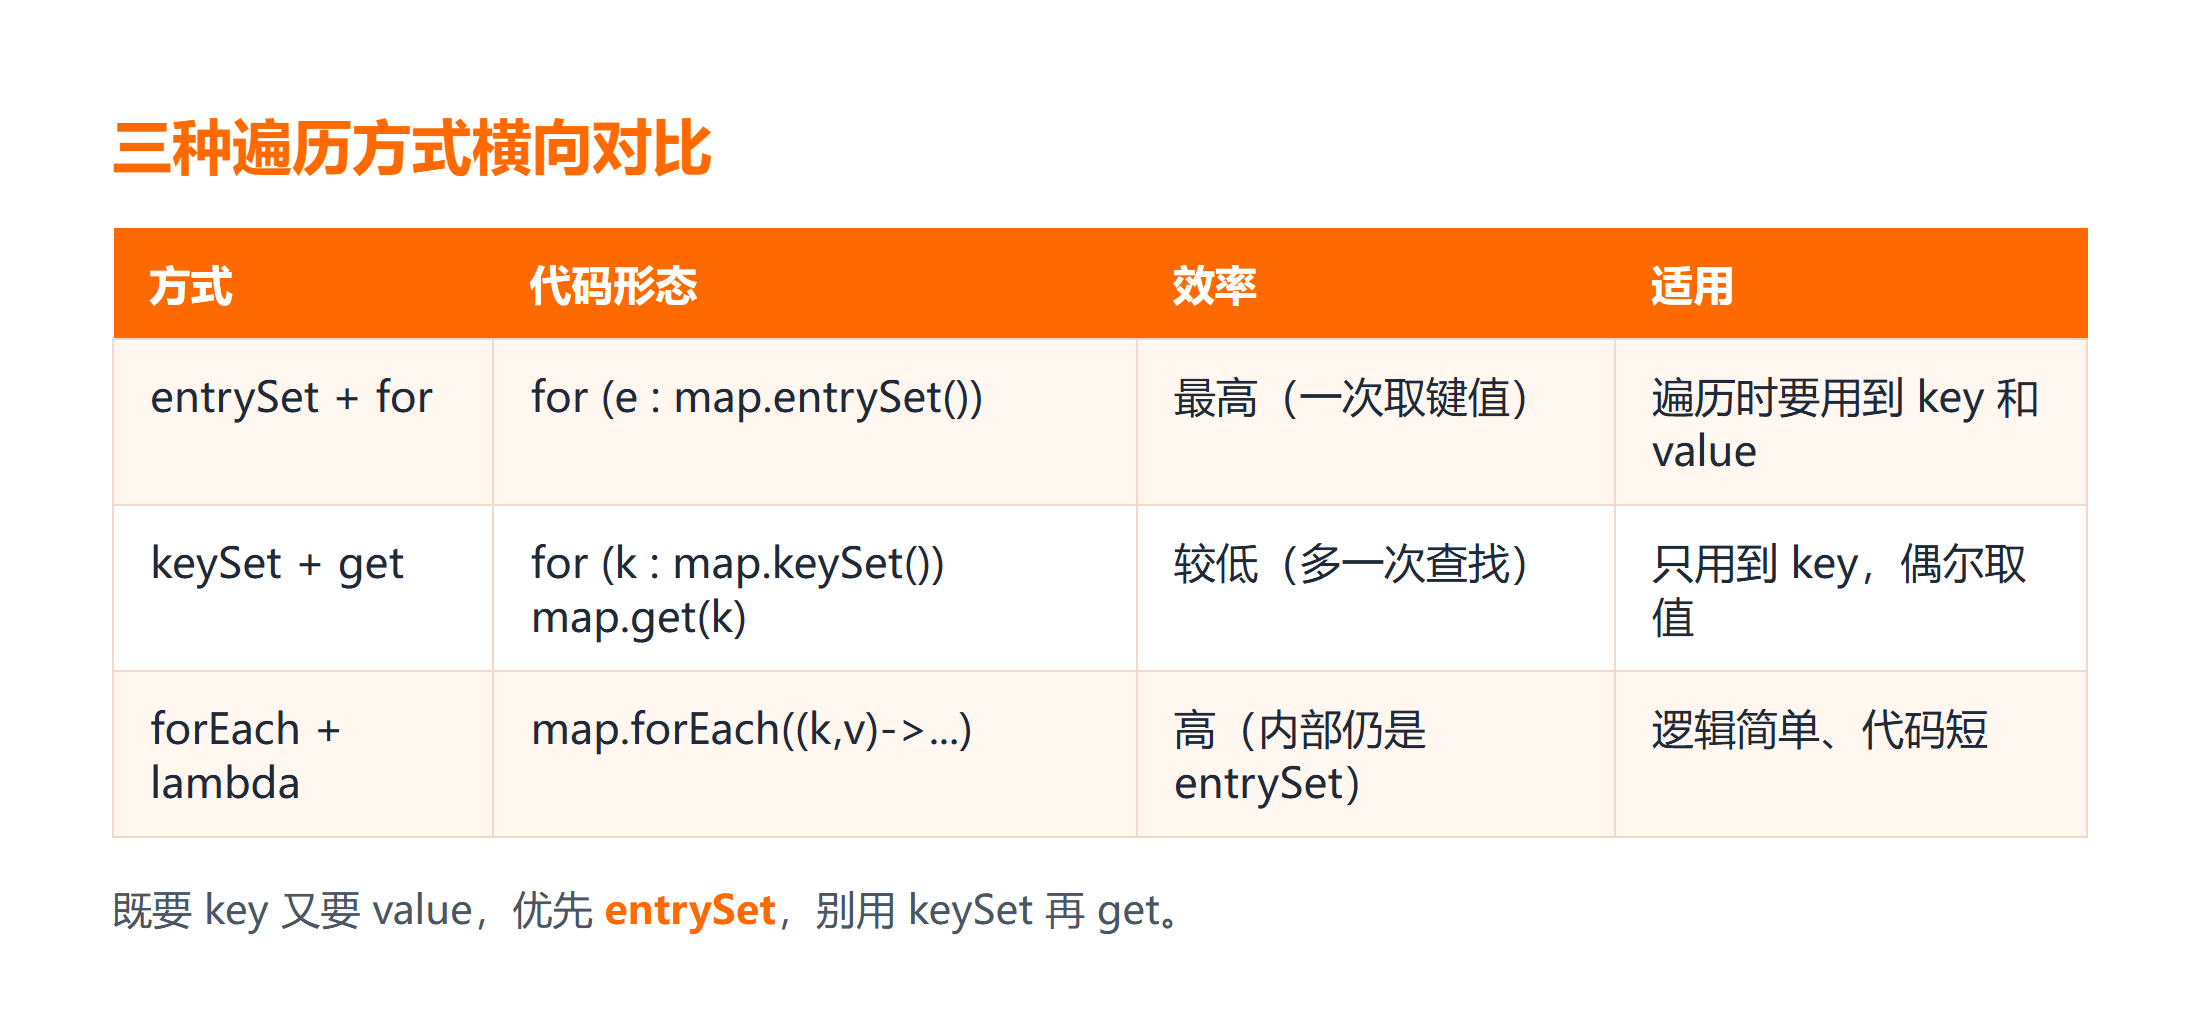
把三种写法摆在一起,差异就很清楚:
| 维度 | entrySet | keySet | forEach |
|---|---|---|---|
| 是否二次查表 | 否 | 是(多一次 get) | 否 |
| 代码简洁度 | 中 | 中 | 高 |
| 最低版本 | Java5 | Java5 | Java8 |
选型建议很明确:默认用 entrySet,效率和可读性都均衡;只在“只用键”的场景考虑 keySet;项目锁定 Java8+ 时,forEach 是最省眼的选择。
下面这几条是实际写代码时最常卡住的点,每条都给了现象、原因和修复办法。
- 现象:用 forEach 却编译报错 lambda 不支持。
原因:项目语言级别低于 Java8,forEach 的 Lambda 写法无法编译。
修复:把编译目标调到 Java8 或更高,确认依赖环境确实是 Java8+。
- 现象:用 keySet 遍历大 Map,性能明显比同事的写法慢。
原因:每轮都多一次 map.get(key) 哈希查找。
修复:改用 entrySet,一次拿到键值对,去掉多余查表。
- 现象:遍历时顺便 map.put,抛出 ConcurrentModificationException。
原因:在 for-each 遍历中直接修改原 Map,触发快速失败机制。
修复:先收集要改的内容,遍历结束后再统一修改,或用 ConcurrentHashMap 等并发容器。
- 现象:想同时拿键和值,却还在用 keySet + get,代码又长又慢。
原因:没意识到 entrySet 能把键值对一起给出来。
修复:换成 entrySet 的增强 for 循环,代码更短、效率更高。
总结
Java 遍历 Map 就三件事:要效率用 entrySet,要简洁用 forEach,只用键时才用 keySet。选错写法,最常见的结果是多一次查表、性能白白损失。
要点带走:
- entrySet 一次拿齐键值对,不二次查表,效率最好;
- keySet 只拿键,要值还得再 get 一次,大 Map 上偏慢;
- forEach 配 Lambda 最简洁,但要求 Java8 及以上;
- 遍历中别直接改原 Map,否则会触发并发修改异常。
下一步如果你要处理更复杂的数据,建议先吃透 entrySet,再去看 ConcurrentHashMap 这类并发容器的遍历规则。
延伸学习
想把 Java 集合这块系统补齐,可以按这个顺序来:
- 先过一遍 Java 架构师课程,把集合框架和并发容器的基础铺平;
- 那篇 Java 集合框架总览 把列表、栈、队列、集合、映射的关系讲清楚了,建立整体认知很有帮助;
- Java 集合遍历方法详解 从更多角度补充了遍历的写法,遇到具体写法对不上时可以对照。
常见问题
Q:entrySet 和 keySet 哪个效率更高?
A:entrySet 更高。keySet 只给键,循环里还要用 map.get(key) 再查一次表,大 Map 上会多出不小的开销;entrySet 每轮直接给出键值对,省掉这次多余查找,是默认推荐。
Q:forEach 遍历要求 Java 几?
A:forEach 加 Lambda 是 Java8 引入的写法,项目必须跑在 Java8 或更高版本上。如果工程还停留在 Java7,编译期就会报 lambda 不支持,把语言级别提到 8 以上即可。
Q:遍历 Map 时能顺便修改它吗?
A:不建议。用 for-each 遍历时直接 put 或 remove 原 Map,会触发 ConcurrentModificationException。正确做法是先记录要改的内容,遍历结束后再统一修改,或者改用 ConcurrentHashMap 这类支持并发遍历的容器。