 免费 AI IDE

MySQL 查询变慢时,第一步永远是打开慢查询日志把"慢 SQL"抓出来,再用 EXPLAIN 看它有没有走索引;八成的性能问题都出在缺失索引或写了让索引失效的 SQL 上。本文给出五个层层递进的排查方向:慢日志定位、执行计划分析、索引补全、统计信息更新、锁与事务阻塞,并附可直接复制的 SQL。无论你用 MyISAM 还是 InnoDB,思路是通用的。读完你能自己定位一条慢查询的根因,而不是盲目加内存或重启数据库。
一、方向一:用慢查询日志抓出真正的慢 SQL
当线上响应变卡,凭感觉改 SQL 往往南辕北辙。MySQL 自带的慢查询日志会记录所有执行时间超过 long_query_time 的语句,是定位问题的第一手证据。默认该功能是关闭的,需要先开启,并建议把阈值设小一点(如 1 秒)以便捕捉 borderline 的查询。
除了时间阈值,还可以用 log_queries_not_using_indexes 把"没走索引的查询"也记下来,这对发现全表扫描特别有用。日志文件会逐行列出耗时、扫描行数和具体 SQL,配合 mysqldumpslow 工具能按出现次数排序,快速找到最该优化的那条。排查时优先看 Rows_examined 远大于 Rows_sent 的语句,那通常意味着索引没生效。
-- 临时开启慢查询日志(重启失效,生产用配置文件更稳)
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 'ON';
-- 查看当前设置
SHOW VARIABLES LIKE 'slow_query_log%';
SHOW VARIABLES LIKE 'long_query_time';
想系统补 SQL 基础,可参考 SQL 教程,其中对 SELECT、JOIN 与索引约束的讲解能帮你读懂执行计划里的每一列含义。
二、方向二:用 EXPLAIN 看执行计划与索引命中
抓到慢 SQL 后,在语句前加 EXPLAIN 就能看到 MySQL 准备怎么执行它:走没走索引、扫描多少行、是否用了临时表或文件排序。重点看 type 列,从好到坏大致是 const > ref > range > index > ALL,看到 ALL 就说明全表扫描,必须警惕。key 列显示实际使用的索引,为空说明没用上。
Extra 列也很有信息量:Using index 是覆盖索引的好信号;Using filesort 表示需要额外排序,数据量大时很慢;Using temporary 往往出现在 GROUP BY 没走索引时。如果明明建了索引却没命中,多半是查询写法让索引失效,比如对字段套了函数、用了 != 或 LIKE '%xx' 左模糊。下面演示如何查看。
EXPLAIN SELECT id, title FROM articles
WHERE category_id = 5 AND status = 1
ORDER BY published_at DESC
LIMIT 20;
-- 关注 type / key / rows / Extra 四列
建索引或排查字段类型时,随时查 MySQL 速查手册,它把 EXPLAIN 各列取值和索引语法整理成了速查表,现场对照效率很高。
三、方向三:补齐缺失或设计不当的索引
索引是 MySQL 查询变慢的头号解药。常见错误是只在主键上加索引,却对 WHERE、JOIN、ORDER BY 用到的列视而不见。对于多条件查询,应结合最左前缀原则建立联合索引,并把区分度高的列放前面。例如按分类和状态筛选,再按时间排序,就适合建 (category_id, status, published_at) 这样的联合索引。
要注意索引不是越多越好:每个索引都会拖慢写入并占用空间。大表加索引建议在低峰期用 ALGORITHM=INPLACE 在线操作,避免锁表。另外,字段类型不一致(如字符串字段和整数比较)会导致索引失效,务必保持类型统一。下面给出建索引示例。
-- 为高频查询建立联合索引,覆盖 WHERE 与 ORDER BY
CREATE INDEX idx_cat_status_time
  ON articles (category_id, status, published_at);
-- 验证索引是否被使用
EXPLAIN SELECT * FROM articles
  WHERE category_id = 5 AND status = 1
  ORDER BY published_at DESC;
四、方向四:更新过期的表统计信息
有时索引建好了,MySQL 却仍然不选它,原因是统计信息(table statistics)过期了。MySQL 优化器依赖这些数字估算每个执行计划的成本,如果统计严重偏差,就可能误判而放弃索引。对 InnoDB 来说,stats 由采样得到,表经过大量增删改后容易失真。
解决方法是对相关表执行 ANALYZE TABLE,让优化器重新采样。相比 OPTIMIZE TABLE(会锁表并重建),ANALYZE 成本低得多,线上也能接受。如果问题依旧,可以检查 innodb_stats_persistent 与采样页参数,必要时提高采样精度。下面演示分析命令。
-- 重新采集统计信息,帮助优化器选对索引
ANALYZE TABLE articles;
-- 查看表的索引与基数(Cardinality)
SHOW INDEX FROM articles;
五、方向五:排查锁等待与长事务阻塞
最后一类慢,并非 SQL 本身差,而是被别的会话堵住了。InnoDB 中,一个未提交的长事务会一直持有行锁,后续写同一行的语句只能排队等待,表现就是"单条简单更新也卡好几秒"。此外,间隙锁、外键检查、甚至备份工具都可能成为阻塞源。
定位时查 information_schema 的锁相关视图,或新版 performance_schema 的 data_locks / data_lock_waits,找到阻塞源头的事务 ID 与 SQL,必要时 kill 掉长时间空闲的连接。日常要养成短事务习惯,别在事务里做 HTTP 调用等耗时操作。下面列出诊断语句。
-- 查看当前被阻塞的锁等待
SELECT * FROM performance_schema.data_lock_waits;
-- 查看活跃事务与其执行的 SQL
SELECT trx_id, trx_state, trx_query
FROM information_schema.innodb_trx
WHERE trx_state = 'RUNNING';
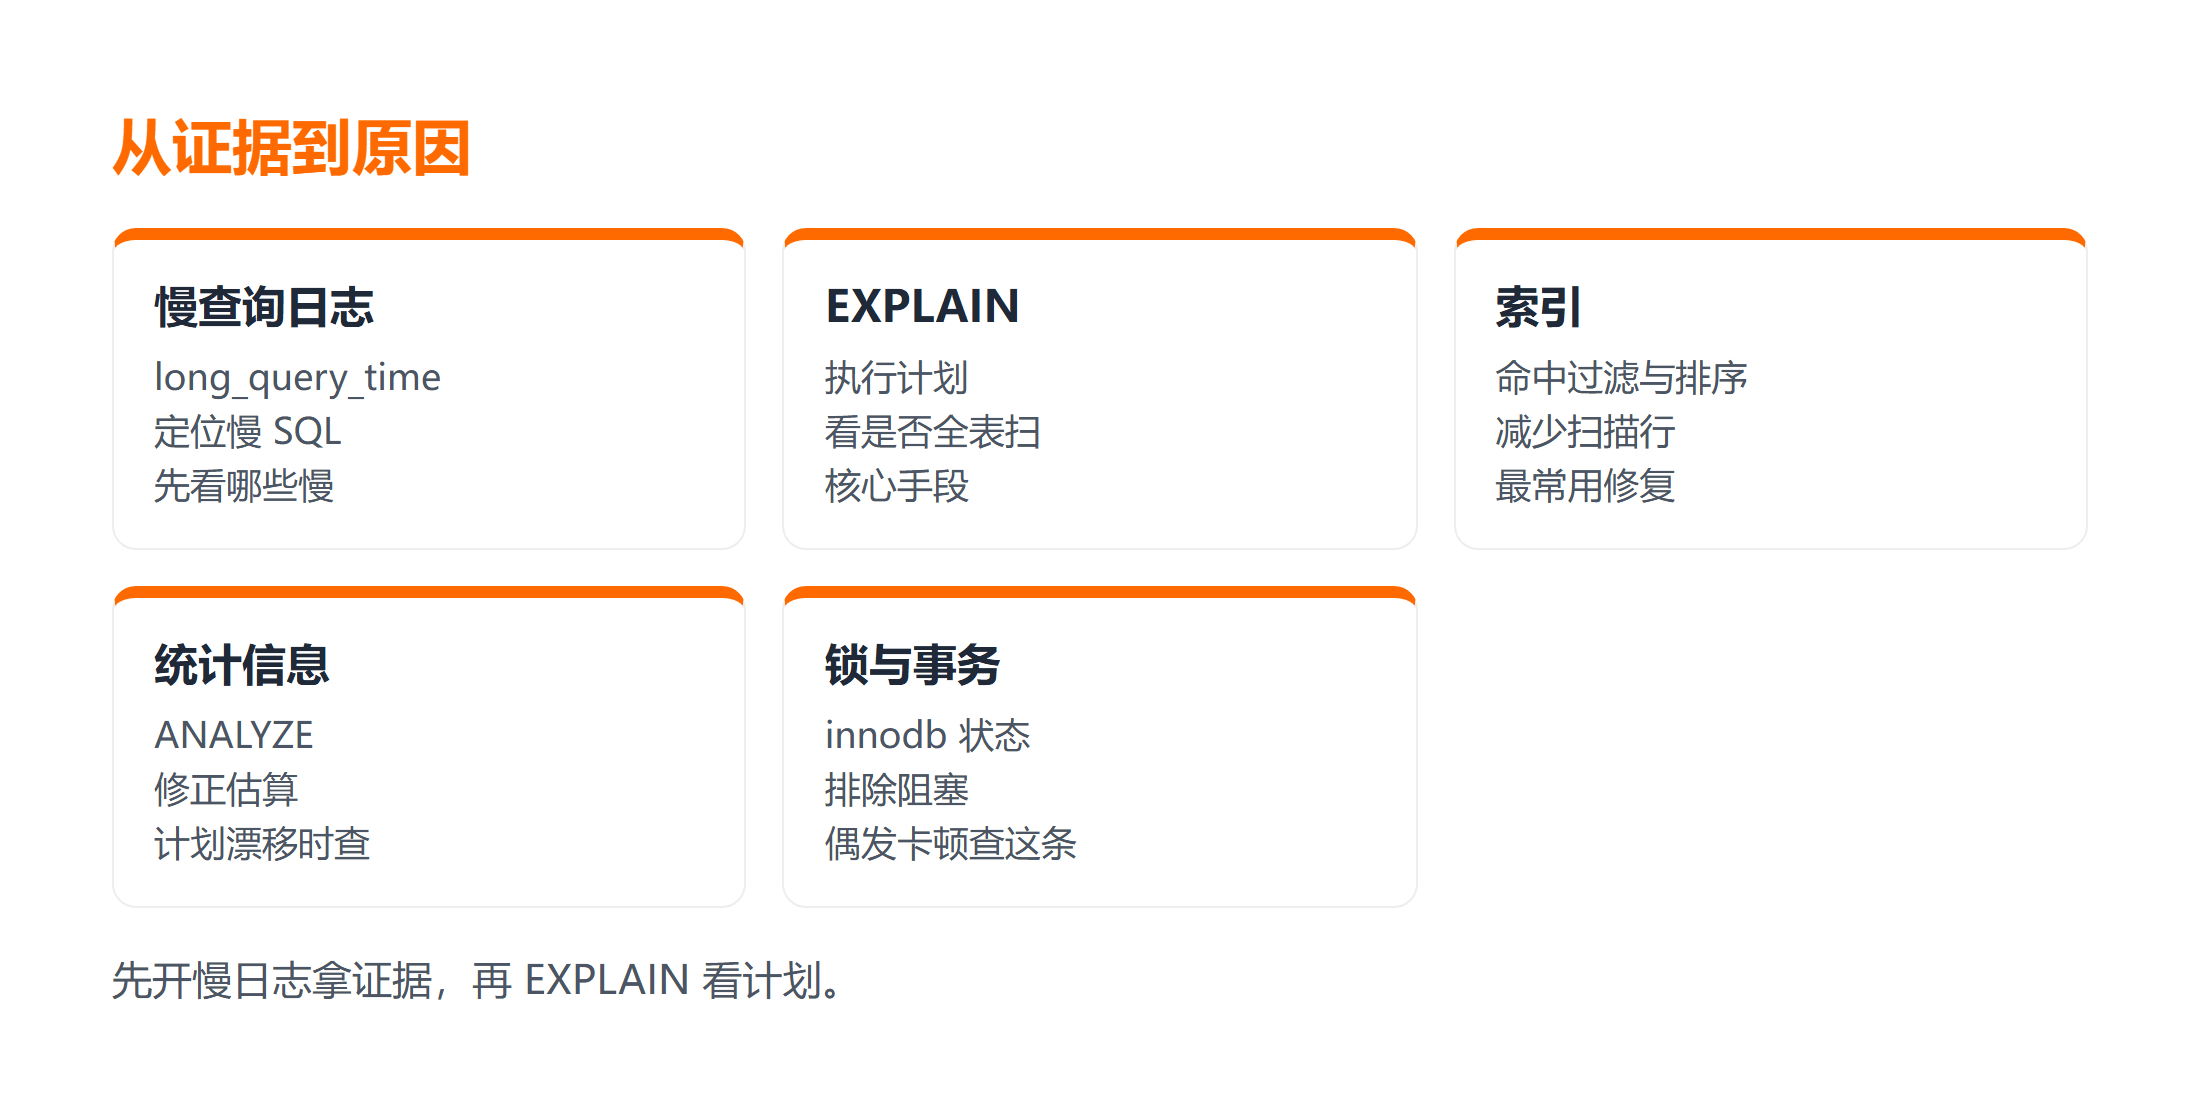
把上面五个方向落成一份可执行的排查清单,日常遇到慢查询时照着走就能少走弯路。第一步,先在配置里把 slow_query_log 打开并把 long_query_time 设小,运行几笔典型查询收集真实慢 SQL;第二步,用 EXPLAIN 对比有索引和无索引的执行计划,检查 type 是否从 ALL 变成 ref,验证索引是否真的命中。第三步,若统计过期就执行 ANALYZE TABLE 刷新,再确认优化器有没有改选。这套流程的边界在于:它解决的是「扫得多」和「等得久」,适用场景是单条 SQL 变慢,若是整库负载过高则要另看连接数与缓冲池。若某一步执行失败,比如索引建了却没生效,先检查字段类型与函数包裹,再用最左前缀规则修复联合索引,最后回到 EXPLAIN 验证效果是否符合预期。把清单固化成团队 SOP,遇到性能问题按顺序排查,比凭感觉改 SQL 稳妥得多。示例 SQL 按官方文档整理,可直接复用。
总结
MySQL 查询变慢从来不是玄学,而是一条可复现的排查链:先用慢日志定位,再用 EXPLAIN 看计划,缺索引就补,统计过期就 ANALYZE,被阻塞就查锁。把这五个方向记成 checklist,遇到性能问题按顺序走一遍,基本都能找到根因。记住,索引解决的是"扫得多",锁解决的是"等得久",两者机制不同要分开判断。这套思路也是编程狮性能优化专栏的标配方法。
延伸学习
- MySQL 入门课程 系统学 MySQL
- MySQL 表结构笔记 看表结构查看方法
- MySQL 教程 复习语法
常见问题
Q:EXPLAIN 里 type 是 ALL 一定有问题吗?
A:ALL 表示全表扫描,小表影响有限,但大表必须重视。先确认是否真有合适索引,再看查询写法是否让索引失效,比如对列使用函数或左模糊匹配。
Q:加了索引查询还是慢怎么办?
A:可能统计信息过期,执行 ANALYZE TABLE 刷新;也可能是被锁等待阻塞,或索引选择性太低。用 EXPLAIN 和锁视图分步确认,别盲目继续加索引。
Q:long_query_time 设多少合适?
A:核心业务建议 1 秒甚至 0.5 秒,把 borderline 慢查询也暴露出来;报表类长查询可放宽到 2 秒,避免日志被正常慢报表淹没而掩盖真正问题。