
 TRAE-AI编程

Redis 缓存穿透是指查询一个根本不存在的数据,缓存层永远不命中,请求每次都直接打到数据库,等于缓存形同虚设。它的核心危害不是单次查询慢,而是大量这种请求会瞬间压垮后端数据库。本文先把缓存穿透和普通缓存未命中区分开,再依次讲清三种主流做法——缓存空值、布隆过滤器、互斥锁——分别怎么写、各自适合什么场景,最后给出一张选型对照表,帮你按业务体量做取舍。无论你是刚接触 Redis 的新手,还是已经在生产环境踩过坑,都能照着落地。
一、先确认:缓存穿透到底发生在哪一步
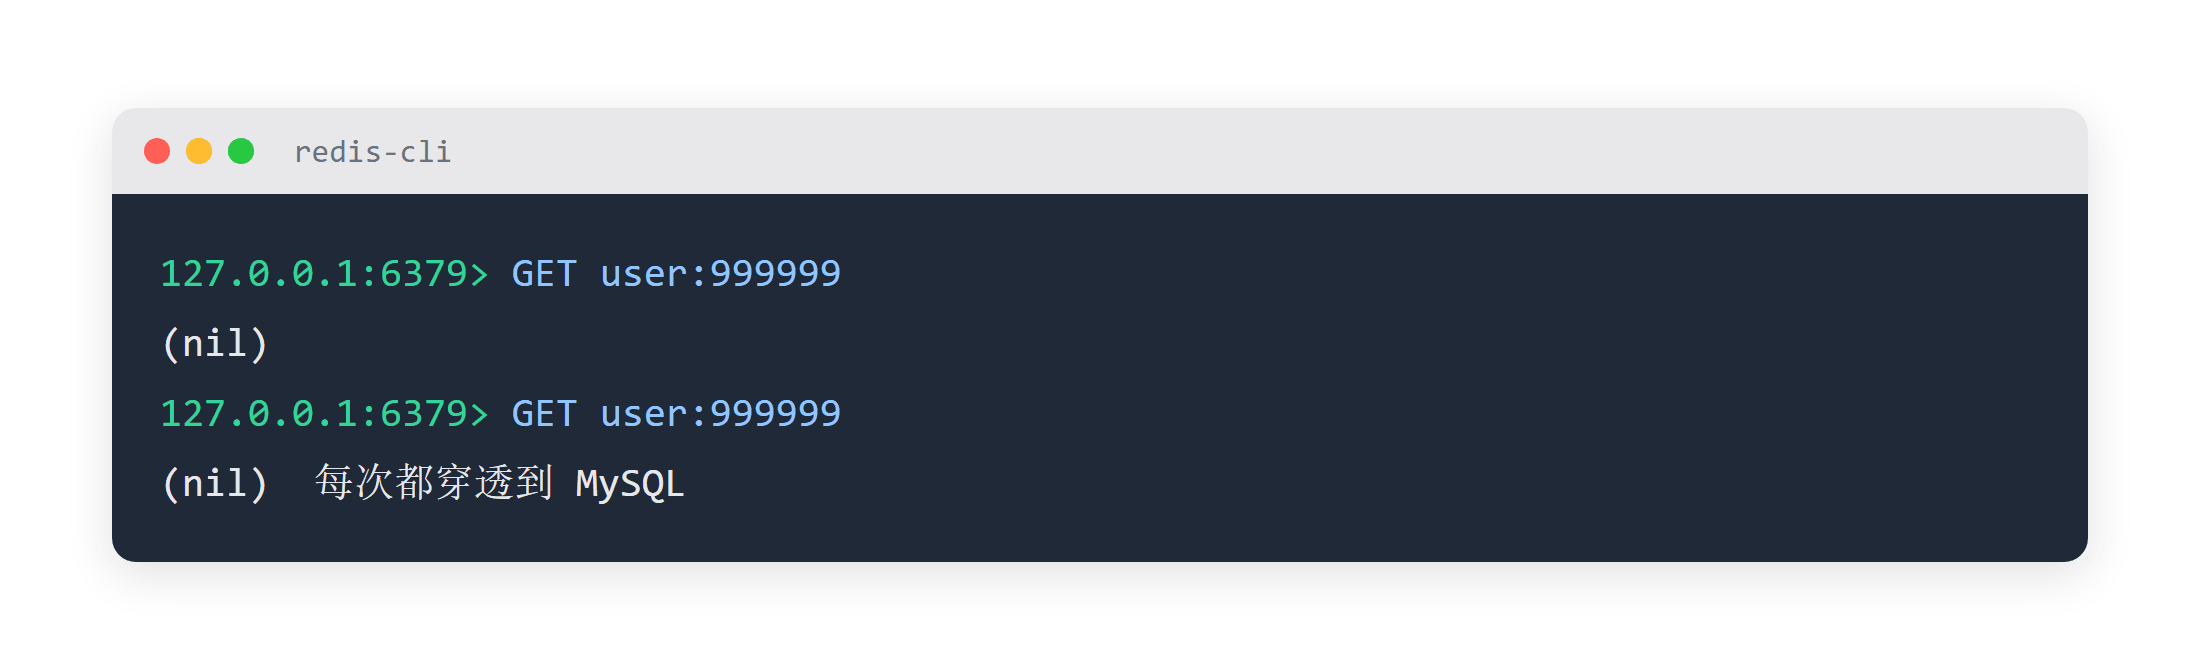
要防住 Redis 缓存穿透,第一步是看清它和普通「缓存未命中」不是一回事。在系统引入 Redis 教程 这类缓存后,正常的缓存未命中,是 key 存在、只是还没预热或已过期,回源查一次数据库、再写回缓存,后续请求就能命中。而缓存穿透的 key 在数据库里也根本不存在:缓存里没有,数据库里也没有,于是每一次请求都完整地走完「查缓存 → 未命中 → 查库 → 无结果」这一整条链路,缓存永远帮不上忙。
它最危险的地方在于可被放大。假设有人用一个随机生成的、库里肯定没有的 ID 高频请求你的接口,那么这些流量会全部穿透缓存、直接落到 MySQL 上。在 Redis 详解 的架构里,Redis 本来是替数据库挡枪的第一道防线,一旦这道墙被穿透,数据库就会在毫无缓冲的情况下承接全部压力,轻则响应变慢,重则连接数打满、服务雪崩。所以判断是不是穿透,关键看两点:这个 key 是否「注定查不到」,以及请求是否「高并发且持续」。两者同时成立,就是典型的缓存穿透场景,必须针对性治理,而不是简单地加机器。
二、最易上手:缓存空值怎么写
针对 Redis 缓存穿透,第一种做法最简单,也最常被优先采用,就是「缓存空值(Cache Null)」:当数据库返回空结果时,我们仍然往 Redis 里写一个代表「空」的值,并给它一个较短的过期时间。这样下次同一个不存在的 key 再来,会直接在缓存层命中这个空值,不再回源数据库。它改造量极小,几乎不引入新组件,是新手防穿透的第一道保险。
写法上注意两点。第一,空值不要用业务里可能出现的真实数据来表示,比如用空字符串要谨慎,最好用一个专门的占位符,避免和正常的空结果混淆。第二,TTL 一定要短,因为被缓存的空值对应的数据以后可能被补建,TTL 太长会导致数据不一致。下面的 Redis 命令演示了给一个不存在的用户缓存一个空占位、并只保留 60 秒:
# 数据库查无此用户,写入空占位并设置短 TTL
SET user:999999 "(nil)" EX 60
# 60 秒内再次查询,命中空值,不再访问数据库
GET user:999999
缓存空值的优点是改动小、逻辑直观;缺点是如果攻击者用海量不同的不存在 key 来打,Redis 里会堆满大量空占位,反而吃掉内存。因此通常会配合一个较短的 TTL,比如 30 到 60 秒,让这些空值尽快过期。它适合key 空间有限、且空命中比例可控的场景,是大多数中小项目的首选方案。
三、更省内存:布隆过滤器怎么接进 Redis
针对 Redis 缓存穿透,第二种做法用布隆过滤器(Bloom Filter)在缓存之前再加一道闸。布隆过滤器是一个空间效率极高的概率型数据结构,它用一个位数组记录「哪些 key 可能存在」。查询时,如果过滤器说「这个 key 不存在」,那就一定不存在,可以直接拒绝,根本不会去查 Redis 或数据库;如果它说「可能存在」,才继续往下走。这种「宁可错杀、绝不漏放不存在的 key」的特性,正好克制缓存穿透。
接入时常见两种形态。一种是把布隆过滤器作为独立服务,在请求进入时先过一遍;另一种如 Colly Examples REDIS Backend 这类把 Redis 当作后端存储的框架,也会用类似思路在入口层拦截无效 key。下面是一个用 Python 的 pybloom 库维护用户 ID 过滤器的简单示例:
from pybloom_live import ScalableBloomFilter

# 初始化一个可扩容的布隆过滤器,装入全部合法用户 ID
bf = ScalableBloomFilter(initial_capacity=100000, error_rate=0.001)
for uid in load_all_valid_user_ids():
    bf.add(uid)

def handle_request(uid):
    # 过滤器判定不存在,直接拒绝,不再访问 Redis 与数据库
    if uid not in bf:
        return None
    return query_from_cache_or_db(uid)
布隆过滤器的优点是占用内存极小,能挡住海量不存在的 key,还不会像空值缓存那样堆积数据。代价是它有「误判率」:可能把存在的 key 误判为不存在,需要业务能接受偶尔的误杀;而且过滤器必须提前把合法 key 全部预热进去,新增数据时要同步维护。它适合 key 总量大、且可以接受极低误判率的场景。
四、三种做法的取舍与选型建议
治理 Redis 缓存穿透时,前面两种解决「查不到」的问题,第三种做法——互斥锁,则更多用于「热点 key 失效瞬间大量回源」的并发击穿场景,但思路和穿透治理相通,也常被一起讨论。它的做法是:当缓存未命中时,用分布式锁保证只有一个线程去查数据库并回写缓存,其余线程等待结果,避免同一时刻几百个请求一起击穿到库。和穿透最直接的关联是:它能在缓存层失效的瞬间保护数据库,是空值缓存和布隆过滤器之外的兜底手段。
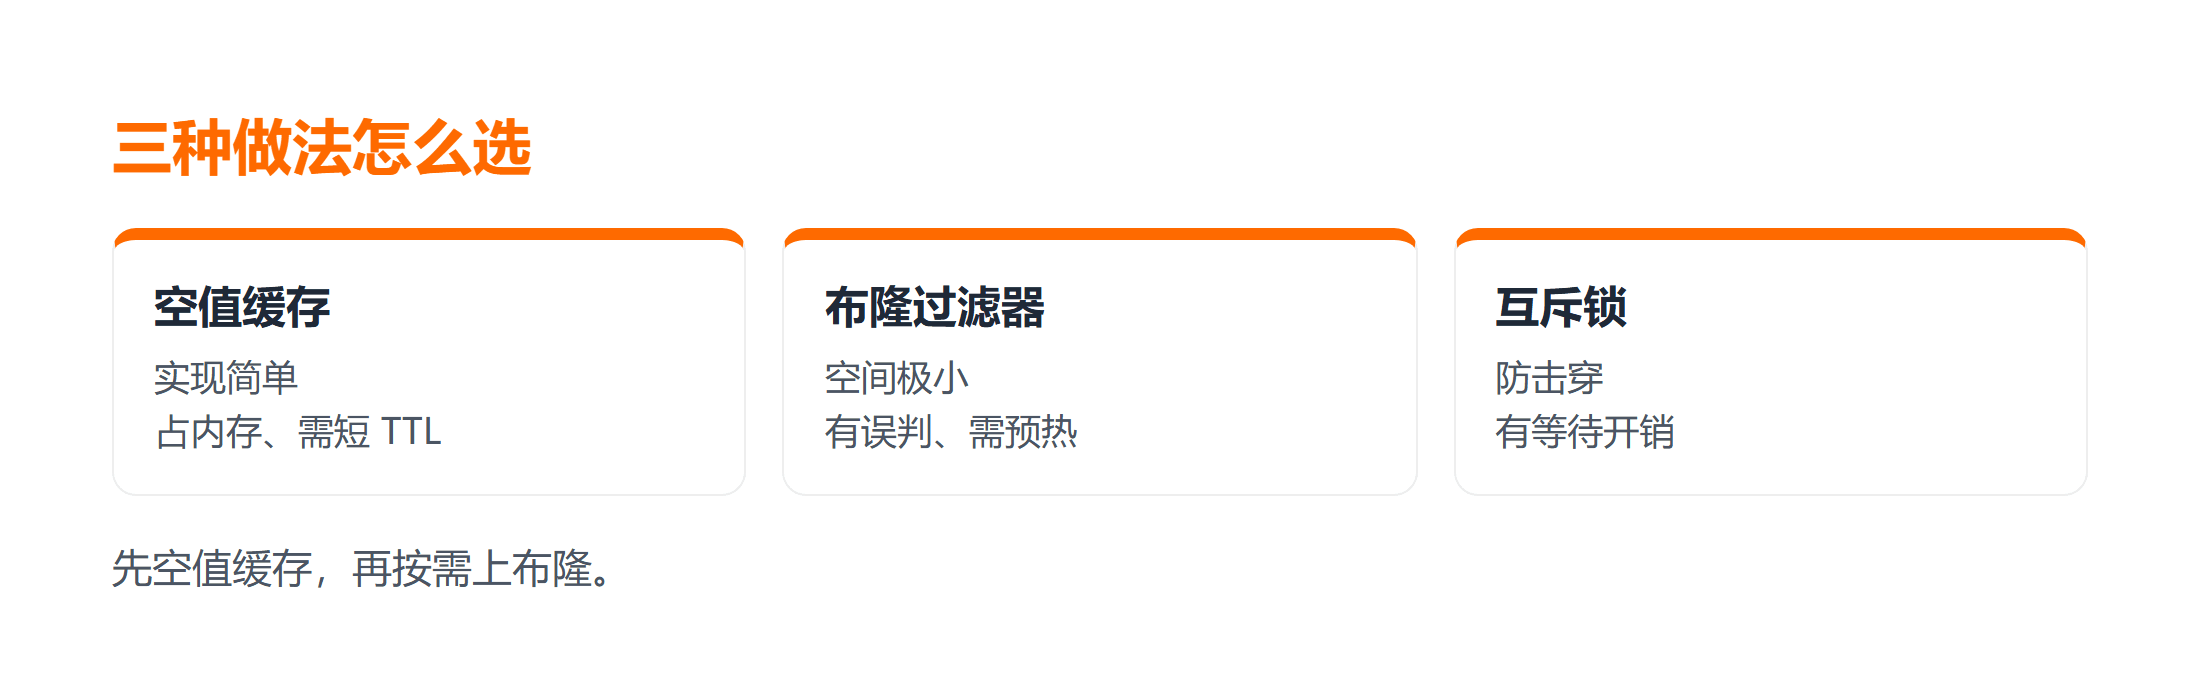
那么三种做法怎么选?可以照下面这张对照表来定:
- 中小项目、key 空间有限、想最快上线:优先「缓存空值」,改动最小,注意给空值设短 TTL。
- key 总量巨大、攻击面宽、能接受极低误判:上「布隆过滤器」,内存最省,但要解决预热与维护。
- 存在热点 key、且担心并发击穿:在回源处加「互斥锁」,保护数据库不被瞬时流量冲垮。
实际生产里,缓存空值 + 布隆过滤器组合最为常见:布隆过滤器拦掉绝大多数无效 key,少量漏网的空命中由短 TTL 的空值兜底。当某个热点 key 突然失效时,互斥锁再补一刀。三类做法并不互斥,而是按风险分层叠加。无论选哪种,回源数据库(例如 MySQL 教程 所讲的存储层)始终是最后一道防线,治理的目标就是尽量不让它裸奔承接穿透流量。
五、动手落地与排错:边界、版本与性能
前置(前置条件):动手前先确认你的场景确实属于缓存穿透——key 注定查不到且请求高并发。单实例、流量小的情况下,先上缓存空值即可,别一上来就引入布隆过滤器。环境上准备好 Redis 与可回源的数据层。
操作(操作步骤):给查库无结果的 key 写一个带短 TTL 的空占位(如 SET user:999999 "(nil)" EX 60);当 key 量级巨大时,再接入布隆过滤器预热全部合法 ID。
验证(验证生效):用库里肯定不存在的 ID 高频请求接口,观察并对比数据库 QPS,预期它不再随请求线性上涨,说明 Redis 缓存穿透已被拦在缓存层。落地后检查缓存命中率是否回升,并给空值配置一个 30 到 60 秒的短 TTL,避免空占位长期堆积吃内存。
失败处理与边界:若布隆过滤器误杀合法请求,把 error_rate 调低到 0.001 即可;注意 Redis 6 以前需借助 RedisBloom 模块才支持原生布隆结构,老版本要确认模块已加载。性能上,布隆过滤器每次查询是 O(k) 的位运算,远比空值缓存堆内存轻,但空值缓存胜在零新组件、改动最小。这三类做法按风险分层叠加,比盲目堆组件更有效。
总结
Redis 缓存穿透的本质是「查不到的 key 持续打到数据库」,它和普通缓存未命中最大的区别是 key 注定不存在、且请求往往高并发。治理上主流有三招:缓存空值改动最小、适合中小项目但要给空值设短 TTL;布隆过滤器内存最省、能挡海量无效 key,但要解决预热与极低误判;互斥锁则用于热点失效瞬间的并发击穿兜底。三者并不冲突,生产环境常以「布隆过滤器 + 缓存空值」组合打底,必要时再叠加互斥锁,始终把数据库留在最后一道防线之后。先判断自己的 key 空间和流量形态,再按上表选型,比盲目堆组件更有效。
常见问题
Q:缓存穿透和缓存击穿是一回事吗?
A:不是。穿透是查询「根本不存在」的 key,缓存和数据库都没有;击穿是某个「真实存在且是热点」的 key 突然失效,瞬时大量请求打到数据库。前者靠空值缓存或布隆过滤器拦截无效 key,后者靠互斥锁或逻辑过期保护回源,治理侧重点不同。
Q:布隆过滤器误判了怎么办?
A:布隆过滤器只会「把存在的误判为不存在」,不会把不存在的误判为存在,所以误判的后果是偶发地多查一次数据库或拒绝一次合法请求。把误判率调低(如 0.001)即可把影响降到极低,业务上通常可以接受,不必过度担心。
Q:小项目直接用哪种最省事?
A:直接上「缓存空值」最省事,改动只有几行:查库无结果时写一个带短 TTL 的占位即可。等流量和攻击面变大、发现空值堆积吃内存时,再引入布隆过滤器做升级,不必一开始就上复杂方案。



