 TRAE-AI编程

注意力机制是 Transformer 里让每个词都能直接参考句中其他词的一种加权计算;它用查询、键、值三组向量衡量词与词的相关度,再据此把信息汇聚到当前词上。你在读长句子时常遇到这样的困惑:模型怎么知道“它”指代谁、怎么理解一词多义。本文用初学者能跟上的方式,讲清注意力到底是什么、QKV 三步怎么算、多头为什么更强,并和 RNN、CNN 对比它好在哪、落地时容易踩哪些坑。看完你能判断自己项目该不该上 Transformer,以及第一步从哪里下手。今天这篇文章,编程狮就把这块讲透。
一、注意力机制到底是什么
用一句判断句给定义:注意力机制是一种让序列中每个位置都能按相关度直接“看”到其他位置,并据此汇总信息的计算方式,它取代了 RNN 那种必须按顺序传递隐藏态的做法。
打个比方,就像你读“小明把书给了小红,她很开心”这句话时,大脑会自动把“她”和“小红”连起来。注意力做的也是这件事:给每个词算一个“和谁最相关”的权重,再按权重把含义融进当前词。
1.1 触发条件
当任务依赖长距离依赖、一词多义或全局上下文时,注意力最值得考虑。典型场景是机器翻译、长文档理解和问答,这些任务里关键信息往往隔了很多个词。
⚠️ 注意:注意力不是“越算越好”。它和词序位置编码是配合使用的,丢掉位置信息,模型会分不清“猫追狗”和“狗追猫”。想补齐 AI 基础,可先过一遍 人工智能教程。
1.2 常见误解
有人认为“注意力就是让模型关注重点词”。其实关键在于相关度是动态算出来的:同一个词在不同句子里,关注的邻居不一样。这也是它和固定卷积核的区别,卷积核的权重是固定的,而注意力的权重随输入内容变化。
二、QKV 三步怎么算(最小示例)
下面用伪代码展示一次自注意力的核心计算。这段代码演示的是把查询、键、值三组向量做缩放点积,再按权重汇聚值。
import torch, torch.nn as nn

x = torch.randn(1, 6, 64)          # 6 个词,每个 64 维
q = nn.Linear(64, 64)(x)           # 查询
k = nn.Linear(64, 64)(x)           # 键
v = nn.Linear(64, 64)(x)           # 值
scores = q @ k.transpose(-2, -1)   # 两两相关度
weights = nn.Softmax(dim=-1)(scores / 64 ** 0.5)  # 缩放并归一化
out = weights @ v                  # 按权重汇聚值
上面这段做的是把每个词对其它词的匹配分数归一化成权重,再用它把值向量加权求和。预期结果(未在本机执行,依据公开论文与官方文档)是 out 的第 i 行,主要是和 x[i] 相关的那些词的值混合而成,模型由此拿到上下文感知的表示。
💡 小提示:缩放因子用键维度开根号,是为了防止维度变大时点积数值过大、softmax 梯度消失;这是 Transformer 原始论文的稳妥做法。
三、多头注意力为什么更强
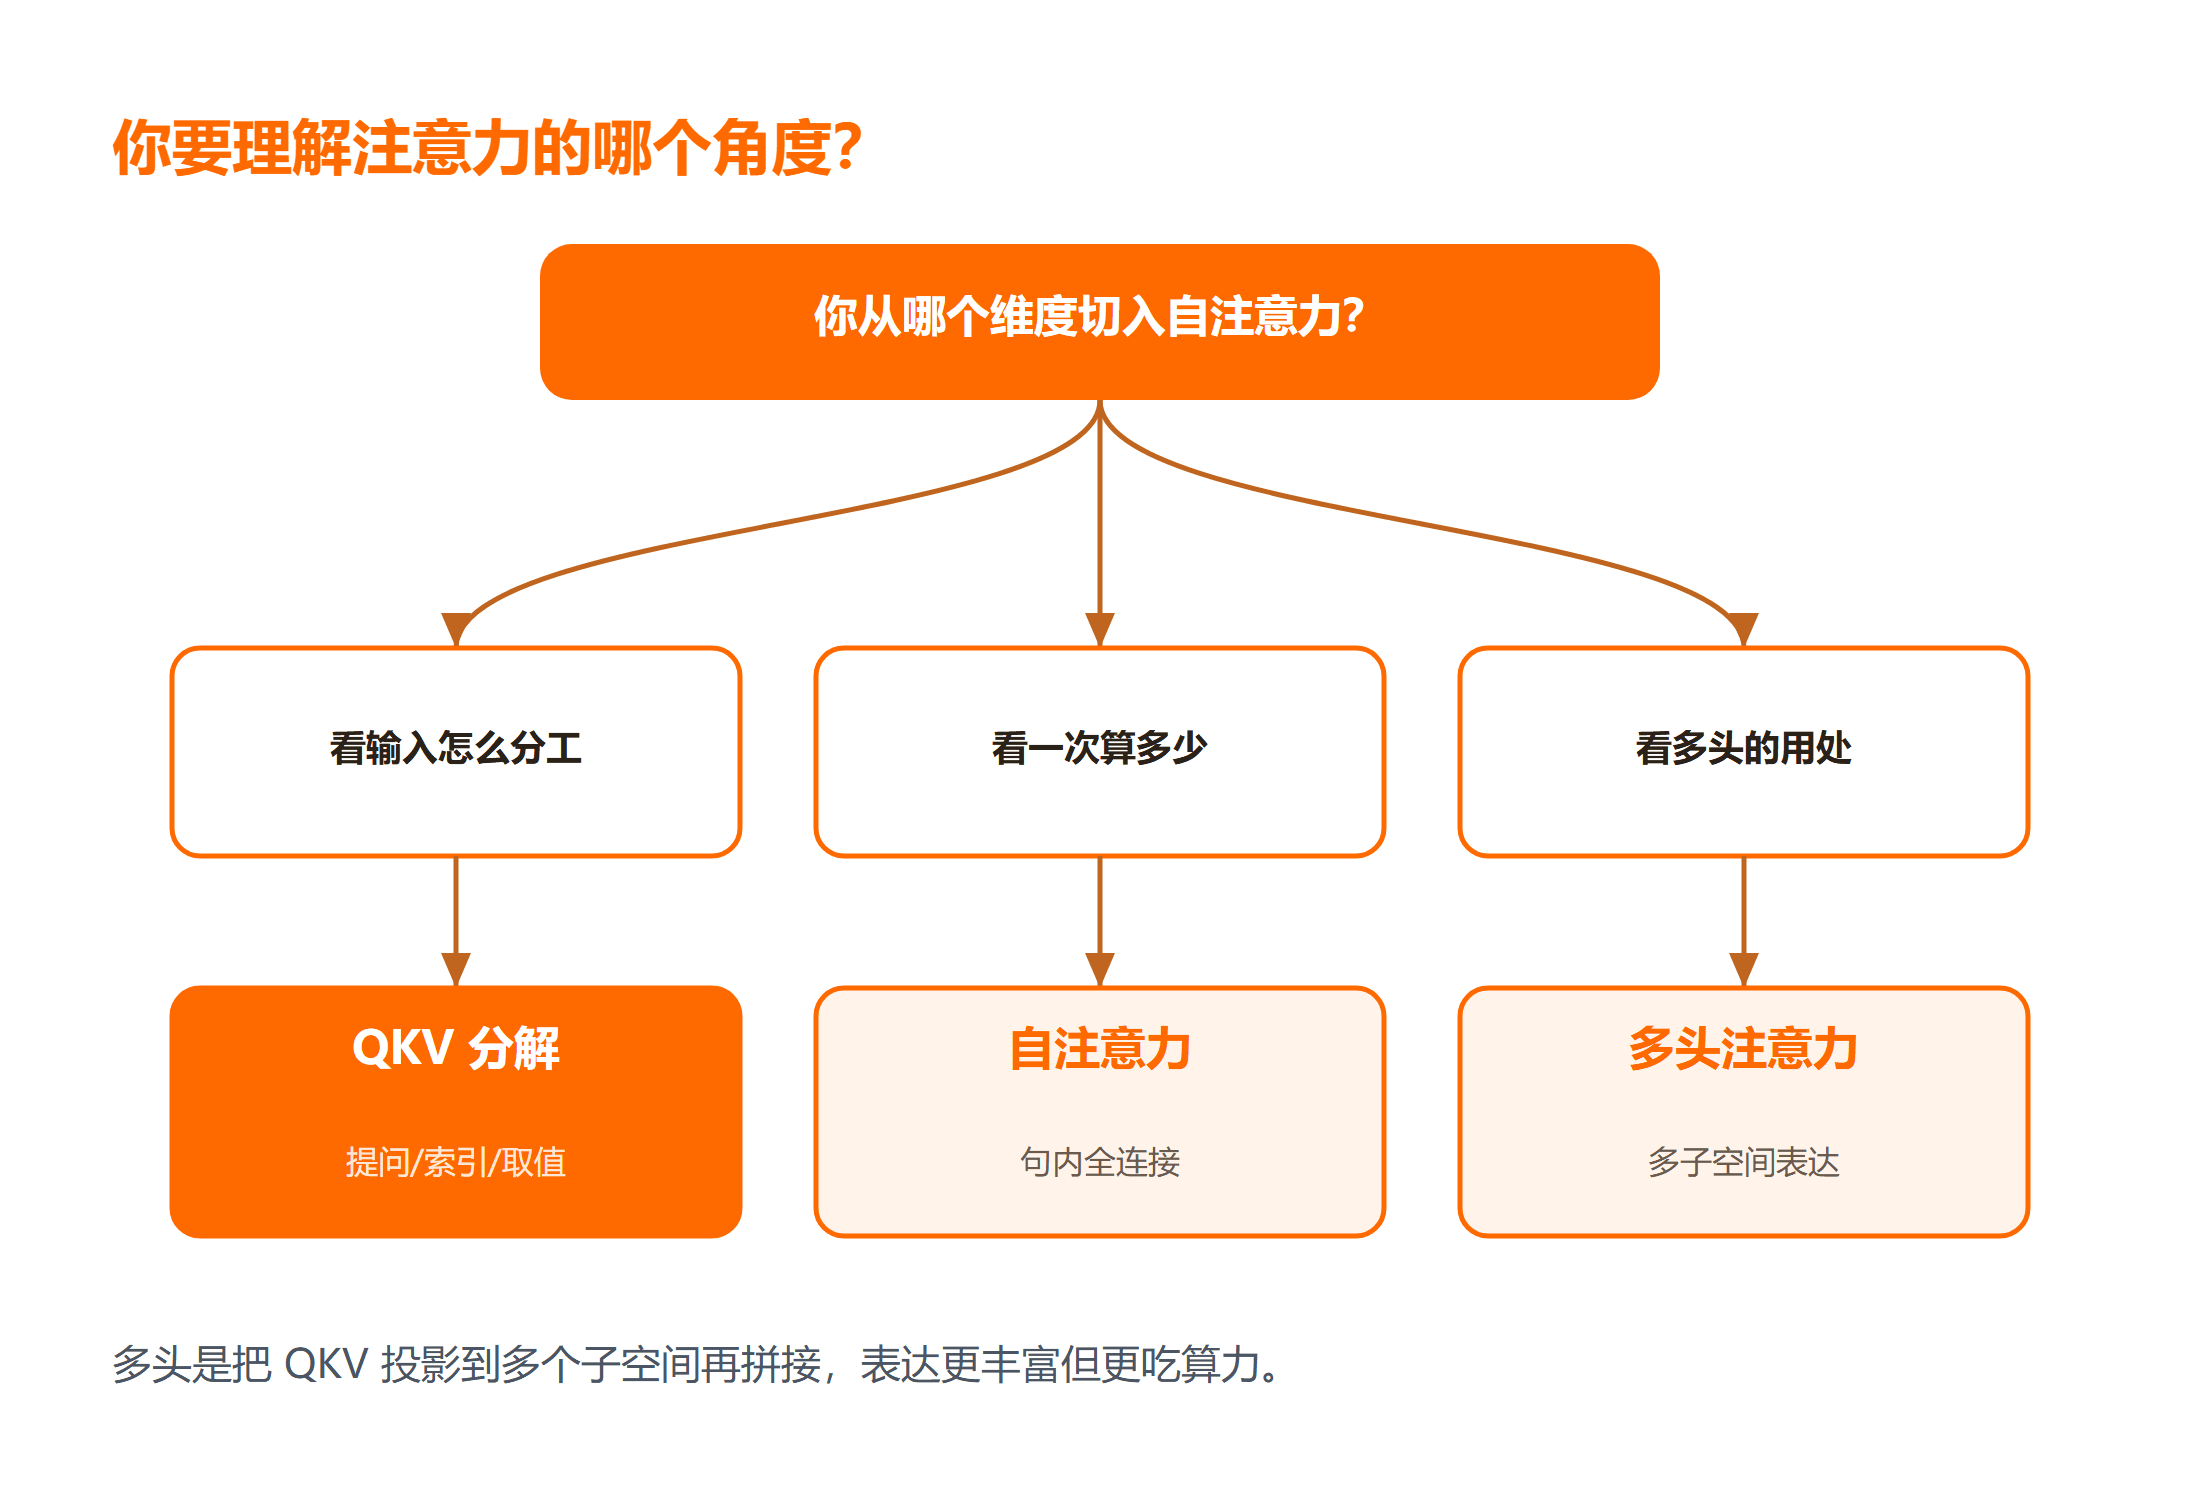
单头注意力只能学到一种“关注模式”,比如只关注语法相邻。多头把向量拆成若干组,每组独立算注意力,再拼起来,等于让模型同时关注不同角度的关系。
3.1 版本与适用边界
原始 Transformer 用 8 头常见;小模型会降到 4 头或 2 头以省算力。适用边界是:头数越多表达越丰富,但显存和算力线性上涨,移动端要谨慎。
3.2 失败的表现
失败通常有两种:一是位置编码没接好,模型把词序搞乱;二是头数过多但数据量不够,部分头学成冗余。两者都要靠验证集上的下游任务指标来发现,不能只看损失下降。
四、它比 RNN 和 CNN 好在哪
和 RNN 比,注意力能一步看到任意远距离的词,不用一步步传递,因此训练可并行、长程依赖更强;和 CNN 比,它对不定长全局关系更友好,不用堆很多层卷积。
| 对比项 | RNN | CNN | 自注意力 |
|---|---|---|---|
| 并行能力 | 弱(要顺序) | 较强 | 强 |
| 长程依赖 | 易遗忘 | 需堆层 | 一步直达 |
| 计算开销 | 低 | 中 | 高(平方级) |
⚠️ 边界提醒:自注意力的计算和序列长度的平方相关,超长文本要配稀疏注意力或分块,否则显存会爆。性能上它更强,但代价是更吃资源。想更系统地看模型结构演进,可参考 神经网络类型。
五、落地时容易踩的坑
- 现象:换词序后意思变了。原因:位置编码缺失或没生效。修复:确认输入拼接了位置编码,再在小数据集上验证词序敏感任务。
- 现象:显存溢出。原因:序列太长、头数太多。修复:先降头数或切分长序列,用梯度检查点兜底。
- 现象:多个头学到的内容雷同。原因:初始化或数据单一。修复:检查数据多样性,必要时用不同的初始化尺度。
# 用现成层快速搭一个多头注意力(片段,非完整脚本)
layer = nn.MultiheadAttention(embed_dim=64, num_heads=8, batch_first=True)
out, attn = layer(x, x, x)   # 自注意力:QKV 都来自 x
# 预期 out 形状 (1, 6, 64),attn 是 8 头各自的权重(未在本机执行)
总结
注意力机制是用查询、键、值三组向量按相关度汇聚上下文的计算方式,让每个词都能直接参考句中任意位置。落地记住三点:缩放点积防止梯度消失,根号 d 不能省;多头让模型同时看多种关系,但头数受算力约束;长序列要配稀疏或分块,避免平方级开销。想理解 AI 基础概念,可补 AI 术语翻译笔记。
要点带走:
- 注意力的核心是动态相关度,同一个词在不同上下文关注点不同;
- 缩放因子用维度开根号,是训练稳定的关键;
- 它强在并行与长程依赖,代价是计算和序列长度的平方相关。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何调用模型;
- 想理解 AI 基础,读 AI 核心概念笔记;
- 动手前补 AI Python 课程 了解工程实现。
常见问题
Q:注意力和自注意力是一回事吗?
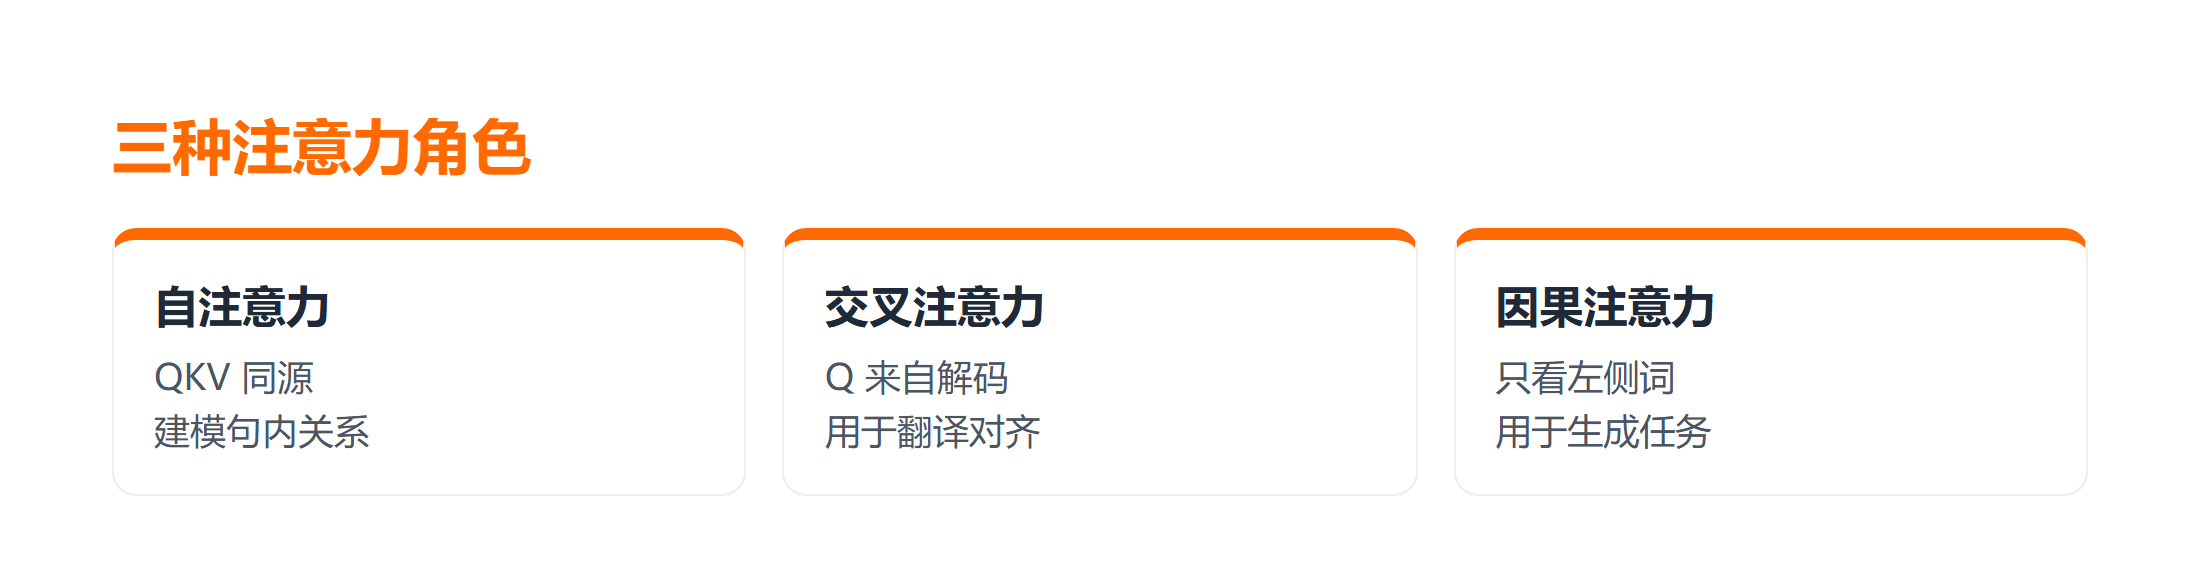
A:不是。自注意力是注意力的一种特例,查询、键、值都来自同一序列;而交叉注意力里查询来自一个序列、键值来自另一个(典型用于翻译的解码器看编码器)。两者共用同一套 QKV 计算,只是来源不同。
Q:没有位置编码会怎样?
A:模型会变成“词袋”,分不清词序。比如“猫追狗”和“狗追猫”在它眼里没有区别,因为注意力本身对排列不变。位置编码正是为了把顺序信息补回表示里。
Q:序列太长一定会显存爆吗?
A:不一定。原生自注意力的复杂度随长度平方增长,所以超长文本确实危险;但可以用稀疏注意力、分块窗口或线性注意力把复杂度压下来,很多长文本模型正是这么做的。