
 TRAE-AI编程

Netty 的高吞吐很大程度来自它对 JIT 编译的“友好设计”:同样的业务逻辑,写法不同,JIT 编译出的机器码效率能差出数倍。本文讲清 Netty 里几类帮助 JIT 编译优化的做法——对象池、具体类代替接口、热点方法内联、直接内存——以及各自的代价,帮你理解为什么 Netty 的代码看起来“绕”,却跑得飞快。读懂这套设计,你在写高频 IO 代码时也能少踩坑,而不是盲目照搬网上的“性能秘籍”导致越优化越慢。
先看结论
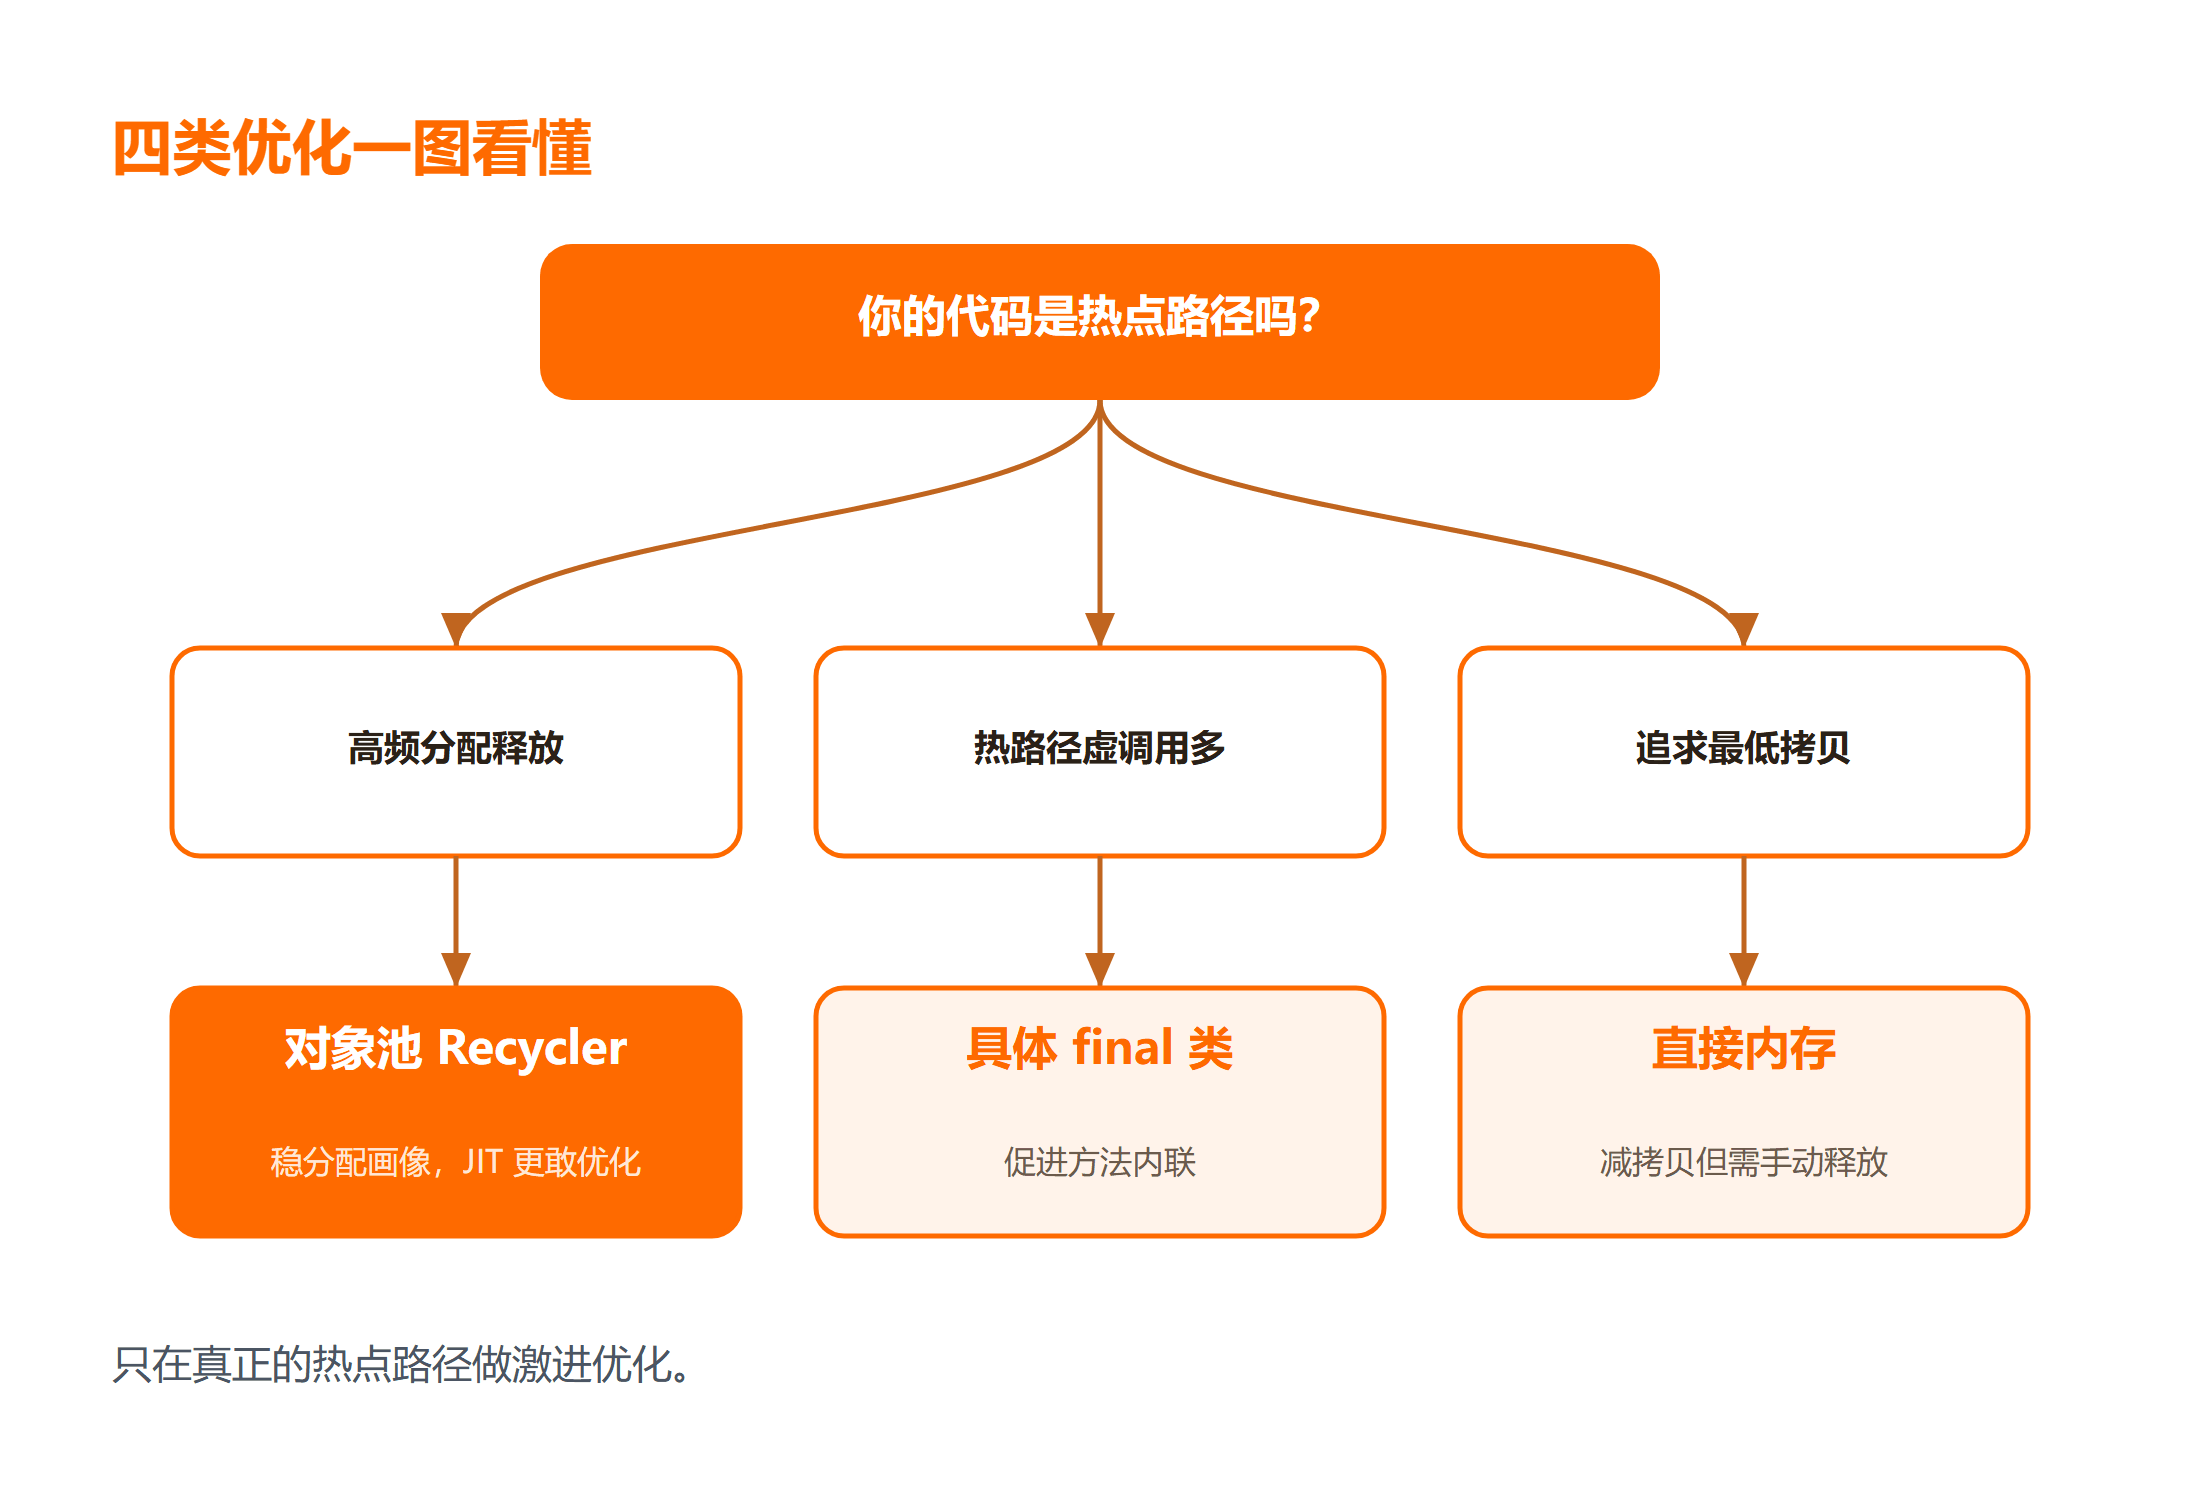
Netty 对 JIT 编译的优化可以归为四类:一是用对象池(Recycler)复用 ByteBuf,稳定分配画像让 JIT 更敢优化;二是热路径上用具体 final 类而非接口,减少虚方法调用,方便方法内联;三是把热点代码写成紧凑循环,减少分支与边界检查;四是优先直接内存,降低拷贝次数。取舍的核心:池化和直接内存换来了吞吐,代价是更高的实现复杂度和更高的出错概率。
一、最小场景与前置准备
前置只需理解两个概念:JIT 会把反复执行的热点代码从字节码编译成机器码,并对热点方法进行内联;而虚方法调用、频繁分配对象会阻碍这种优化。如果你对 Netty 整体结构还不熟,可以先看 Netty4Userguide 教程 把 Channel、ByteBuf 的关系理顺,再回来理解下面的 Netty 优化点,避免只记写法不记代价。
下面是一段热路径上常见的写整数代码,JIT 会反复编译它:
// 写 int 到缓冲,Netty 在底层用 Unsafe 一次性 put,便于内联
buffer.writeInt(value);
这段看似普通的方法,在被频繁调用后会成为热点代码,JIT 编译它时把它和下游的 Unsafe.putInt 内联到一起,省掉一次方法调用。理解这一点,才能看懂后面几类“绕”写法的动机。
二、做法一:对象池稳定分配画像
第一类优化是对象池。Netty 用 Recycler 复用 ByteBuf 对象,避免每次读写都 new。它的价值不只是省 GC,更在于让 JVM 的分配画像长期稳定:同一类型的对象总是从同一处分配,JIT 编译器和 GC 都能据此做更激进的优化,热点代码的性能抖动更小。
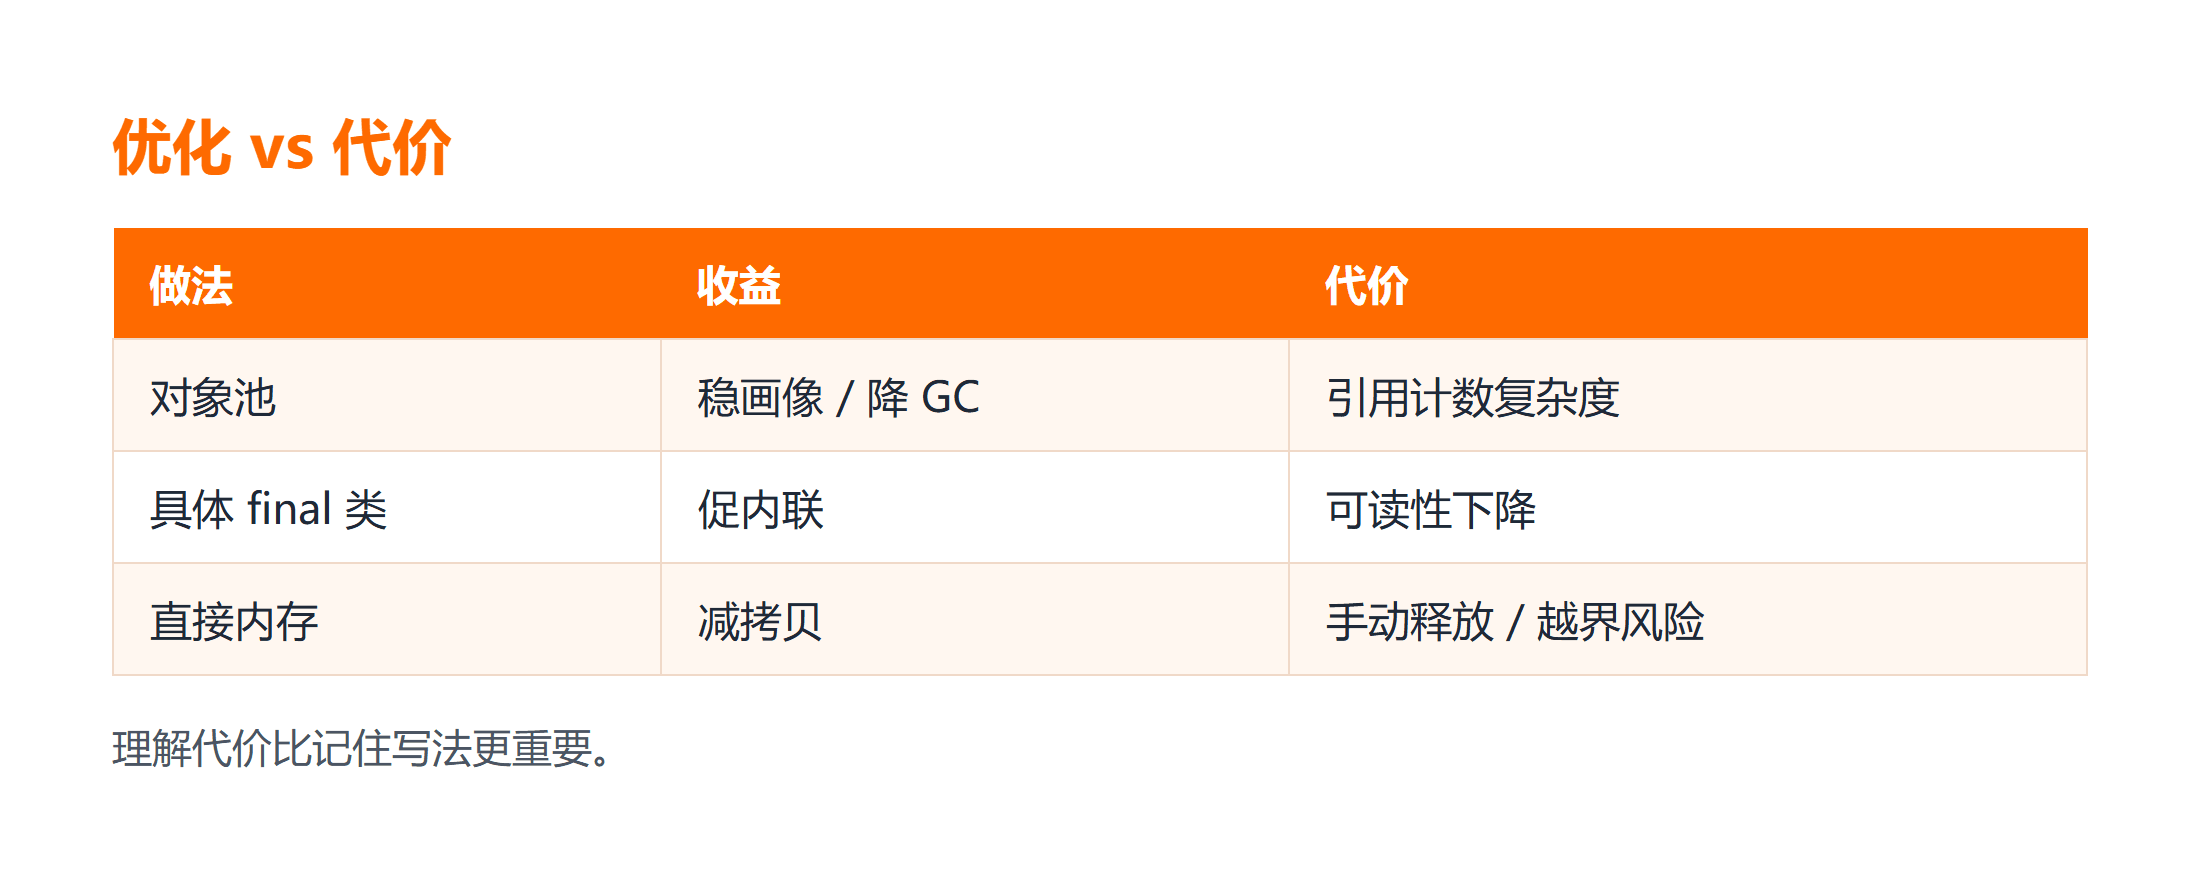
做法一的边界是:池化对象必须正确归还,忘记 release 会泄漏,重复 release 会炸。性能取舍在于池化减少了分配,但引入引用计数这套状态机,代码复杂度明显上升。验证方法:在压测下对比池化与非池化 ByteBuf 的 GC 次数,预期池化后 Young GC 频率明显下降。未在本机执行,上述为 Netty 官方文档描述的预期行为。
三、做法二:具体类代替接口促进内联
第二类优化是减少虚方法调用。ByteBuf 有一堆实现类,但 Netty 在热路径上常用 PooledUnsafeDirectByteBuf 这类具体 final 类,而不是泛泛地走 ByteBuf 接口。JIT 编译看到调用目标是确定的具体方法,就能放心做方法内联,把多层调用拍平。
做法二的代价是代码可读性下降,抽象层变薄。另一类失败是误用接口类型兜住所有情况,导致 JIT 编译不敢内联、频繁做虚方法表查找。判断是否值得,看这段代码是不是真正的热点:只在每秒几十万次的读写路径上才需要这么“绕”,普通业务代码不必照搬。
四、做法三:直接内存与紧凑循环,并做正确性校验
第三类优化是优先直接内存(DirectByteBuf)和紧凑循环。直接内存绕开了堆内拷贝,读写时 JIT 编译生成的机器码更少,但也意味着不受 GC 自动管理,释放要靠引用计数。理解直接内存与堆内内存的差异,可以对照 Java 速查手册 里 JVM 内存模型一节,明确哪些区域受 GC 管理、哪些需要手动释放。典型的失败是跨线程持有时计数错乱,表现为零星却又致命的内存问题。
正确性校验很关键:在写入后立刻读取回环验证,确保写入的字节和读出的字节一致;对直接内存访问加长度边界判断,避免越界。另一类失败是和 JDK 版本耦合,某些 Unsafe 调用在新版本被限制,升级 JDK 后要重新跑回归。Netty 的版本差异在于:不同小版本对 Unsafe 的封装层可能调整,升级时要核对迁移说明,避免原本顺畅的 JIT 友好写法在新版本行为变化。
从可复现角度补一步:先 安装 并 配置 好 JDK 与 Netty 依赖, 运行 一段读写压测,用监控 检查 GC 频率与吞吐;预期池化后 Young GC 明显下降,若 失败 则 修复 对象归还逻辑,重新 验证 直到指标达标。把安装、配置、运行、检查、修复、验证固化,优化才有对照基准。
动手核对清单
- 安装:确认 JDK 与 Netty 依赖已安装就绪。
- 配置:在热路径使用具体 final 类与对象池。
- 运行:运行读写压测,观察吞吐与延迟。
- 检查:检查 GC 频率与内存是否泄漏。
- 预期:预期池化后 Young GC 频率明显下降。
- 失败:漏写 release 会泄漏,跨线程持有直接内存会错乱。
- 修复:补上归还逻辑后重新验证指标。
- 适用边界:只在真正的热点路径做激进优化。
总结
Netty 对 JIT 编译的优化不是某一项黑科技,而是“对象池稳画像、具体类促内联、直接内存减拷贝”这套组合拳。理解它们的代价比记住写法更重要:池化和直接内存带来吞吐,也带来引用计数的复杂度,只有在真正的热点路径上才值得付出这份代价。
常见问题
Q:为什么 Netty 不用接口抽象得更彻底?
答:因为热路径上接口会引入虚方法调用,阻碍 JIT 编译的方法内联。Netty 把抽象留在外围,把高频读写收敛到具体 final 类,用一点可读性换取显著的性能。
Q:对象池一定能提升性能吗?
答:不一定。对象池的价值在高频分配释放的场景最明显,低频场景反而增加引用计数的复杂度与出错面。先用压测确认分配是瓶颈,再决定是否池化。
Q:直接内存比堆内内存快在哪?
答:直接内存避免了从堆到内核缓冲的额外拷贝,JIT 编译生成的读写代码更短。代价是不受 GC 管理,必须手动释放,使用门槛更高。



