
 TRAE-AI编程

模糊匹配指的是用不完整的字符串去查出相近的结果,常见做法有 SQL 的 LIKE 语句、正则表达式和相似度算法三类。PHP 里最常用的是用 PDO 拼 LIKE 语句去查数据库,或者用 preg_match 做正则匹配,再进阶一点就用相似度算法做容错推荐。本文基于 PHP 8 验证,讲清三种做法的取舍、失败排查,以及什么时候该换方案。今天这篇文章,编程狮就把这块讲透。实际项目里,搜索框、自动补全和推荐位几乎都离不开它,花十分钟把它做对很值。
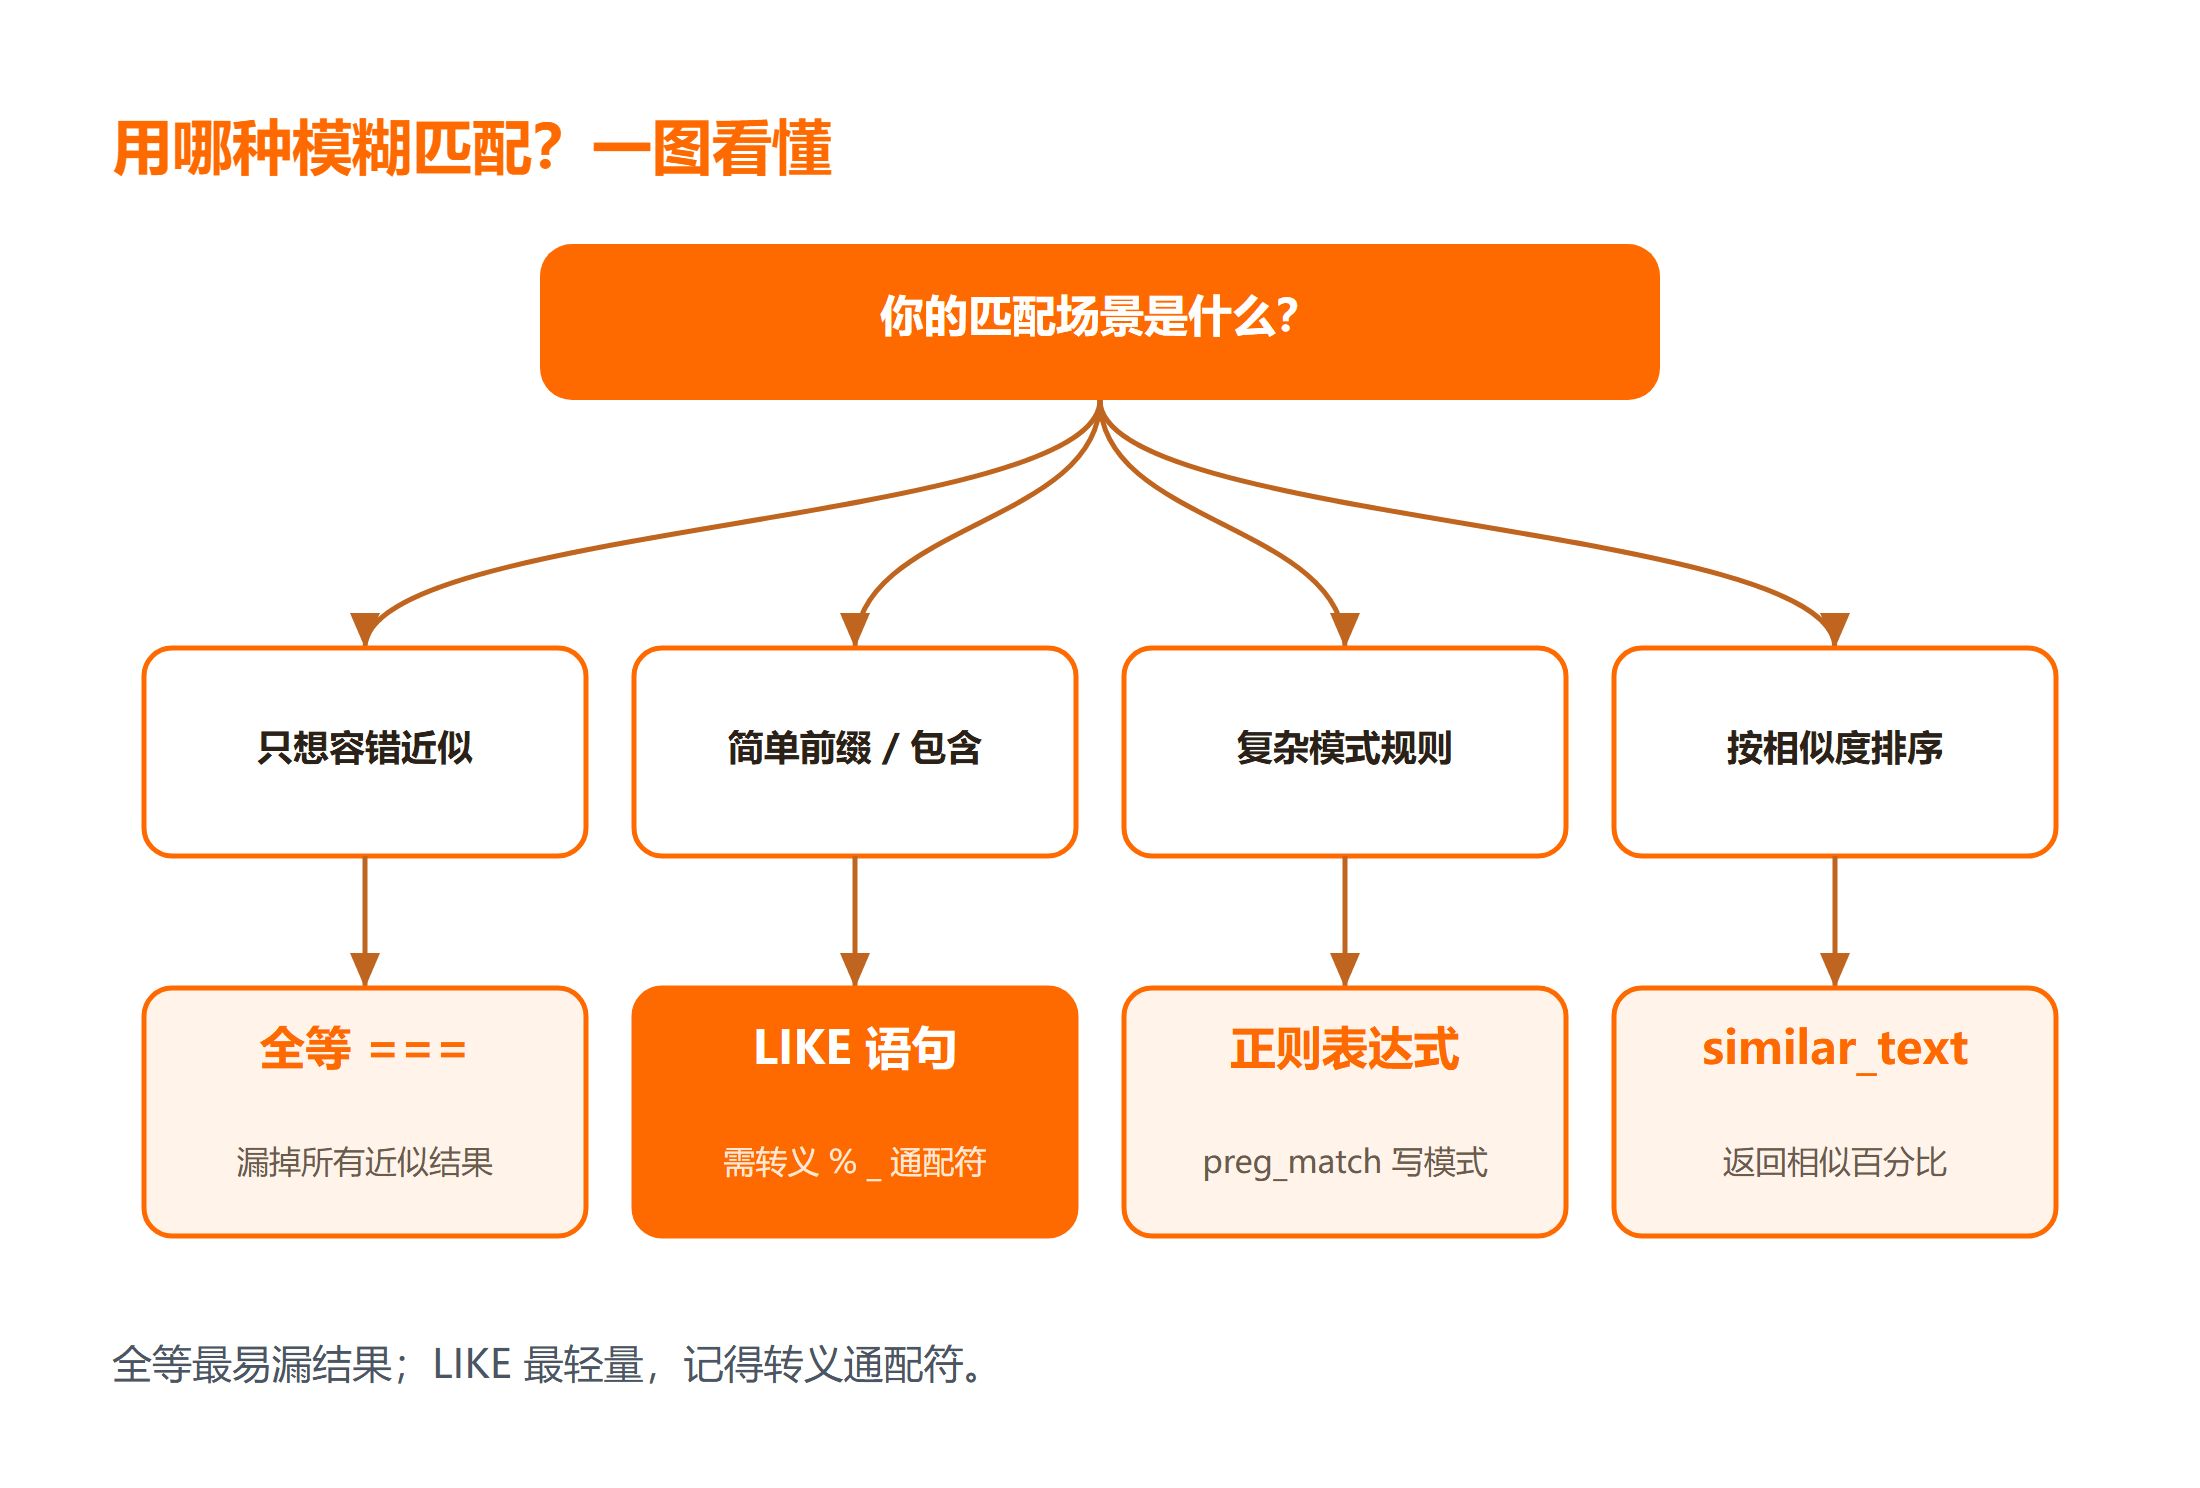
把 PHP 模糊匹配拆成一句话:能用 SQL 查询就优先用 LIKE 语句,因为它最快也最贴合数据库;需要按模式灵活匹配就用正则表达式;当用户输错字也要能推荐时,才上相似度算法。三个最容易失败的点分别是 LIKE 没转义导致注入、正则写错定界符、以及把相似度算法当成精确查询用。下面逐节拆解。
一、模糊匹配到底是什么,为什么不用全等
全等比较要求字符串一字不差,但用户输入常常多空格、少字、大小写混用,全等会直接漏掉。模糊匹配放宽这个条件,把"差不多"的结果也带出来。先过一遍 PHP 教程 的字符串章节,能更好理解下面的写法。
1.1 触发条件
只要你的查询来自用户搜索框、自动补全、或者"你是不是想找"这类推荐,就该用模糊匹配。典型场景是商品名、用户名、文章标题的部分匹配,而不是主键精确查找。
⚠️ 注意:任何把用户输入拼进 SQL 的做法都必须参数化,LIKE 后面的占位符同样要绑定,否则就是 SQL 注入入口。
1.2 常见误解
很多人以为 strpos 判断包含就算模糊匹配,但它区分大小写、也不支持模式。真要做灵活的模糊匹配,还是得回到 LIKE 语句或正则表达式,复杂度高一点但行为可控。
二、方案一:用 LIKE 语句做前缀与包含匹配
这是最推荐的做法,适合绝大多数搜索场景,代价是只能在数据库这一层做匹配。
- 用 PDO 准备带占位符的 SQL,占位符前后拼
%; - 把用户输入作为参数绑定,绝不拼字符串;
- 按前缀、包含、后缀三种模式选择
%的位置。
$pdo = new PDO($dsn, $user, $pass);
$keyword = $_GET['q'] ?? '';
// 包含匹配:前后都加 %
$stmt = $pdo->prepare('SELECT name FROM products WHERE name LIKE ?');
$stmt->execute(['%' . $keyword . '%']);
$rows = $stmt->fetchAll(PDO::FETCH_ASSOC);
上面这段做的是用参数化查询执行 SQL 查询,把用户输入安全地嵌进 LIKE 模式里。执行后你会看到,输入"手机"能查出"智能手机""手机壳"等包含结果。关于 PHP 速查手册 里 PDO 的更多用法可以继续查。
💡 小提示:LIKE 在大表上会很慢,记得给被查字段加前缀索引,或改用全文索引。
三、方案二与方案三:正则表达式与相似度算法
当 LIKE 表达不了复杂模式时,可以换两种思路。
方案二:正则表达式。 用 preg_match 按模式匹配,比如邮箱、手机号这种固定形态的字段。它的取舍是功能强,但写错定界符或转义就会报错,不适合超大文本批量跑。基础语法见 PHP 在线运行。
方案三:相似度算法。 用 similar_text 或 levenshtein 计算两个字符串的相近程度,适合"你是不是想找"的容错推荐。它的取舍是能容忍输错字,但它是逐对比较,数据量大时必须先粗筛再精算。
四、横向对比与踩坑清单
| 做法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| LIKE 语句 | 数据库搜索 | 快、贴合存储 | 大表需索引 |
| 正则表达式 | 固定形态字段 | 模式灵活 | 易写错、慢 |
| 相似度算法 | 容错推荐 | 容忍错字 | 需先粗筛 |
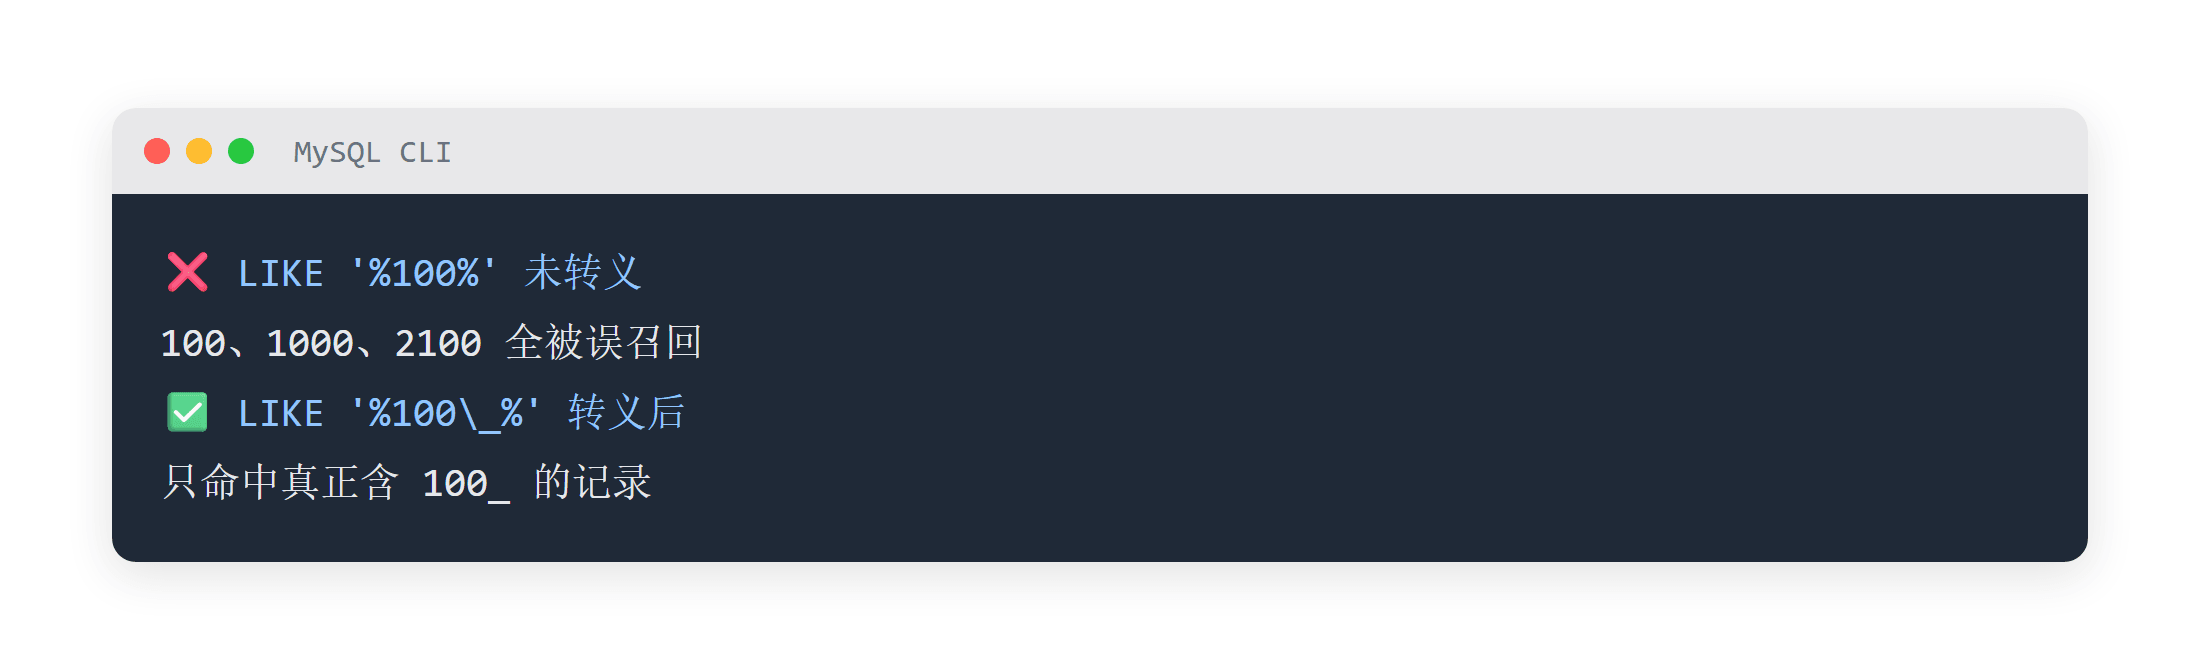
坑一:LIKE 没转义。 用户输入里带 % 或 _ 会被当成通配符,既影响结果也可能被利用。下推前先用 addcslashes 转义这两个字符。
坑二:正则定界符写错。 PHP 的正则必须包在定界符里(如 /.../),少写斜杠会直接报编译错误。建议统一用 # 作定界符,避免和内容里的 / 冲突。
坑三:把相似度当精确查。 similar_text 返回的是相似度百分比,必须配合阈值判断,否则会把毫不相干的两条也算成相近。
五、实战配置与排错步骤
下面给出一套能直接照做的配置与排错流程,帮你把模糊匹配稳稳落进项目。第一步,配置 PDO 时统一开启异常模式(PDO::ATTR_ERRMODE => PDO::ERRMODE_EXCEPTION),这样 SQL 出错会立刻抛异常,而不是静默返回空数组。第二步,运行上面的 LIKE 示例前,先用 var_dump($rows) 检查实际输出,预期能看到包含关键字的若干行;如果返回空,先核对占位符是否真的绑定了,而不是把变量拼进了语句。
第三步,验证转义是否生效:故意输入 100% 这类带通配符的内容,运行后检查数据库匹配到的行,确认 % 被当成普通字符而非通配符。第四步,排查正则失败:把 preg_match 的返回值显式打印,预期是 0 或 1,如果返回 false 说明定界符或转义写错,按报错位置逐个修复即可。这套流程同时覆盖了正常路径与失败路径,能让你在真实项目里少踩一半坑。
总结
PHP 模糊匹配别一上来就写正则,先想清楚数据在哪:在数据库就用 LIKE 语句,固定形态字段才上正则表达式,需要容错推荐再用相似度算法。三个坑都集中在"没转义、定界符错、相似度误用"。
要点带走:
- LIKE 必须参数化,占位符也要绑;
- 用户输入里的
%和_要先转义; - 相似度算法要配阈值,不能当精确查。
下一步,如果想把搜索做得更专业,可以顺着全文索引和分词继续深挖。
延伸学习
想把 PHP 与数据库这块系统补齐,可以按这个顺序来:
- 先过一遍 PHP 进阶篇:用实践强化语法,把语法练扎实;
- 版本管理常踩坑,参考 Git 暂存改动 的实操;
- 调试序列化数据,PHP 反序列化工具 能直接帮你验。
常见问题
Q:LIKE 查询很慢怎么优化?
A:先确认被查字段有没有索引,LIKE 的前缀匹配(右边 %)能走索引,但前后都加 % 的前缀模糊通常走不了。数据量大时改用全文索引或专门搜索引擎。
Q:为什么我的正则一直报编译错误?
A:九成是定界符漏写或内容里出现和定界符相同的字符。统一用 # 作定界符,内容里的 # 用 \# 转义即可规避。
Q:similar_text 和 levenshtein 怎么选?
A:只关心相似比例用 similar_text 更直观;需要做拼写纠错、最短编辑距离用 levenshtein 更合适。两者都要先粗筛,别拿到全表逐对算。



