
 TRAE-AI编程

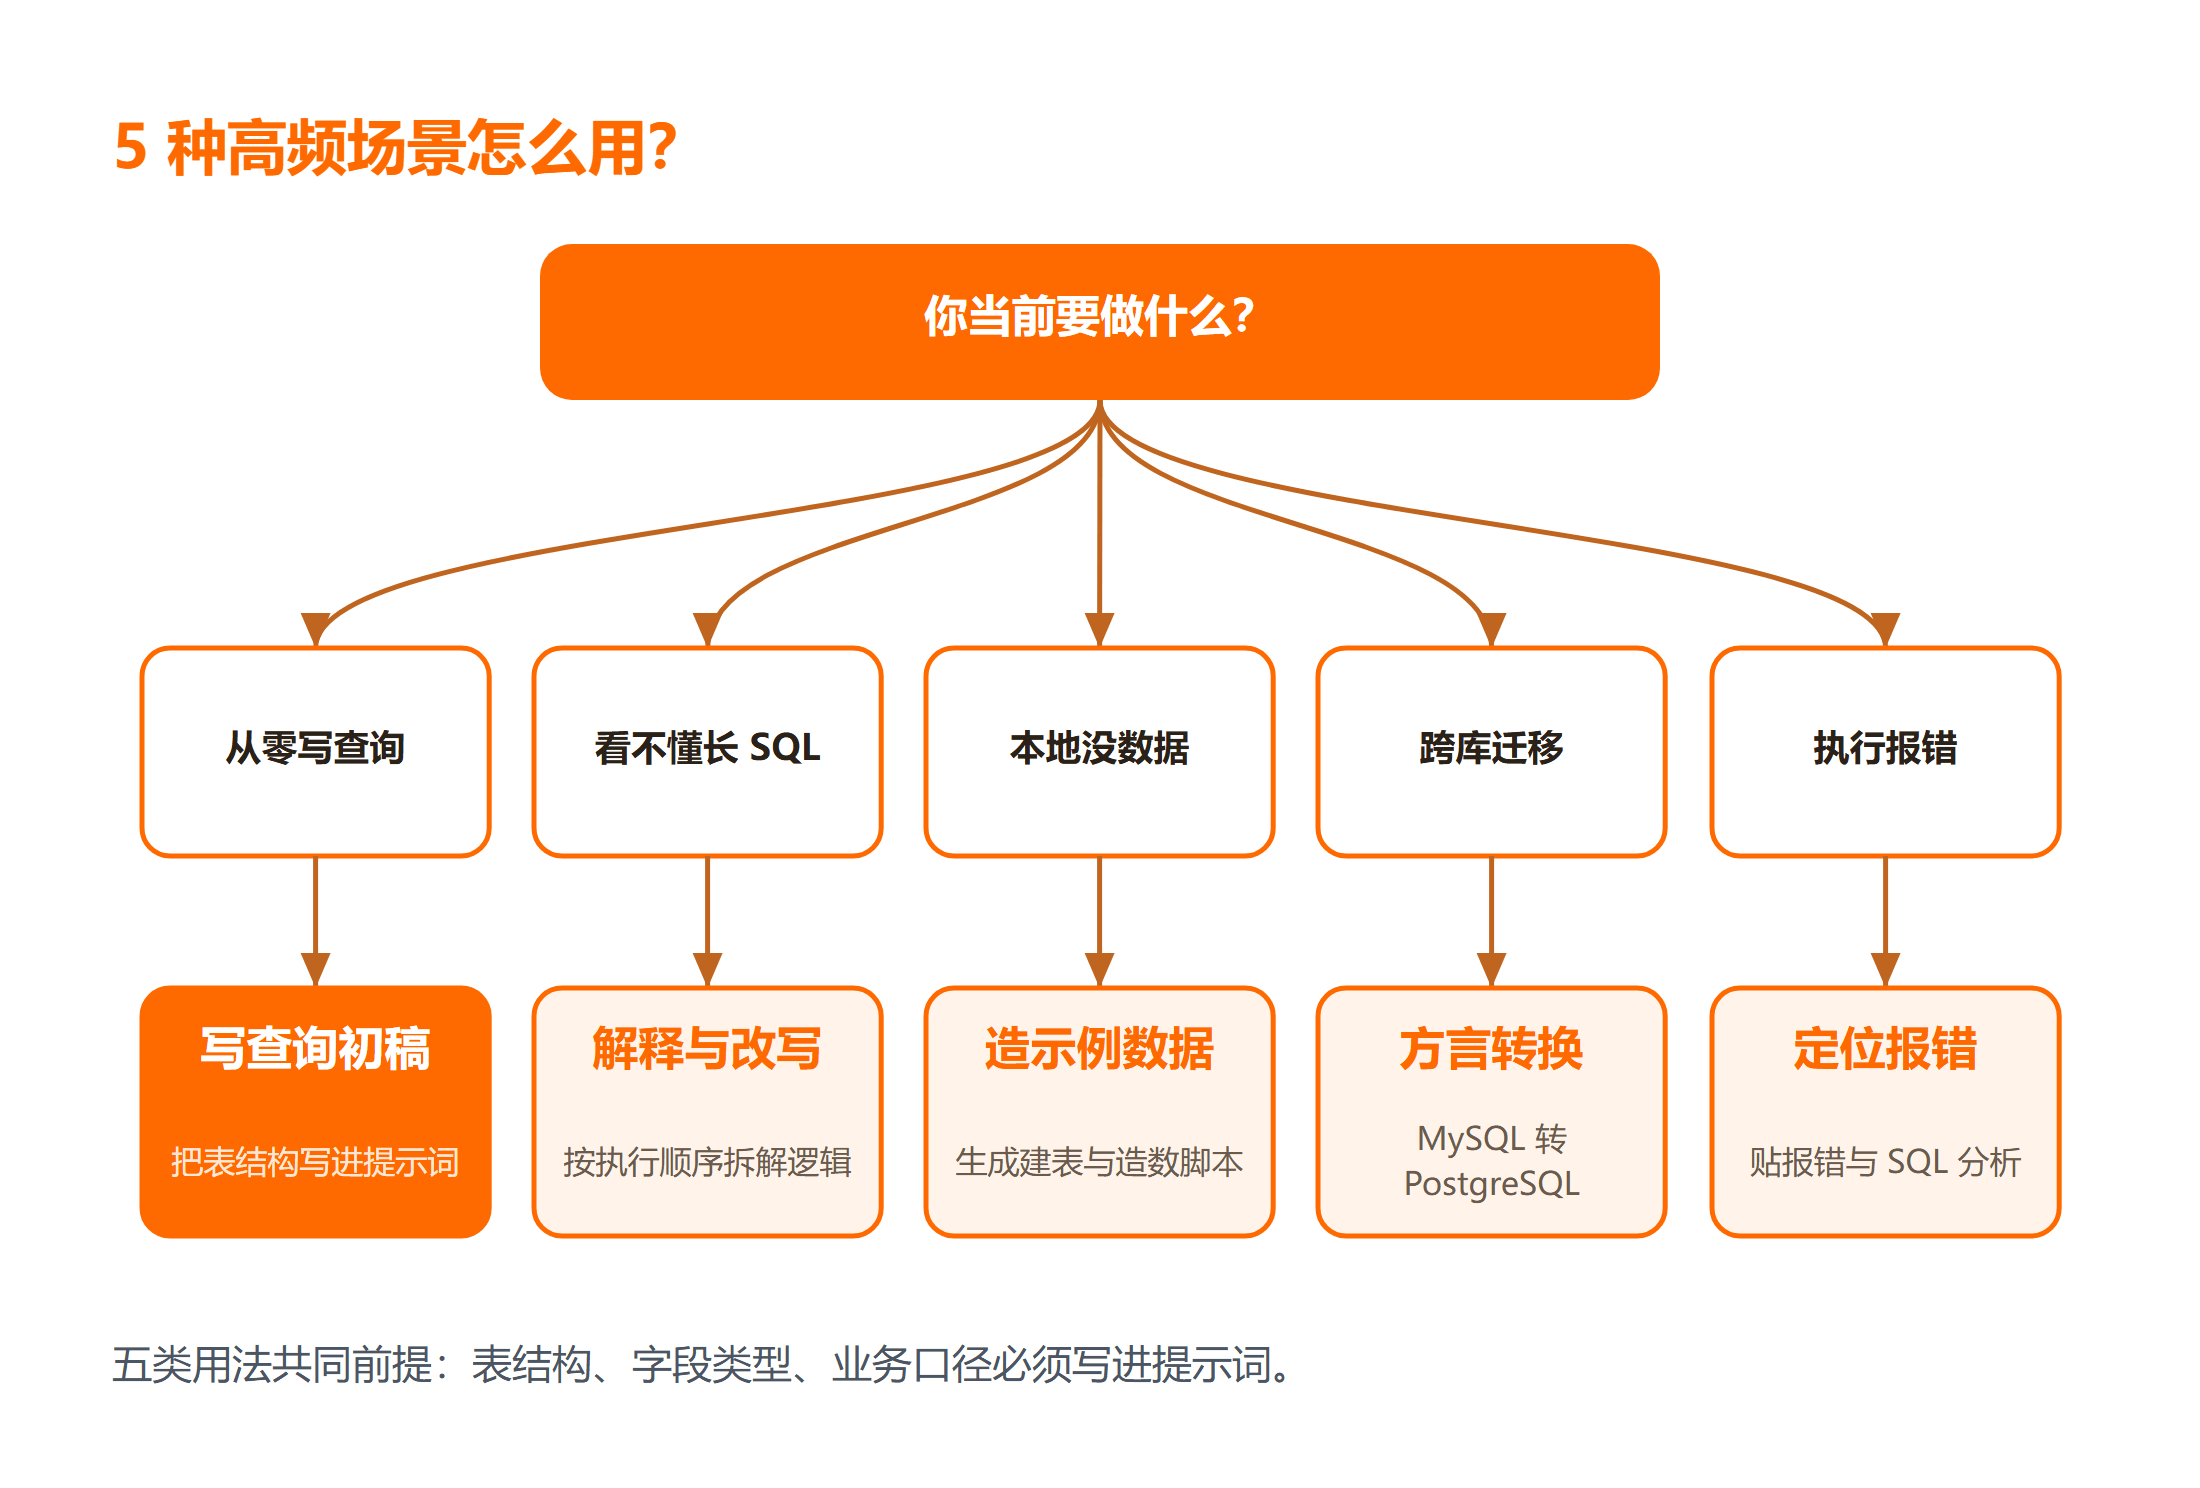
做数据查询时,很多人会先问一句:能不能让大模型直接把需求变成 SQL?答案是可以,但生成的语句不能直接当作生产代码使用。核心结论是,把通义千问当成会写初稿的搭档,而不是出生产代码的机器——每一句 SQL 都要你亲自核验表名、字段类型、过滤条件和返回结果。通义千问辅助写 SQL 最稳的 5 种用法是:写查询初稿、解释复杂语句、造示例数据、转换数据库方言、定位报错;必须避开的边界则是权限变更、未核验的聚合统计,以及带业务规则的模糊需求。下面按场景逐个拆解,并讲清提示词怎么写、结果怎么验。
一、写查询初稿:把自然语言需求变成可运行 SQL
最常见的用法,是把一段业务需求直接描述给通义千问,让它产出第一版查询语句。比如你想查"最近 7 天里下单超过 3 次的用户",这种需求用自然语言说很清楚,但手写 SQL 要拼日期函数和分组计数,容易写错。你可以这样写提示词:给出一张 orders 数据表,字段有 user_id、order_id、created_at,请用 MySQL 8 语法写出最近 7 天下单次数大于 3 的用户。把表结构写进提示词,模型产出的语句通常能直接跑。要系统补 MySQL 基础,可以看 MySQL 基础教程。
SELECT user_id, COUNT(*) AS order_cnt
FROM orders
WHERE created_at >= DATE_SUB(NOW(), INTERVAL 7 DAY)
GROUP BY user_id
HAVING COUNT(*) > 3;
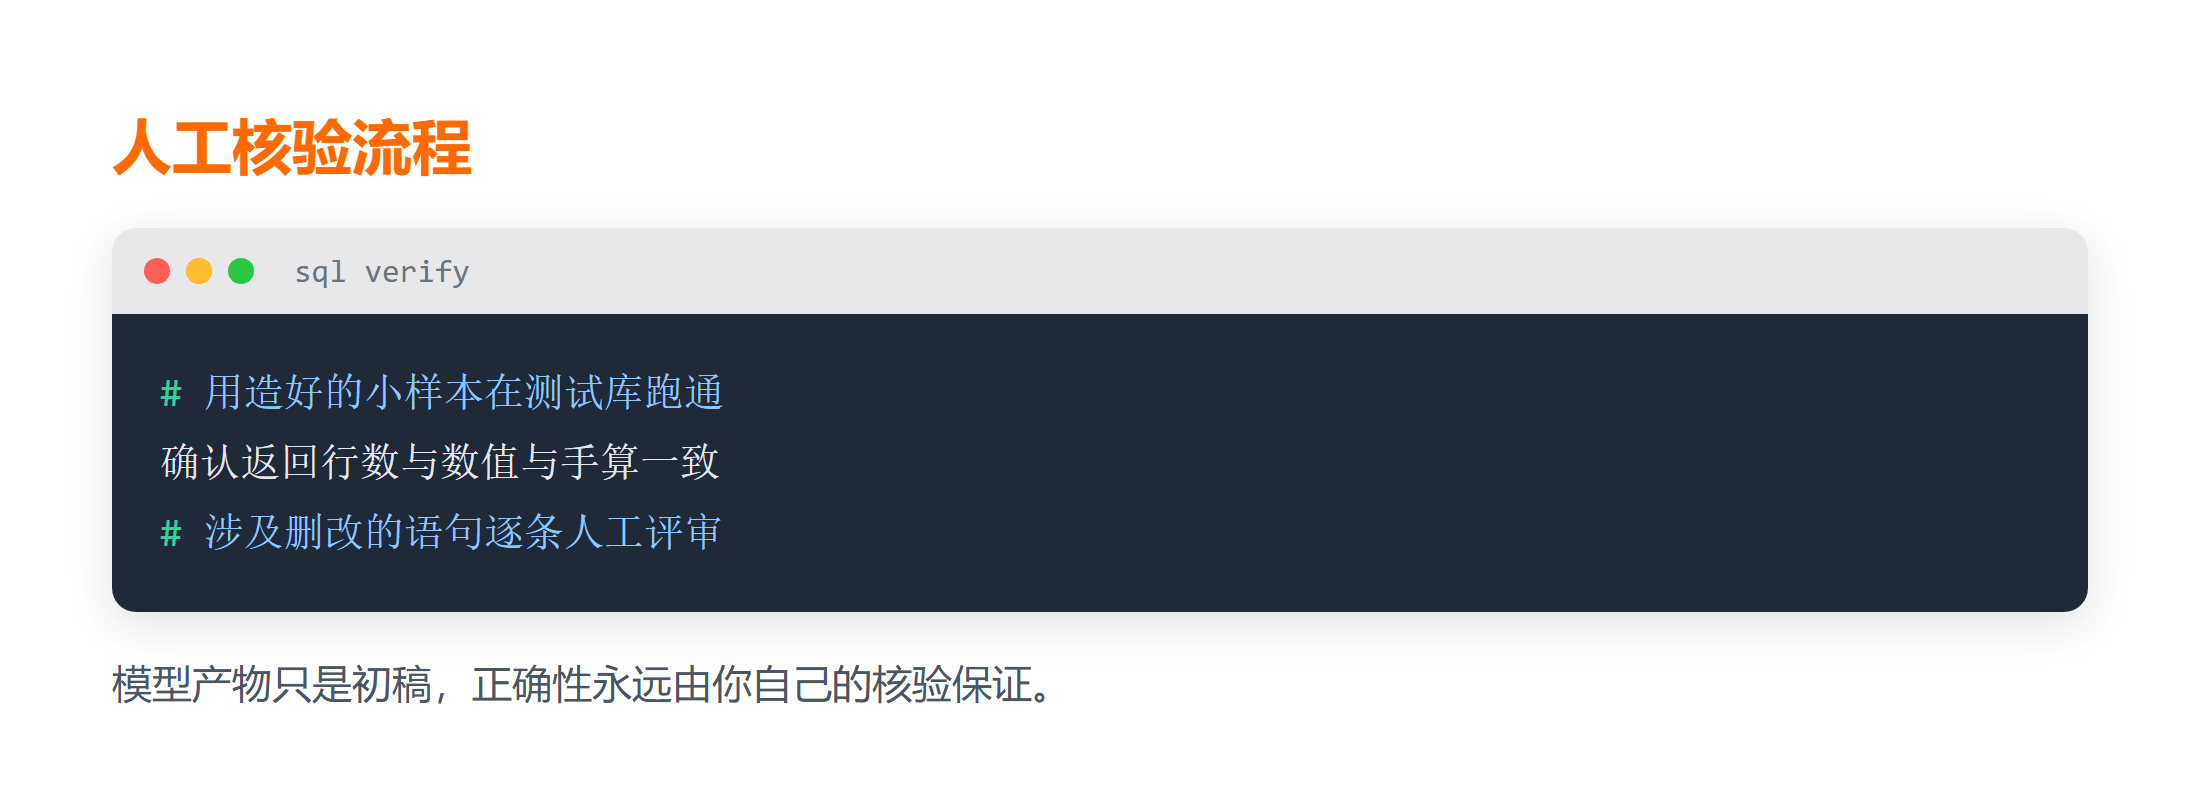
这里真正的坑不在语法,而在假设。模型默认 created_at 是时间类型、默认时区正确、默认你只想要 user_id。如果你的表里日期存的是字符串,或者业务口径是"自然日"而非滚动 7 天,这条语句的结果就会偏。所以初稿跑通后,一定要拿一条你手算过的小样本核对,确认返回的行数和数值与预期一致,再往复杂查询上叠加。通义千问给出的初稿只是起点,真正保证正确性的永远是你自己的核验。
二、解释与改写复杂 SQL:读懂别人写的长语句
第二类高频场景,是把一段看不懂的历史 SQL 丢给通义千问,让它用白话解释每一步在做什么,或者在不改变语义的前提下重写得更易读。生产环境里经常遇到几百行的存储过程,嵌套了多层子查询和窗口函数,新人接手时很难快速理解。把语句贴进去并说"请按执行顺序解释这条 SQL,并标出每个子查询的作用",模型能把逻辑拆成几段讲清楚,帮你定位慢查询可能出在哪一步。想补全 SQL 语法体系,可以看 SQL 基础教程。
SELECT dept, avg_salary
FROM (
  SELECT dept, salary, AVG(salary) OVER (PARTITION BY dept) AS avg_salary
  FROM employees
) t
WHERE salary > avg_salary;
这段用窗口函数算部门平均薪资,再筛出高于部门平均的人。模型解释时容易把"窗口函数不分组聚合"和"GROUP BY 聚合"混为一谈,这点你要特别留意。正确说法是:内层 AVG() OVER (PARTITION BY dept) 给每一行都带上部门均值,外层再做行级比较,而不是先聚合成单行。让通义千问改写时,也要确认它有没有偷偷把窗口函数改成 GROUP BY,那样语义就变了。把复杂 SQL 讲清楚的价值,在于你能在评审时立刻发现这类语义偷换。
三、造示例数据与建表语句:测试前先有素材
第三类用法,是让通义千问生成建表语句和造数脚本,省去手写测试夹具的时间。比如你要演示一个报表查询,但本地没有数据,就可以让它按字段类型生成 20 条符合约束的样例。提示词要写清字段名、类型和业务含义,比如"生成一张 products 数据表,含 id 自增主键、name 字符串、price 小数、stock 整数,并插入 10 条价格介于 9.9 到 999 之间的示例"。这样造出的数据能直接用于验证你的查询逻辑。新版本语法可参考 MySQL8 基础教程。
CREATE TABLE products (
  id INT AUTO_INCREMENT PRIMARY KEY,
  name VARCHAR(60),
  price DECIMAL(10,2),
  stock INT
);
INSERT INTO products (name, price, stock) VALUES
  ('键盘', 99.00, 50), ('鼠标', 49.90, 120), ('显示器', 899.00, 12);
一个常被忽略的点是:模型造的数往往"太整齐",比如价格全是整数、日期全是同一天,这会掩盖你查询里对边界值的处理缺陷。所以拿到造数脚本后,故意改一两条异常数据,例如负库存、超大金额、空字符串,再跑你的查询,看看边界情况有没有被正确处理。通义千问在造示例数据上很省事,但它不会替你想清楚哪些边界最容易出现 bug。
四、跨数据库方言转换:MySQL 到 PostgreSQL 等
第四类用法,是把一种数据库的语法改写成另一种。比如你有一段 MySQL 的 DATE_SUB 和 LIMIT 写法,要搬到 PostgreSQL,语法差异会卡住不少人。把原语句贴给通义千问并注明目标库,它能把 LIMIT 保留、把 DATE_SUB(NOW(), INTERVAL 7 DAY) 换成 NOW() - INTERVAL '7 days',甚至提醒你两种库在自增主键、字符串拼接上的不同。常见函数对照可以翻 MySQL 速查手册。
-- MySQL
SELECT * FROM logs ORDER BY id DESC LIMIT 10;
-- PostgreSQL
SELECT * FROM logs ORDER BY id DESC FETCH FIRST 10 ROWS ONLY;
方言转换的坑在于细节:分页、日期运算、字符串连接符、布尔类型、自增列的写法,每个数据库都不完全一样。动手转换前,先检查源语句里用到的分页方式与日期函数,确认目标库是否支持同样写法,再让模型改写;模型有时会漏掉目标库的特有限制,例如 PostgreSQL 没有 TINYINT、对标识符大小写敏感。所以转换后务必在目标库真正执行一遍,而不是只做语法层面的替换。通义千问能把八成工作量自动化,剩下两成的数据库差异,必须由你在本机验证确认。
五、定位 SQL 报错:把异常丢给模型分析
第五类用法,是把执行报错信息连同相关表结构一起发给通义千问,让它分析可能的原因。比如你遇到 "Unknown column" 或 "Operand should contain 1 column",把完整报错和出错的 SQL 命令贴过去,模型通常能指出是字段名拼错、子查询返回多列,还是类型不匹配。这一步能大幅缩短你翻文档的时间。不过报错分析必须谨慎,因为模型可能给出看似合理但其实跑不通的修法。
ERROR 1242 (21000): Subquery returns more than 1 row
这条报错说明你写在了等号右边的子查询返回了多行。模型会建议你改成 IN 或者加 LIMIT 1,但具体该用哪种,取决于业务逻辑:是要取其中任意一个值,还是原本就该是多值比较。不要照搬模型的改法,先想清楚业务语义再决定。把通义千问用于定位报错,本质上是让它帮你缩小排查范围,而不是替你做最终决策。
总结
通义千问辅助写 SQL 能明显缩短从需求到语句的距离,但它生成的内容必须经过你的核验才能上线。五种实战场景各自解决不同问题:写查询初稿解决"从零起步",解释复杂 SQL 解决"读懂历史",造示例数据解决"测试缺素材",转换方言解决"跨库迁移",定位报错解决"排查卡壳"。它们共同的前提是,你要把表结构、字段类型和业务口径写进提示词,否则模型只能靠猜。
真正要守住的边界只有三条:第一,任何涉及删除、更新、授权等权限变更的语句,绝不能直接用模型产物执行;第二,聚合统计和报表口径必须手算小样本复核,模型不会理解你公司的业务规则;第三,模糊需求要拆成明确的字段和约束再问。把通义千问当初稿工具、把自己当最终责任人,它才是提效助手而不是隐患来源。写完 SQL 后用一条已知结果的小数据验证一下,比上线后靠用户反馈发现问题省心得多。
常见问题
Q:通义千问生成的 SQL 能直接在生产库执行吗?
不建议。它生成的语句语法可能正确,但未必符合你的表结构、时区和业务口径。正确做法是先在测试库用造好的示例数据跑通并核对结果,确认无误后再考虑生产环境,涉及删改的语句更应逐条人工评审。
Q:提示词怎么写才能让 SQL 更准确?
把数据表名、字段名、字段类型和你的目标数据库版本写清楚,最好附一条期望输入输出。越具体的约束,模型越不容易靠猜。相反,只说"帮我查一下用户数据"这类模糊需求,产出的语句几乎一定要返工。
Q:为什么模型给的方言转换有时跑不通?
因为不同数据库在分页、日期函数、自增列、字符串连接上细节差异很大,模型可能遗漏目标库的限制。转换后一定要在目标数据库真正执行一次,而不是只做语法层面的替换。



