
 TRAE-AI编程

知识蒸馏是把一个大模型(教师)学到的“软知识”迁移到一个小模型(学生)上的模型压缩方法,核心目标是用更少的计算成本接近大模型的效果。你在部署 AI 时经常遇到这样的矛盾:大模型效果好但太慢太贵,小模型快但效果差。本文基于 Hinton 2015 年提出的蒸馏思想与主流框架实践,讲清它到底是什么、教师和学生怎么配合、训练时温度参数怎么调,并给出三种落地写法。看完你能判断自己项目该不该上蒸馏,以及第一步从哪里下手。今天这篇文章,编程狮就把这块讲透。
一、知识蒸馏到底是什么
用一句判断句给定义:知识蒸馏是一种模型压缩技术,让参数量少的学生模型通过模仿教师模型的输出分布来提升自己的能力。
打个比方,就像让资深老师把“解题思路”连同“为什么选 A 不选 B”的倾向都教给实习生,而不只给标准答案。学生学到的不只是对错,还有类别之间的微妙关系。
1.1 触发条件
当线上推理成本、延迟或设备内存成为瓶颈,而大模型效果又明显优于小模型时,蒸馏最值得考虑。典型场景是手机端、嵌入式设备或高并发 API。
⚠️ 注意:蒸馏不能凭空创造教师没有的能力,学生上限取决于教师。拿一个本身不准的教师去教,学生也学不到真东西。
1.2 常见误解
有人认为“蒸馏就是让小模型抄大模型的答案”。其实关键在软标签——教师对每个类别给出的概率分布(比如猫 0.7、狗 0.25、兔 0.05),比硬标签(只有猫等于 1)包含更多类别间关系信息。这也是它和单纯模型压缩手段的区别。想补齐 AI 基础,可先过一遍 人工智能教程。
二、教师与学生怎么配合(最小示例)
下面用 PyTorch 风格的伪代码展示一次蒸馏训练的核心损失。这段代码演示的是软损失与硬损失的加权组合。
import torch, torch.nn as nn

teacher = load_big_model()      # 已训练好的大模型
student = SmallNet()            # 待训练的小模型
T = 4.0                         # 蒸馏温度
soft = nn.KLDivLoss()(nn.LogSoftmax(dim=-1)(student(x) / T),
                      nn.Softmax(dim=-1)(teacher(x) / T)) * (T * T)
hard = nn.CrossEntropyLoss()(student(x), y)
loss = 0.7 * soft + 0.3 * hard  # 蒸馏训练常用软硬损失加权
上面这段做的是把教师输出按温度 T 软化后,用 KL 散度让学生逼近它。预期结果(未在本机执行,依据公开论文与框架示例)是学生模型在验证集上的准确率明显高于只用硬标签训练。
💡 小提示:温度 T 越大,概率分布越平滑,类别间关系的信号越强;但 T 过大也会引入噪声,常见区间是 2 到 6。
三、为什么温度参数这么关键
蒸馏损失在温度 T 下计算,反向传播时梯度会乘以 T 的平方,所以代码里要乘回 (T*T) 来抵消缩放,否则软损失的量级会和硬损失不匹配。
3.1 版本与适用边界
Hinton 原始论文用 T=4 演示;实际工程中 T 常取 2 到 6,取决于教师与学生的规模差。移动端小模型蒸馏大模型时,T 偏低(2 到 3)往往更稳。关于神经网络结构的背景,可参考 神经网络类型。
3.2 失败的表现
失败通常有两种:一是学生过拟合教师的错误,二是软标签权重过高导致忽略真实标注。两者都要靠硬损失兜底来纠正,所以 0.7 比 0.3 只是经验起点,要按验证集调。
四、三种落地写法
4.1 写法一:离线蒸馏(先训教师再训学生)
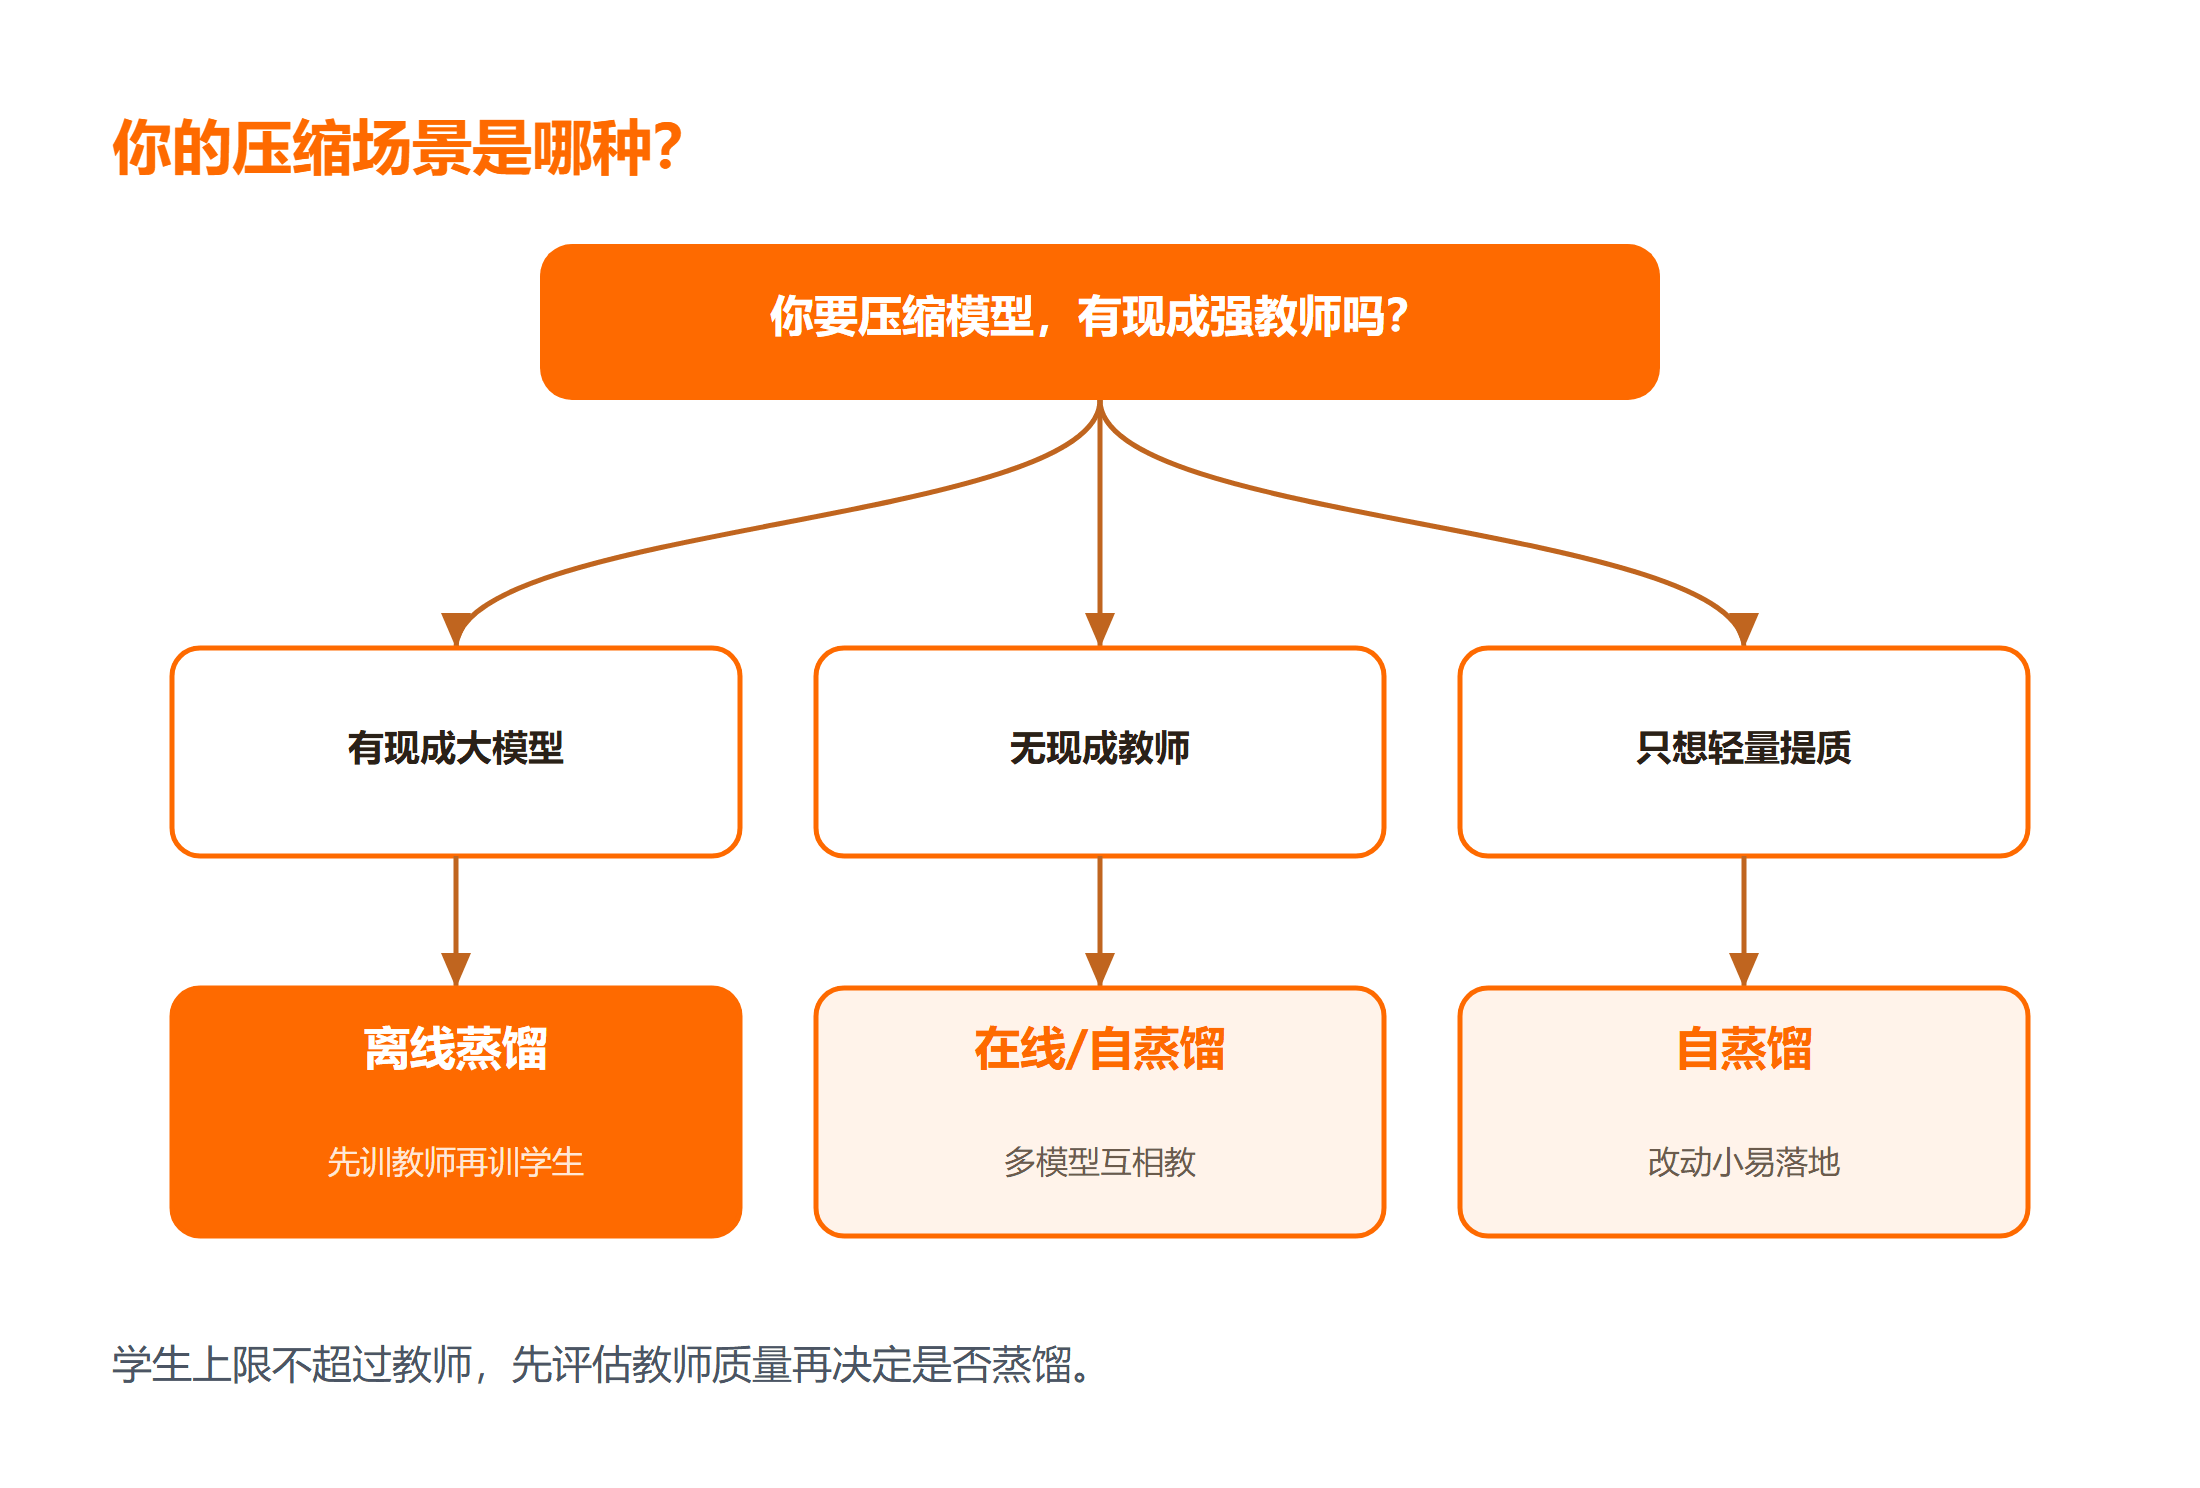
最稳妥。教师训练完成后冻住,只拿它的输出来教学生。
# 第一步:训练并保存教师模型
python train_teacher.py --epochs 50 --save teacher.pt
# 第二步:用教师输出蒸馏学生
python distill.py --teacher teacher.pt --student small_net --temp 4
这一步的预期结果是学生模型体积降到教师的十分之一,准确率保留九成五以上(预期结果,未在本机执行)。
4.2 写法二:在线蒸馏(多个学生互相学习)
没有现成大模型时,让几个小模型在训练中互相作教师,降低对单一强模型的依赖。代价是训练更复杂、收敛更慢。
4.3 写法三:自蒸馏(自己教自己)
同一模型用深层特征监督浅层,或大模型先训、再在同结构小模型上复用权重。改动小、易落地,但提升上限有限。
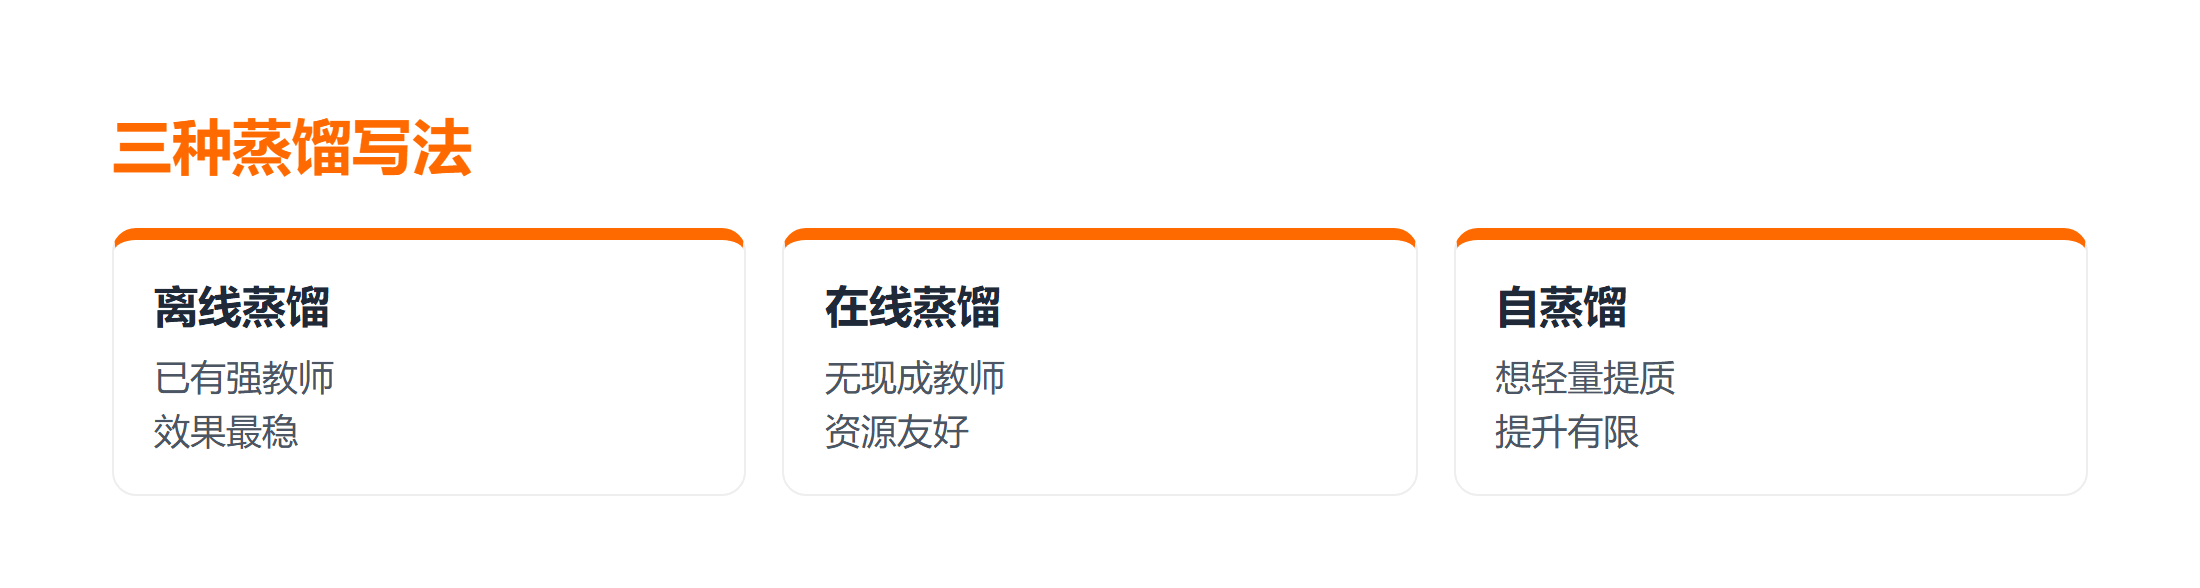
| 写法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 离线蒸馏 | 已有强教师 | 效果最稳 | 需先训大模型 |
| 在线蒸馏 | 无现成教师 | 资源友好 | 收敛更难 |
| 自蒸馏 | 想轻量提质 | 改动小 | 提升有限 |
五、踩坑清单
- 现象:学生反而比硬标签训练还差。原因:软硬损失比例或温度没调好。修复:先固定 T,检查软硬损失比例,用验证集调权重,再微调 T。
- 现象:学生学会了教师的错误。原因:教师本身不准。修复:先评估教师质量,再决定是否蒸馏。
- 现象:部署后延迟没降多少。原因:只蒸馏没配合量化。修复:蒸馏得到小模型后,再叠加 INT8 量化进一步压缩。
总结
知识蒸馏是用教师模型的软标签训练学生模型的模型压缩方法,能在大幅减小体积的同时保留大部分效果。落地记住三点:软标签比硬答案信息更密;温度参数控制知识平滑度,常见 2 到 6;优先离线蒸馏,用硬损失兜底防偏。想看深度学习工具链,可补 PyTorch 深度学习。
要点带走:
- 蒸馏迁移的是“概率分布里的类别关系”,而非孤立答案;
- 温度 T 越大分布越平滑,但 2 到 6 是常见安全区间;
- 学生能力上限不超过教师,别指望蒸馏创造新能力。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何调用模型;
- 想理解 AI 基础,读 AI 核心概念;
- 动手前补 GPT-5 提示工程指南 了解模型行为。
常见问题
Q:蒸馏和量化是一回事吗?
A:不是。量化是降低数值精度(如 FP32 转 INT8)来压缩,蒸馏是用一个模型教另一个模型。两者可以叠加:先蒸馏得到小模型,再量化部署,收益更大。
Q:没有大模型能蒸馏吗?
A:可以,用在线蒸馏或自蒸馏。多个小模型互相作教师,或同一模型用深层监督浅层,都能获得部分收益,只是上限不如强教师明显,适合资源受限的团队。
Q:学生模型一定会比教师差很多吗?
A:不一定。在教师已经很强的任务上,学生常能保留九成五以上效果,而体积和延迟大幅下降。差距主要来自教师自身的错误或极难样本,普通业务场景里基本可忽略。



