 TRAE-AI编程

语音合成(TTS)是把文字自动变成人声朗读的技术,核心是先理解文本该用什么语气、再把文字转成波形。你在用听书、导航播报、语音助手时常享受着它:文字瞬间变成自然语音。本文用初学者能跟上的方式,讲清 TTS 到底是什么、合成流水线分几步、三种路线怎么选,以及用哪些维度判断音色好坏、落地时容易踩哪些坑。看完你能判断项目该用哪种合成方案,以及第一步从哪里下手。今天这篇文章,编程狮就把这块讲透。
一、语音合成到底是什么
用一句判断句给定义:语音合成是一类把文本序列映射为语音波形的任务,它让机器“开口说话”,是 ASR 的逆过程。
打个比方,就像配音演员拿到稿子,先标出哪儿该停顿、哪儿该重读,再用自己的嗓子念出来。模型做的也是这套:先分析文本韵律,再生成对应声音。
1.1 触发条件
当你需要把大量文字转成可听的语音时,TTS 最值得上。典型场景是有声书、导航播报、视障无障碍阅读、智能硬件播报,这些场景里人工录音太慢太贵。
⚠️ 注意:TTS 不是“字对音”的简单查表。同一句话在不同情绪、不同说话人下声音完全不同,模型和声码器决定了自然度上限。想补齐 AI 基础,可先过一遍 人工智能教程。
1.2 常见误解
有人认为“合成就是挑个音库念出来”。其实关键在于神经声码器负责把粗糙的声学特征还原成细腻波形,这一步直接决定像不像真人。这也是它和早期拼接法的区别。
二、合成流水线分几步(最小示例)
下面用伪代码展示一条 TTS 流水线的核心步骤。这段代码演示的是从文本到波形的主干。
text = "今天天气真好"                     # 输入文本
seq = frontend(text)                      # 第一步:分词与韵律预测
mel = acoustic_model(seq)                  # 第二步:生成梅尔频谱
wav = vocoder(mel)                         # 第三步:声码器还原波形
save_audio(wav, "out.wav")                 # 保存语音
上面这段做的是先把文字变成带韵律的序列,再用声学模型出频谱,最后靠声码器还原成可播放的波形。预期结果(未在本机执行,依据公开论文与官方文档)是 out.wav 是一段清晰、自然的普通话朗读,停顿和重音基本合理。
💡 小提示:前端韵律预测常被忽视,但它决定“在哪停顿、怎么断句”。如果这步出错,后面声码器再好也会念得磕巴,像机器人。
三、三种路线怎么选
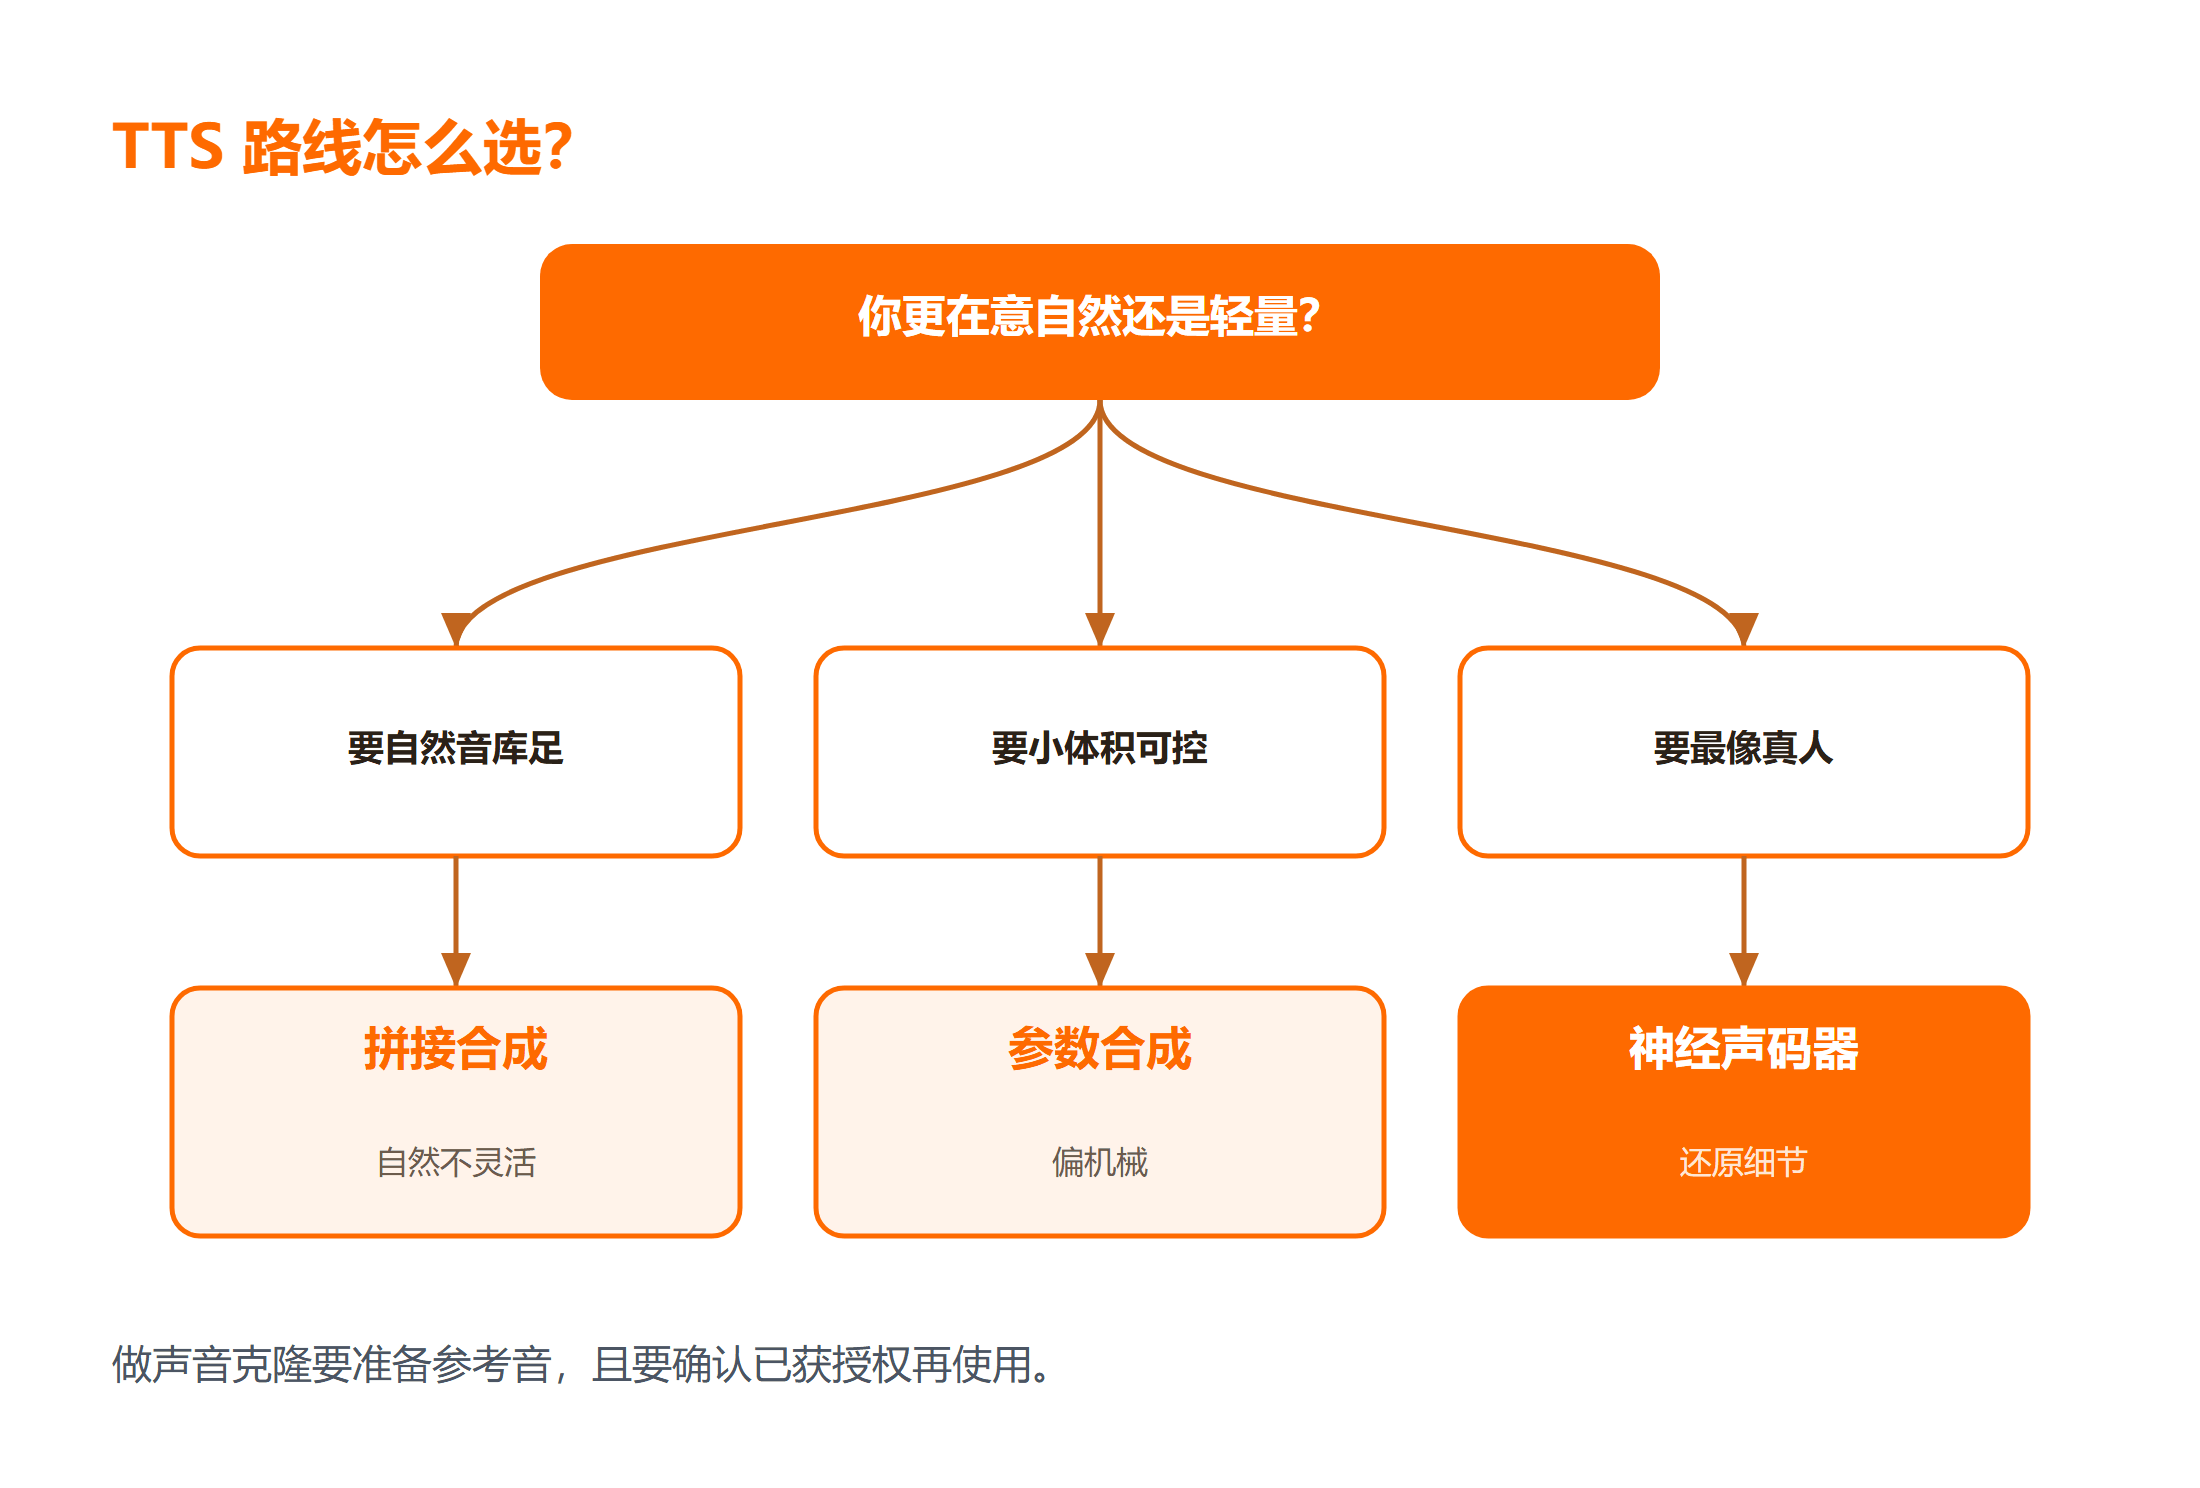
拼接合成音质自然但库大不灵活,参数合成体积小可控但偏机械,神经声码器路线还原细节最像真人,是当前主流。
3.1 版本与适用边界
早期拼接法靠切真实录音片段,自然但占空间;参数法用统计模型,轻量但机械;深度学习时代端到端加神经声码器兼顾自然与体积。适用边界是:嵌入式追求小体积可用参数法,追求真人感就上端到端。关于模型结构背景,可参考 神经网络类型。
3.2 失败的表现
失败通常有两种:一是声音发闷像机器人,说明声码器或声学模型太弱;二是换音色要重训,说明没做解耦。两者都要靠听感评测(MOS)来定位,不能只看损失。
四、衡量音色看哪些维度
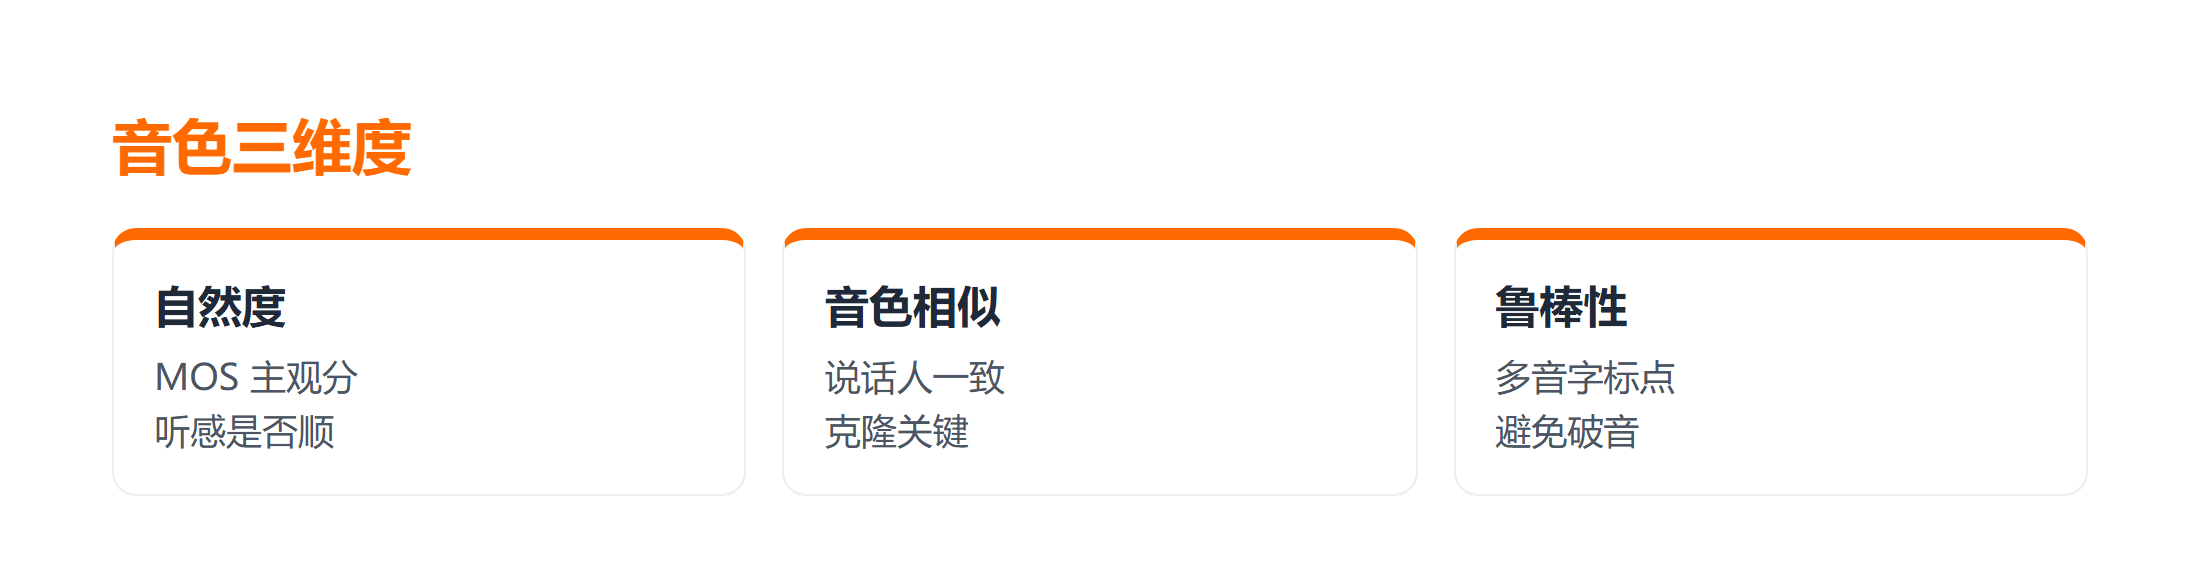
工程上主要看三个维度:自然度、音色相似度、鲁棒性。
| 维度 | 含义 | 关注点 |
|---|---|---|
| 自然度 MOS | 主观听感评分 | 越高越真 |
| 音色相似 | 与目标说话人一致度 | 克隆关键 |
| 鲁棒性 | 多音字长句表现 | 避免破音 |
实际怎么量化自然度?最可靠是组织多人盲评打 MOS 分,配置好评测集后运行合成,再收集评分做平均。检查长句和停顿是否自然,验证不同说话人下的稳定性,失败样本要回听定位是前端还是声码器的问题。把这些指标固化成回归测试,每次模型迭代都跑一遍,才能确认语音质量没有回退。音频质量的回归,比模型结构的微调更该被盯紧。
⚠️ 边界提醒:MOS 要多人盲评才有意义,单人听感偏差大;做声音克隆还要准备参考音,且要确认已获授权。
五、落地时容易踩的坑
如果你的场景对延迟敏感,比如实时导航播报,优先选体积小的端到端模型并做流式合成,宁可牺牲一点自然度也要保证跟手。反之,有声书这类离线场景可以上最大模型换最高 MOS。选方案前先拿你的真实语料做一轮盲评,别只看厂商给的演示音频。
- 现象:多音字读错。原因:前端没判断语境。修复:补多音字词典或用语义模型消歧,再抽样听测。
- 现象:长句破音卡顿。原因:声码器不稳或文本过长。修复:按标点切句合成再拼接,换更稳的声码器。
- 现象:克隆声音不像。原因:参考音太少或风格不一致。修复:收集同一说话人多场景音频,统一录制条件。
# 按标点切句合成的片段(非完整脚本)
sentences = split_by_punct(text)            # 标点切句
clips = [tts(s) for s in sentences]        # 逐句合成
wav = concat_clips(clips)                  # 拼接成一段
# 预期长文本被平稳切分,避免单句过长破音(未在本机执行)
总结
语音合成是把文字变成人声的技术,核心流水线为前端韵律、声学模型和声码器三步。落地记住三点:声码器决定自然度上限,别忽视它;自然度、音色相似、鲁棒性三维度客观衡量好坏;多音字和长句是常见坑,靠切句和消歧解决。想系统理解 AI 术语,可补 AI 术语翻译笔记。
要点带走:
- TTS 是 ASR 的逆过程,让机器开口说话;
- 神经声码器还原波形细节,是真人感的关键;
- 上线看 MOS、音色相似和鲁棒性,别只凭感觉。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何调用语音能力;
- 想理解 AI 基础,读 AI 核心概念笔记;
- 动手前补 AI Python 课程 了解工程实现。
常见问题
Q:TTS 和 ASR 是互逆的吗?
A:功能互逆:ASR 语音转文字,TTS 文字转语音,常一起用在语音助手。但技术上两套独立模型,一个解决“听懂”,一个解决“发声”,互不替代。
Q:声音克隆需要很多数据吗?
A:看方法。传统克隆要几十分钟同人音频,少样本克隆可降到几分钟甚至几句话,但数据越少越容易失真。还要注意参考音的授权合规,不能随便采他人声音。
Q:为什么合成的语音有时像机器人?
A:多半出在前端韵律或声码器。前端没标好停顿重音会念得平,声码器弱则发闷。优先升级声码器并加韵律预测,通常能明显提升自然度。