
 TRAE-AI编程

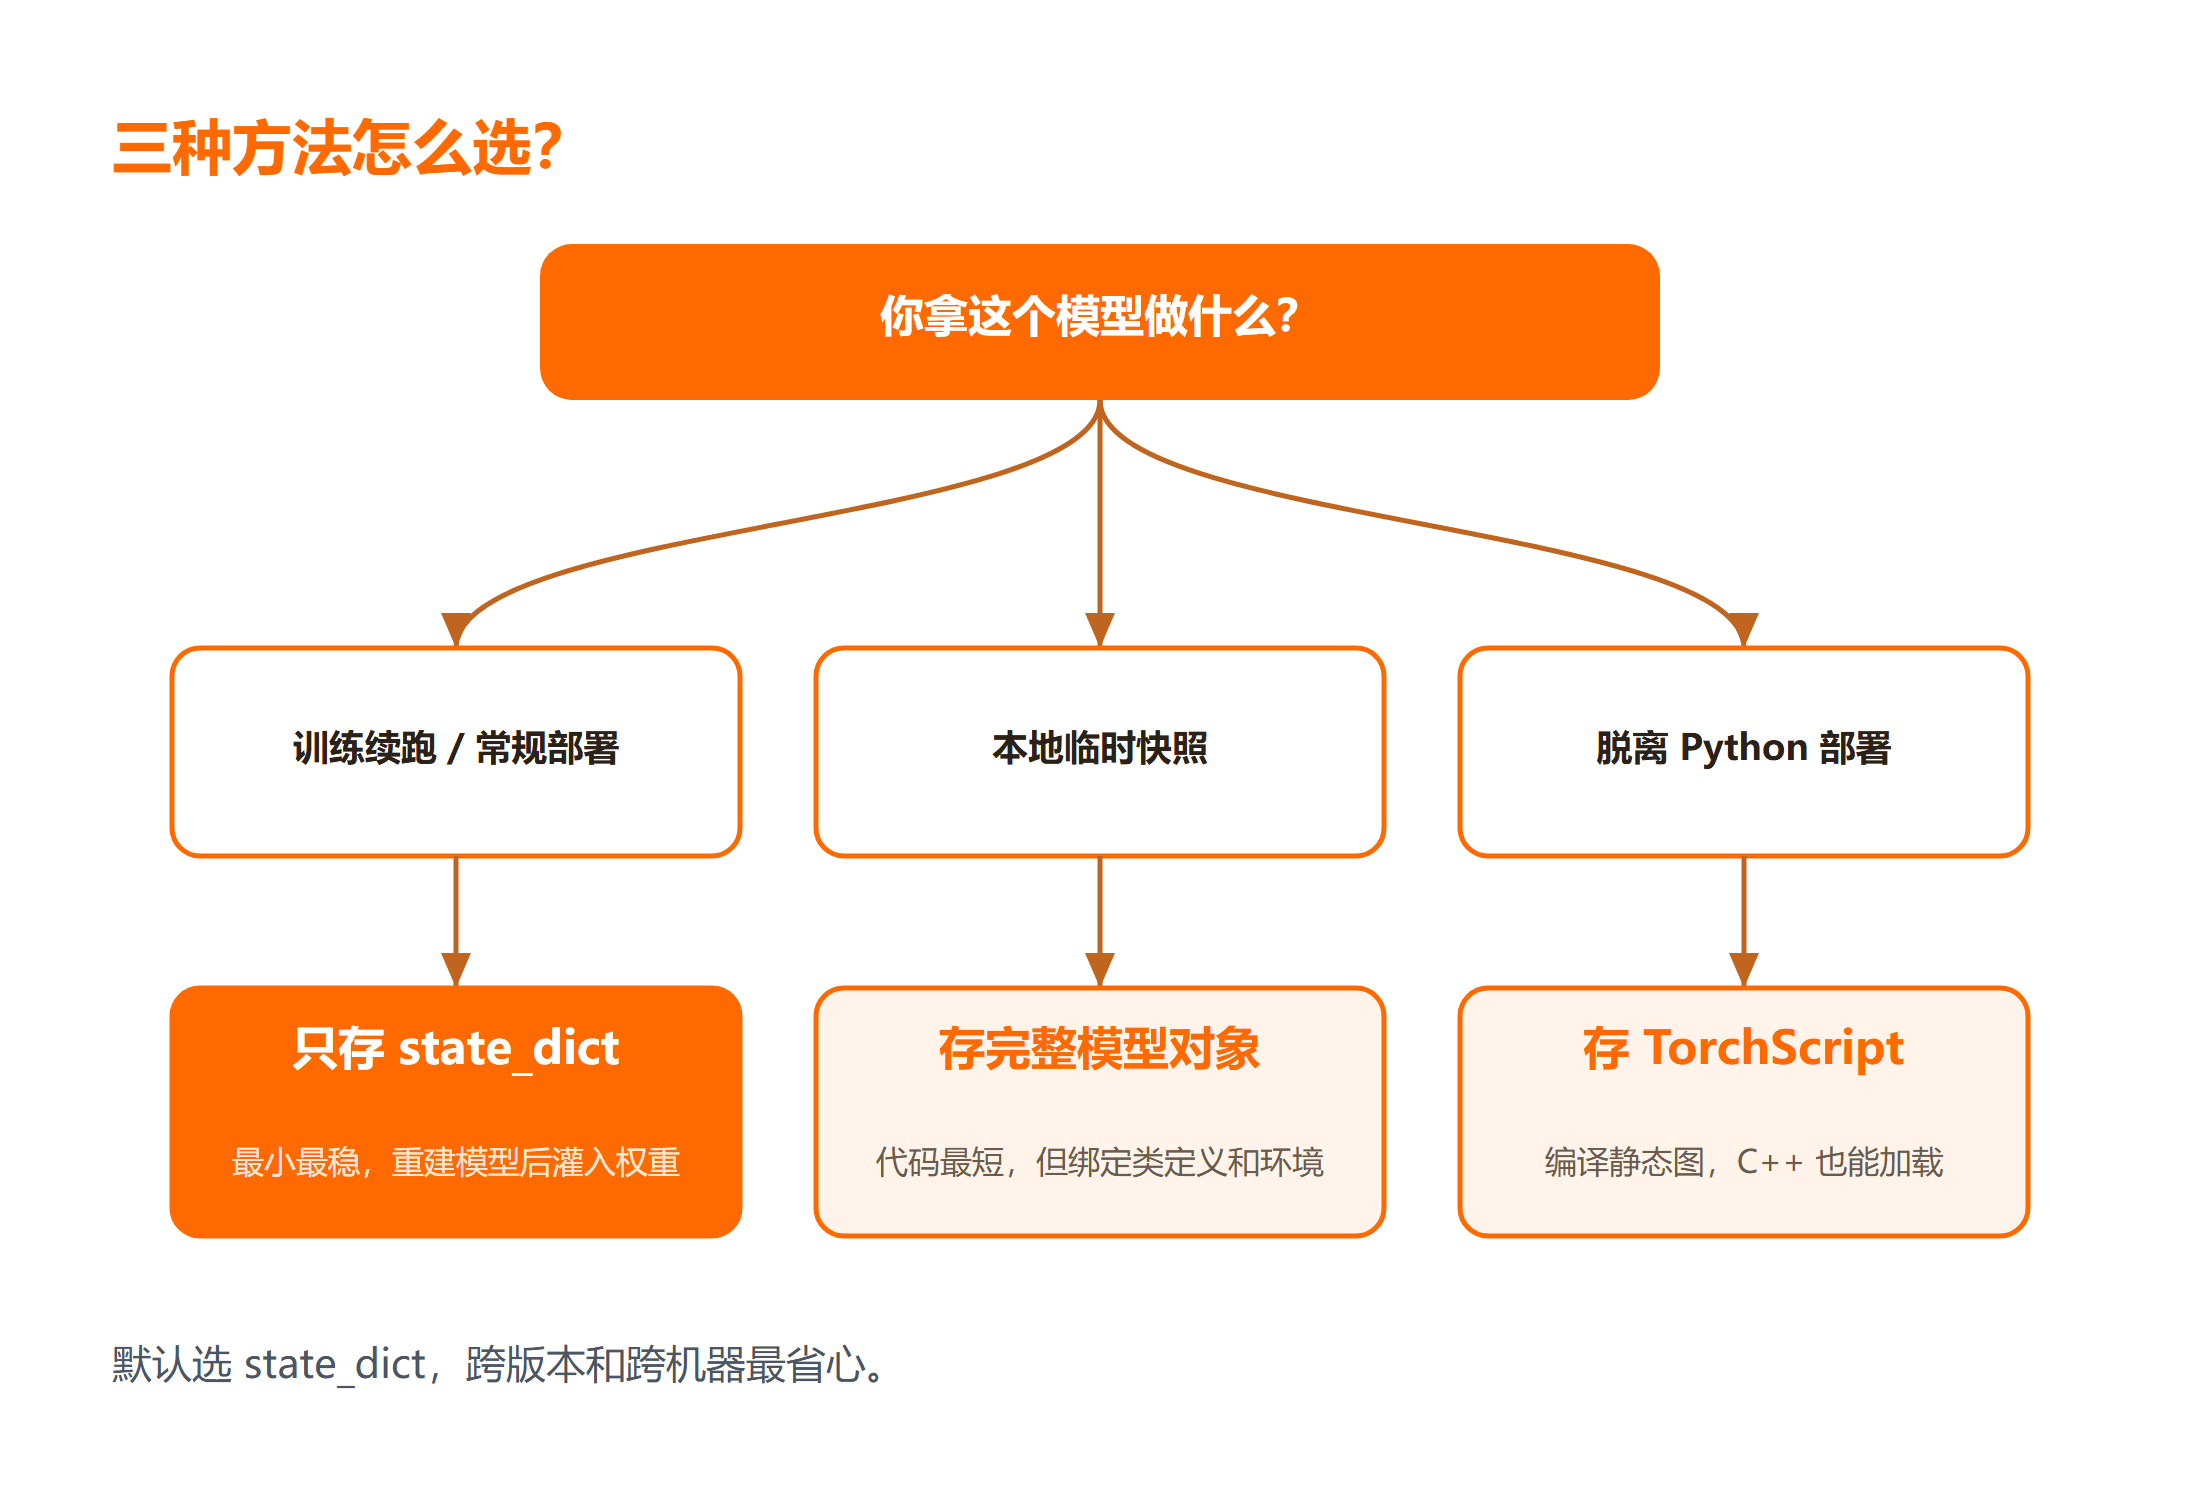
训练完一个 PyTorch 模型,接下来最容易卡住的一步就是把它存下来、再可靠地读回去。先说结论:保存模型有三条主流路径——只存权重 state_dict、存完整模型对象、存 TorchScript,日常绝大多数场景优先用 state_dict,因为它最稳、最省空间、跨版本兼容最好。很多人第一次保存时直接把整个模型 pickle 掉,结果换一台机器或升级 PyTorch 就加载失败;也有人只存了权重,却忘了保存类别映射和网络结构参数,恢复时拼不回原模型。本文用一份能直接运行的最小例子,把三种方法各自怎么操作、什么时候用、失败分支怎么排查讲清楚。看完你能按自己的场景选对方法,并写出一份可复现的保存与加载代码,避免"存了却读不回来"这类低级返工。
一、先看结论与最小例子
讲保存前,先准备一个最小但完整的模型,后面的三种方法都基于它。下面这段代码定义了一个两层全连接网络,并跑了一次假数据前向传播,你可以直接复制到本地 Python 环境运行;对底层原理感兴趣的,可以延伸看 人工智能备选教程。
import torch
import torch.nn as nn

# 定义一个最小的分类网络
class TinyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(4, 8)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(8, 3)

    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))

model = TinyNet()
x = torch.randn(2, 4)          # 假输入:2 个样本,每个 4 维
y = model(x)                   # 一次前向传播,让参数进入计算状态
print(y.shape)                 # 预期结果(未在本机执行):torch.Size([2, 3])
这里有个容易被忽略的适用边界:model 只有经过定义和初始化后才有参数,保存的本质是把这些参数或整个对象序列化到磁盘。如果你连模型都没建好就谈保存,那只是存了个空壳。上面代码里的 y = model(x) 不是训练,只是让网络处于可用状态,真正的训练循环不在本文范围。
二、方法一:只保存 state_dict(推荐)
这是官方推荐、也是工程里用得最多的方法。核心思路是:网络结构是代码,参数才是训练成果,所以只存参数就够了。
保存时调用模型的 state_dict(),它返回一个从层名到张量的字典:
torch.save(model.state_dict(), "tinynet_weights.pth")加载时,先按原样重建模型对象,再把权重灌回去:
model = TinyNet()                                  # 必须先有相同的类定义
model.load_state_dict(torch.load("tinynet_weights.pth", map_location="cpu"))
model.eval()                                       # 切到评估模式,关掉 dropout 等
三个细节决定你能不能顺利读回:
- 加载前必须有类定义。
load_state_dict只负责填参数,不知道网络长什么样,所以TinyNet这个类要在当前脚本里能找到。这也是为什么权重文件小却离不开源码。 map_location处理设备差异。如果模型是在 GPU 上训练的,而加载机器没有显卡,不写map_location="cpu"会直接报错。这是一个典型的版本与环境边界问题。eval()不能忘。加载完默认是训练模式,含 dropout 或批归一化的模型不切评估模式,推理结果会不稳定。
这套"存权重—重建—灌入—切评估"的流程,是后面两种方法的对照基准。想补人工智能的整体概念,可以先看 人工智能概览教程,把张量、网络层这些基础吃透,再回来看三种保存方式的差异会顺畅得多。
三、方法二:保存完整模型
如果你只是想快速存一份快照,图省事,可以存整个模型对象:
torch.save(model, "tinynet_full.pth")加载时不需要重新定义类,直接读:
model = torch.load("tinynet_full.pth", map_location="cpu", weights_only=False)
model.eval()
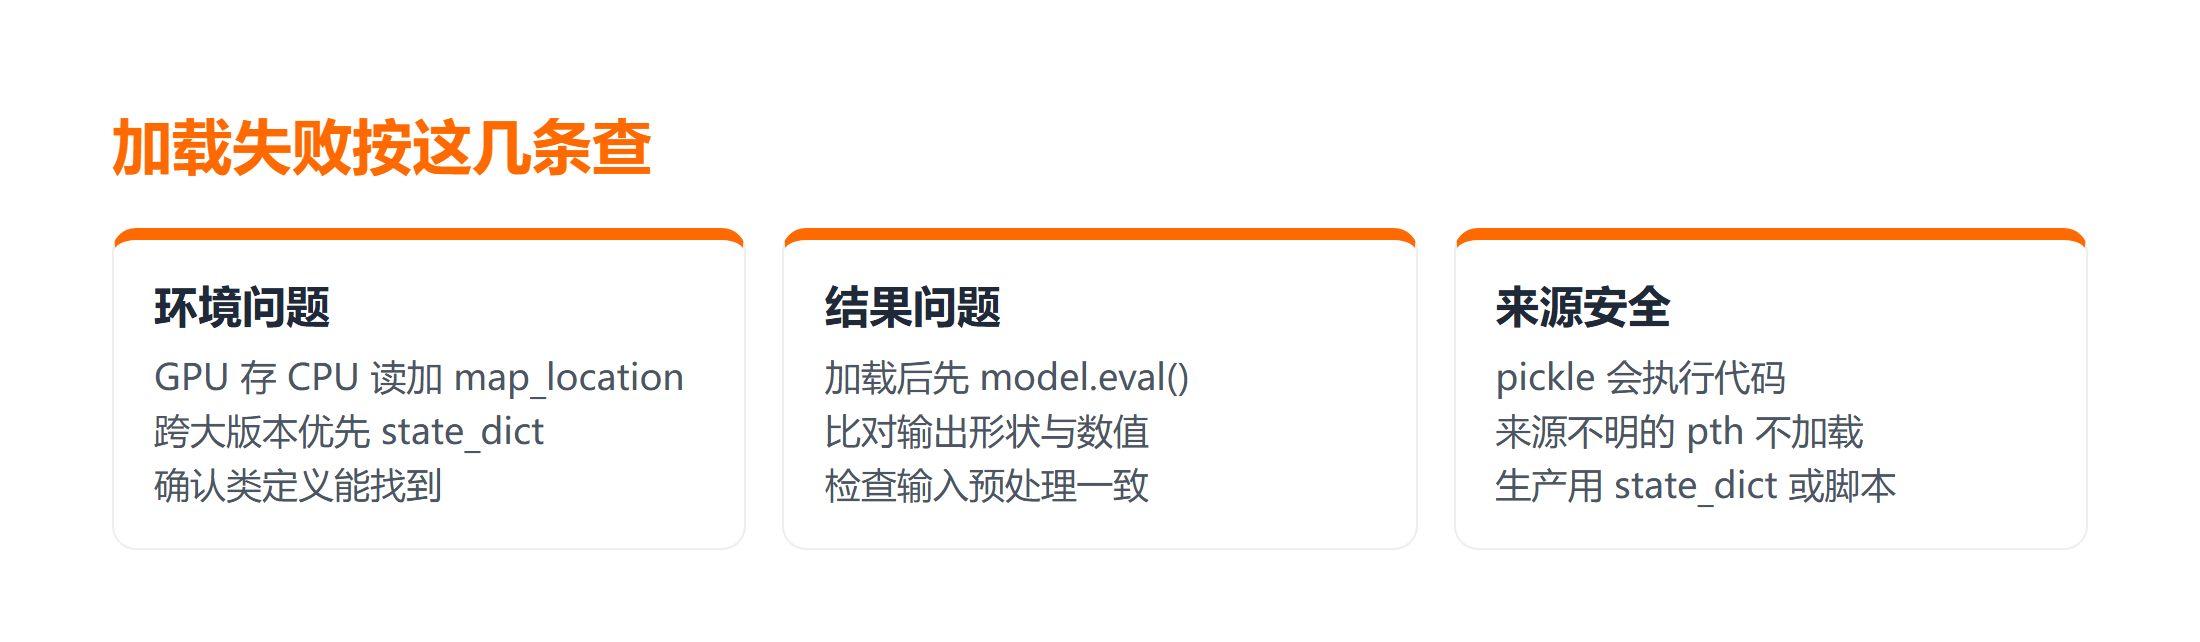
看起来更短,但它的坑埋在 pickle 机制里。第一,加载时 Python 必须能找到 TinyNet 类的定义路径,类被移动、改名或脚本结构变了,就会报 AttributeError。第二,pickle 文件绑定 Python 和 PyTorch 的版本,跨大版本升级后加载失败的案例并不少见。第三,也是安全边界:pickle 加载会执行文件中的代码,来源不明的 .pth 文件绝不要随便 torch.load,这一点在生产环境尤其要守住。
所以完整模型法只适合两类场景:一是本地临时快照,二是团队内部版本完全统一、文件来源可信的短周期迭代。跨机器、长期归档、对外分发,都不要用这种方式。
四、方法三:TorchScript 与跨平台
当前两种方法是"Python 生态内"的方案时,如果你的模型要脱离 Python 运行——比如部署到 C++ 服务、移动端,那就要用 TorchScript。它把动态图转换成可序列化的静态图:
scripted = torch.jit.script(model)          # 也可以用 torch.jit.trace
torch.jit.save(scripted, "tinynet_script.pt")
加载只需一行,且不依赖原来的 Python 类定义:
loaded = torch.jit.load("tinynet_script.pt")
out = loaded(x)
这里 script 和 trace 是两条技术路线:script 保留控制流、适配带分支的模型;trace 用一次真实输入记录执行路径,简单快但遇到依赖数据的分支会失真。选错的直接后果是编译成功、推理结果却不对,属于难以察觉的失败分支。性能上,TorchScript 通常比 eager 模式更快,代价是编译期要做类型推断,部分动态写法会编译不过,需要按报错逐处调整。
五、失败分支与排错清单
把最常见的加载失败集中排查,遇到问题按顺序对照。
AttributeError: Can't get attribute:多半是完整模型法丢了类定义。要么补齐类,要么改用state_dict法。- size mismatch 张量尺寸不匹配:权重和当前网络结构对不上,检查层维度有没有改过,或加载错了文件。
- GPU 机器存、CPU 机器读报错:加载时补
map_location="cpu"。 - 推理结果每次不一样:加载后忘了
model.eval(),dropout 还在工作。 - 版本兼容:保存与加载的 PyTorch 大版本尽量一致,跨大版本优先用
state_dict或 TorchScript;确认报错来源后再决定修复方案,不要盲目重装。
动手核对清单
拿到任意一份模型保存需求,按这个顺序走一遍:
- 前置:明确用途——本地快照、跨机训练续跑,还是生产部署;
- 选择:默认选
state_dict,临时快照可选完整模型,脱离 Python 选 TorchScript; - 保存:调用对应 API,文件名带上模型名和日期,便于回溯版本;
- 验证:在另一段脚本里重新加载,跑一次前向传播,比对输出形状与数值;
- 失败处理:按上面的排错清单逐条对照,先查类定义和设备,再查尺寸与模式。
总结
PyTorch 保存模型的核心是先想清楚用途,再选方法。只存权重的 state_dict 法最通用,记住"重建模型—灌入权重—切评估模式"三连;完整模型法代码最短但绑定环境,只适合可信的临时快照;TorchScript 面向脱离 Python 的生产部署,取舍在性能与控制流兼容之间。
要点带走:
- 默认用
torch.save(model.state_dict(), path)存权重; - 加载必须
model.eval(),跨设备用map_location; - 完整模型依赖 pickle,来源不明的
.pth不要加载; - 长期归档和跨版本,优先
state_dict或 TorchScript。
常见问题
Q:state_dict 和完整模型到底该选哪个?
A:绝大多数场景选 state_dict,它文件小、跨版本稳、能换结构加载。只有本地临时快照、且环境污染可控时,才考虑存完整模型图省事。
Q:加载后推理结果和保存前对不上,怎么排查?
A:先确认调用了 model.eval() 关闭 dropout 和批归一化的训练行为;再确认输入预处理一致;最后用同一批输入对比输出,定位是模式问题还是权重问题。
Q:模型在 GPU 训练、CPU 机器能加载吗?
A:能。保存权重时不受影响,加载时给 torch.load 传 map_location="cpu" 即可把张量映射到 CPU。完整模型法同理。
延伸学习
- 想补整体 AI 概念,可以系统学一遍 AI 人工智能教程;
- 想看社区里 PyTorch 的入门整理,翻 人工智能的基石——pytorch 这篇笔记;
- 想系统学一遍,可以了解 AI零基础入门:人人都能用上的人工智能课。



