
 TRAE-AI编程

做运营或数据分析时,经常要算某个分类在总量里占多大比例,以及这个比例相比上一期是升了还是降了。用 SQL 语句怎么算出变化的 share,核心就是把「当期占比」和「上期占比」分别算出来再相减。下面给出三种可落地的写法:窗口函数、子查询加自连接、以及用 CTE 分步算,任选一种都能落地。无论哪种写法,都要先避开整数除法截断和除零两个高频坑,必要时用 CASE 兜底。掌握这三种方法,绝大多数占比同比、环比的需求都能直接套用,不必每次都从头推导。
先看结论
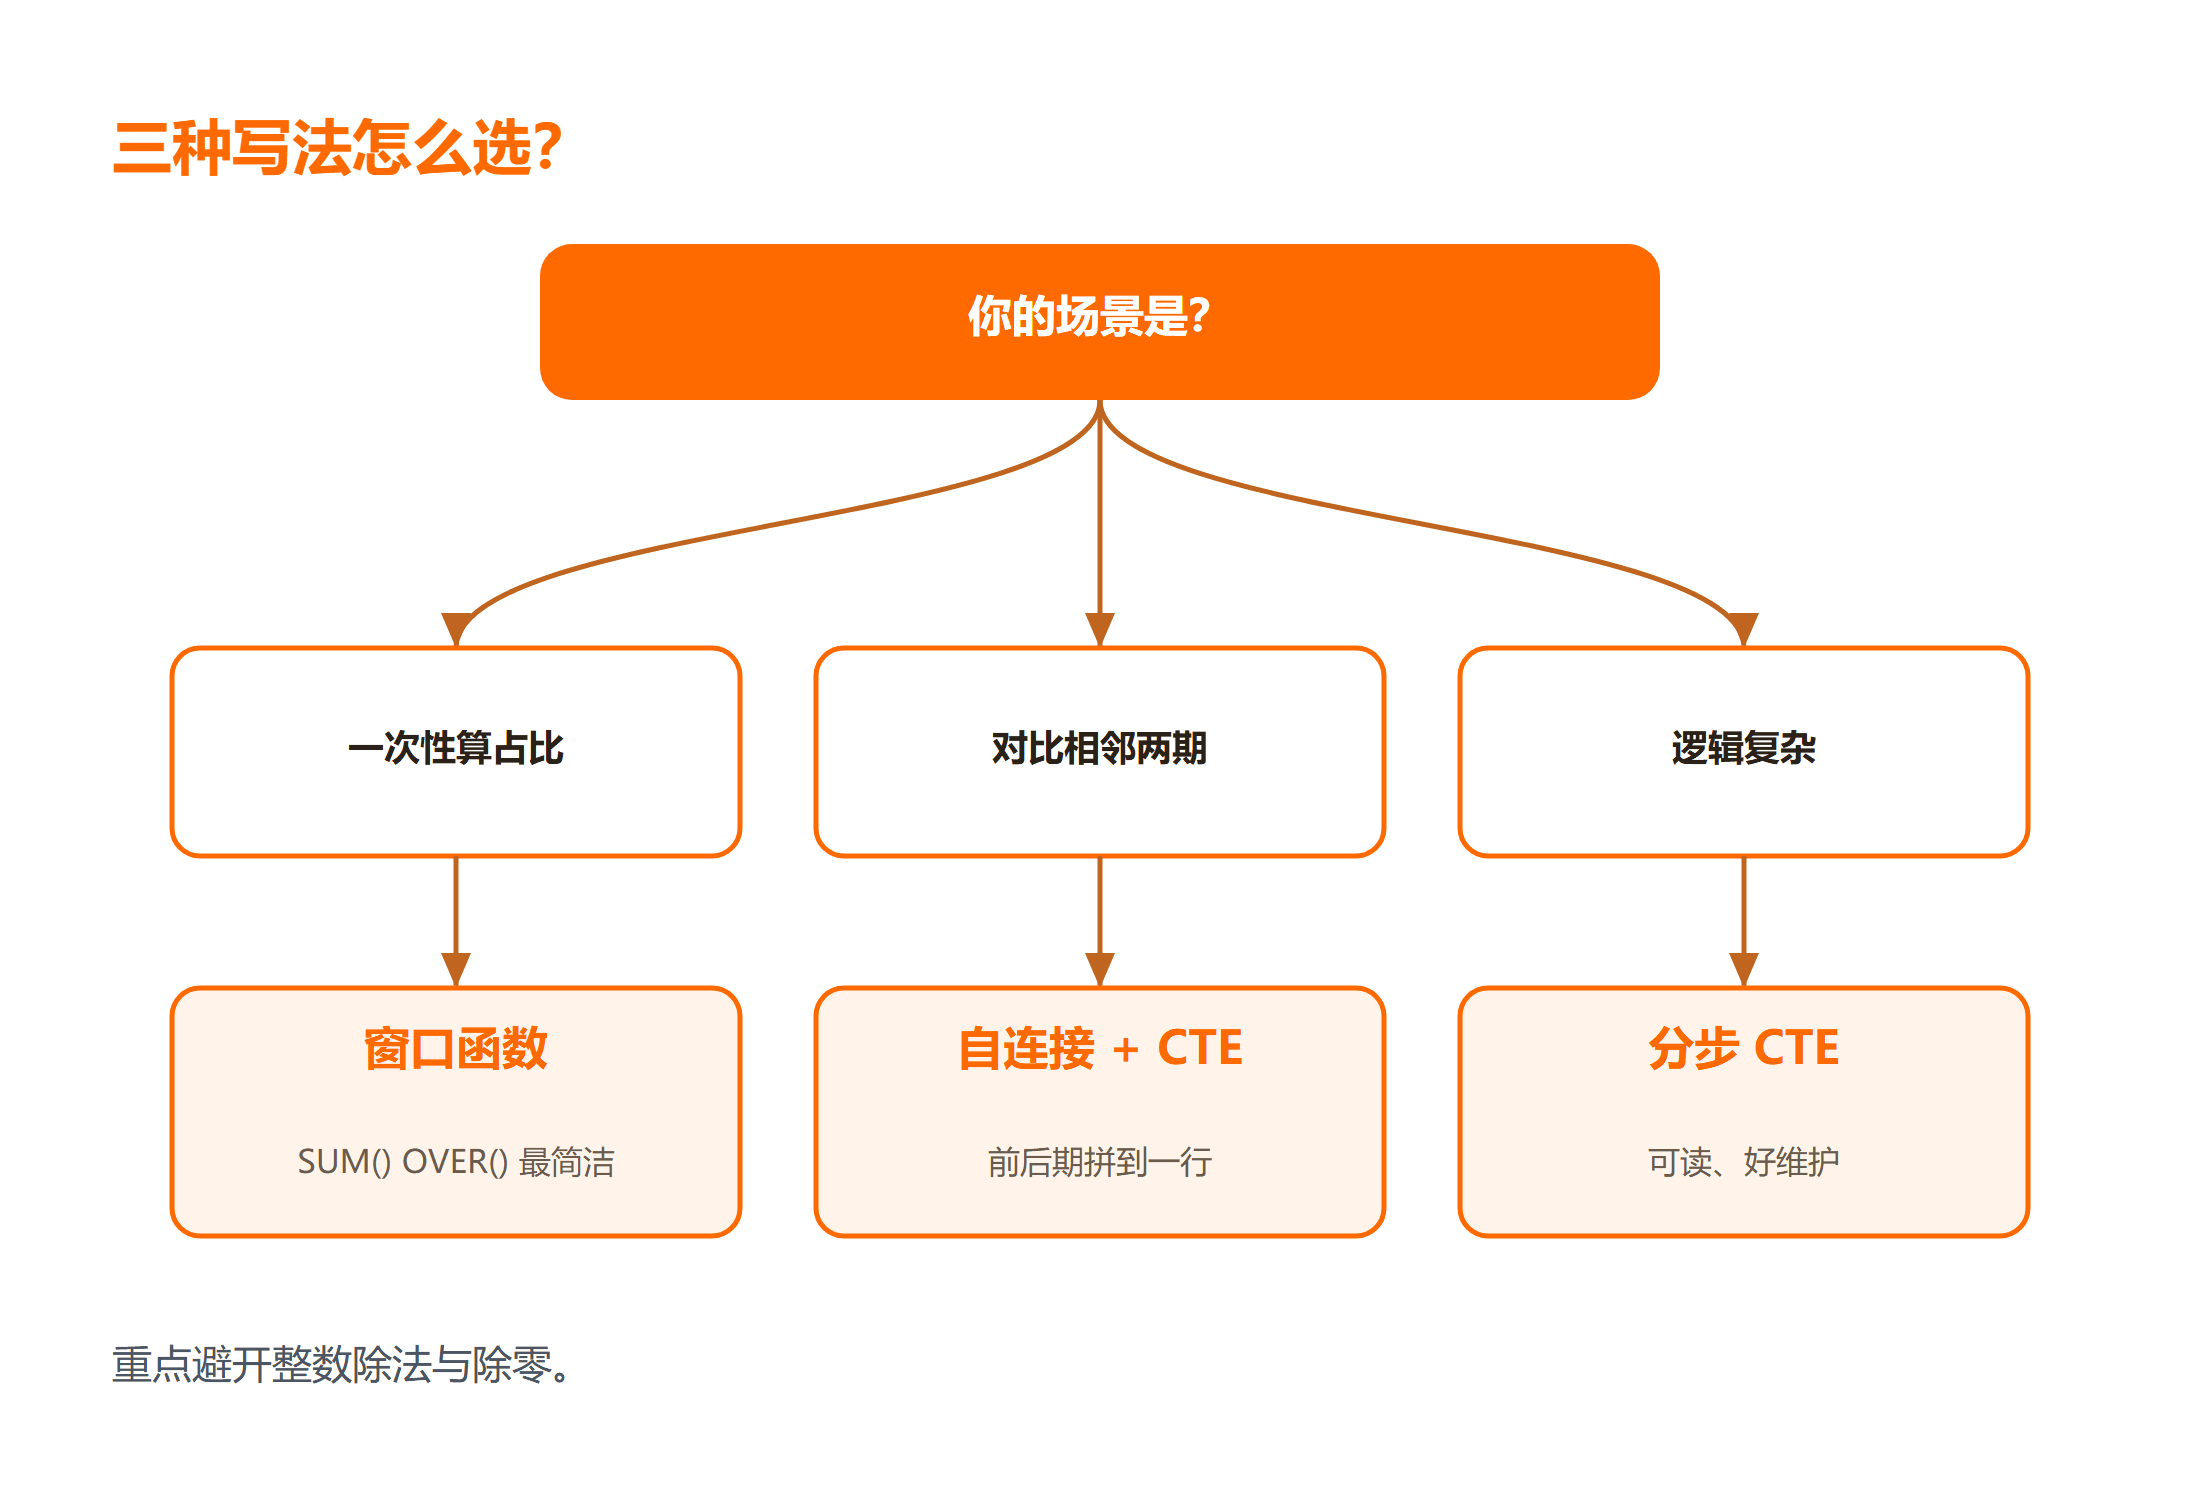
- 变化的 share 等于当期占比减去上期占比,本质是两次占比的差。
- 窗口函数 SUM() OVER() 最简洁,适合一次性算出每行占比。
- 子查询加自连接能清晰对比相邻两期,可读性好。
- CTE 分步写法最稳,复杂逻辑不容易写错。
- 占比记得乘 100 转成百分比,并处理好除零。
一、最小场景与预期行为
假设有一张每日分类销量表,结构如下:
CREATE TABLE daily_sales (
  dt DATE,
  category VARCHAR(20),
  amount INT
);
目标是:对每一天,算出每个 category 的 amount 占当天总量的比例,再和前一天的比例对比,得到变化的 share。预期结果是每行带两个字段:当前占比和占比变化量。把这段 SQL 当成一条命令在客户端运行,就能看到对比输出。参考 MySQL 速查手册 能快速核对聚合函数写法。
这里 daily_sales 只是最小示例,真实业务里 dt 可能是带时区的时间戳,需要先 truncate 到天再分区。category 也可能是多级的(例如大类+小类),这时 PARTITION BY 要带上对应维度。先把「分母」定义清楚——到底是当天总量、当周总量还是全局总量——占比才有意义,否则算出来的 share 会和自己预期对不上。
二、先用最稳的实现:窗口函数
最简洁的写法是窗口函数,一次算出当天总量和每行占比:
SELECT
  dt,
  category,
  amount,
  amount * 1.0 / SUM(amount) OVER (PARTITION BY dt) AS share_now
FROM daily_sales
ORDER BY dt, category;
这里 SUM(amount) OVER (PARTITION BY dt) 就是当天总和,amount 除以它得到 SQL 占比计算的结果。乘 1.0 是为了避免整数除法把比例截断成 0。这是 sql 计算变化的 share 的第一步,先把当期占比拿到手。
窗口函数还有个好处:它不折叠行,所以你能同时拿到「每行自身的占比」和「整组的总和」,方便在应用层再做二次加工,比如只保留占比超过某个阈值的行。对于按月、按地区的多维度占比,只要在 PARTITION BY 里叠加维度列即可,写法几乎不变,比自连接好维护。
三、替代方案与取舍
要算变化量,需要把当期和上一期放同一行。用自连接最直观:
WITH cur AS (
  SELECT dt, category,
         amount * 1.0 / SUM(amount) OVER (PARTITION BY dt) AS share_now
  FROM daily_sales
),
prev AS (
  SELECT dt, category,
         amount * 1.0 / SUM(amount) OVER (PARTITION BY dt) AS share_prev
  FROM daily_sales
)
SELECT c.dt, c.category,
       c.share_now,
       p.share_prev,
       (c.share_now - p.share_prev) AS share_change
FROM cur c
LEFT JOIN prev p
  ON p.dt = DATE_SUB(c.dt, INTERVAL 1 DAY)
 AND p.category = c.category
ORDER BY c.dt, c.category;
自连接把前后两天拼到一行,share_change 就是变化比例 SQL 的结果。CTE 写法把占比计算拆成 cur 和 prev 两步,逻辑清楚,后期要加过滤条件也方便。
如果你用的是 MySQL 8 以前的版本,窗口函数不可用,就只能走自连接或子查询的写法。这时要特别注意日期偏移的写法:DATE_SUB 在 MySQL 里可用,PostgreSQL 要用 dt - INTERVAL '1 day',SQL Server 用 DATEADD(day,-1,dt)。跨数据库迁移这类查询时,最容易被坑的就是日期函数不通用,建议先在目标库里单独验证 DATE_SUB 那段。
四、反例、边界和常见失败
第一个常见失败是整数除法。amount 和 SUM 都是整数时,很多数据库会做整除,比例直接变成 0 或 1。解决方法是乘 1.0 或把字段声明成 DECIMAL,强制走浮点除法。
第二个边界是除零。某天总量为 0 时,除法会报错或得到 NULL。稳妥写法加一个判空:
SELECT dt, category,
       CASE WHEN SUM(amount) OVER (PARTITION BY dt) = 0 THEN 0
            ELSE amount * 1.0 / SUM(amount) OVER (PARTITION BY dt) END AS share_now
FROM daily_sales;
第三个反例是误用 GROUP BY。有人先 GROUP BY dt, category 再想算占比,结果失去了「当天总量」的上下文,占比算不出来。窗口函数不折叠行,所以最适合这类占比计算。
还有一个边界:当某 category 当天有数据、前一天没数据时,自连接会得到 NULL 的 share_prev,share_change 也随之是 NULL。这种情况在新增分类上线第一天必然出现,不要当成 bug。前端展示时把 NULL 当成「无上期可比」而不是 0,更符合直觉,也避免误导业务方以为占比从 0 涨到了某个值。
五、用输入输出验证结果
造一小份数据验证逻辑是否正确:
INSERT INTO daily_sales VALUES
('2026-11-08', 'A', 30),
('2026-11-08', 'B', 70),
('2026-11-07', 'A', 40),
('2026-11-07', 'B', 60);
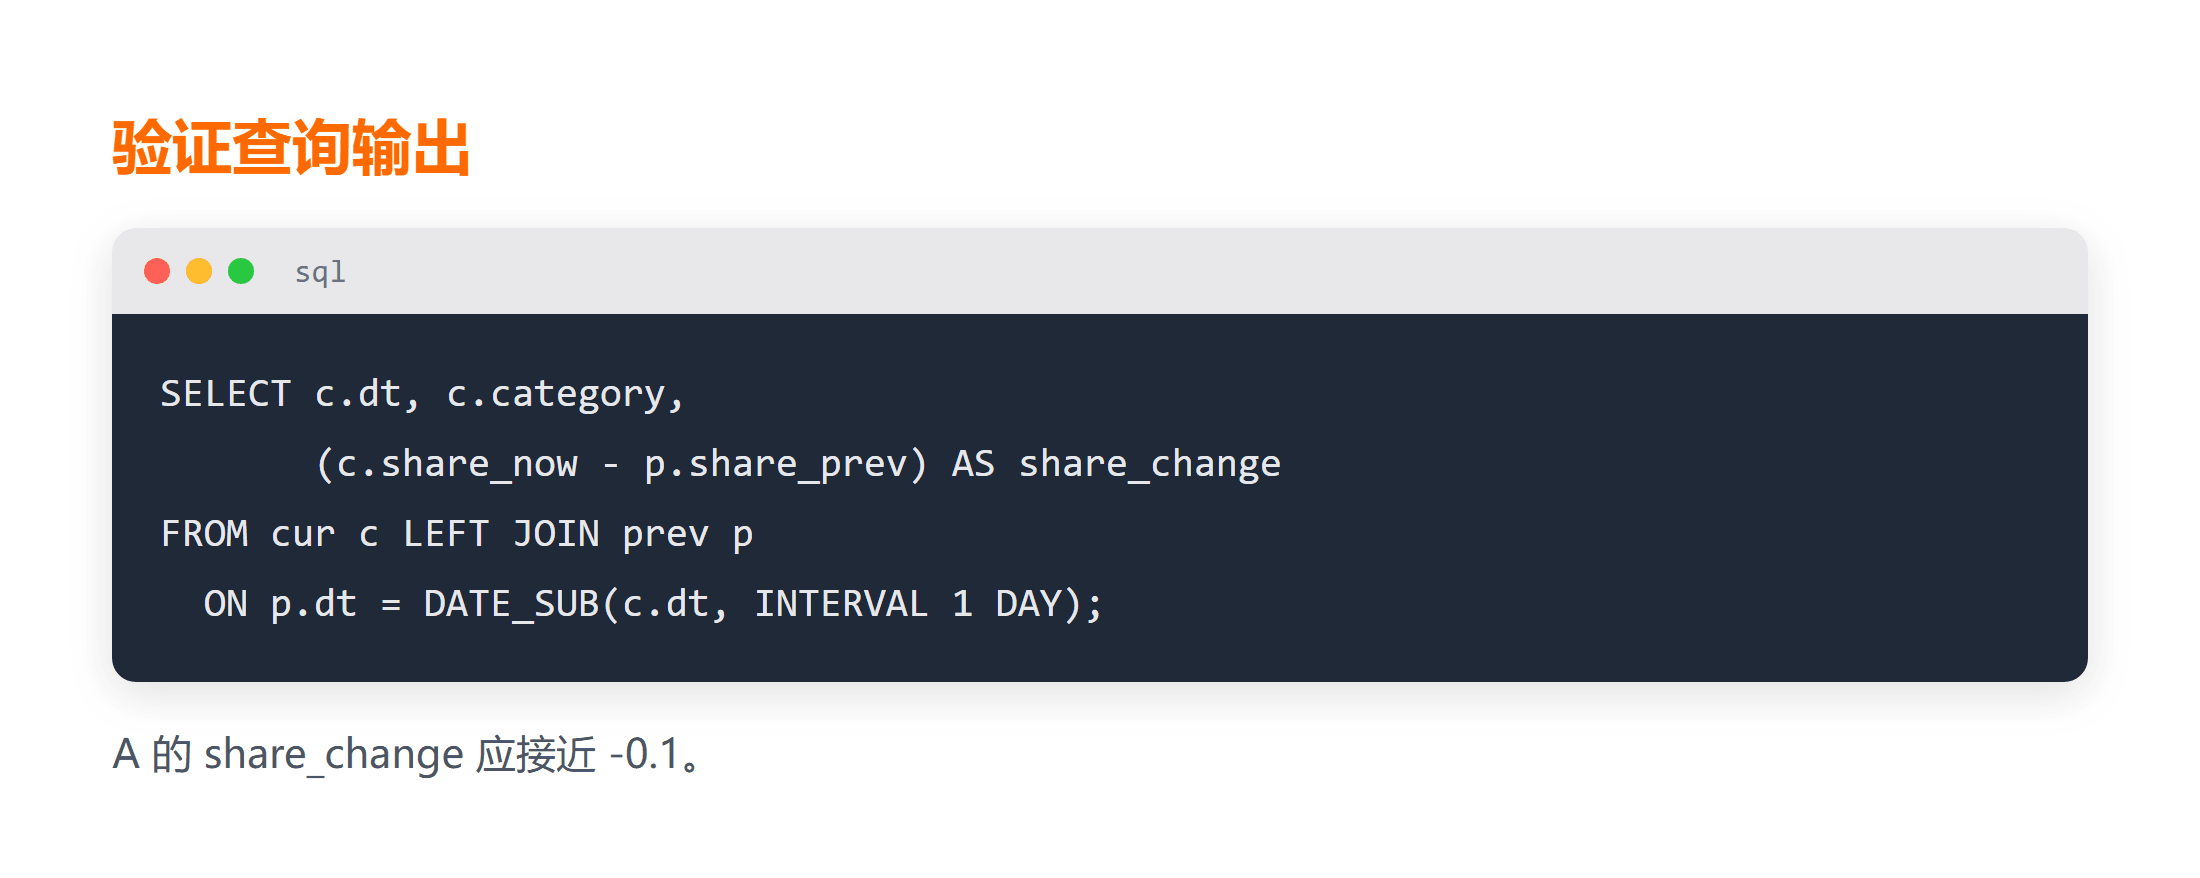
2026-11-08 当天 A 占比 30/(30+70)=0.3,2026-11-07 是 40/(40+60)=0.4,所以 A 的变化 share 应是 -0.1。在本机运行上面的自连接查询,share_change 接近 -0.1 就说明逻辑正确。若结果偏离,优先检查 DATE_SUB 的区间和连接条件是否对齐。
写复杂查询前,先用 SQL格式化工具 把长 SQL 排版理清,能更快看出 PARTITION BY 与 JOIN 的配对有没有写错,也方便贴给同事复查。
最后提醒:变化的 share 是相对指标,受基数影响很大。一个占比从 1% 涨到 2% 看似翻倍,绝对量可能只是多卖了几单;而占比从 80% 降到 70%,绝对量可能依旧可观。给业务方汇报时,建议同时给出占比变化和绝对量变化,避免被相对数字误导。这也是为什么查询输出里最好保留 amount 本身,而不只输出 share_change。
总结
用 SQL 计算变化的 share,思路只有两步:先分别算出当期占比和上期占比,再做差。窗口函数 SUM() OVER() 最适合一次性拿占比,自连接或 CTE 最适合把相邻两期拼到一行算变化量。写的时候重点避开整数除法和除零两个坑,必要时用 CASE 兜底。掌握这三种方法,绝大多数占比同比、环比的需求都能直接套用。
常见问题
Q:为什么我的占比算出来全是 0 或 1?
几乎都是整数除法导致的。amount 和 SUM 都是整数时,数据库会做整除。把分子乘 1.0 或把字段定义为 DECIMAL,强制走浮点除法即可。
Q:窗口函数和 GROUP BY 哪个更适合算占比?
算占比优先用窗口函数。GROUP BY 会把行折叠掉,丢失「当天总量」的上下文;窗口函数保留每一行,还能用 PARTITION BY 划定分组范围。
Q:变化 share 出现 NULL 是哪里错了?
通常是某天总量为 0 触发了除零,或自连接的上期数据没匹配上。用 CASE 处理除零,并核对连接条件里的日期偏移是否正确。
延伸学习
- SQL 入门课程(配套课程,系统学一遍聚合与窗口函数)
- SQLyog 连接 MySQL 报错 2058?caching_sha2_password 兼容问题解决教程(笔记,连库报错的排查参考)
- MD5/SHA哈希工具(在线工具,验证字符串哈希再回写 SQL)



