 TRAE-AI编程

大模型评测基准是一组固定的题目和评估规则,用来客观比较不同模型在某个能力上的强弱,而不是凭感觉说谁更好。你在选模型时常遇到这样的困惑:排行榜第一的模型,到我业务里为啥不灵。本文用初学者能跟上的方式,讲清基准到底是什么、评测流程怎么跑、三类主流评测测什么,以及选基准前要问自己的三件事和常见坑。看完你能看懂榜单背后的口径,不再被单一排名带节奏。今天这篇文章,编程狮就把这块讲透。
一、评测基准到底是什么
用一句判断句给定义:评测基准是包含标准数据集、统一打分方式的评估方案,它把“模型好不好”变成一个可复现、可比较的数字。
打个比方,就像用同一张考卷考不同学生,分数才有可比性。如果各家自己出题自己改卷,排名就毫无意义。模型评测也是同理,统一题目和评分标准,结论才站得住。
1.1 触发条件
当你要在多个候选模型里做选型,或想跟踪自己模型迭代是否变强时,基准最值得用。典型场景是技术选型汇报、版本回归对比、对外宣传的硬指标支撑。
⚠️ 注意:基准分数高不等于业务好用。榜单多测通用能力,你的场景若是客服、合同审阅等垂直任务,更要看领域评测。想补齐 AI 基础,可先过一遍 人工智能教程。
1.2 常见误解
有人认为“分数第一就是最强”。其实关键在于评测集是否和你的数据分布接近,以及分数有没有被刷过。这也是它和盲目试用的区别:基准至少给了统一口径。
二、评测流程怎么跑(最小示例)
下面用伪代码展示跑一次基准的核心流程。这段代码演示的是加载数据集、逐题推理、统一打分的主干。
dataset = load_benchmark("mmlu")          # 第一步:加载标准数据集
for item in dataset:
    prompt = build_prompt(item.question)   # 第二步:组装提示
    answer = model.generate(prompt)        # 第三步:模型推理
    score = grade(answer, item.gold)       # 第四步:按规则打分
print(sum(score) / len(dataset))          # 输出平均准确率
上面这段做的是把每道题交给模型,再用标准答案核对,最后汇总正确率。预期结果(未在本机执行,依据公开论文与官方文档)是打印出一个 0 到 1 之间的准确率,数值越高代表在该基准上越强。
💡 小提示:很多榜单要求关闭联网和少样本提示,保证公平;如果开着搜索或给了示例,分数就不可比了,跑之前一定看清规则。
三、三类主流评测测什么
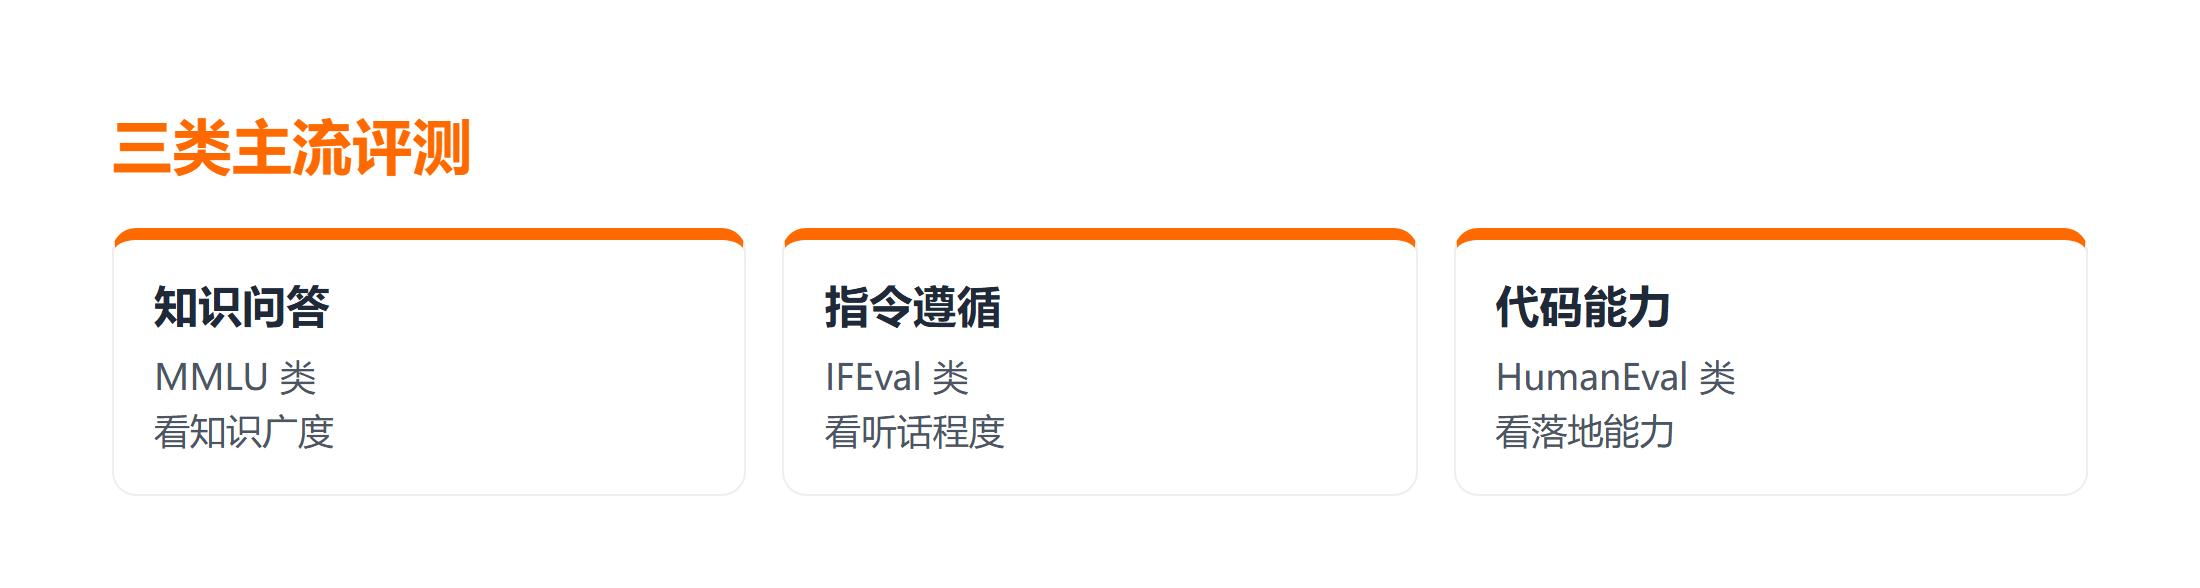
目前最常被引用的有三类:知识问答类测知识广度,指令遵循类测“听不听话”,代码类测落地能力。
3.1 版本与适用边界
知识类(如 MMLU)覆盖多学科选择题,适合看底座水平;指令类(如 IFEval)看格式约束遵守;代码类(如 HumanEval)看函数级生成。适用边界是:选哪类取决于你想证明什么能力,不要拿单类当全能。关于模型结构背景,可参考 神经网络类型。
3.2 失败的表现
失败通常有两种:一是模型在公开集上刷很高,换私有题就垮,说明过拟合榜单;二是自动打分把格式错判对,说明评测口径有漏洞。两者都要靠交叉验证集和人工抽检来发现。
四、选基准前先想清三件事
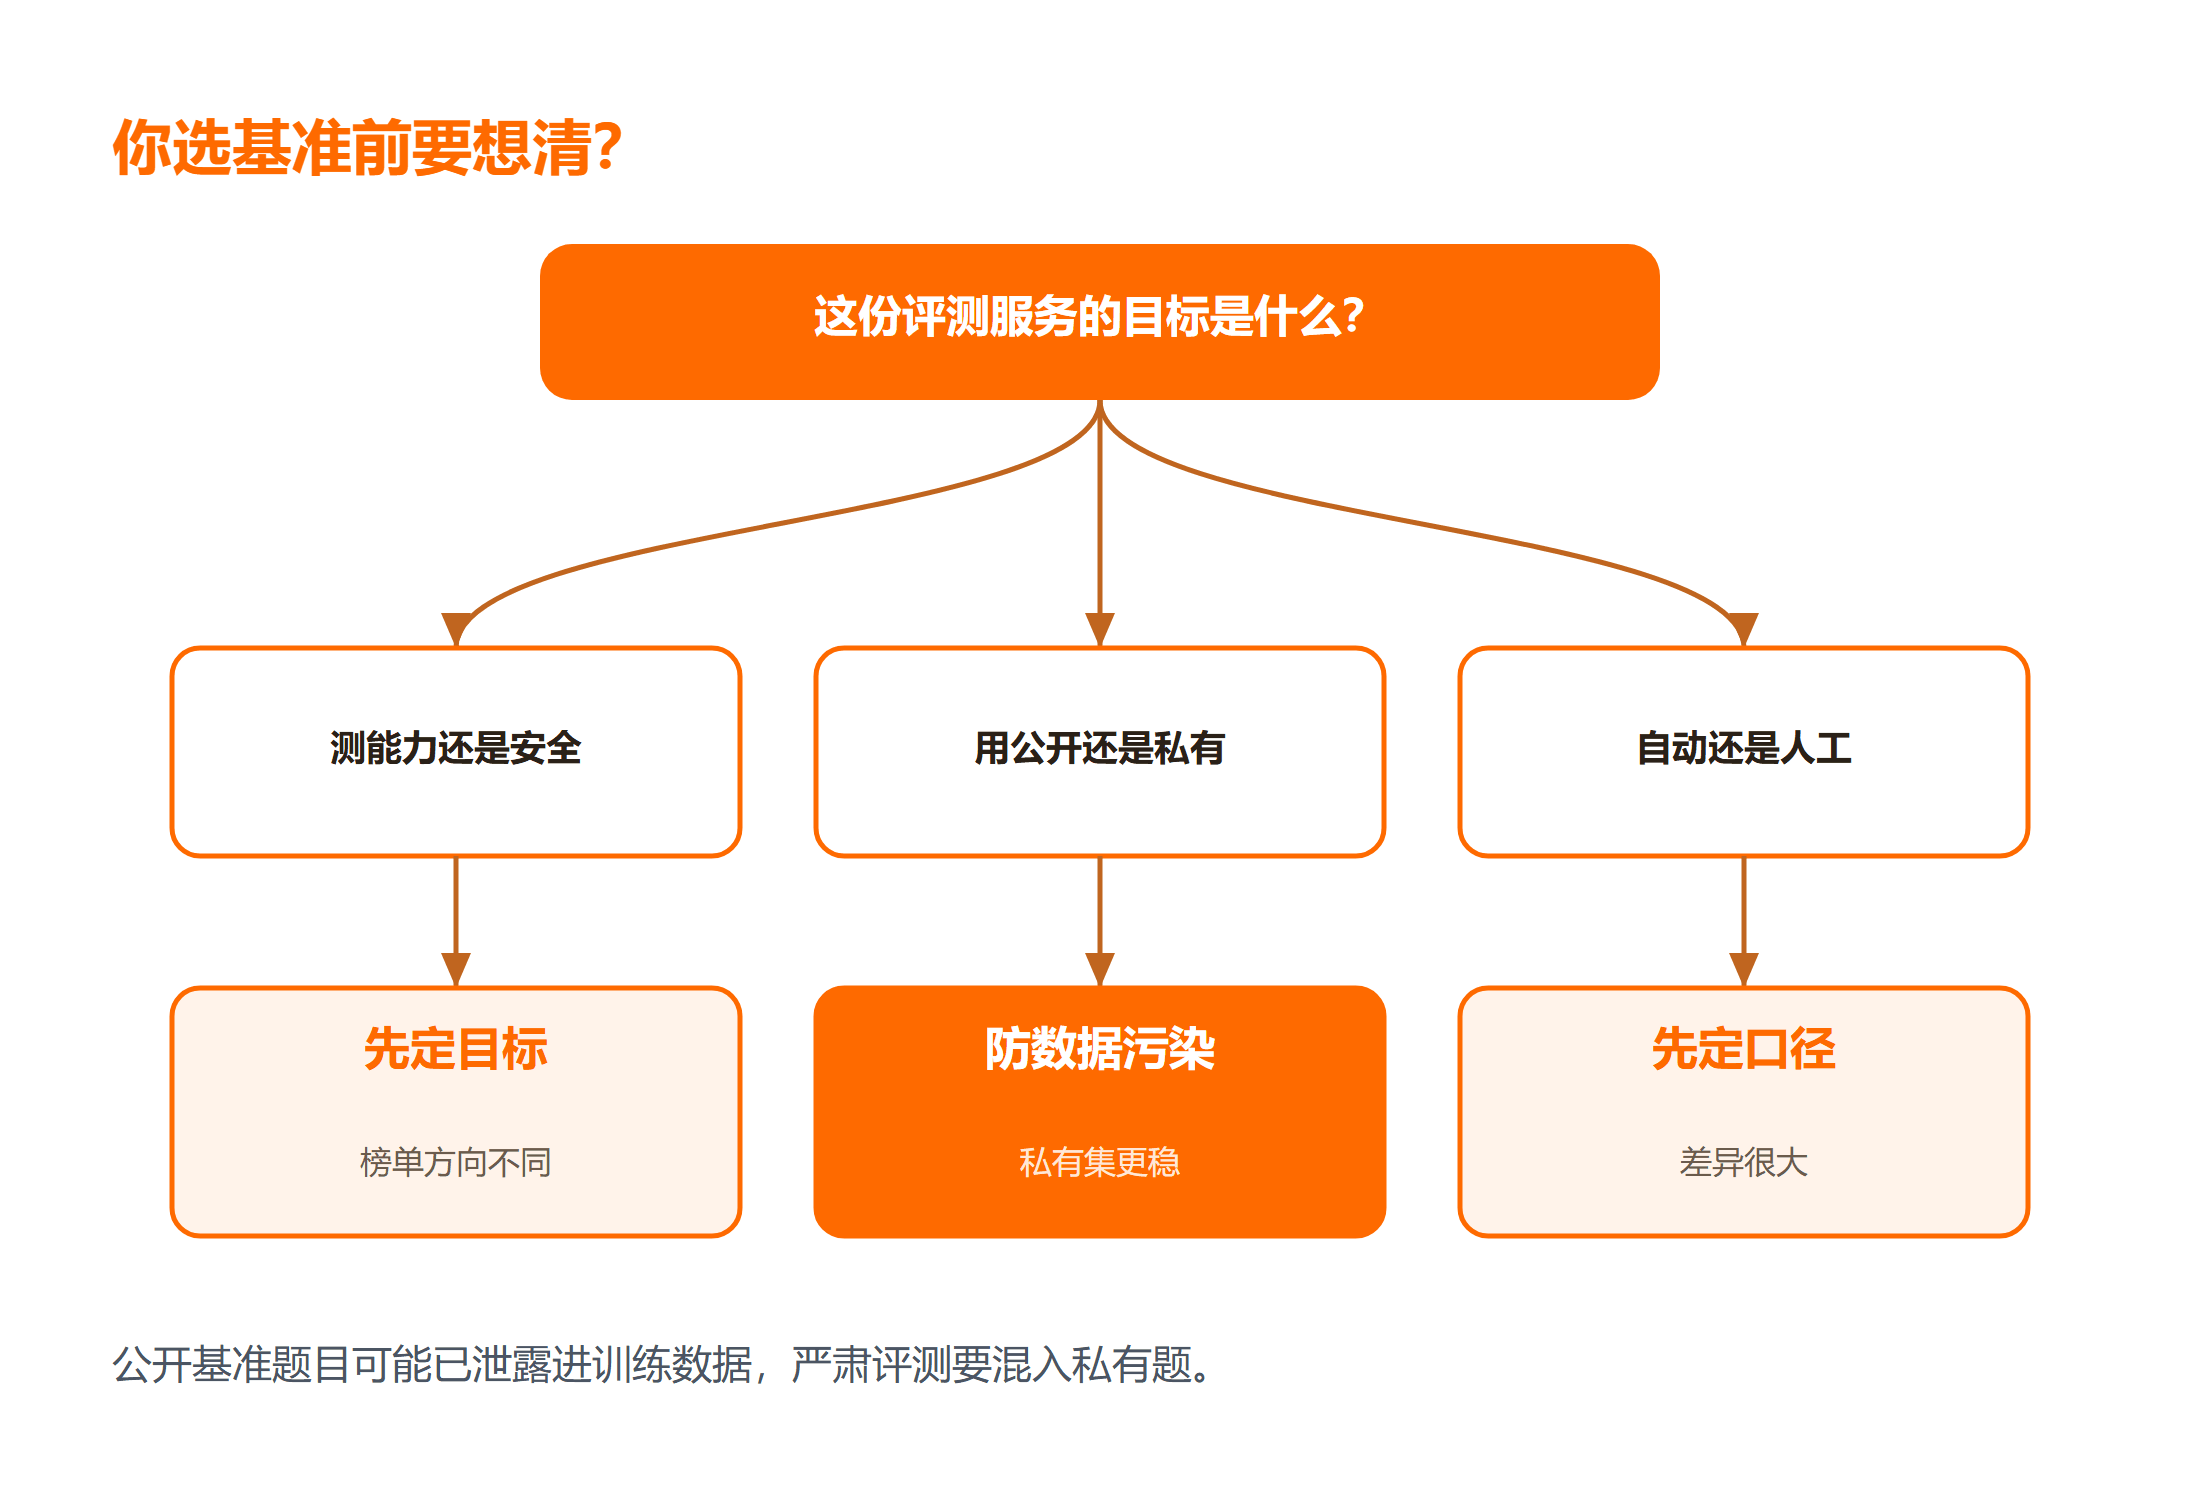
第一,你测的是能力还是安全?两类榜单目标不同,混着看会误判。第二,用公开集还是私有集?私有集能防数据污染,但成本更高。第三,自动打分还是人工?口径差异可能很大。
具体怎么跑代码类评测?你先配置好评测框架,把 HumanEval 这类题目和待测模型接进去,运行生成后再用单测判对错。检查每题输出是否符合签名,验证通过率后再横向比较不同模型。真实项目里还会把评测脚本接进 CI,每次提交自动运行,防止改坏已有能力。把“代码能力”单独拎出来看,比混在综合榜里更能暴露模型在落地任务上的短板。评测不是跑一次就完,要当成持续监控。
⚠️ 边界提醒:公开基准的题目可能已泄露进训练数据,导致“成绩虚高”。严肃评测要混入私有题或定期换榜,否则数字会失真。
五、落地时容易踩的坑
- 现象:榜单第一,业务拉胯。原因:分布不匹配。修复:用你的真实样本做小范围评测,再决定是否采用。
- 现象:换个评测脚本分数大变。原因:打分口径不一致。修复:固定评分函数和提示模板,写进评测报告。
- 现象:分数虚高。原因:训练数据污染了基准。修复:引入未公开的保留集,定期重测验证。
# 加一道私有保留集校验的片段(非完整脚本)
public = run_benchmark(model, "mmlu")         # 公开集分数
private = run_benchmark(model, "my_holdout")  # 私有保留集
if public - private > 0.1:
    print("疑似污染:公开集明显偏高")
# 预期当差值过大时报警(未在本机执行)
总结
大模型评测基准是用统一题目和打分规则客观比较模型能力的方案,核心价值是让“谁更强”变得可复现。落地记住三点:分数高不等于业务好用,要看数据分布;公开集可能被污染,严肃评测加私有保留集;按你想证明的能力选知识、指令或代码类基准。想系统理解 AI 术语,可补 AI 术语翻译笔记。
要点带走:
- 基准是“统一考卷”,没有统一口径就没有可比性;
- 知识、指令、代码三类测的能力不同,别拿单类当全能;
- 公开榜可能数据污染,私有保留集是防虚高的关键。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何调用模型评测;
- 想理解 AI 基础,读 AI 核心概念笔记;
- 动手前补 AI Python 课程 了解工程实现。
常见问题
Q:MMLU 分数高就能代表模型聪明吗?
A:只能代表它在多学科选择题上强,反映知识广度和底座水平。但它不测指令遵循、不测代码、不测安全,离“什么都会”差得远,选型时要配合其他基准一起看。
Q:为什么同一模型在不同榜单排名差很多?
A:因为各榜测的能力、题目难度、打分口径都不一样。有的偏学术知识,有的偏中文指令,模型擅长项不同,排名自然波动,单看一个榜容易误判。
Q:自动打分靠谱吗?
A:多数情况可用,但有口径风险:格式错、部分对可能被误判。关键任务要抽一部分人工核对,并固定评分函数和提示模板,保证前后可比。