 免费 AI IDE

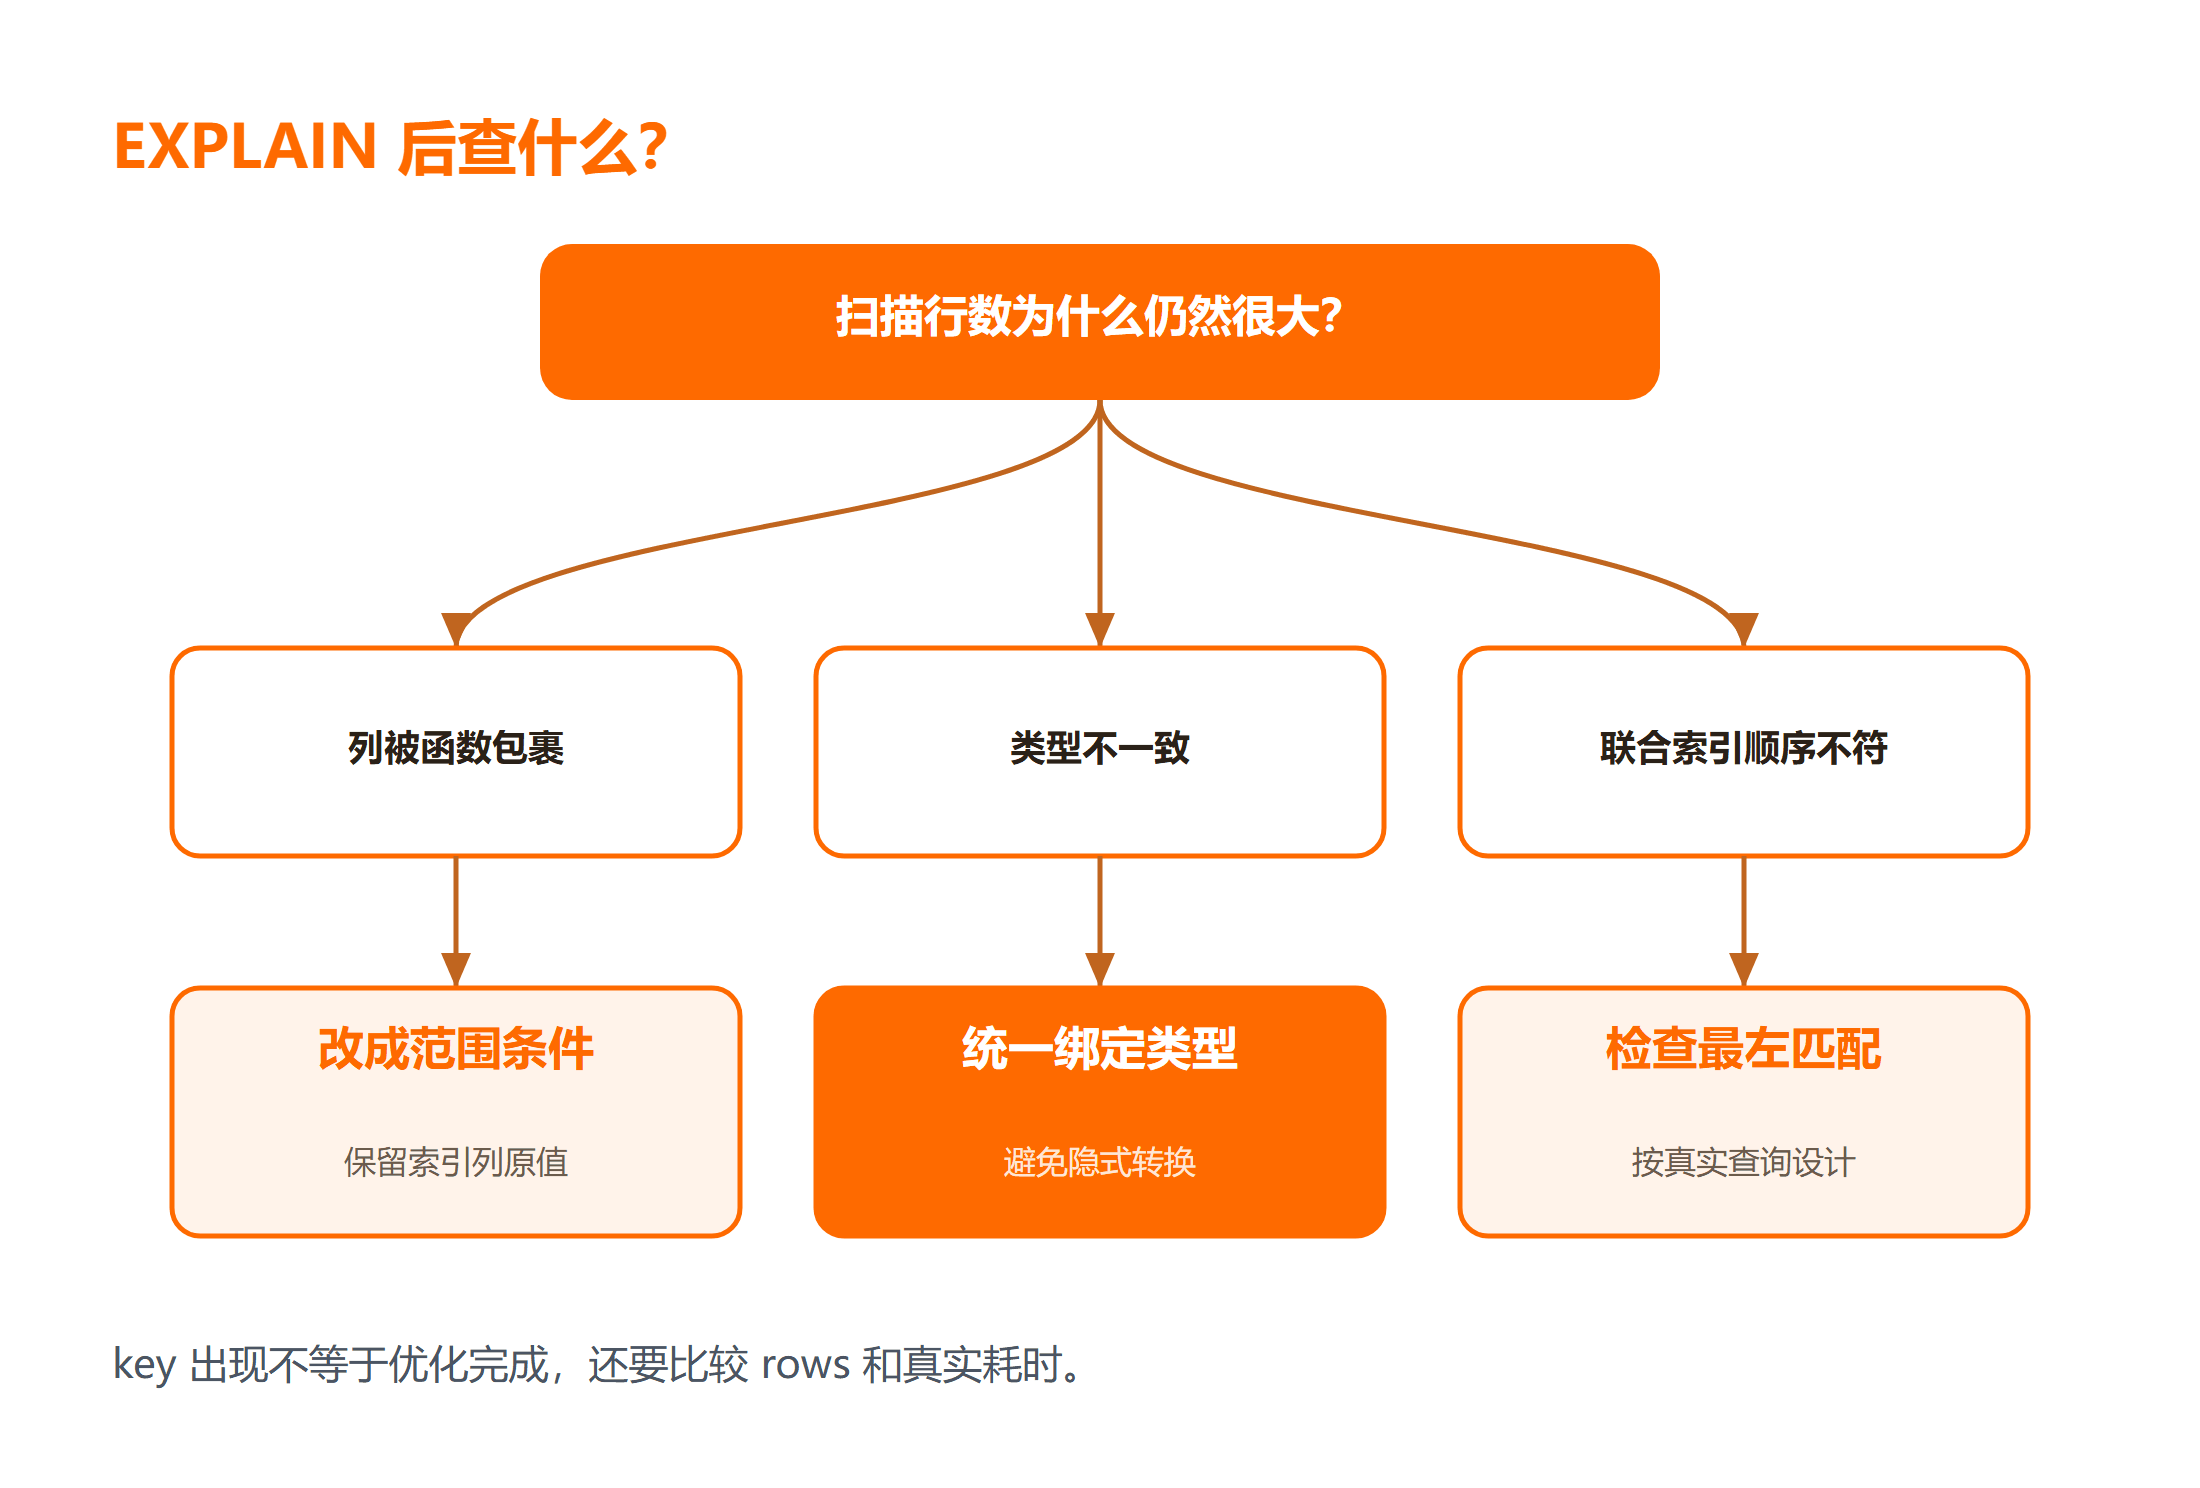
MySQL 已经建了索引却仍然慢,先不要继续加索引。用 EXPLAIN 看实际访问类型、候选索引、扫描行数和过滤比例,再检查条件列是否被函数包裹、类型是否一致、联合索引是否符合最左匹配。本文用一张订单表演示五类常见原因,并把“看起来用了索引”和“真正减少扫描”区分开。 本文以 MySQL 8.0.18 及以上的 EXPLAIN ANALYZE 为主要工具;旧版本可以先用 EXPLAIN,但无法得到同样的真实执行时间与循环次数,结论要结合版本说明。生产库若无法直接执行分析语句,先在数据分布接近的副本上复现,并保留表结构、统计信息时间和查询参数。
一、先用EXPLAIN确认实际计划
索引是否存在不是结论,优化器会根据统计信息和成本选择访问路径。执行计划至少记录type、key、rows和Extra;全表扫描不一定错误,小表或返回大部分数据时可能更快。
# 建议先保存表结构和统计信息
EXPLAIN SELECT id, total FROM orders WHERE user_id = 42;
运行后应看到: EXPLAIN 显示 type、key、rows 和 filtered。
二、不要对索引列直接做函数运算
WHERE DATE(created_at)=... 会让数据库先对每行计算日期,普通索引难以直接定位。把范围写成起止时间,才能让索引按原始列排序工作。
如果这里的基础语法还不熟,可以先查 MySQL 教程,再回到下面的完整示例。
# 可能导致索引利用率下降
SELECT * FROM orders WHERE DATE(created_at) = '2026-09-16';
# 改为范围条件
SELECT * FROM orders WHERE created_at >= '2026-09-16' AND created_at < '2026-09-17';
运行后应看到: 范围条件可使用索引,函数包列通常扩大扫描。
三、类型不一致会触发隐式转换
索引列是整数,参数却以字符串或另一种字符集传入,数据库可能对列做转换。应用层绑定参数时使用正确类型,并用EXPLAIN比较修改前后的rows。
CREATE TABLE orders (id BIGINT PRIMARY KEY, user_id BIGINT, created_at DATETIME, KEY idx_user_time(user_id, created_at));
EXPLAIN SELECT * FROM orders WHERE user_id = 42;
运行后应看到: 参数类型与列类型一致后避免隐式转换。
四、联合索引要符合访问顺序
(user_id,created_at)可以支持先按user_id过滤再按时间范围筛选,但只按created_at查询不能直接使用同样的前缀。设计联合索引前先列出真实查询,而不是把所有列都塞进去。
如果这里的基础语法还不熟,可以先查 MySQL 速查手册,再回到下面的完整示例。
EXPLAIN SELECT * FROM orders WHERE user_id=42 AND created_at >= '2026-09-01';
EXPLAIN SELECT * FROM orders WHERE created_at >= '2026-09-01';
运行后应看到: 联合索引按最左前缀匹配真实查询。
五、用实际数据验证优化结果
MySQL 8.0.18 及以上可用 EXPLAIN ANALYZE 直接执行并返回实际耗时、行数和循环次数;不要再依赖已弃用的 profiling/SHOW PROFILES。
# MySQL 8.0.18+
EXPLAIN ANALYZE SELECT COUNT(*) FROM orders WHERE user_id=42;
# 重点观察 actual time、rows、loops
运行后应看到: EXPLAIN ANALYZE 输出 actual time、rows 和 loops。
如何读 EXPLAIN ANALYZE
重点看 actual time、rows 和 loops,并把执行前后的扫描行数放在同一张表里。key 非空只说明选中了索引,不代表扫描成本已经降低;如果实际行数远大于估算值,先更新统计信息再判断索引设计。
用 EXPLAIN ANALYZE 读真实代价
在 MySQL 8.0.18+ 上运行 EXPLAIN ANALYZE SELECT COUNT(*) FROM orders WHERE user_id=42;,重点记录 actual time、rows 和 loops,并与普通 EXPLAIN 的估算值对照。key 为 NULL 说明没有选中索引;即使选中了索引,也要看实际扫描行数和回表成本。
准备对照数据:相同查询分别使用高选择性用户、低选择性用户和不存在的用户,比较三组计划。若估算行数与实际差异很大,先检查统计信息、数据分布和隐式类型转换,再决定是否调整索引。不要只凭一条快照删除索引。
修改索引后用同一连接、同一参数和相近缓存条件复测,并记录执行时间、扫描行数和锁等待。线上变更应先在副本或低峰窗口验证,准备回滚语句,避免把一次局部优化变成全表重建风险。
怎么判断该选哪条路径
索引是否有效不能只看 key 字段。先用 EXPLAIN 看访问类型和估算行数,再用 EXPLAIN ANALYZE 看真实 rows、loops 与耗时。函数包裹索引列、参数类型不一致、联合索引顺序不匹配和数据选择性过低,都会让优化器放弃或低效使用索引。修改前后必须用同一查询和相近缓存条件对比,避免把缓存命中误认为索引收益。
建立可比较的慢查询样例
创建包含 user_id、status、created_at 的 orders 表并插入具有倾斜分布的测试数据。先对 WHERE user_id=42 运行 EXPLAIN ANALYZE,记录 actual rows 和 loops;再把条件改为 WHERE CAST(user_id AS CHAR)="42",观察索引计划是否变化;最后创建 (user_id,status) 联合索引,分别测试只查 status 和同时查两列。慢查询优化前后必须使用同一参数和数据量。若估算行数与实际差异很大,先更新统计信息,不要直接继续加索引。
四类索引问题如何区分
| 证据 | 更可能的原因 | 下一步 |
|---|---|---|
| possible_keys 有值、key 为空 | 成本估算认为全表扫更便宜 | 检查选择性与数据分布 |
| key 有值、rows 仍很大 | 索引过滤能力不足 | 比较覆盖索引与回表 |
| 条件写函数后计划变化 | 索引列被表达式包裹 | 改成范围或生成列 |
| 估算与实际差异大 | 统计信息过旧或分布倾斜 | 更新统计信息后再验证 |
运行慢查询验证前先记录表行数、索引定义和参数类型。修复后执行同一条命令,检查预期的 rows、loops 与耗时都下降;任何一项反常都要继续排查。生产库执行 DDL 前还要评估锁、磁盘空间和回滚方式,不能把测试库的创建索引命令直接照搬上线。
排错速查
| 症状 | 先检查什么 | 处理建议 |
|---|---|---|
| key 为 NULL | 检查函数、类型和联合索引顺序 | 改写条件后重新 EXPLAIN |
| key 有值仍很慢 | 查看 actual rows、loops 和回表 | 比较覆盖索引与真实数据分布 |
总结
MySQL 索引不生效时,先看执行计划,再排查函数包列、类型转换和联合索引顺序。优化结果要用扫描行数和真实耗时验证,不能因为EXPLAIN显示了一个key就宣布问题解决。
延伸学习
下面三项分别用于系统学习、补充同主题案例和随手查阅;只保留与本文直接相关的资源。
常见问题
Q:全表扫描一定是错误吗?
A:不一定。小表、返回大部分行或统计信息判断全表更便宜时,全表扫描可能是合理选择。
Q:为什么加了索引反而变慢?
A:索引维护有成本,低选择性条件还可能产生大量回表;需要用真实查询和数据量验证。