
 TRAE-AI编程

CUDA 报 RuntimeError,最常见的不是某一行代码写错,而是显存、设备、版本这三类问题在训练或推理时集中暴露。先给结论:排查要先看错误类型——显存不足就减批量或清缓存,设备端断言就查标签越界,版本或驱动问题就对齐 CUDA 与框架版本;别一上来就重装环境。本文按最小示例整理这几类报错的识别与处理,给出几种做法的区别与取舍,并说明适用边界。文中命令与代码为通用示例,未在本文环境逐项实测。
先看结论
先把判断顺序记牢,能省掉大量重装时间。
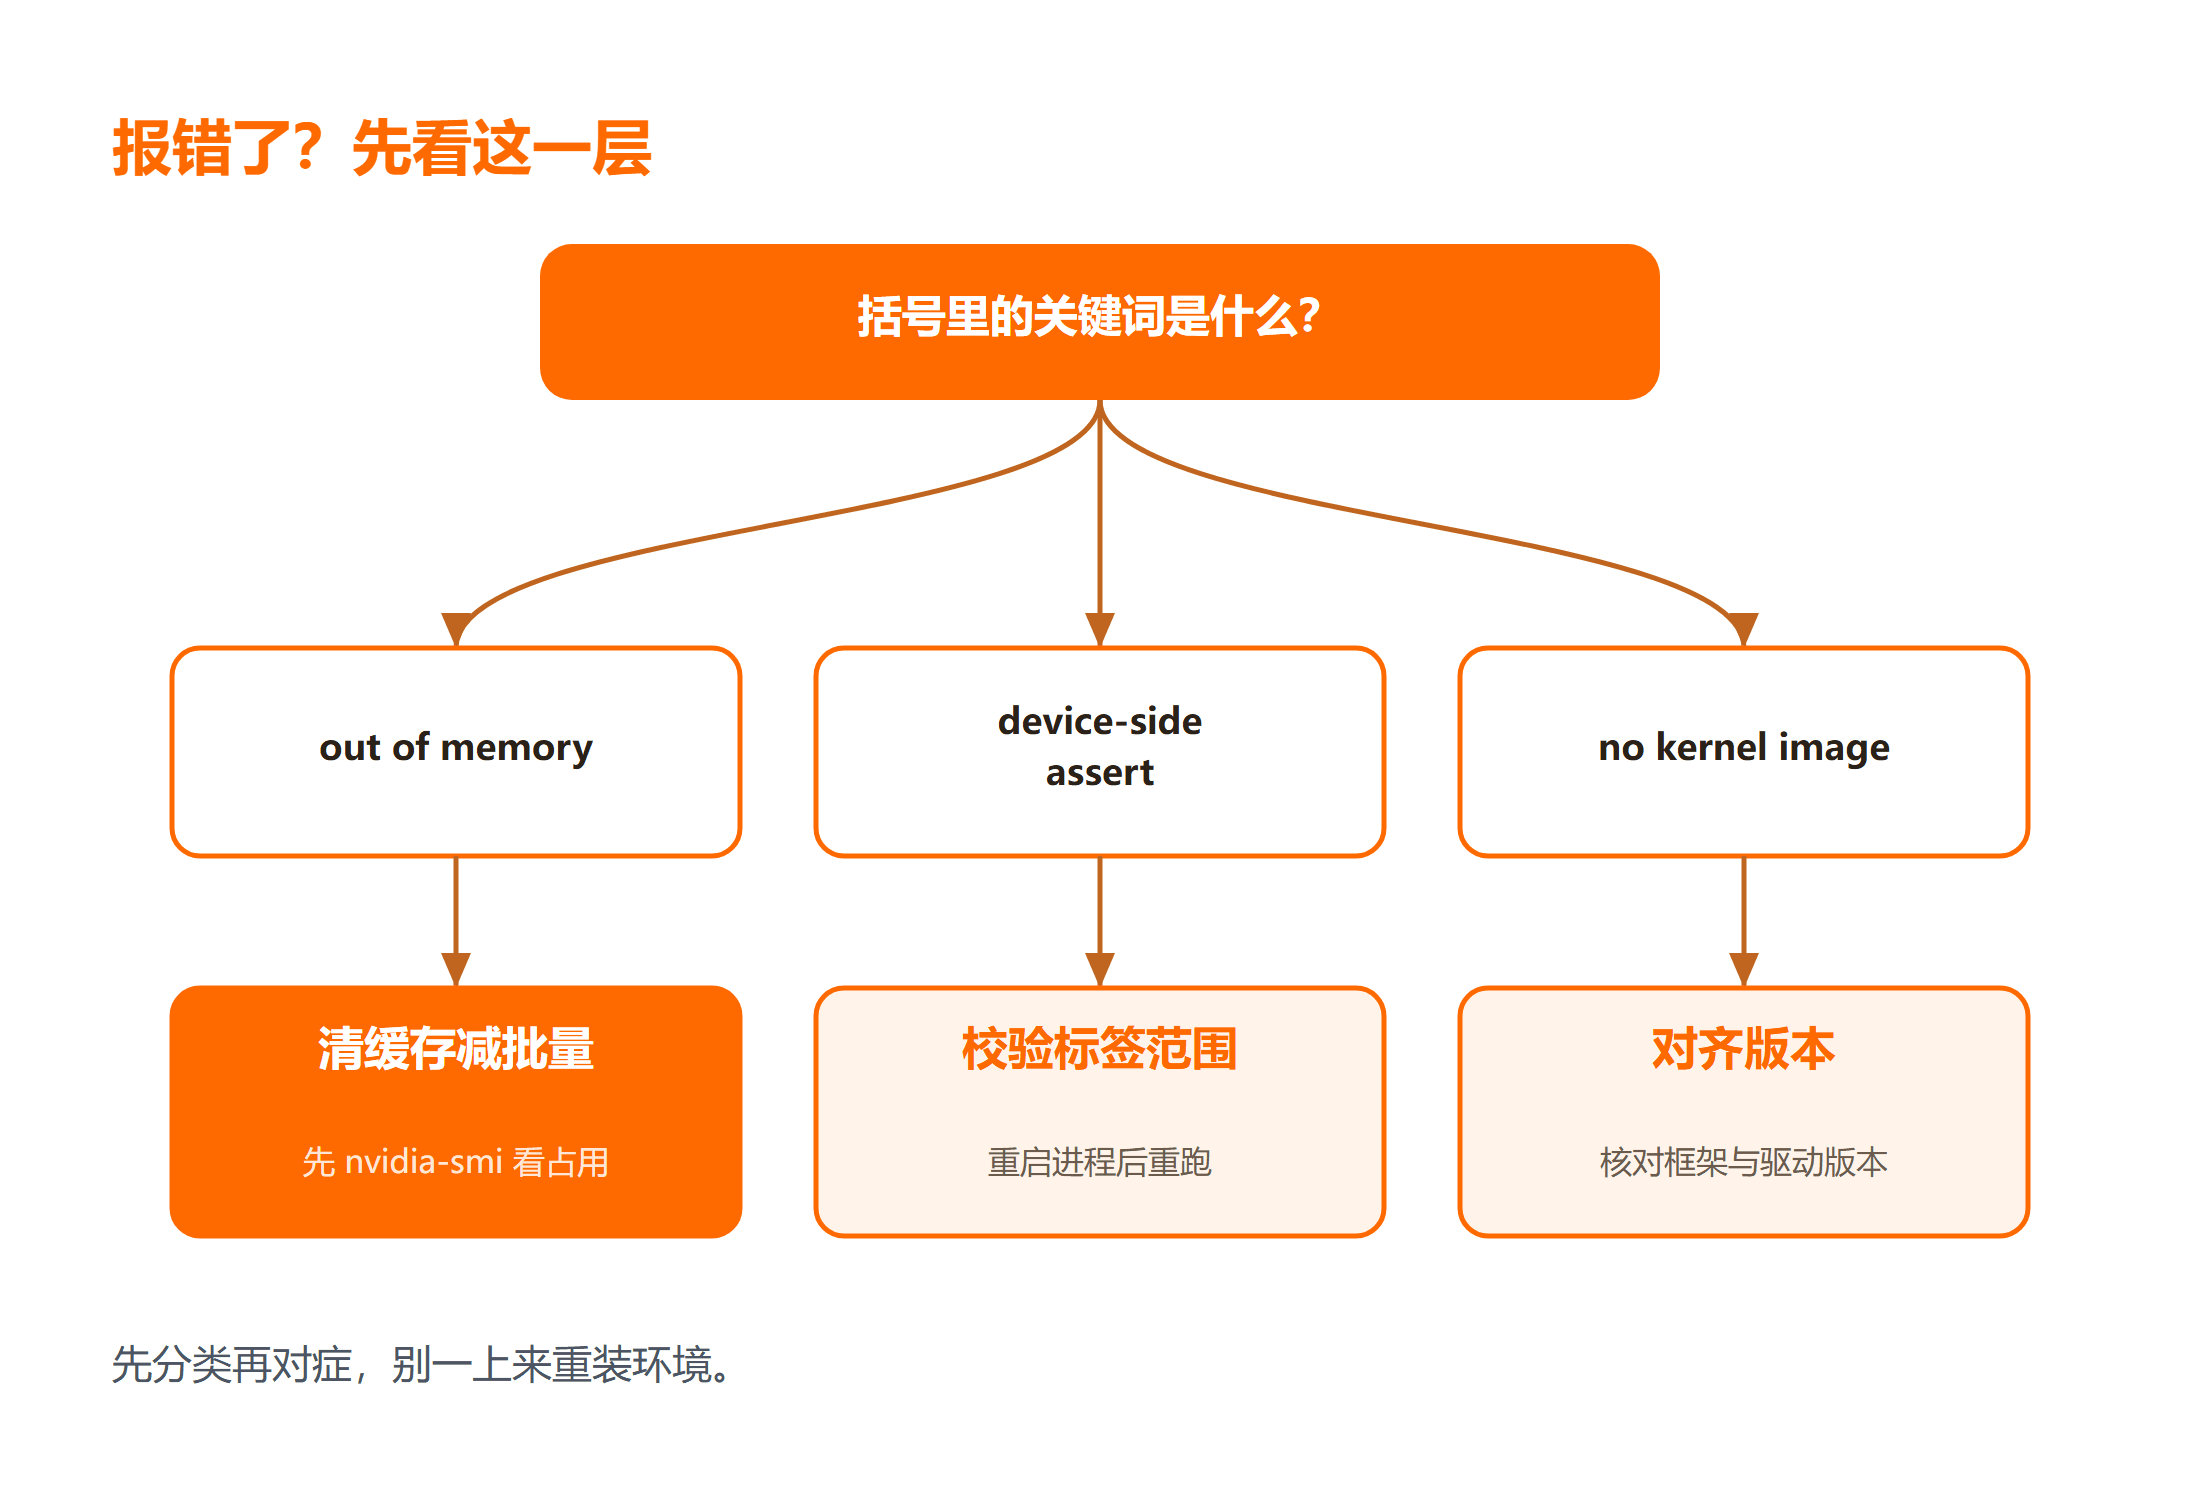
第一,先读错误全文,认准关键词。出现 out of memory 是显存问题,device-side assert 多是标签越界,no kernel image 通常是版本或架构不匹配。想补背景,可过一遍 人工智能概览教程。
第二,按错误类型选手段,不要混用。显存不足和版本不匹配的解法完全不同,套错方向只会越修越乱。
第三,一次只改一个变量。改完批量就先看是否复现,别同时改批量、版本和驱动,否则无法定位是哪个起效。
一、最小场景与预期行为
先准备一段最小场景,用 PyTorch 在 CUDA 上做一个简单计算:
import torch

print("CUDA 可用:", torch.cuda.is_available())
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
x = torch.randn(1024, 1024, device=device)
y = (x @ x).sum()
print("输出设备:", y.device, "值:", float(y))
这段先确认 CUDA 是否可用,再把张量放到 GPU 上计算。预期结果(未在本机执行):能打印 CUDA 可用: True,输出设备显示为 cuda:0。如果第一步就是 False,说明驱动或环境没配好,后面的显存排查都无从谈起。关于框架与设备的基础,可参考 人工智能基础章节。
⚠️ 注意:
RuntimeError只是异常大类,真正的线索在括号里的具体描述。排查前务必把完整报错复制下来,别只看第一行。
二、做法一:显存不足的处理
CUDA out of memory 是最高频的一类,处理有先后之分。
最稳的顺序是:先减小批量大小,再在每轮后清理缓存,最后才考虑换更小的模型:
import torch

torch.cuda.empty_cache()          # 清理未使用的缓存
batch_size = 8                     # 先将批量调小试运行
for x, y in loader:
    x, y = x.to("cuda"), y.to("cuda")
    ...
也可以用命令行看显存占用,判断是不是别的进程占着卡:
nvidia-smi
预期结果(未在本机执行):nvidia-smi 列出各进程显存占用,能看出是否有残留进程。检查时先确认没有无关进程占卡,再决定要不要调批量。做可视化网络结构之类的调试时,也建议先在小批量下确认形状,再放大批量。
关于性能取舍:减小批量最省事,但会降低训练吞吐;清缓存几乎无副作用,但释放的是未使用显存,对真正占用中的张量无效。两者不是替代关系,通常先清缓存再减批量。
三、做法二与做法三:设备断言与版本问题
3.1 设备端断言
device-side assert triggered 多半是分类任务的标签越界。比如类别数是 10,标签却出现了 10 或 -1:
assert labels.min() >= 0 and labels.max() < num_classes, "标签越界"预期结果(未在本机执行):标签合法时静默通过,越界时抛出带中文提示的断言,帮你在数据加载阶段定位。失败排查:这类错误一旦触发,CUDA 上下文可能已被污染,需要重启进程再验证,不能原地继续跑。
3.2 版本与架构不匹配
no kernel image is available 或类似提示,通常是框架、CUDA 工具包与显卡架构没对齐。用下面的命令核对版本:
python -c "import torch; print(torch.__version__, torch.version.cuda)"预期结果(未在本机执行):打印框架版本与其编译时的 CUDA 版本,对照显卡驱动支持的范围即可判断是否匹配。没有本地显卡时,也可先用在线工具跑一遍最小打印脚本,确认语法和版本读取方式无误,再到目标机器上验证。适用边界:这一层涉及具体驱动与硬件组合,本文给的是通用核对思路,具体版本对应关系以官方文档为准。
四、几种做法的区别与取舍
把三类做法摆在一起看,选错方向是大多数人反复失败的原因。
| 报错类型 | 首选做法 | 代价 | 不适用场景 |
|---|---|---|---|
| 显存不足 | 清缓存 + 减批量 | 吞吐下降 | 模型本身超出显存上限 |
| 设备端断言 | 校验标签范围 | 需重启进程 | 非分类任务的自定义算子 |
| 版本不匹配 | 对齐框架与驱动版本 | 需重装环境 | 无权限改动环境的机器 |
- 避坑一:不要一报错就重装 CUDA,重装成本最高,应放在最后。
- 避坑二:调试阶段用小批量和小数据,能更快复现和验证。
- 避坑三:保持代码整洁也有帮助,符合 PEP8 习惯的脚本更容易复查张量流向;零基础读者尤其建议先把环境与版本记清楚再动手。
- 失败处理:改一项、验证一项,确认复现与否再决定下一步,避免多变量叠加。
- 适用边界:本文按通用框架流程整理,标为编辑推断;不同框架版本与硬件的报错细节可能略有差异,以官方文档与你实际环境为准,文中未在本文环境逐项实测。
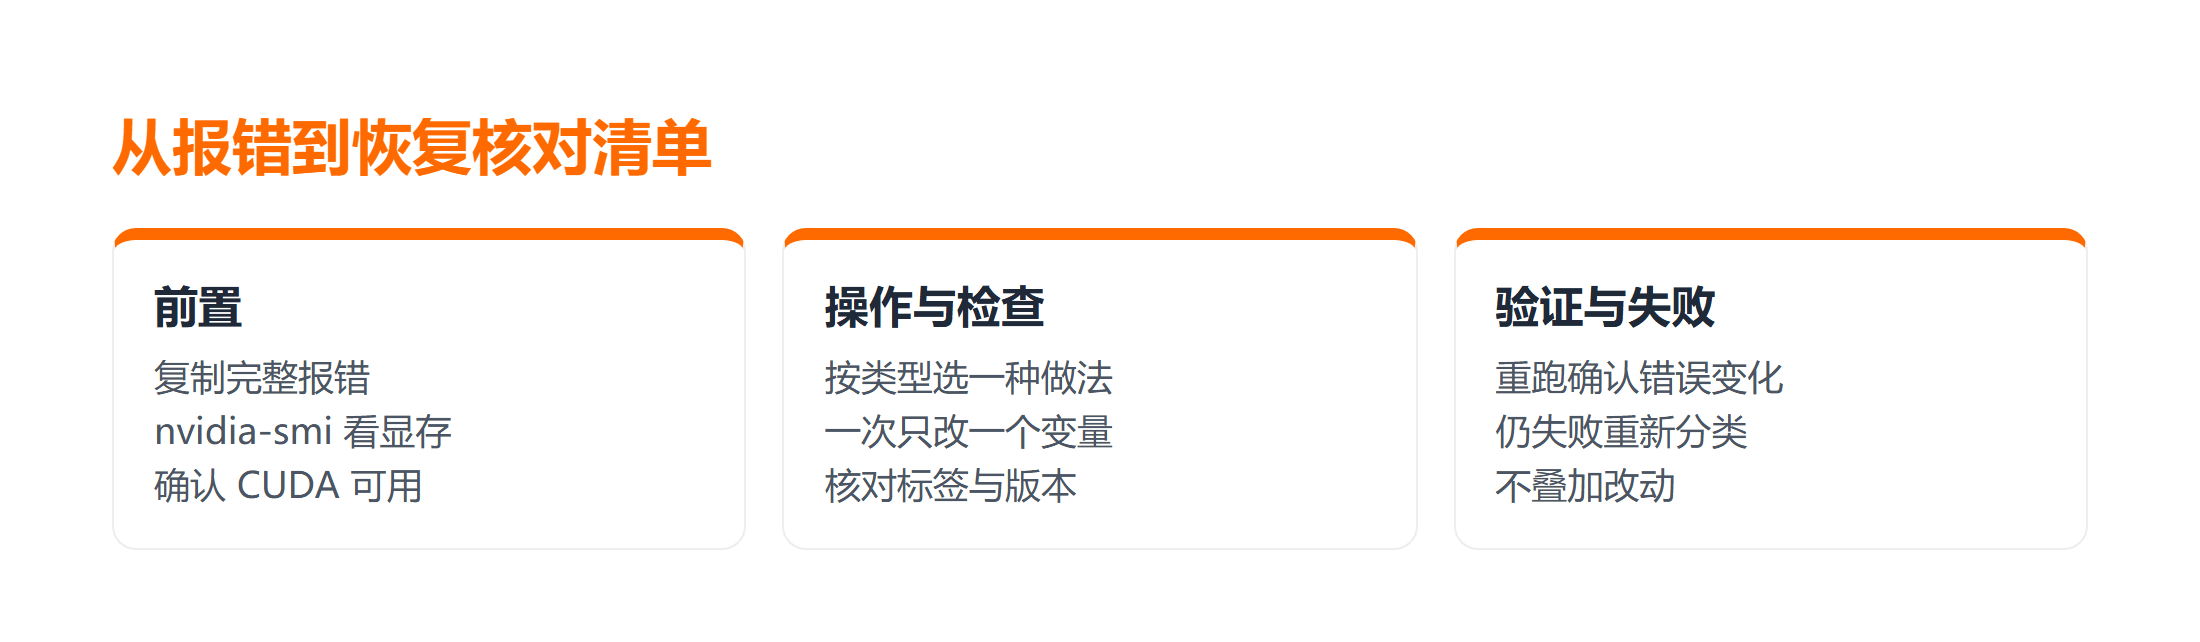
动手核对清单
- 前置:复制完整报错,用
nvidia-smi看显存与进程; - 操作:按错误类型选一种做法,一次只改一个变量;
- 检查:确认标签范围、版本对应关系是否合理;
- 验证:重跑同一场景,确认错误是否消失或变化;
- 失败处理:仍失败就回到错误全文重新分类,不叠加改动。
总结
CUDA 报 RuntimeError 的排查,核心是「先分类、再对症、一次改一项」。显存不足靠清缓存和减批量,设备端断言靠校验标签,版本问题靠对齐框架与驱动。三者混用只会增加噪声,读全错误全文是第一位的动作。把这份分类清单存下来,遇到报错先对号入座,多数情况都能快速收敛。
要点带走:
- 完整报错里的关键词才是线索,别只看第一行;
- 显存问题先清缓存再减批量,别急着换模型;
- 设备断言要查标签范围,并重启进程再验证;
- 版本对齐放最后做,成本最高。
常见问题
Q:为什么清了缓存还是显存不足?
A:empty_cache() 只释放未被占用的缓存,正在使用的张量不会释放。如果批量已经很小仍不足,说明模型或激活值本身超出上限,需要换更小的模型或启用梯度检查点。
Q:报错是 device-side assert,但我的标签看起来没问题?
A:注意标签是否从 0 开始、是否因数据类型转换出现负数或超大值,在数据加载后立刻断言范围最稳妥。触发后 CUDA 上下文可能已污染,记得重启进程。
Q:什么都不改,重启一下就好了,是为什么?
A:残留进程可能占着显存,或 CUDA 上下文已被错误污染。重启能释放这两类资源,但如果错误可复现,仍需按类型定位根因,别把它当最终解法。
延伸学习
想系统补齐 Python 与 AI 排查的知识,可以按这个顺序来:
- 想打牢 Python 基础,可以看 Python 零基础到高薪就业;
- 想用在线环境复现最小示例,翻 Python3 在线工具是什么?怎么用?3 种方法一次讲清;
- 需要整理调试脚本的代码风格,用 Python代码格式化 辅助检查。



