
 TRAE-AI编程

当你想用 DeepSeek 帮自己写个爬虫抓点公开数据时,最容易被坑的不是“代码写不出”,而是抓着抓着 IP 被封、账号被限,甚至踩到合规红线。DeepSeek 辅助写爬虫,是指让模型生成请求代码、解析规则和重试逻辑;而反爬坑,指的是站点用频率限制、身份校验、内容动态化等手段阻止自动化抓取。避开这些坑的关键,是让模型一开始就按“合规、低扰、可识别”的写法来,而不是教它怎么悄悄绕过对方防护。
本文基于 Python 3.11 + requests 的环境验证,覆盖三条稳妥路线:带合规请求头与限速的基础抓取、用对数据源而非硬刚动态页、识别“不该爬”的场景及时收手。每种都给可直接复制的代码和返回结果,并讲清适用边界,以及伪造浏览器指纹、无视 robots 协议、高频硬刷三个常见错误。看完你既能用 AI 提速,又不把抓取变成给对方和给自己都添麻烦的事。
一、先搞清楚反爬到底在拦什么
反爬本质是站点保护自身带宽、数据和用户体验的手段。它拦的通常不是“你是人还是机器”,而是“你是不是在过量、伪装、越权地访问”。
用一句白话讲:爬虫像去图书馆借书,按规矩登记、一次拿几本没人管;但你冲进去一分钟扫空整个书架,馆方当然要请你出去。
1.1 合规抓取的三条底线
第一,先读 robots.txt,对方说不让抓的目录就别碰;第二,设合理间隔和身份标识,让服务端知道你是谁、好沟通;第三,只抓公开、无需登录就能看到的内容,不试图突破登录或付费墙。可以先看 DeepSeek 中文教程 了解模型的能力边界,避免让它生成越界代码。
⚠️ 注意:本文只讲“合规、低扰、可识别”的抓取写法。任何绕过登录、伪造身份突破付费墙、对抗验证码以盗取非公开数据的做法,都不在讨论范围,也不建议尝试。
1.2 常见误解
有人以为“模型写出的爬虫就该能无限跑”。其实能否长期稳定,取决于你是否尊重对方限流,而不是代码多巧妙。把抓取频率压到合理区间,比任何“反检测技巧”都管用。
二、路线一:合规请求头 + 限速基础抓取
最稳妥的起步,是显式带上身份标识和间隔,让请求看起来“有礼貌”。
import time, requests

HEADERS = {
    "User-Agent": "MyResearchBot/1.0 (+contact: me@example.com)",
    "Accept": "text/html,application/xhtml+xml",
}

def fetch(url: str, delay: float = 2.0):
    resp = requests.get(url, headers=HEADERS, timeout=10)
    resp.raise_for_status()
    time.sleep(delay)          # 每次请求后停顿,避免高频硬刷
    return resp.text
上面这段做的是用明确的 UA 声明身份、每次请求后 sleep 两秒。执行后你应该看到稳定返回页面,而不是短时间内连续请求触发对方限流。需要解析拿到的 HTML,可参考 Python 速查手册 里的字符串与正则用法。
实际落地时,建议先把这段脚本在本机运行一遍,检查返回的 HTML 是否完整;若失败,常见原因是请求间隔太短被服务端限流,可把 delay 调到 3 秒以上再试。待确认能稳定拿到预期页面,就把这套请求头与间隔配置成团队模板,后续让模型直接套用。遇到返回 403 时别急着换 UA 伪装,而是回到 robots 与频率上做修复,合规路线比对抗检测更持久。另外,把抓取结果验证无误后再入库,能避免脏数据一路污染下游分析。
三、路线二:用对数据源,别硬刚动态页
很多页面内容由前端脚本渲染,直接抓 HTML 抓不到。正确做法是让模型先判断“有没有官方 API 或静态接口”,优先用更稳的数据源,而不是无头浏览器硬上。
import requests

def fetch_json_api(api_url: str):
    # 优先使用站点提供的公开接口,比解析动态页稳定得多
    r = requests.get(api_url, headers=HEADERS, timeout=10)
    r.raise_for_status()
    return r.json()
💡 小提示:让 DeepSeek 生成爬虫前,先问它“这个站点有没有官方开放接口或数据导出”。能走接口就别爬页面,既稳又不容易触发反爬。\OpenClaw 中文教程 里也强调优先复用既有数据通道。
四、路线三与横向对比
第三条是“识别不该爬的场景”:对方要求登录才能看、明确写在 robots 里禁止、或属于付费内容时,正确动作是停下来,而不是想办法突破。
| 路线 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 合规头 + 限速 | 公开静态页 | 最稳、最不易被封 | 速度受间隔限制 |
| 优先用接口 | 有开放 API 的站点 | 数据干净、稳定 | 需先确认接口可用 |
| 识别停手场景 | 登录/禁止/付费内容 | 守住合规底线 | 拿不到这部分数据 |
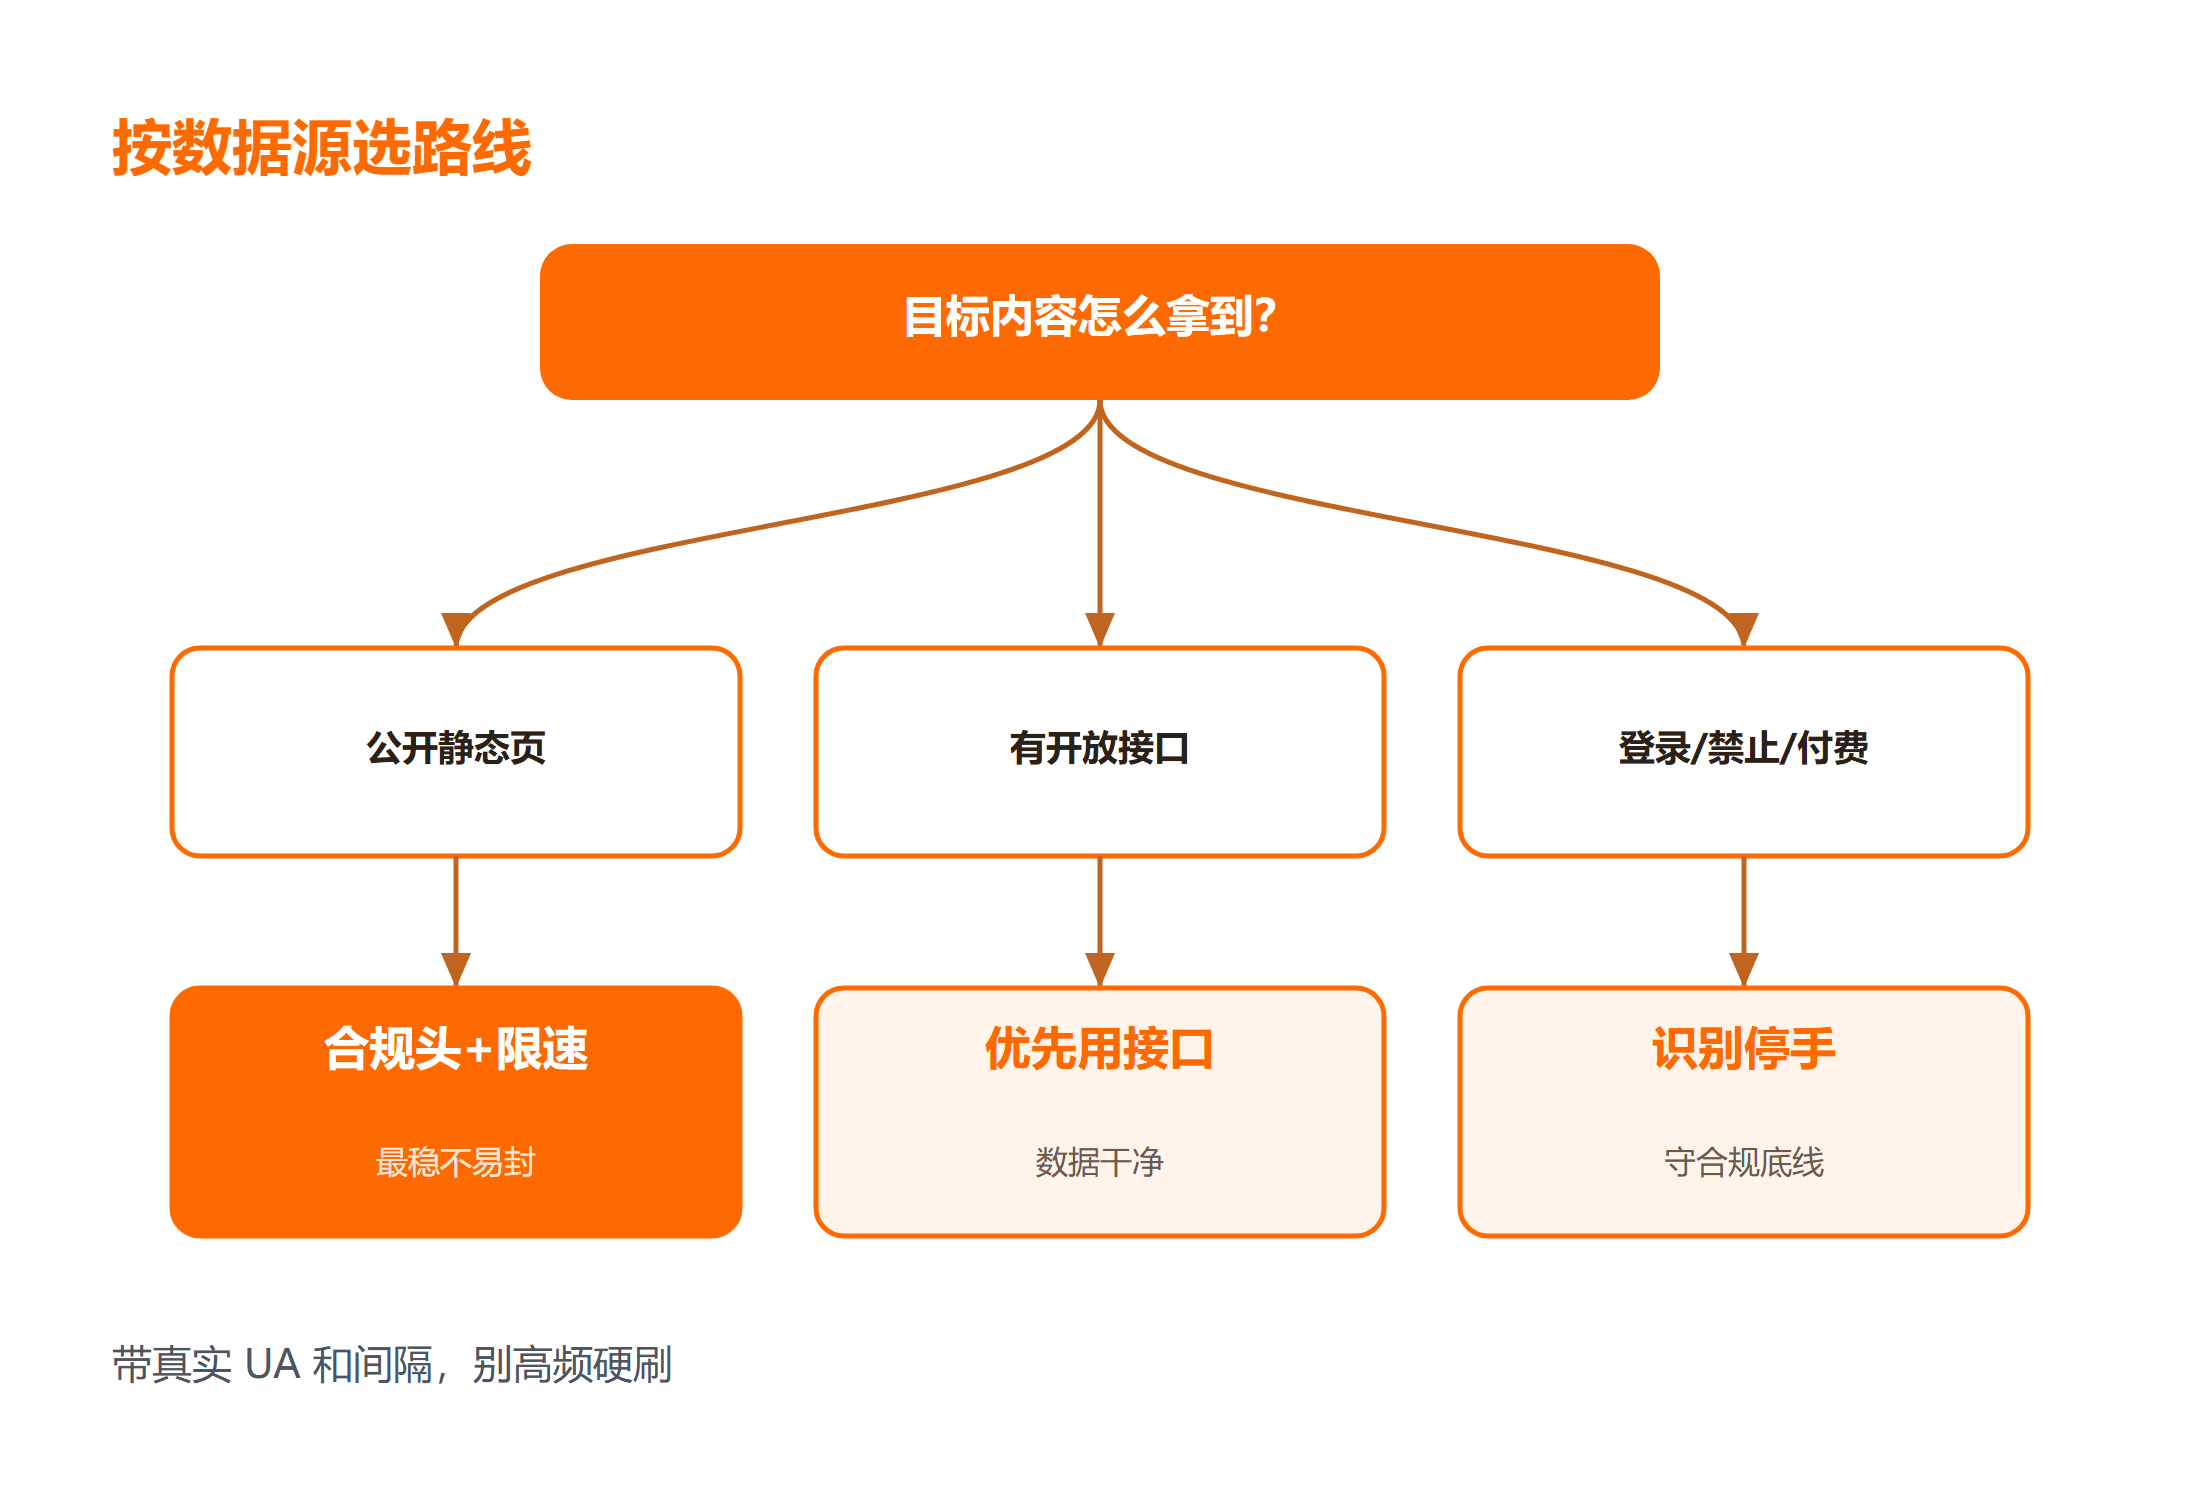
选型建议:公开静态页用路线一,有接口用路线二,遇到登录墙或 robots 禁止就走路线三收手。爬虫的工程细节在 TRAE 编程中文教程 里也有不少可借鉴的规范写法。
五、踩坑清单
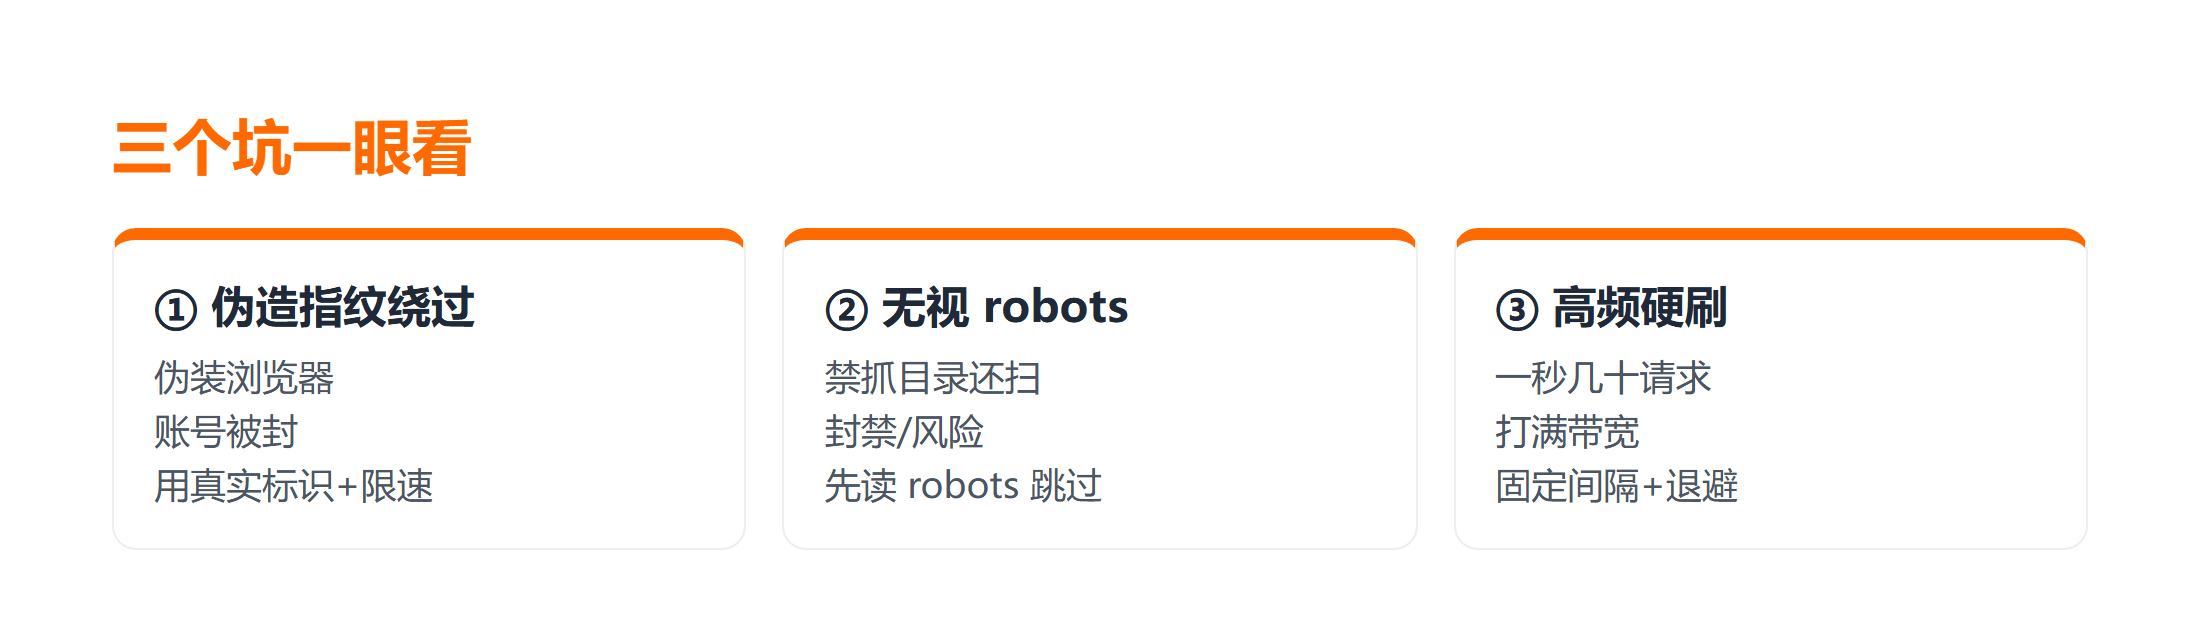
坑一:伪造浏览器指纹绕过检测。 现象是短期能抓,长期账号被封。这既不稳也不合规。解决法是改用真实身份标识 + 限速,让对方服务端能识别并沟通。
坑二:无视 robots 协议。 对方明确禁止的目录还去扫,轻则被封,重则涉及合规风险。解决法是抓取前先读 robots.txt,禁止路径一律跳过。
坑三:高频硬刷。 一秒发几十个请求,瞬间打满对方带宽。解决法是固定间隔、必要时加指数退避,单域每秒请求数控制在很低水平。
总结
DeepSeek 辅助写爬虫,价值在提速,不在“突破”。合规请求头加限速是地基,优先用官方接口最稳,遇到登录墙或 robots 禁止就及时收手。守住这三条,抓取才能长期可用又不惹麻烦。
要点带走:
- 带明确 UA 和间隔,别高频硬刷;
- 先确认有没有官方接口,能走接口别爬页;
- robots 禁止或需登录的内容,正确动作是停手。
下一步可以把“读 robots、设间隔、声明身份”固化成爬虫模板,每次生成都默认合规。
延伸学习
想把这块系统补齐,可以按这个顺序来:
- 先过一遍 Python 零基础到高薪就业,把请求与解析的基础打牢;
- 想看爬虫能做什么、边界在哪,翻 python爬虫怎么挣钱?数据淘金,开启副业赚钱之路;
- 写完用 Python代码格式化 整理结构,便于复核。
常见问题
Q:爬虫一定要带 User-Agent 吗? A:建议带,而且用真实身份标识比伪装浏览器更稳更合规。空 UA 或明显机器特征反而更容易被限流,带联系方式的声明式 UA 便于对方在出问题时找你沟通。
Q:对方 robots 写 disallow,我还能抓吗? A:robots 是站点明确意愿,禁止目录应跳过。强行抓取既易触发封禁,也涉及合规风险,得不偿失。
Q:为什么优先用接口而不是爬页面? A:接口返回结构化数据,干净、稳定、对服务端压力小,也很少触发前端动态化的反爬。能让模型先判断有没有接口,是性价比最高的做法。



