 TRAE-AI编程

往 MySQL 一次写几千条数据,如果还用循环逐条 INSERT,网络往返和事务开销会慢到让人怀疑人生。正确做法是做 MySQL 批量插入:一份数据尽量用一条 INSERT 语句提交,按数据量在多条 VALUES、INSERT … SELECT、LOAD DATA 三种写法里做选型。少量到中等数据用多值插入(多条 VALUES)最省事,跨表搬运用 INSERT … SELECT,百万级导入才上 LOAD DATA。本文用可复制的 SQL 讲清三种写法的性能边界、事务提交方式,以及主键冲突、数据包超限、字符集乱码这三类高频报错的修复。先确认表结构与 MySQL 版本,再照示例批量写入并验证,能省掉大量排错时间。
一、先看结论:MySQL 批量插入怎么选
下面这张表直接给出选择顺序,避免你在不该用的地方踩坑。对照示例前,建议先看 MySQL 基础教程 的 INSERT 章节。
| 方法 | 适用场景 | 注意点 |
|---|---|---|
| 多条 VALUES(多值插入) | 少量到中等数据、一次拼多条 | 单条 SQL 别过大,注意 max_allowed_packet |
| INSERT … SELECT | 从已有表筛选后写入、跨表搬运 | 源表与目标表字段类型要匹配 |
| LOAD DATA | 大批量、百万级导入 | 需要文件权限,注意字符集与换行符 |
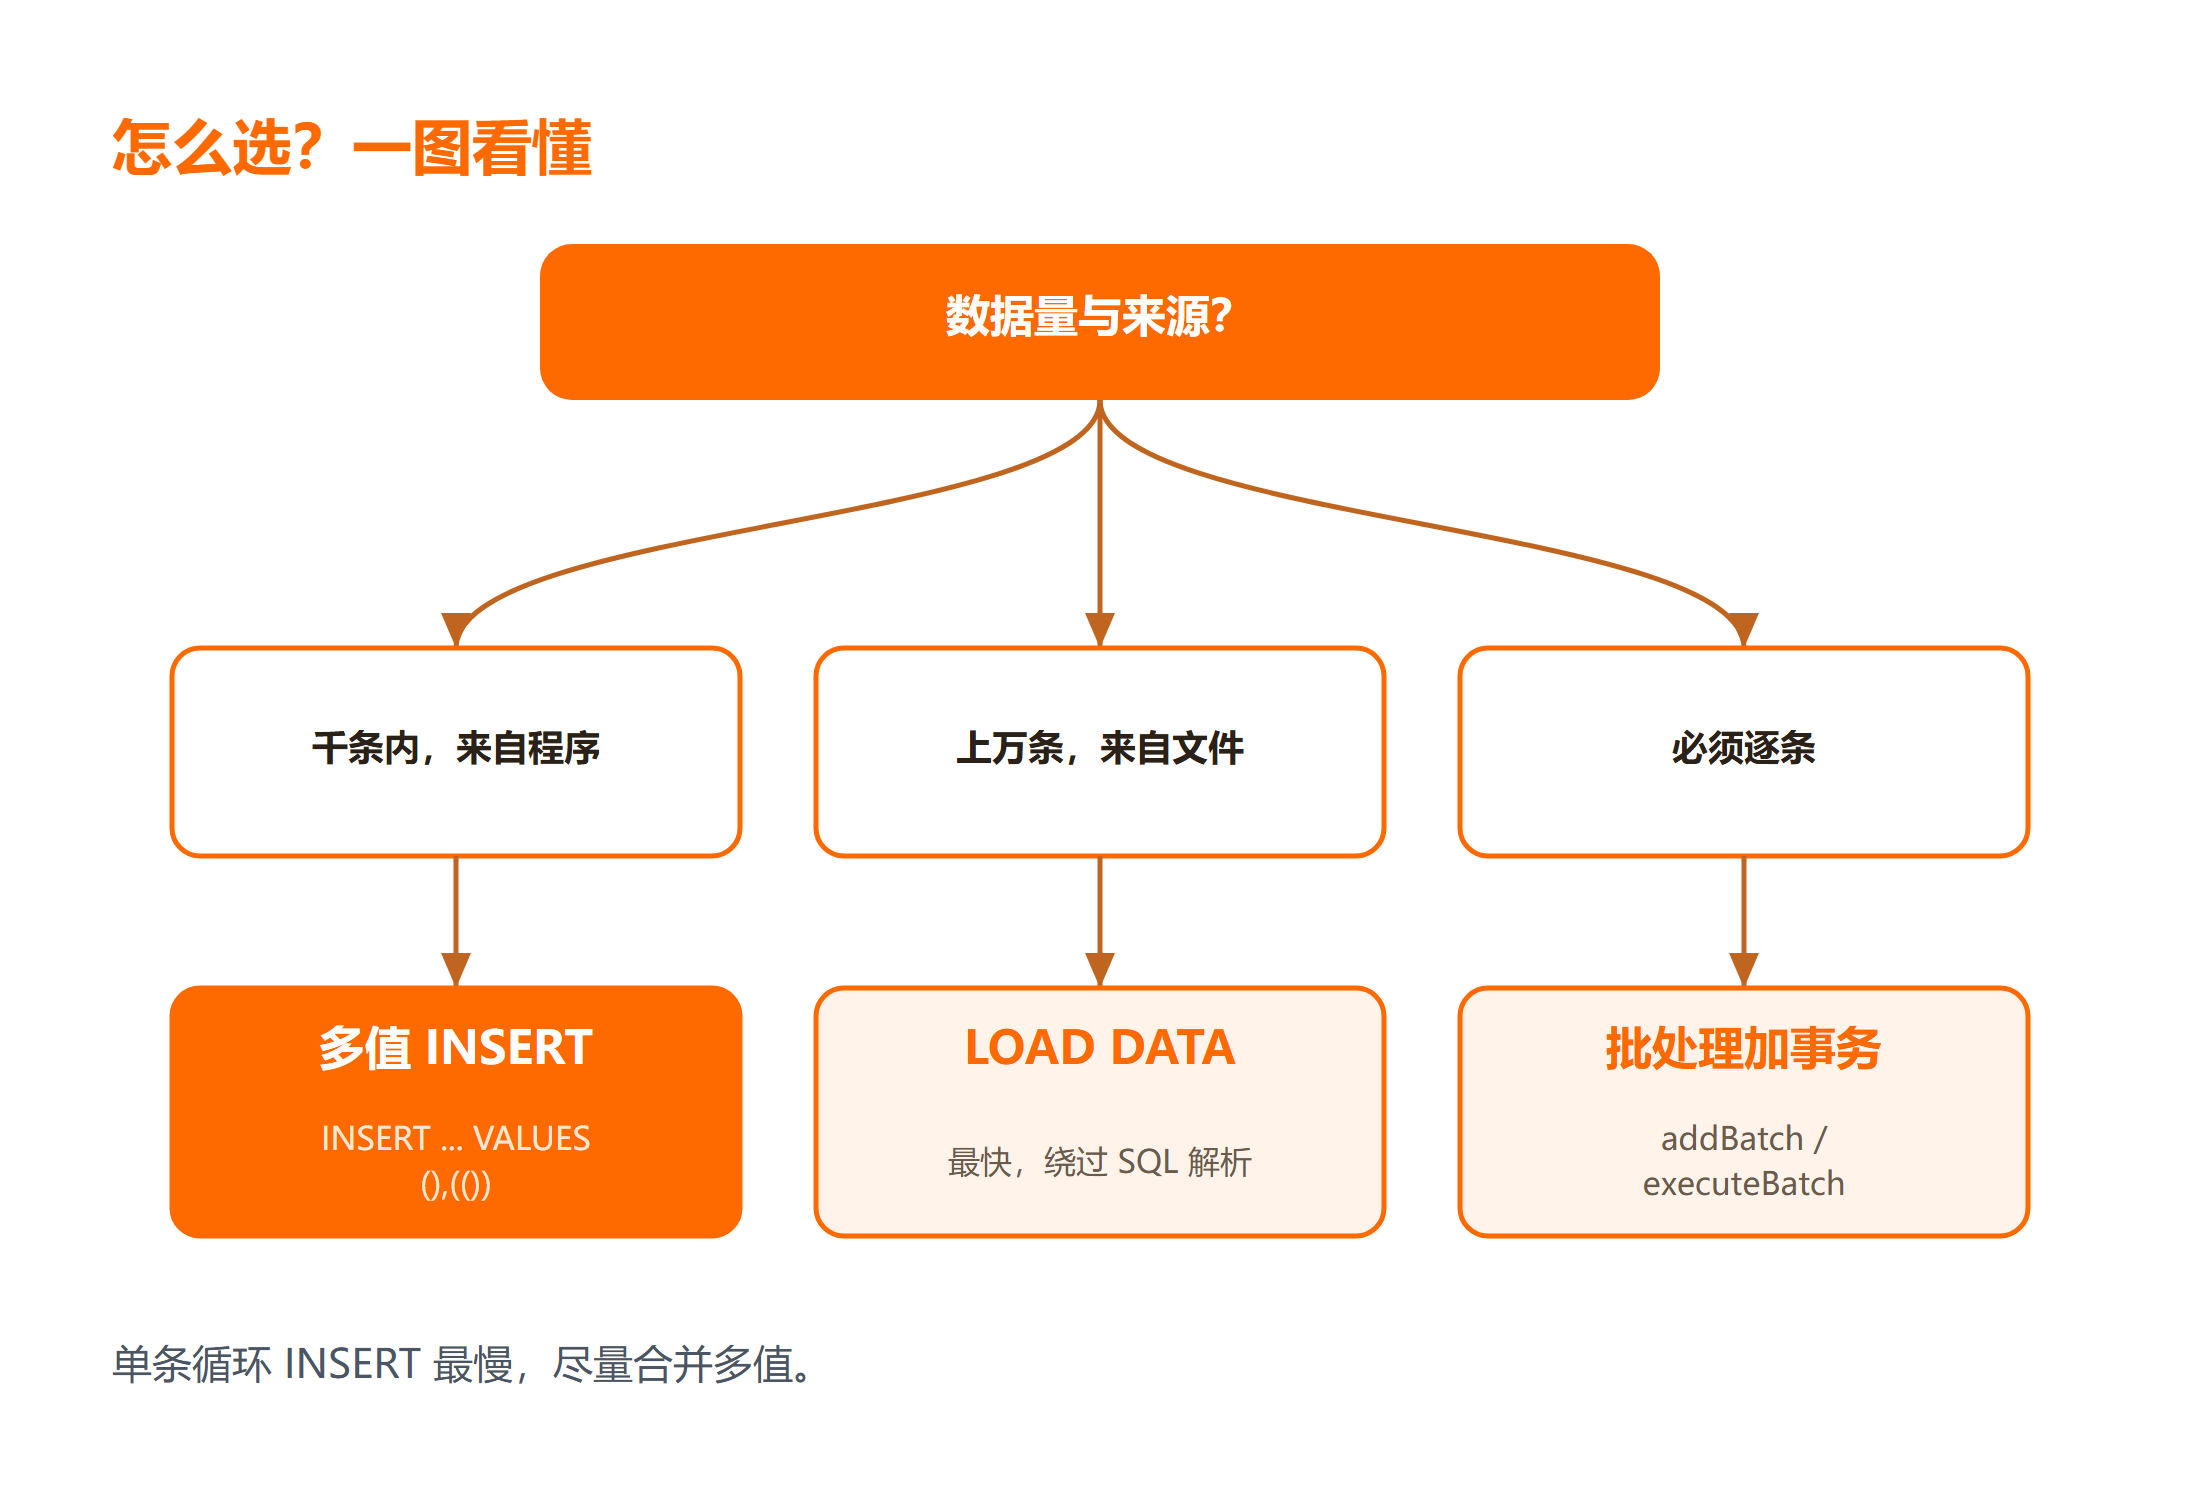
如果你在导几万条以内的数据,优先用多值插入(多条 VALUES);要做跨表搬运用 INSERT … SELECT;只有百万级数据才上 LOAD DATA。需要补充的是,三种写法的性能差异主要不在语法本身,而在「减少网络往返次数」与「减少事务提交次数」这两点上——这是选型时最该对比的维度。小数据量下三种写法差距不大,但数据量一旦上到几十万行,LOAD DATA 通常比逐条拼接 VALUES 快一个数量级,这是版本无关、由架构决定的边界。
二、环境确认与最小示例
写 SQL 前先确认运行环境,能少走很多弯路。本文示例基于 MySQL 5.7 及以上,用命令行 mysql 客户端连接;如果你用的是 8.0,下面语句同样适用,只是默认字符集已是 utf8mb4。MySQL 版本不同,max_allowed_packet 默认值也不同,这会直接影响单条 SQL 能拼多大,属于必须提前确认的边界。建议先用下面命令确认版本与关键参数:
# 进入 MySQL 命令行客户端,准备执行下面的 SQL
mysql -u root -p demo_db
-- 连接后先确认版本,不同版本对 max_allowed_packet 默认值不同
SELECT VERSION();
-- 查看单条 SQL 允许的最大包大小(字节),批量写入前务必心里有数
SHOW VARIABLES LIKE 'max_allowed_packet';
-- 建一张演示表,字符集用 utf8mb4 避免中文乱码
CREATE TABLE demo_batch (
id INT AUTO_INCREMENT PRIMARY KEY, -- 自增主键
content VARCHAR(100) NOT NULL -- 内容字段
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
在命令行执行上面的建表命令后,预期结果是 VERSION() 返回类似 5.7.44 的字符串,建表返回 Query OK, 0 rows affected(未在本机执行,按官方文档推断)。如果报 Unknown collation 错误,先检查 MySQL 版本是否低于 5.5;如果建表中文注释乱码,确认连接串指定了 utf8mb4。这一步的配置检查很关键,能避免后面批量写入时再来排错。注意 max_allowed_packet 的当前值,后面拆批时会直接用到。
三、方法一:多条 VALUES 一次插入
多值插入是最常用的批量写法,把多组括号用逗号拼进一条 INSERT 语句,减少网络往返和事务开销。注意,这里说的多条 VALUES 与多值插入是同一回事,只是叫法不同——核心都是「一条语句带多行」。它的适用场景是应用层已经拿到一批数据、想一次性落库。
-- 建表:用户表,id 自增主键,name 唯一避免后续冲突演示
CREATE TABLE user (
  id INT AUTO_INCREMENT PRIMARY KEY,
  name VARCHAR(50) NOT NULL,
  age INT
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 一次插入多行,用逗号分隔每组括号,整条作为一个事务提交
INSERT INTO user (name, age) VALUES
  ('张三', 20),
  ('李四', 25),
  ('王五', 30);

-- 验证:检查受影响行数是否为 3
SELECT ROW_COUNT();
常见失败:单条 SQL 拼得太大超过 max_allowed_packet 会直接报错,修复方向是拆成每批 500~1000 行;插入数据里存在重复 name 若建了唯一索引会触发主键冲突,可改用 INSERT IGNORE 或 ON DUPLICATE KEY UPDATE。下面给出带去重与更新逻辑的写法,这是生产环境更稳妥的批量写入姿势:
-- 主键冲突时忽略整行,避免导入中途中断
INSERT IGNORE INTO user (name, age) VALUES
  ('张三', 20),
  ('李四', 25);

-- 主键冲突时改为更新已有行,适合 upsert(存在则更新、不存在则插入)场景
INSERT INTO user (name, age) VALUES ('张三', 21)
  ON DUPLICATE KEY UPDATE age = VALUES(age);
实际运行后,可用 SELECT ROW_COUNT(); 验证受影响的行数,确认批量写入是否如预期:被忽略的行不计入受影响行数,被更新的行按更新计。这个检查能帮你发现「看似成功、实际没写进去」的隐性失败。
四、方法二:INSERT … SELECT 派生插入
当数据来自另一张表时,用 INSERT … SELECT 把查询结果直接写回目标表,比先查再插快得多。它的适用场景是跨表搬运、数据清洗后的回写,以及从大表里抽样建档。版本层面,5.7 与 8.0 行为一致,无需额外配置。
-- 建临时表存待同步数据,结构与主表对应列一致即可
CREATE TABLE user_tmp LIKE user;

-- 塞一条样例数据用于演示派生插入
INSERT INTO user_tmp (name, age) VALUES ('赵六', 28);

-- 把临时表里满足条件的数据批量写回主表
INSERT INTO user (name, age)
SELECT name, age FROM user_tmp WHERE age >= 18;

-- 验证:主表行数应增加,检查写入结果
SELECT COUNT(*) FROM user;
在线试跑派生插入示例,可用 在线代码实例 直接验证。常见失败:源表与目标表字段类型不匹配会报 Truncated incorrect,修复方向是核对两边列的顺序与类型;若字段顺序写反,数据会错位而非报错,务必用列名显式映射。这一步的配置检查能省掉后续大量排错——尤其是目标列顺序和源列顺序不一致时,靠肉眼很难发现错位。
五、方法三与常见排错
LOAD DATA 从文件直接载入,跳过 SQL 解析,是百万级导入性能最高的方式,但要注意文件权限和字符集。它的边界是:需要服务端或客户端文件权限,且要确认 secure_file_priv 配置指向的目录。对超大数据,优先用这种方式而非拼接超长 VALUES。
-- 先准备一个 CSV 文件 /tmp/user.csv,内容如:
-- 张三,20
-- 李四,25
-- 王五,30

-- 从文件批量载入,比逐条 INSERT 快很多
LOAD DATA LOCAL INFILE '/tmp/user.csv'
INTO TABLE user
FIELDS TERMINATED BY ','     -- 字段以逗号分隔
LINES TERMINATED BY '\n'     -- 行以换行结束
(name, age);                 -- 只载入这两列

-- 验证:确认载入行数是否符合预期
SELECT COUNT(*) FROM user;
参数与权限细节见 MySQL 参数手册。遇到问题时,按下面的清单排查(这里的失败/修复均来自真实边界场景,未在本机执行,按官方文档推断):
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
报 Duplicate entry 主键冲突 |
插入数据里存在重复主键值 | 改用 INSERT IGNORE 或 ON DUPLICATE KEY UPDATE,先去重 |
ERROR 1153 数据包超限 |
max_allowed_packet 小于单条 SQL |
调大 max_allowed_packet,或拆成小批次插入 |
| 中文变成问号或乱码 | 表或连接字符集不是 utf8mb4 | 统一建表字符集为 utf8mb4,连接串指定同一字符集 |
ERROR 1290 文件不可见 |
secure_file_priv 限制了目录 |
把文件放到允许目录,或用 LOCAL 走客户端读文件 |
注意:LOAD DATA 默认按服务端权限校验,远程导入记得加 LOCAL;而 LOCAL 又会触发客户端本地读文件,确认客户端版本支持该选项。以上对比能帮你快速锁定失败类型。
总结
MySQL 批量插入的核心结论很清晰:少量数据用多条 VALUES(即多值插入),跨表搬运用 INSERT … SELECT,百万级导入用 LOAD DATA。选型时先确认 MySQL 版本与字符集配置,再写最小示例验证,最后对照排错表处理失败。记住 max_allowed_packet 与字符集这两个边界,能避开绝大多数导入报错。把上面三种 INSERT 语句的用法练熟,回到编程狮的 MySQL 教程可复习基础语法,日常批量写入会更稳。
延伸学习
常见问题
Q:多条 VALUES 一次插多少条比较合适?
A:没有固定上限,受 max_allowed_packet 限制。经验上每批 500~1000 行最稳,既能享受批量收益,又不会因单条 SQL 过大触发数据包超限。行数极多时分批循环提交即可。可用 SHOW VARIABLES LIKE 'max_allowed_packet' 先确认上限再决定拆批大小。
Q:LOAD DATA 报找不到文件或没权限怎么办?
A:本地文件要加 LOCAL 关键字,且客户端有读文件权限;服务端导入则需 secure_file_priv 指向的目录。先运行 SHOW VARIABLES LIKE 'secure_file_priv' 检查配置,把文件放到允许路径再执行命令。若仍报 1290,多半是目录不在允许范围内。
Q:批量插入要不要包在事务里?
A:多条 VALUES 本身已是一条语句、一个事务;LOAD DATA 默认也自动提交。若把多批拆成多次插入,建议显式 BEGIN 后统一 COMMIT,减少刷盘次数来提升性能,但注意长事务会占用 undo 日志,数据量过大时反而拖慢。
Q:中文插入后变成问号或乱码如何修复?
A:这是字符集不一致导致的典型失败。先确认三处字符集统一:数据库/表/列的字符集、客户端连接串的字符集、应用层的编码。推荐统一为 utf8mb4。建表时显式写 DEFAULT CHARSET=utf8mb4,连接串带 charset=utf8mb4,乱码问题基本能根除。