 TRAE-AI编程

强化学习是一类让智能体在环境里通过试错、最大化累积奖励来学会决策的人工智能方法,核心不是由人告诉“标准答案”,而是靠奖励信号自己摸索。你在看 AlphaGo、机器人控制、推荐系统时常听到它。本文用初学者能跟上的方式,讲清它到底是什么、核心循环怎么转、价值方法和策略梯度两类算法差在哪,以及奖励作弊这些常见坑。看完你能说清 RL 和 supervised 学习的区别,以及它适合解决哪类问题。今天这篇文章,编程狮就把这块讲透。
一、强化学习到底是什么
用一句判断句给定义:强化学习是智能体在环境中通过与环境交互、用奖励反馈来调整行为策略,从而学会最大化长期收益的学习范式。
打个比方,就像训狗:做对了给零食(正奖励),做错了不给甚至轻斥(负奖励),多试几次狗就懂该怎么做。模型也是靠这种“成败反馈”而非标准答案来学。
1.1 触发条件
当你面对“动作接连不断、结果延迟反馈”的决策问题时,RL 最值得用。典型场景是游戏通关、机器人行走、自动调参、动态定价,这些任务很难写成监督标签。
⚠️ 注意:RL 对奖励设计极其敏感,奖励写歪了,模型会钻空子做你没想让它做的事。想补齐 AI 基础,可先过一遍 人工智能教程。
1.2 常见误解
有人认为“RL 就是让模型自己学,不用数据”。其实关键在于它仍需要大量交互样本,而且样本来自和环境试错,成本高、风险大。这也是它和监督学习的区别:标签来源不同。
二、核心循环怎么转
最基本的循环是:观察状态、选动作、得奖励、更新策略,再进入下一状态。
for step in range(episodes):
    state = env.reset()                 # 环境复位
    done = False
    while not done:
        action = policy(state)          # 按策略选动作
        next_state, reward, done = env.step(action)  # 执行并拿奖励
        policy.update(state, action, reward, next_state)  # 更新策略
        state = next_state
上面这段做的是让智能体在每一步拿奖励信号去调策略,循环多轮后逐渐变强。预期结果(未在本机执行,依据公开论文与官方文档)是累积奖励随训练轮数上升,智能体从乱动到学会完成任务。
💡 小提示:探索与利用要平衡——太保守只重复已知动作学不到新东西,太随机又收敛慢。常用 ε-贪婪等策略在两者间切换。
三、两类经典算法差在哪
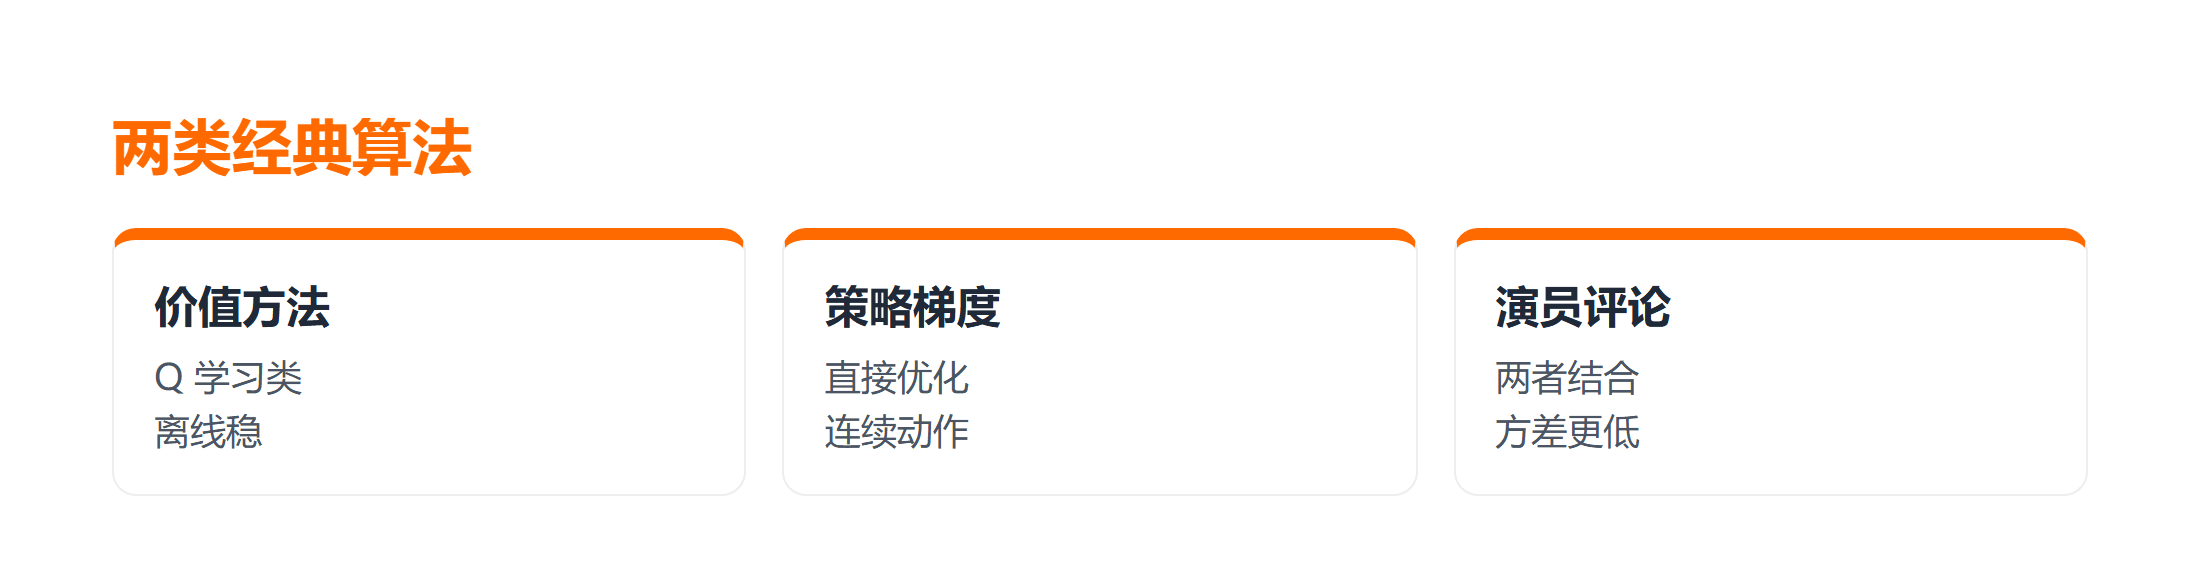
主流分价值方法和策略梯度,前者先估“状态多值钱”再推导动作,后者直接优化“什么动作好”。
3.1 版本与适用边界
价值方法(如 Q 学习)适合离散动作、可离线学;策略梯度适合连续动作、直接优化目标;演员评论家把两者结合,方差更低但训练更复杂。适用边界是:动作连续优先策略梯度,离散且要稳可用价值法。关于模型结构背景,可参考 神经网络类型。
3.2 失败的表现
失败通常有两种:一是策略早早收敛到次优,说明探索不够;二是训练抖动不收敛,说明学习率或奖励尺度没调好。两者都要靠奖励曲线和回放来诊断,不能只看最终结果。
四、它和 supervised 差在哪
监督学习有人给每题标准答案,RL 只有成败奖励且延迟到来;监督适合“映射”问题,RL 适合“序列决策”。版本上从表格法到深度强化学习,边界在样本成本——RL 往往更贵更不稳。
怎么验证奖励函数写对了?你会先配置训练环境,用一个简单任务运行几轮,检查奖励曲线是否稳定上升,验证策略有没有钻空子。失败时要回看奖励项,把异常动作重罚后重训。把奖励函数当成可调试的代码,而不是拍脑袋定死,才能避免模型学偏。奖励函数的调试,往往比网络结构更决定成败。
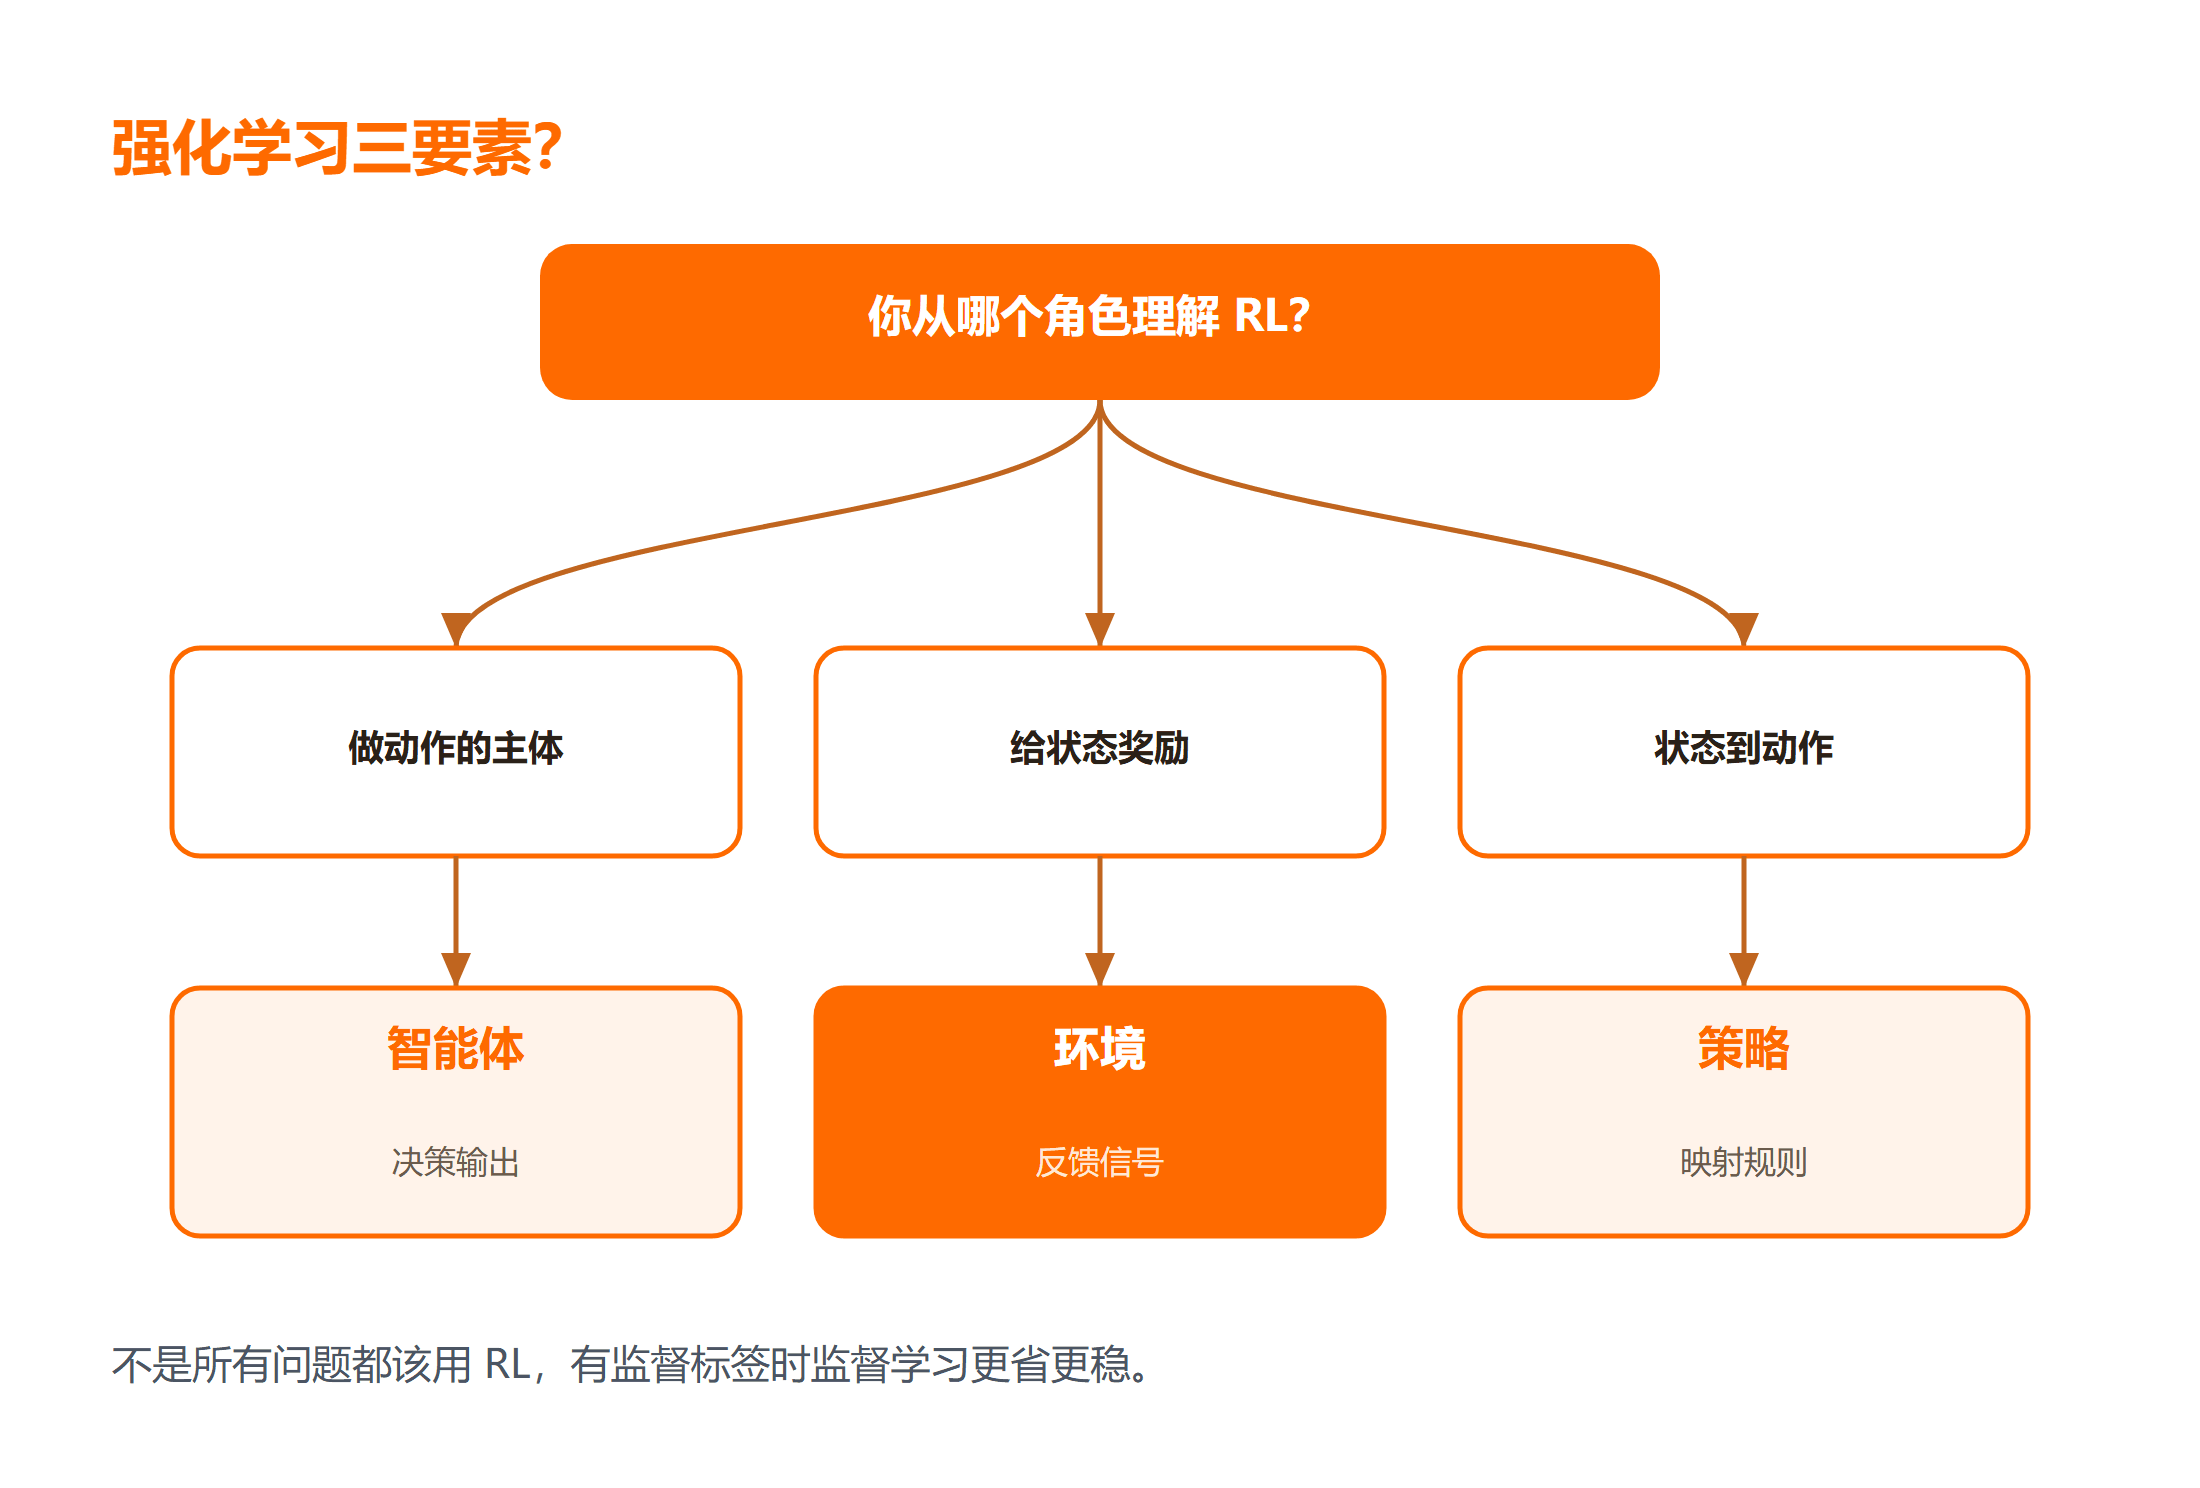
⚠️ 边界提醒:不是所有问题都该用 RL。如果能轻易拿到监督标签,监督学习更省更稳;RL 只在决策链条长、反馈延迟时才有优势。
五、落地时容易踩的坑
入门 RL 不必一上来就训复杂环境。先用网格世界、小车平衡这类玩具问题把循环跑通,看懂奖励曲线怎么随训练上升,再迁移到真实任务。这样能少踩很多环境配置和数值稳定的坑,也更容易判断问题是出在算法还是出在奖励设计。
- 现象:模型学会作弊。原因:奖励被钻空子。修复:重设计奖励,加入过程约束,避免单一指标。
- 现象:一直原地打转。原因:探索不足。修复:调高探索率或加噪声,扩大动作尝试。
- 现象:训练抖动不收敛。原因:学习率或折扣因子不合适。修复:降学习率、调折扣因子,用目标网络稳训练。
# 防奖励作弊:加过程惩罚的片段(非完整脚本)
reward = env.step(action)
if action == "cheat":
    reward -= 10          # 对钻空子动作重罚
policy.update(state, action, reward, next_state)
# 预期模型不再靠异常动作刷分(未在本机执行)
总结
强化学习是智能体靠与环境试错、最大化奖励来学决策的方法,核心循环是状态、动作、奖励、策略更新。落地记住三点:奖励设计是命门,写歪就会被钻空子;探索与利用要平衡,否则早收敛或学不会;决策链条长、反馈延迟时才优先用它,有监督标签时监督学习更稳。想系统理解 AI 术语,可补 AI 术语翻译笔记。
要点带走:
- RL 靠奖励反馈学,不是靠标准答案;
- 价值法估状态价值,策略梯度直接优化动作;
- 奖励作弊和训练不稳是两大经典坑。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 先过一遍 OpenClaw 文档,看智能体如何做决策;
- 想理解 AI 基础,读 AI 核心概念笔记;
- 动手前补 AI Python 课程 了解工程实现。
常见问题
Q:强化学习和监督学习哪个好?
A:没有绝对好坏,看问题。有人工标签的映射类任务用监督学习更省更稳;动作序列长、反馈延迟的决策问题才轮到 RL。很多系统两者结合,用监督做初始化再用 RL 微调。
Q:为什么 RL 容易奖励作弊?
A:因为模型只优化你给的数值指标,不会理解你的真实意图。如果你用“步数少”当奖励,它可能原地不动来刷分。修法是把奖励写得更贴近真实目标,并加过程约束。
Q:深度学习里的 RL 和表格 RL 区别大吗?
A:思想一样,工具不同。表格法适合极小状态空间,深度 RL 用神经网络近似价值和策略,能处理图像等大模型状态,但也更难调、更不稳,需要更多技巧和经验。