
 TRAE-AI编程

TensorFlow 报 ValueError,绝大多数情况不是框架坏了,而是输入的形状、数据类型或调用的接口和预期对不上。先给结论:看到这个错先读括号里的说明,再按「形状—类型—接口用法」三层依次核对,别一上来就改模型结构。很多人用错场景反而更麻烦,比如把为批次设计的层拿去处理单条数据,错误就会从一处冒到多处。本文从最小示例出发,讲清几类常见成因的处理区别与取舍,给出失败边界。文中代码为通用示例,未在本文环境逐项实测。
先看结论
先记住一个顺序,能避开大量无效改动。
第一,先读完整报错。TensorFlow 报 ValueError 的括号里通常写着期望形状和实际形状,这是最直接的线索。想补背景,可过一遍 人工智能概览教程。
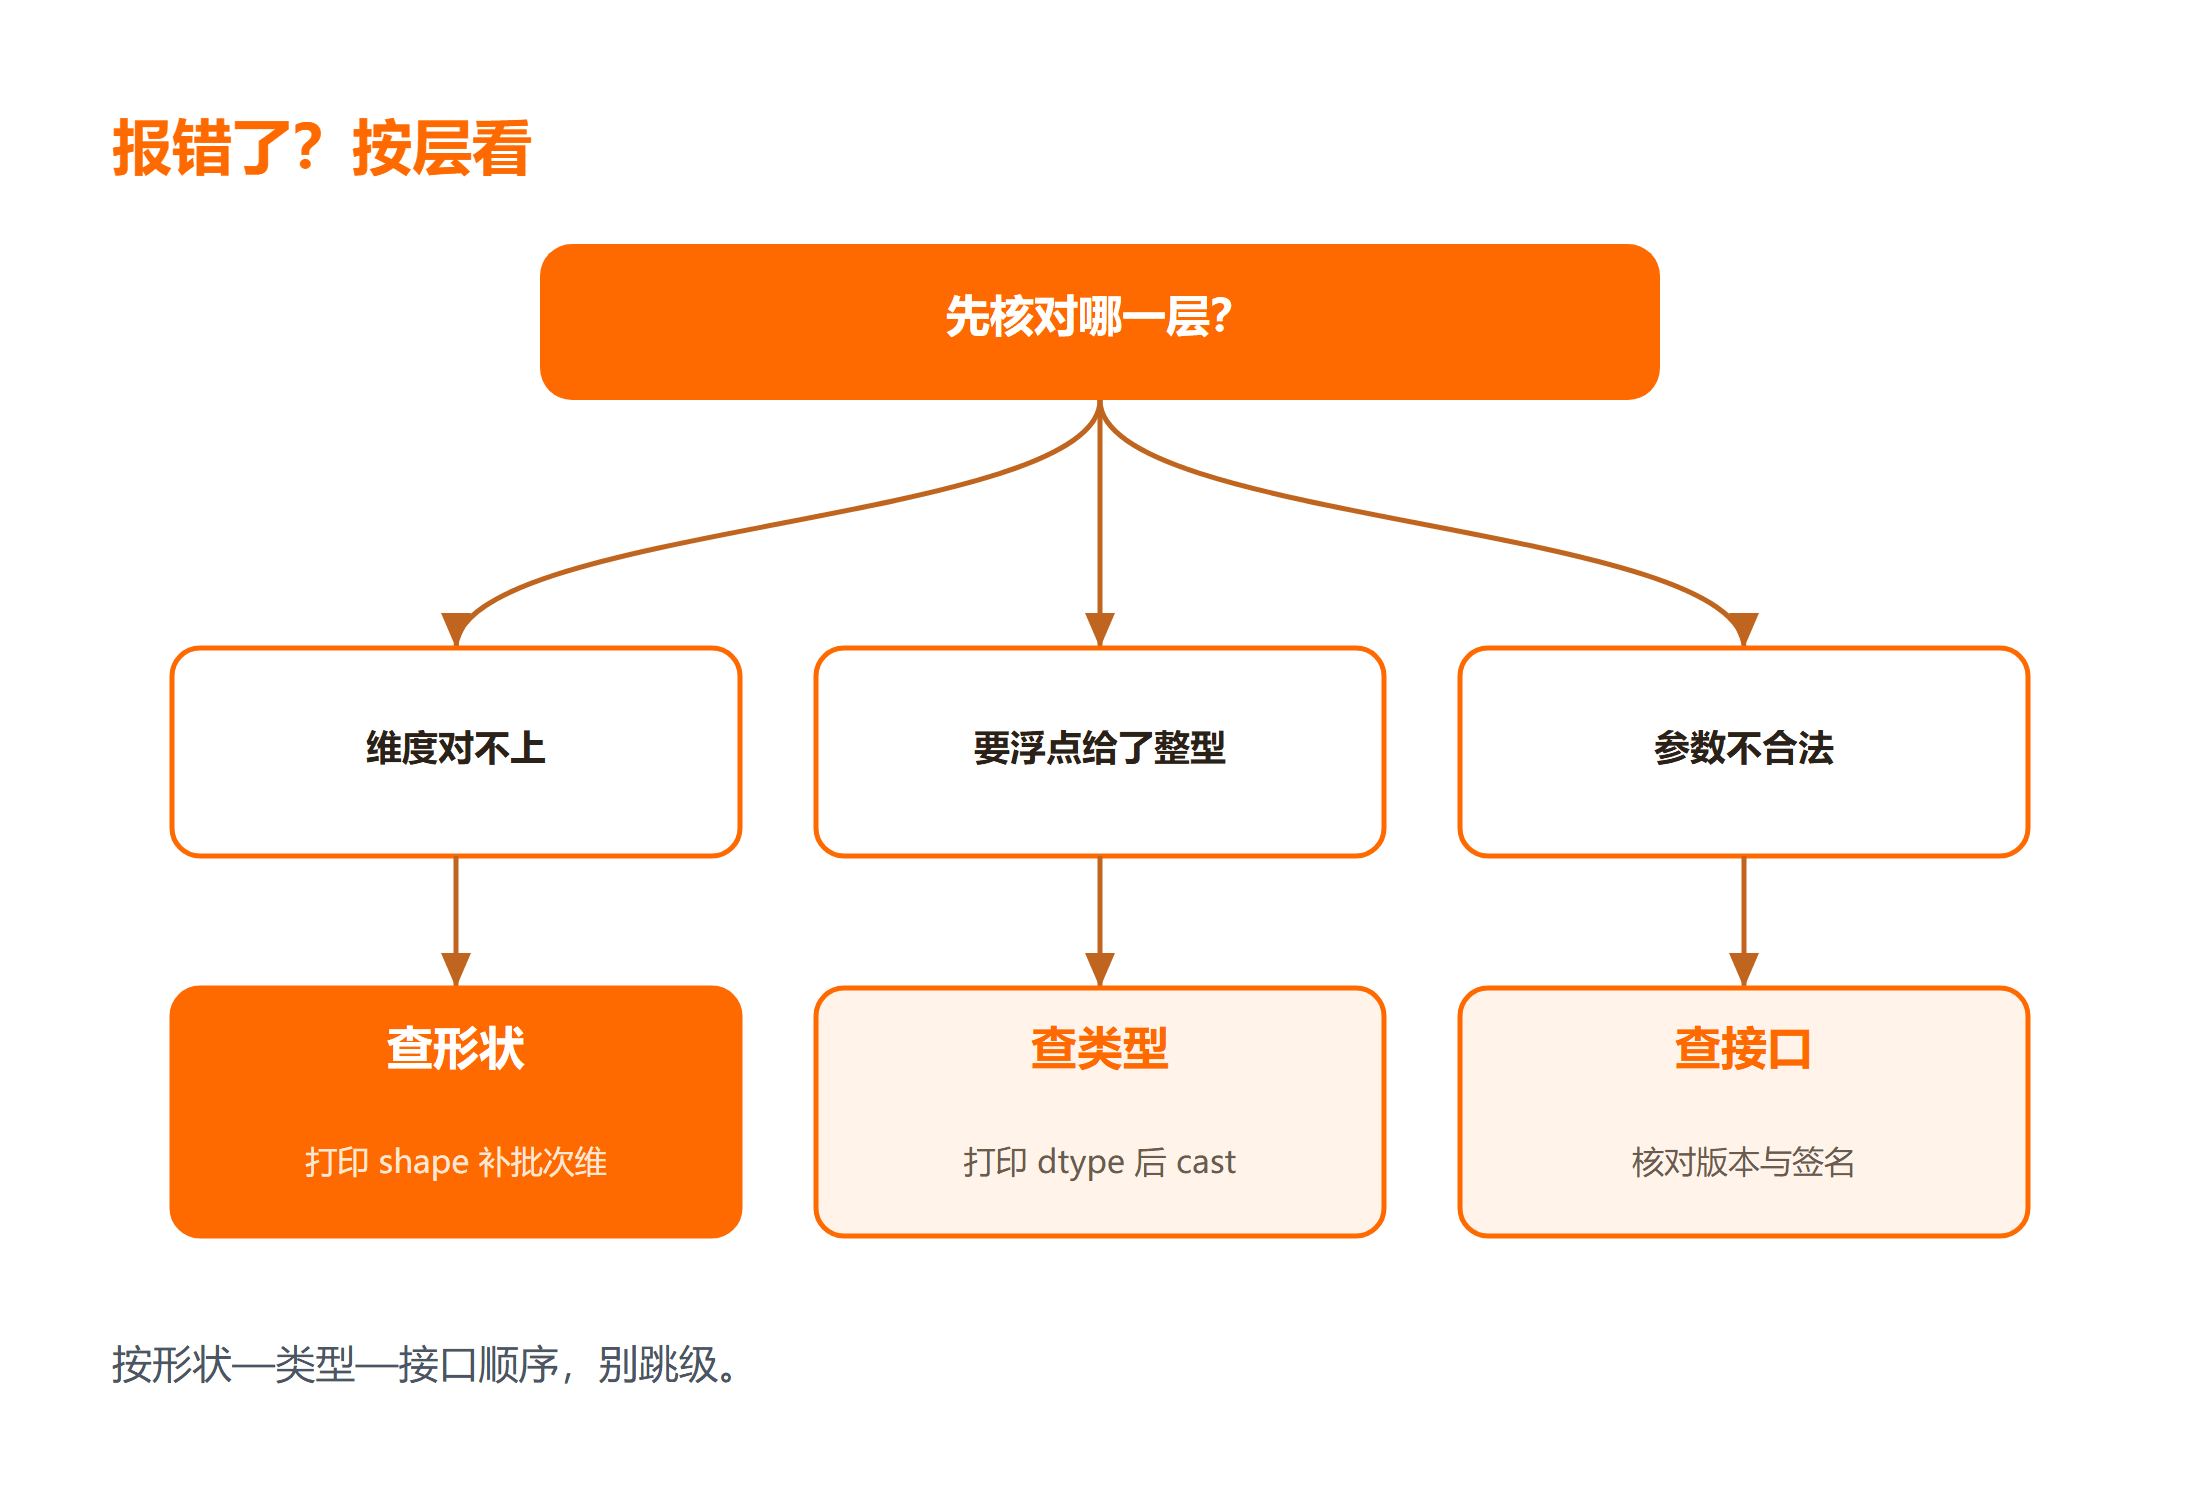
第二,按层次查,别跳级。先看形状对不对,再看数据类型,最后才怀疑接口用法。跳过前两层直接换接口,往往把简单问题复杂化。
第三,一次只改一处。改完就重跑最小示例,确认错误变化再决定下一步,这是从最小示例讲到边界的核心纪律。
一、最小场景与预期行为
先准备一段最小场景,用一张全连接层处理矩阵:
import tensorflow as tf

layer = tf.keras.layers.Dense(units=4, input_shape=(3,))
x = tf.constant([[1.0, 2.0, 3.0]])   # 形状 (1, 3)
y = layer(x)
print("输出形状:", y.shape)
这段定义一个输入 3 维、输出 4 维的全连接层,喂一条样本。预期结果(未在本机执行):输出形状为 (1, 4)。如果这里就抛 ValueError,多半是输入维度和 input_shape 不一致。关于张量与层的基础,可参考 人工智能基础章节。
⚠️ 注意:ValueError 是参数或取值不合法的通用异常,同类报错可能来自完全不同的原因。务必以括号里的具体描述为准,不要凭经验直接套解法。
二、做法一:核对形状
形状不匹配是最高频的一类。用 shape 逐层打印,能快速定位是哪一层开始对不上:
print("输入:", x.shape)
print("权重:", layer.kernel.shape)
print("输出:", layer(x).shape)
预期结果(未在本机执行):输入最后一维应等于权重第一维,否则会报形状不匹配。检查时重点看最后一维,全连接层要求除批次维外的维度与权重对齐。用错场景的典型例子是把形状 (3,) 的单条样本直接喂给期望 (batch, 3) 的层,这时补一个批次维即可:
x_single = tf.constant([1.0, 2.0, 3.0])
y = layer(tf.expand_dims(x_single, axis=0))   # (3,) → (1, 3)
关于性能取舍:补批次维几乎零成本,是这类问题最稳的解法;而 reshape 会改变数据排布,用错顺序会 silently 得错结果,能不用就不用。
三、做法二与做法三:类型与接口用法
3.1 数据类型不符
有些层要求浮点输入,喂进整型张量会抛 ValueError:
x_int = tf.constant([[1, 2, 3]])          # int32
x_float = tf.cast(x_int, tf.float32)      # 转成 float32
y = layer(x_float)
预期结果(未在本机执行):转换后正常输出,不转换则报类型不符。失败排查:先打印 x.dtype 确认类型,再做转换,别凭数据长相猜。处理类似的类型整理时,Python 容器操作也有讲究,比如列表去重时选 set 还是保持顺序,取舍思路是相通的。运行前建议先确认环境已安装匹配版本的框架,再重跑最小示例。
3.2 接口用法用错场景
同一个函数在不同版本、不同场景下签名不同,用错就会报参数不合法:
# 用 model.fit 时,标签需与输出维度一致
model.compile(optimizer="adam", loss="sparse_categorical_crossentropy")
预期结果(未在本机执行):标签为整数类别编号时选用 sparse 版本损失函数,若误用需要 one-hot 的版本,就会在训练时报 ValueError。适用边界:这一层跟具体版本和任务类型强相关,本文给的是通用核对思路,具体签名以官方文档为准。想用在线环境复现最小示例,可配合 Python3 在线工具是什么?怎么用?3 种方法一次讲清。
四、三层做法的区别与取舍
把三层做法摆在一起,选错层次是反复报错的主因。
| 层次 | 典型报错 | 首选做法 | 代价 |
|---|---|---|---|
| 形状 | 期望与实际维度不符 | 打印 shape、补批次维 | 几乎零成本 |
| 类型 | 要求浮点却给了整型 | 打印 dtype 后 cast | 转换有精度取舍 |
| 接口 | 参数或签名不合法 | 核对版本与签名 | 需读文档 |
- 避坑一:别把形状问题当成模型问题去改结构,先看 shape 往往一步到位。
- 避坑二:调试阶段用最小示例,输入越小越容易复现和验证。
- 避坑三:保持代码风格一致也省事,符合 PEP8 习惯的脚本更易复查张量流向;零基础读者建议先把形状和类型概念理清再上手。
- 失败处理:改一项、验证一项,确认错误是否变化,再决定下一步,避免多变量叠加。
- 适用边界:TensorFlow 报 ValueError 的成因远不止这三类,本文按通用流程整理,标为编辑推断;不同版本细节可能差异,以官方文档与你实际环境为准,文中未在本文环境逐项实测。
动手核对清单
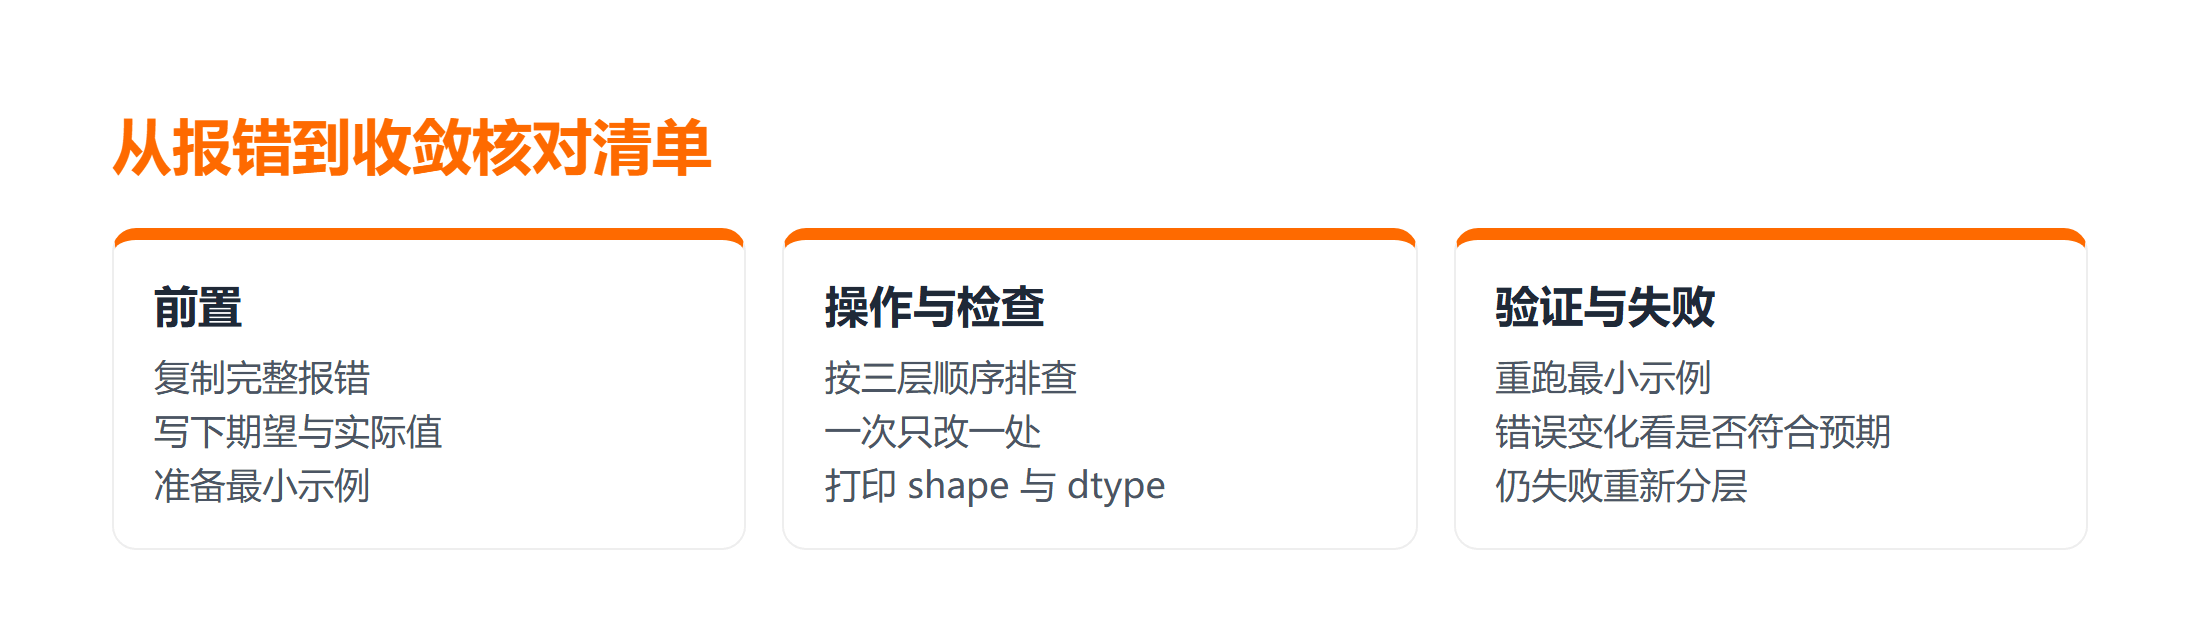
- 前置:复制完整报错,写下期望值与实际值;
- 操作:按形状—类型—接口顺序,一次只改一处;
- 检查:打印 shape 与 dtype,核对与层的定义是否一致;
- 验证:重跑最小示例,确认错误消失或变化;
- 失败处理:仍失败就回到报错全文重新分层,不叠加改动。
总结
TensorFlow 报 ValueError 的排查,核心是「读全报错、按层核对、一次改一项」。形状不匹配靠打印 shape 与补批次维,类型不符靠确认 dtype 后转换,接口问题靠核对版本与签名。三层混着试,只会把简单问题拖成复杂问题。把这份清单存下来,遇到报错先分层对号入座,多数情况都能快速收敛。
要点带走:
- 括号里的期望值与实际值是第一线索;
- 形状问题先看最后一维,补批次维最稳;
- 类型问题先打印 dtype,再决定 cast;
- 接口问题以官方文档为准,别凭记忆签名。
常见问题
Q:报错说形状不符,但我打印的形状看着是对的?
A:注意批次维。很多层期望 (batch, features),而单条数据是 (features,),看着「对」其实少了一维。用 tf.expand_dims 补一维再试。
Q:类型和形状都对了,还是报 ValueError,怎么办?
A:这时大概率是接口用法或版本差异。核对函数签名、损失函数与标签格式是否匹配,必要时对照官方文档确认该版本的参数要求。
Q:改了之后错误变了,是变好了吗?
A:不一定。错误变化说明你的改动起作用了,但要回到最小示例确认输出是否符合预期,别只看「不报原来的错」就算通过。
延伸学习
想系统补齐 Python 与 AI 排查的知识,可以按这个顺序来:
- 想打牢 Python 基础,可以看 Python 零基础到高薪就业;
- 想巩固调试时的写法分层思路,翻 Python 列表去重:4 种方法一次讲清(附最小示例与避坑),从 set 到保持顺序;
- 需要整理调试脚本的代码风格,用 Python代码格式化 辅助检查。



