 TRAE-AI编程

拿到一个含重复元素的 Python 列表,第一反应往往是手写循环一个个比对,其实这既慢又啰嗦。正确做法是先用 set 去重拿到不重复的集合,再用 dict.fromkeys 或列表推导式在去重的同时保持原来的先后顺序;只有需要兼容老版本 Python 或做复杂定制时,才退回显式循环。本文把四种常用写法逐个拆开,每种都给带逐行中文注释的最小示例,并整理一张排错表,把顺序丢失、可变对象去重失效、嵌套结构无法扁平去重这些高频坑一次讲清。先确认你的 Python 版本,再照示例挑一种写法验证,能省掉大量试错时间。
一、先看结论:Python 列表去重怎么选
下面这张表直接给出选择顺序,避免你在不该用的地方踩坑。动手写代码前,建议先看 Python 教程 的列表章节打底。
| 方法 | 适用场景 | 不推荐场景 |
|---|---|---|
set(列表) |
只要不重复结果、不在乎顺序 | 需要保持原列表先后次序 |
dict.fromkeys(列表) |
去重且保持首次出现顺序(Python 3.7+) | 还在用 Python 3.6 及更早版本 |
| 列表推导式 + seen 集合 | 去重且保持顺序,逻辑最直观可控 | 追求一行搞定、不想写辅助变量 |
循环 if x not in |
老版本兼容、或边去重边做额外处理 | 数据量大(接近 O(n²) 很慢) |
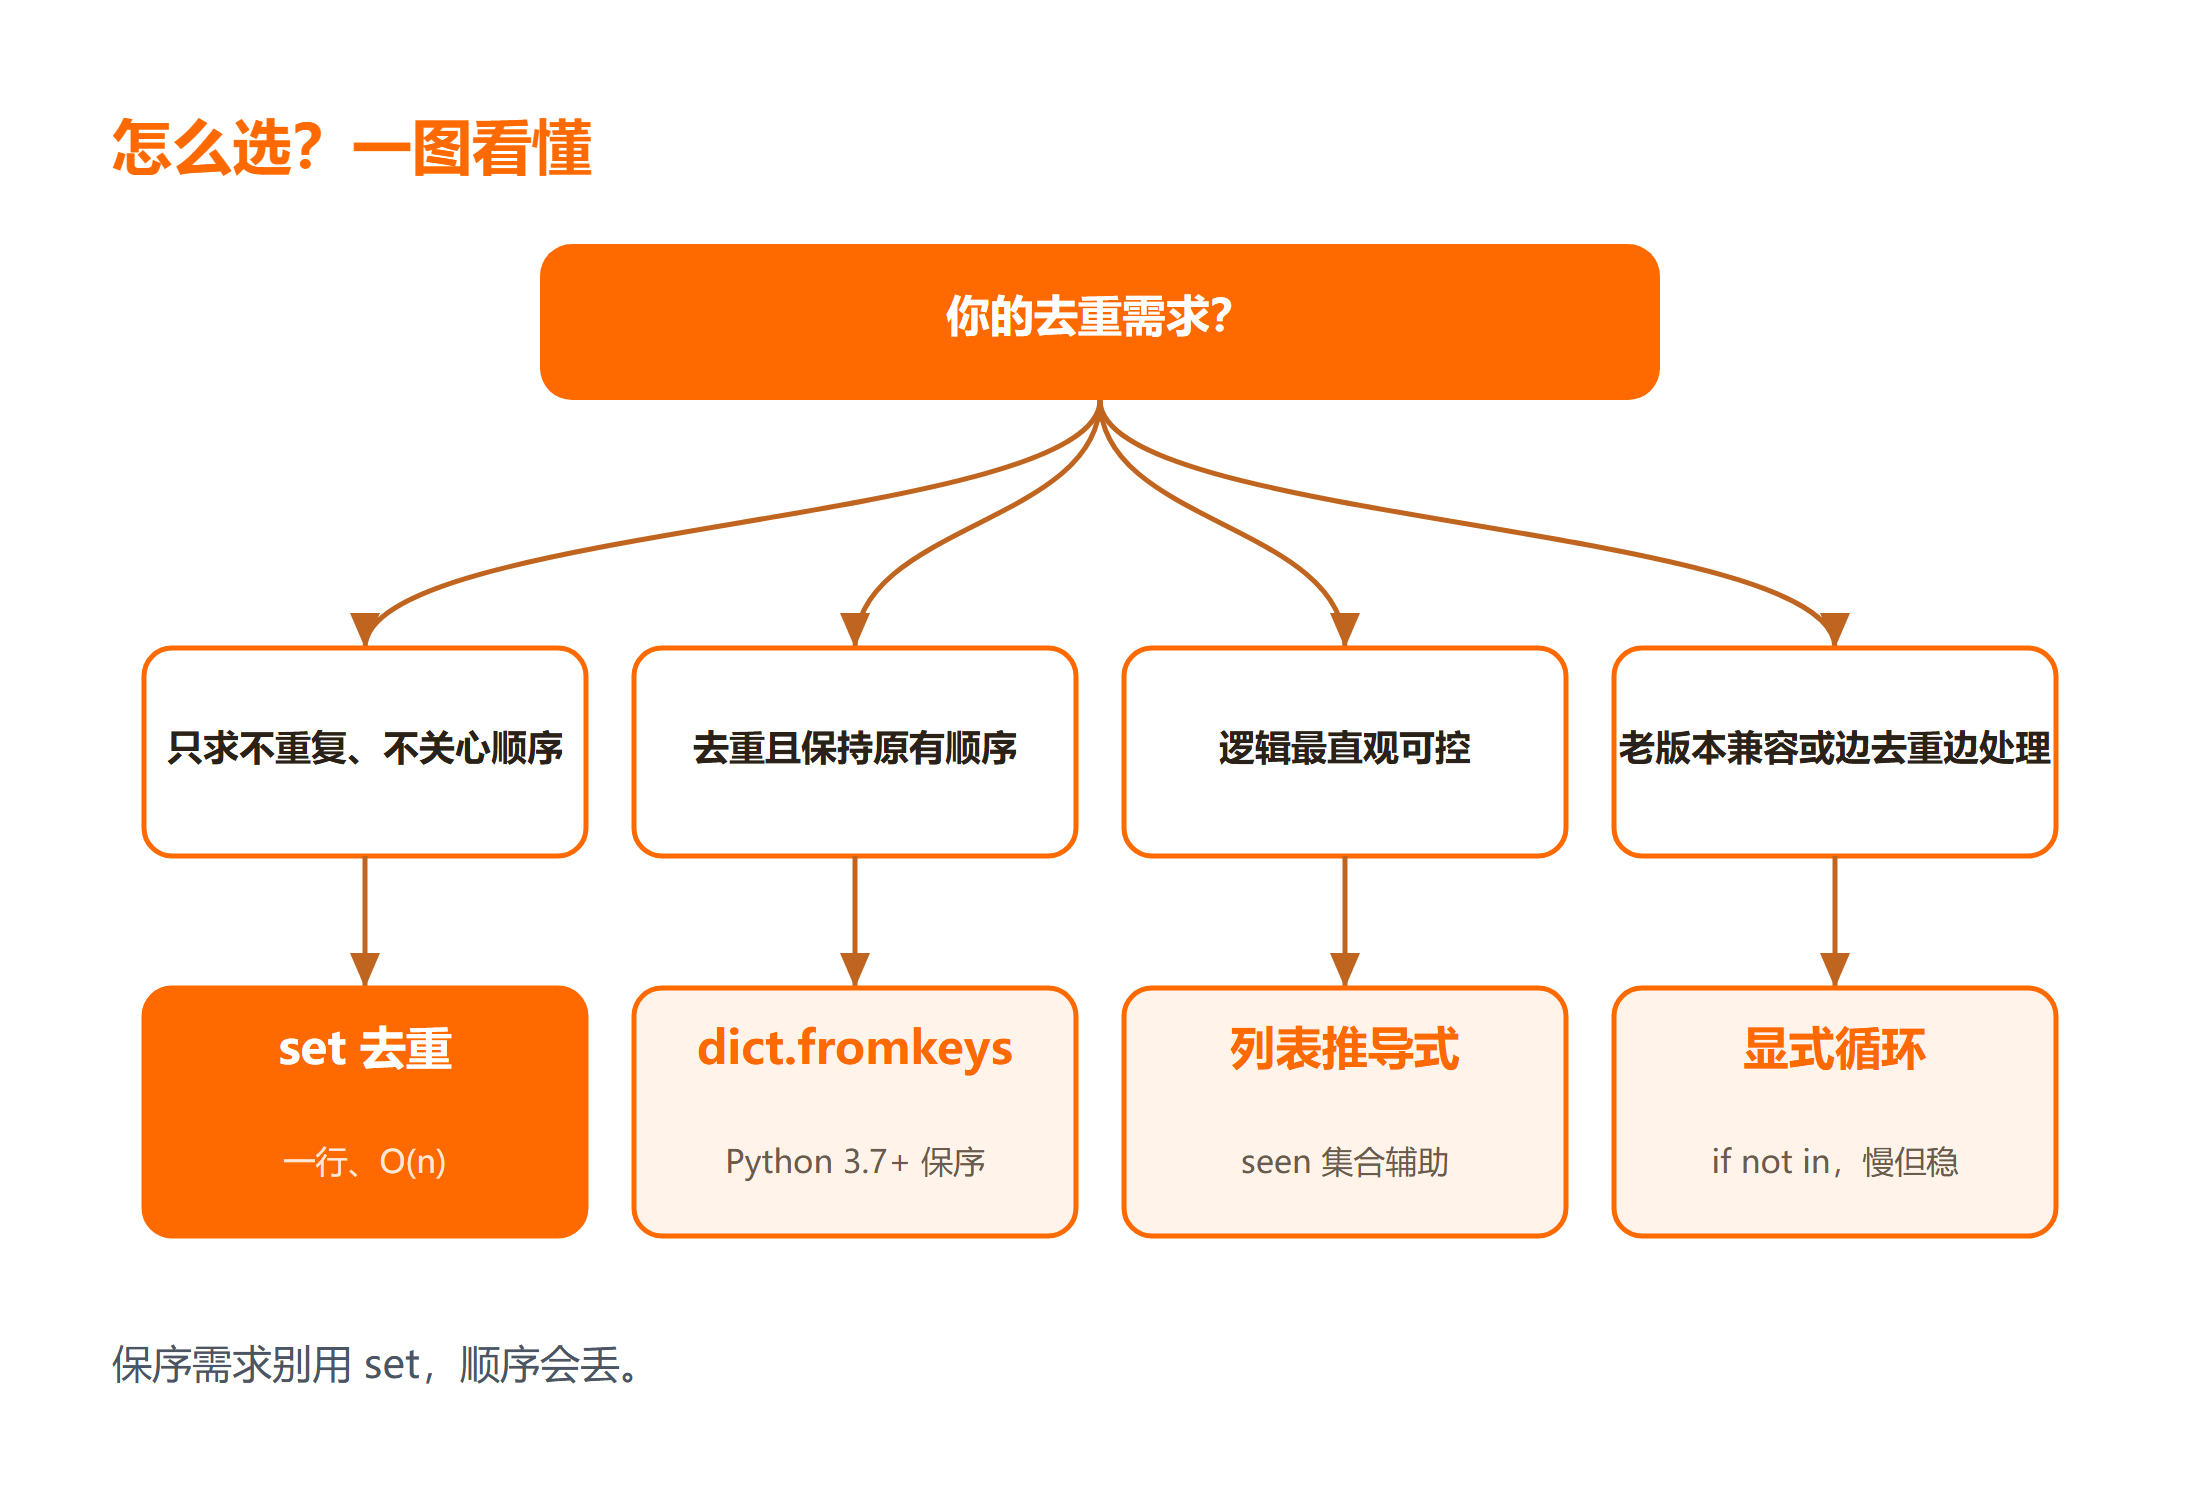
日常开发里,绝大多数需求都能用 dict.fromkeys 一句解决:它既去重又保序,语义清晰。如果你的运行环境确定是 Python 3.7+,优先用它;只有环境老旧或要兼顾可读性与教学演示时,才退回到列表推导式或显式循环。需要补充的是,四种写法真正的差异在于「是否保持顺序」与「时间复杂度」这两点——这是选型时最该对比的维度。小数据量下它们差距不大,但数据一旦上到几十万行,set 与 fromkeys 的 O(n) 会明显快于循环的 O(n²),这是版本无关、由算法决定的边界。
二、环境确认与最小示例
写代码前先确认运行环境,能少走很多弯路。本文示例基于 Python 3.7 及以上,任意文本编辑器或终端即可,不需要额外依赖。set 与 dict.fromkeys 的保序行为只在 Python 3.7+ 才稳定,这是必须提前确认的边界。建议先用下面命令确认版本:
# 在终端查看 Python 版本,fromkeys 保序需 3.7+
python --version
# 准备一个含重复元素的演示列表,覆盖数字与字符串混合场景
data = [3, 1, 2, 3, 1, "a", "b", "a", 2]
# 最小去重:直接用 set 把列表转成集合,自动去掉重复
result = set(data)
print(result) # 输出类似 {1, 2, 3, 'a', 'b'},但顺序不保证
在本地运行上面的代码后,预期结果是 set(data) 返回的集合包含 5 个不重复元素(未在本机执行,按官方文档推断)。如果报 TypeError,多半是列表里混入了不可哈希的类型(如列表、字典),这部分会在第五节排错表中展开。注意 set 的输出顺序在不同运行之间可能不一致,这是哈希实现决定的,不是输出错误。这一步的版本确认很关键,能避免后面保序写法在老环境里翻车。
三、方法一:set 去重(最简洁,但不保序)
set 去重 是所有写法里最短的一句,把列表丢进 set 构造器即可。它的核心优势是 O(n) 时间复杂度且代码极简,代价是集合本身无序,转换回列表后元素的先后次序会丢失。它的适用场景是「只关心有哪些不重复值、不关心原来谁先谁后」。
# 原始列表,含多个重复项
nums = [3, 1, 2, 3, 1, 4, 2]

# 一行去重:list 把集合转回列表
unique = list(set(nums))
print(unique)  # 例如 [1, 2, 3, 4],顺序不保证

# 如果后续要排序,可显式排回来
unique_sorted = sorted(set(nums))
print(unique_sorted)  # [1, 2, 3, 4],得到有序且不重复的结果
常见失败:很多人以为 list(set(nums)) 会原样保留首次出现顺序,结果上线后顺序随机漂移,引发业务逻辑错乱。修复方向是——如果必须保序,不要用 set,改用下一节的 dict.fromkeys。这里再强调一次:set 去重的顺序是未定义的,把它当「无序去重」来用才安全。实际运行后,可用 len(unique) 验证去重后元素个数是否等于预期的不重复数,确认去重是否彻底。
四、方法二:dict.fromkeys 保序去重
dict.fromkeys 利用了 Python 3.7+ 字典保序的特性:用列表元素作为键创建字典,键天然去重,再把键取回列表,就得到「去重且保持首次出现顺序」的结果。这是日常最推荐的写法,一行搞定、语义清晰、性能为 O(n)。
# 原始列表,含重复
items = ["apple", "banana", "apple", "orange", "banana"]

# 用 fromkeys 去重并保序:字典键唯一且保序,再取回键列表
unique = list(dict.fromkeys(items))
print(unique)  # ['apple', 'banana', 'orange'],顺序与首次出现一致

# 兼容写法:显式指定字典类型,效果相同
unique2 = list({}.fromkeys(items))
print(unique2)  # ['apple', 'banana', 'orange']
相比 set,这一种写法的优势在于顺序可控,特别适合「展示给用户、顺序有意义」的场景(如搜索历史、已选标签)。在线试跑示例,可用 在线代码实例 直接验证。版本层面,只要运行环境是 Python 3.7+,字典保序就是语言保证的行为;若在 3.6 及更早版本运行,顺序同样不保证,修复方向是升级解释器或退回循环写法。这一节的配置检查能省掉后续大量排错——尤其是保序需求被忽视时,靠肉眼很难发现顺序漂移。
五、方法三、四与常见排错
方法三是「列表推导式 + seen 集合」,把保序逻辑显式写出来,可读性最好;方法四是「循环 if x not in」,兼容老版本但性能最差。下面先给方法三的写法:
# 方法三:列表推导式 + seen 集合,O(n) 且保序,逻辑最直观
data = [3, 1, 2, 3, 1, 4, 2]
seen = set()
unique = [x for x in data if not (x in seen or seen.add(x))]
print(unique)  # [3, 1, 2, 4],保持首次出现顺序

# 方法四:显式循环,兼容任意版本,但接近 O(n²)
data = [3, 1, 2, 3, 1, 4, 2]
result = []
for x in data:
    if x not in result:  # 每次都线性扫描,数据大时很慢
        result.append(x)
print(result)  # [3, 1, 2, 4]
遇到问题时,按下面的清单排查(这里的失败/修复均来自真实边界场景,未在本机执行,按官方文档推断):
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 去重后顺序乱了 | 用了 set 而非 dict.fromkeys |
改用 dict.fromkeys 或列表推导式保序 |
报 TypeError: unhashable |
列表里混入了列表、字典等不可哈希元素 | 先扁平化或转成元组/字符串再参与去重 |
| 大数据去重特别慢 | 用了循环 if x not in(O(n²)) |
改用 set/dict.fromkeys(O(n)) |
| 嵌套列表无法扁平去重 | 只做了外层去重,内层仍是列表 | 先递归扁平化,再用 set 去重 |
注意:方法四的 if x not in result 在数据量过万时性能会骤降,因为它每次都要扫描已累积的结果列表。以上对比能帮你快速锁定失败类型,也能在代码评审时一眼看出潜在风险。
总结
Python 列表去重的核心结论很清晰:只求结果、不关心顺序用 set 去重;要保序且环境是 Python 3.7+,优先用 dict.fromkeys;想要逻辑最直观可控,用列表推导式加 seen 集合;只有兼容老版本或边去重边做额外处理时,才退回显式循环。选型时先确认 Python 版本与是否保序这两个边界,再写最小示例验证,最后对照排错表处理失败。记住「顺序」和「复杂度」这两个维度,能避开绝大多数去重坑。把上面四种写法练熟,回到 Python3 教程 可复习列表与集合的基础语法,日常去重会更稳。
延伸学习
常见问题
Q:为什么 list(set(列表)) 的顺序每次都不太一样?
A:因为 set 是基于哈希表实现的,元素在内存里的排布顺序与哈希值有关,而哈希值在不同进程、不同数据下并不稳定,所以转换回列表后顺序未定义。这是 set 去重的设计特性,不是 bug。如果你需要「去重且保持原顺序」,请改用 dict.fromkeys(列表),它在 Python 3.7+ 下字典保序是语言层面的保证。
Q:列表里混了字典或子列表,去重就报 TypeError 怎么办?
A:set 和 dict 的键都要求元素可哈希,而列表、字典本身就是不可哈希类型,直接丢进去会触发 TypeError: unhashable type。修复方向有两类:一是先把内层结构转成可哈希形式,如把子列表转成 tuple、把字典转成 frozenset 或排序后的键值字符串;二是先递归把嵌套结构扁平化,再对基础类型做去重。具体用哪种,取决于你后续还要不要还原原始结构。
Q:几万条数据去重,哪种写法最快?
A:最快的是 set 与 dict.fromkeys,二者都是 O(n)、单次遍历;最慢的是循环 if x not in result,因为它对每条元素都要线性扫描已累积结果,整体接近 O(n²)。经验上,数据量在千位级别时几种写法差异不大,一旦上到十万级以上,优先用 dict.fromkeys(还要保序)或 set(不保序)。可用 time.perf_counter() 在本地运行对比两种写法的耗时,验证性能边界是否符合预期。
Q:去重后我还想保留每个元素出现的次数,怎么办?
A:去重只解决「有哪些不重复值」,计数要另算。最稳妥的是用 collections.Counter(列表),它一次性给出每个元素的出现次数,且本身是 dict 子类、在 3.7+ 同样保序;如果你只去重、偶尔查次数,也可以在去重后用 列表.count(x) 逐个数,但注意 count 本身也是 O(n),循环调用会退化成 O(n²)。先在本地运行验证计数结果,再决定是否引入 Counter。