 免费 AI IDE

JavaScript 数组去重并不只有一种写法:基础类型可以用 Set,对象数组通常要按 id 或业务字段使用 Map,若还要保留首次出现顺序,就必须明确覆盖规则。先说清楚“相等”的定义,再选择实现,才能避免把两个不同用户误合并。本文用数字数组、对象数组和重复字段三组数据比较 Set、Map 与循环写法。 本文示例基于现代 JavaScript,覆盖基础值、对象数组、保留顺序与复杂度;如果业务中的“重复”由多个字段共同决定,应先写出键规则,再选择 Set、Map 或显式循环。
一、基础类型优先考虑Set
Set按值判断重复项,写法短,返回顺序按首次插入顺序保留。它适合字符串、数字和布尔值,但对象即使内容相同,只要不是同一个引用也会被视为不同。
const values=["js","css","js","html"];
console.log([...new Set(values)]);
运行后应看到: 基础值数组按值去重并保持首次出现顺序。
二、对象数组先定义去重字段
对象数组去重前要决定使用id、email还是组合键。Map以键覆盖旧值,最终顺序取决于插入策略;如果要保留第一条记录,需要先判断是否已有键。
如果这里的基础语法还不熟,可以先查 JavaScript 教程,再回到下面的完整示例。
const users=[{id:1,name:"A"},{id:1,name:"A-new"},{id:2,name:"B"}];
const byId=new Map();
for(const user of users){ if(!byId.has(user.id)) byId.set(user.id,user); }
console.log([...byId.values()]);
运行后应看到: 对象数组按 id 生成唯一键。
三、Map覆盖和保留首次出现不同
Map.set同一个键会覆盖值,但键的顺序不会重新移动。保留最后一条适合数据流中后到记录更可信的场景;保留第一条适合避免后续脏数据覆盖已确认结果。把策略写进函数名或注释,不要让调用者猜。
function uniqueLast(items){
 const m=new Map(items.map(item=>[item.id,item]));
 return [...m.values()];
}
console.log(uniqueLast(users));
运行后应看到: 保留首次和保留最后一次得到不同结果。
四、稳定顺序和排序是两件事
去重通常不应顺便排序。Set和Map会保留插入顺序,但排序会改变用户看到的顺序和分页结果。若业务要求按时间排序,应在去重完成后单独调用sort,并写明时间相同时的二级键。
如果这里的基础语法还不熟,可以先查 JavaScript 速查手册,再回到下面的完整示例。
const rows=[{id:2,t:10},{id:1,t:20},{id:2,t:30}];
const unique=[...new Map(rows.map(x=>[x.id,x])).values()];
console.log(unique.map(x=>x.id));
运行后应看到: 排序不是去重,原顺序要求需单独说明。
五、用复杂度和数据规模做选择
Set和Map平均是O(n),适合线性处理;每次用findIndex扫描已有结果会变成O(n²),小数组可读性较好,大列表会明显变慢。先测真实数据量,再决定是否需要索引或批处理。
function uniqueById(items){
 const seen=new Set(); const out=[];
 for(const item of items){ if(!seen.has(item.id)){seen.add(item.id);out.push(item);} }
 return out;
}
console.log(uniqueById(rows));
运行后应看到: 大数组用 Map 避免嵌套遍历的平方级增长。
边界值对照
Set 对 NaN 能正确去重,但 null、字符串和数字仍按不同类型区分;对象数组要明确按哪个字段比较。若需要深比较,应先说明成本和循环引用风险,不要把 JSON.stringify 当成通用方案。
从基本类型到对象数组
先用 [1, 1, NaN, NaN, null, "1"] 测试 Set,预期保留一个 NaN,但数字 1 和字符串 "1" 仍是两个值。对象数组不能直接用 new Set() 按内容去重,因为每个对象引用不同;应明确按 id、邮箱或组合键比较,并决定冲突时保留第一条还是最后一条。
如果数据量较大,用 Map 保存已见键并在循环中记录重复项;如果必须深比较,先说明嵌套对象、数组顺序和循环引用的规则。JSON.stringify 只适合结构稳定、键顺序可控的简单数据,不能替代通用深比较。
验收至少覆盖空数组、单元素、重复基本类型、缺少 id、id 类型不一致和两条内容不同但键相同的记录。输出去重结果之外,再输出删除数量,避免“看起来少了一条”却无法定位规则。
怎么判断该选哪条路径
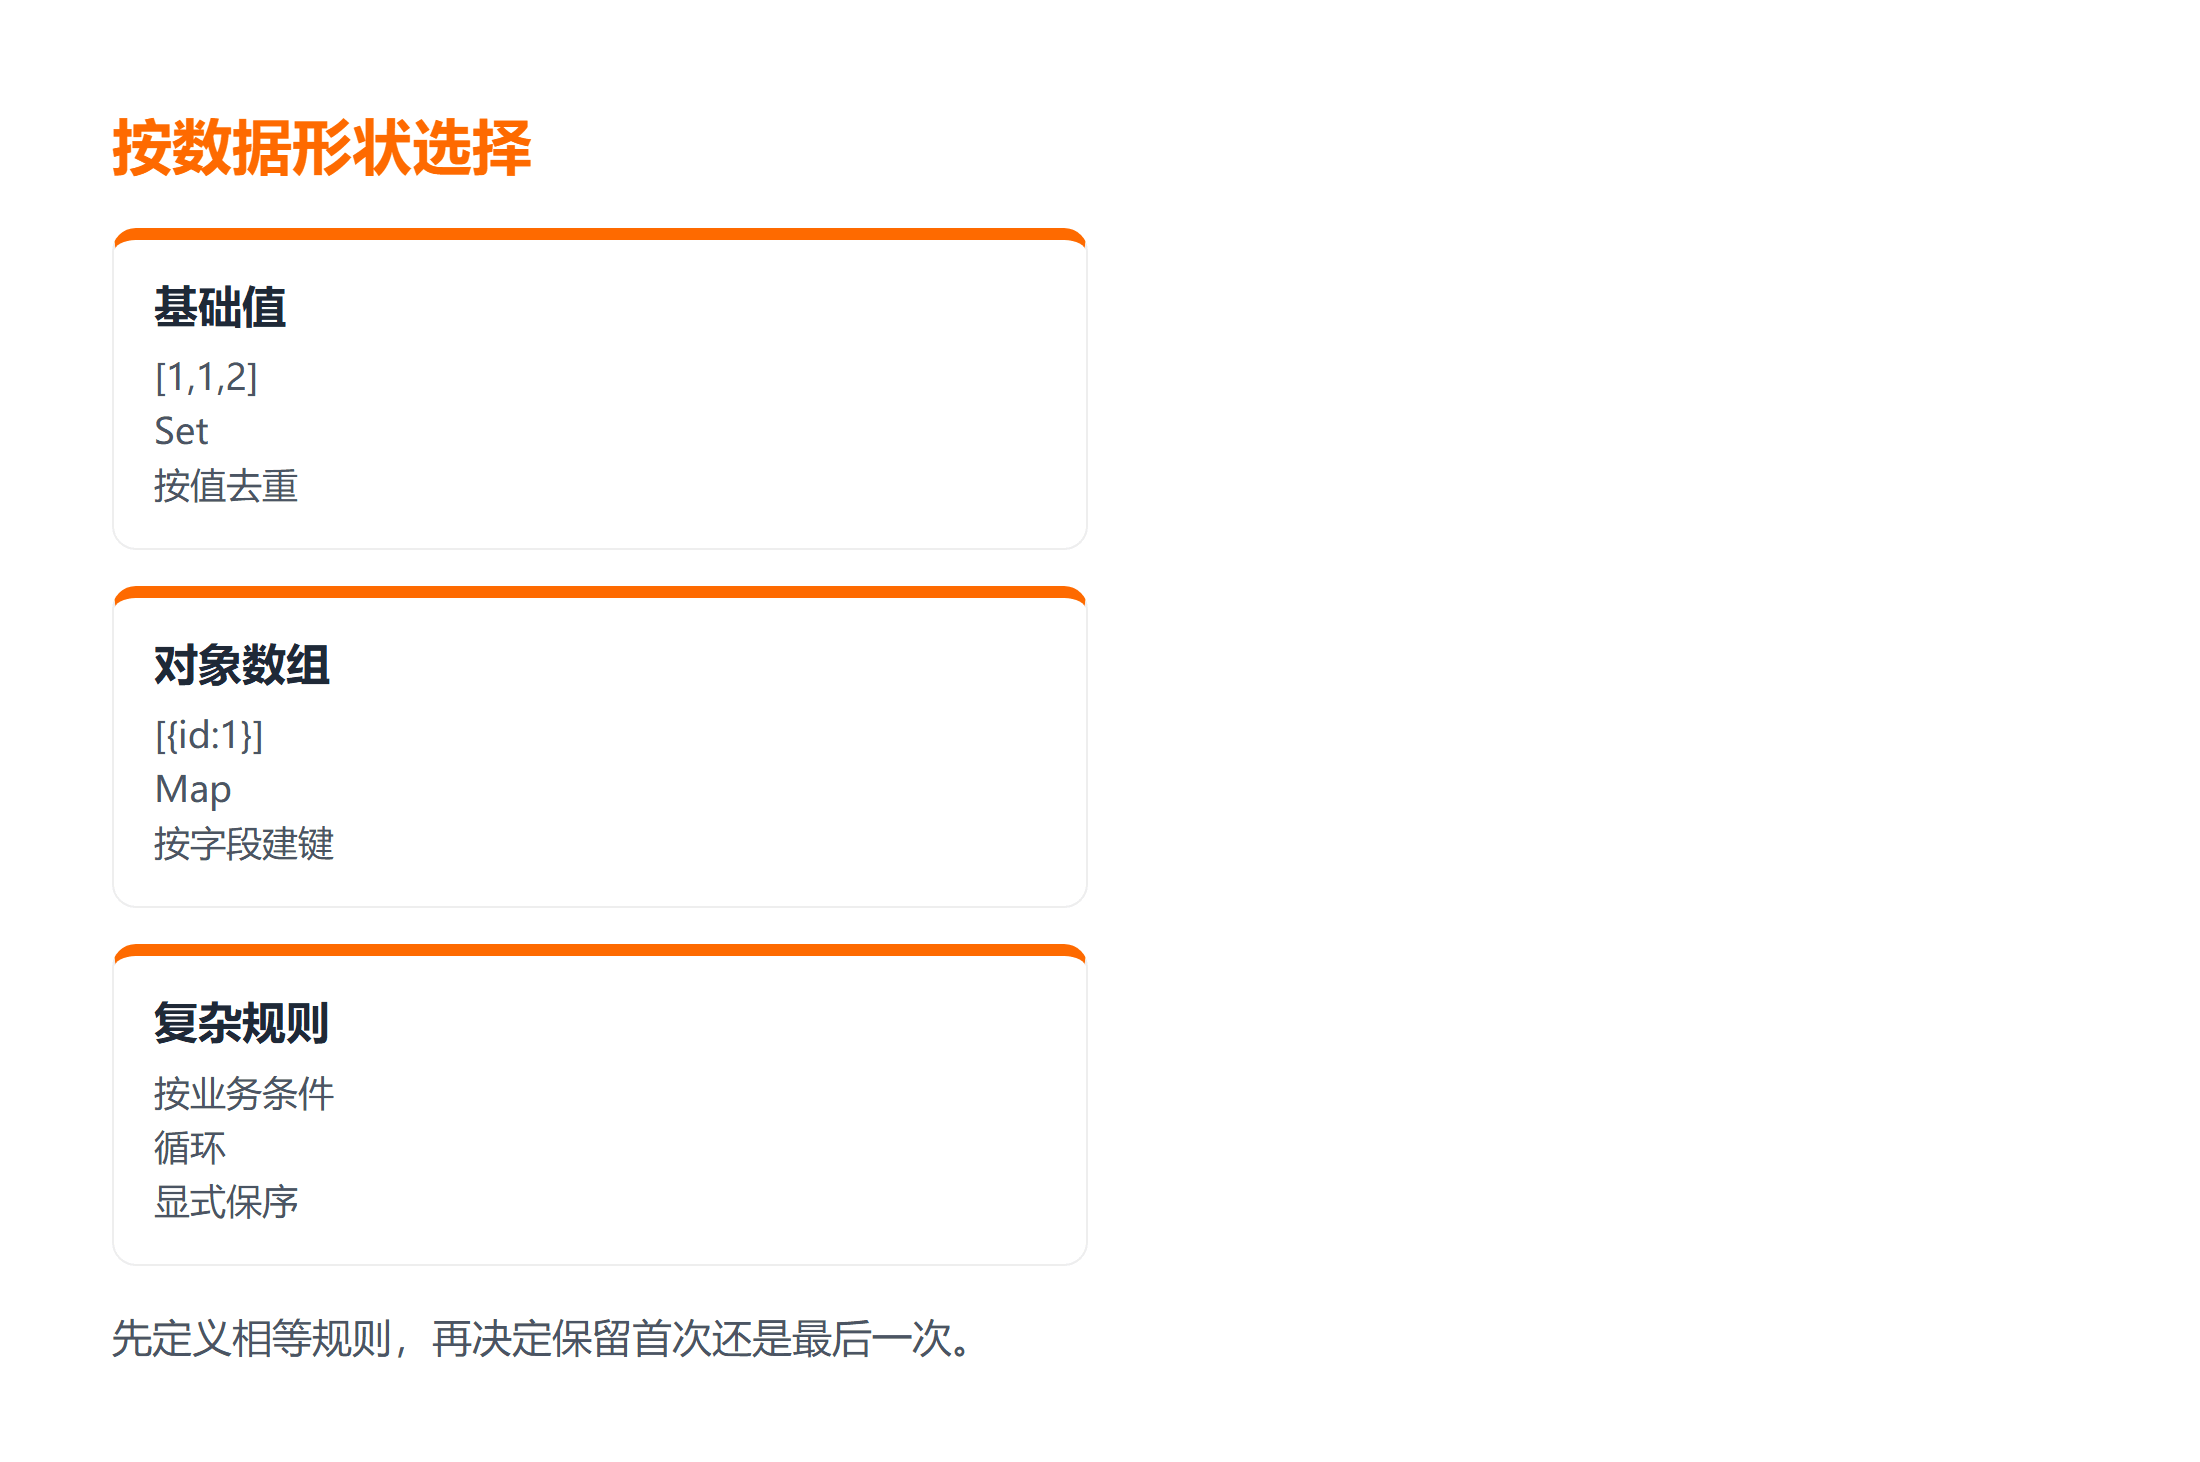
去重前先定义“相等”:基础值按值比较,对象通常按 id 或业务组合键,深层结构则要明确键顺序、数组顺序和循环引用。然后再决定保留第一条还是最后一条,以及是否保持原顺序。Set 适合基础值,Map 适合按键处理对象,filter 加 findIndex 更直观但大数组上会重复扫描。方法选择来自数据形状,而不是代码长短。
用一组输入覆盖相等规则
准备基础值 [1, 1, NaN, NaN, "1"]、对象数组 [{id:1,name:"A"},{id:1,name:"B"}] 和缺少 id 的对象。运行 Set 示例时检查数字 1 与字符串 "1" 是否保留;运行 Map 示例时分别验证保留首次和保留最后一次;再把 1 万条输入扩大到 10 万条,比较 Map 与嵌套查找的耗时趋势。失败不是程序报错才算,丢失顺序、误合并不同类型或覆盖错误记录同样是失败。验证结果应包含输入长度、输出长度和重复数量。
按数据形状选择实现
| 数据形状 | 推荐方案 | 关键取舍 |
|---|---|---|
| 字符串、数字等基础值 | Set | 简洁并保持首次出现顺序 |
| 对象按单字段去重 | Map | 明确保留首次或最后一次 |
| 对象按组合字段去重 | 组合键 + Map | 处理分隔符和类型冲突 |
| 深层对象比较 | 专用比较函数 | 成本高,需处理循环引用 |
如果输入来自接口,还要先统一 id 的类型;数字 1 与字符串 "1" 是否视为同一条记录,属于业务规则,不能由去重代码替你决定。
排错速查
| 症状 | 先检查什么 | 处理建议 |
|---|---|---|
| 对象仍有重复 | 确认是否按业务字段生成键 | 用 Map 按 id 或组合键保存 |
| 顺序被改变 | 检查是否先排序再去重 | 明确保序要求并保留首次出现 |
总结
数组去重先定义相等规则,再选择工具:基础值用Set,对象按字段用Map或Set,保留首次还是最后一次要明确写出。去重不等于排序,复杂度也要结合真实数据量验证。
延伸学习
下面三项分别用于系统学习、补充同主题案例和随手查阅。
常见问题
Q:为什么两个内容相同的对象没有被Set去重?
A:Set比较对象引用,不会自动比较每个字段;需要按id等业务字段建立键。
Q:Map去重保留哪一条?
A:直接set会保留最后写入的值;如果要保留第一条,需要先判断has。