
 TRAE-AI编程

国内大模型泛指由国内团队研发、主要服务中文场景的大语言模型;对开发者来说,最快的上手方式是用 Python 调用它们开放的 API。
你正打算在项目里接一个中文模型,却被文心、通义、智谱、DeepSeek、豆包、Kimi 这些名字挑花眼:到底哪个能直接调、哪个开源能本地跑?本文不堆名单,而是按"能调用、能开源、能落地"三条线,用真实可运行的 Python 示例,帮你把主流国内大模型接进自己的代码。公开模型至少上百个,但日常开发常用的其实不到十家。今天这篇文章,编程狮就从"怎么用"而不是"有哪些"的角度把它讲透。
一、国内大模型现状:从开发者视角怎么看
两年前聊中文大模型,默认只有一个参照物;现在百度、阿里、腾讯、字节、智谱、DeepSeek、月之暗面、百川都拿出了可对话、可嵌入产品的模型。如果只把它们当成"又一个聊天机器人",就浪费了开发者最该关心的两点——能不能当接口调、能不能拿权重自己部署。
把公开清单里两百多个名字按"开发者能不能直接用"切成三类:
| 类型 | 代表模型 | 开发者能做什么 |
|---|---|---|
| 闭源 API 型 | 文心一言(百度)、豆包(字节)、混元(腾讯)、星火(讯飞) | 注册拿 Key,走 HTTP 接口调用,不能改模型本身 |
| 开源权重型 | 通义千问 Qwen(阿里)、ChatGLM(智谱)、DeepSeek、Yi(零一万物) | 可下载权重本地部署,也可走官方 API |
| 行业垂类型 | 医疗、金融、法律等垂直模型 | 多在封闭场景试用,开发者一般接触不到通用接口 |
选模型时真正影响你写代码的是三件事:其一,开源还是 API——开源能私有化、可微调但要自己运维显存,API 开箱即用、按量计费;其二,上下文长度,模型一次能"记住"的文本上限用 token 计量,喂长文档前先估算量级;其三,中文与生态,有的对古文黑话更稳,有的和自家云产品绑得紧。想彻底搞懂"接口"这件事,可以读这篇 什么是 API\。
二、动手前准备:Python 环境与 Key 安全保管
不管接哪家,前置动作都一样。先确认本机有 Python 3.8 及以上,命令行能跑 python --version。
接着安装官方或兼容的 SDK。通义、DeepSeek、智谱、豆包、混元、Kimi、百川都提供 OpenAI 兼容接口,装一个 openai 包即可;文心走百度智能云千帆,需额外装 qianfan:
# 建议先建虚拟环境再装,避免污染全局
python -m venv venv
source venv/bin/activate        # Windows 用 venv\Scripts\activate
pip install openai qianfan
最关键的是保管 Key。把密钥写死在代码里、顺手提交到 Git,是新手最常见的泄露方式。正确做法是用环境变量,代码里只读取变量名:
import os

# 从环境变量读 Key,绝不写死在源码
dashscope_key = os.getenv("DASHSCOPE_API_KEY")
if not dashscope_key:
    raise SystemExit("请先设置环境变量 DASHSCOPE_API_KEY")
这样代码被分享也拿不到密钥;本地把变量写进 .env 并加进 .gitignore 即可。如果 Python 基础还不牢,建议先把 Python3 教程\ 的基础章节过一遍。
三、实战一:用 Python 调用通义千问(Qwen)
通义千问(Qwen)是阿里开源又提供 API 的代表,它开放了和 OpenAI 兼容的接入方式,意味着你几乎不用学新接口。下面这段是最小可运行示例(需先装 openai 并设好 DASHSCOPE_API_KEY):
from openai import OpenAI
import os

# 把 base_url 指向阿里 DashScope 的兼容端点
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

resp = client.chat.completions.create(
    model="qwen-plus",                       # 也可换 qwen-turbo / qwen-max
    messages=[{"role": "user", "content": "用一句话解释什么是大模型"}],
)

# 预期返回:模型生成的一段中文回答字符串
print(resp.choices[0].message.content)
这段做了三件事:指定兼容端点、选模型、发一条用户消息。返回对象是结构化的,答案挂在 choices[0].message.content。具体模型名和可用区域以阿里官方文档为准,本文示例用 qwen-plus 仅作演示。
四、实战二:一套客户端接全家(DeepSeek、智谱、豆包、混元、Kimi、百川)
真正省事的地方在这里:DeepSeek、智谱 GLM、字节豆包、腾讯混元、月之暗面 Kimi、百川,全都暴露了 OpenAI 兼容接口。你不用为每家重写客户端,只要把三个值——base_url、api_key、model——抽成配置,就能用一个函数切换模型。这就是国产模型"接口趋同"给开发者带来的红利。
先用 DeepSeek 与智谱验证最基础的写法(两者仅端点与模型名不同):
from openai import OpenAI
import os

# DeepSeek:换端点和模型即可,其余写法完全一致
deepseek = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com/v1",
)
r1 = deepseek.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "用 Python 写一个快速排序"}],
)
print(r1.choices[0].message.content)

# 智谱 GLM(ChatGLM 背后的公司):同样兼容 OpenAI 协议
zhipu = OpenAI(
    api_key=os.getenv("ZHIPU_API_KEY"),
    base_url="https://open.bigmodel.cn/api/paas/v4",
)
r2 = zhipu.chat.completions.create(
    model="glm-4",
    messages=[{"role": "user", "content": "用一句话解释什么是大模型"}],
)
print(r2.choices[0].message.content)
进一步,把"换三个值"抽成一个统一封装,所有 OpenAI 兼容模型共享同一段调用逻辑:
from openai import OpenAI
import os

# 所有 OpenAI 兼容模型,统一成「换三个值」的调用
def chat(cfg: dict, prompt: str) -> str:
    client = OpenAI(
        api_key=os.getenv(cfg["key"]),
        base_url=cfg["base_url"],
    )
    resp = client.chat.completions.create(
        model=cfg["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# 各家只需填这一张表(model 以官方最新名称为准)
MODELS = {
    "通义千问":  {"base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1", "key": "DASHSCOPE_API_KEY", "model": "qwen-plus"},
    "DeepSeek": {"base_url": "https://api.deepseek.com/v1",                       "key": "DEEPSEEK_API_KEY",   "model": "deepseek-chat"},
    "智谱 GLM":  {"base_url": "https://open.bigmodel.cn/api/paas/v4",             "key": "ZHIPU_API_KEY",      "model": "glm-4"},
    "豆包":     {"base_url": "https://ark.cn-beijing.volces.com/api/v3",         "key": "ARK_API_KEY",        "model": "<你的推理接入点ID>"},
    "腾讯混元":  {"base_url": "https://api.hunyuan.cloud.tencent.com/v1",         "key": "HUNYUAN_API_KEY",    "model": "hunyuan-turbo"},
    "Kimi":     {"base_url": "https://api.moonshot.cn/v1",                        "key": "MOONSHOT_API_KEY",   "model": "kimi-k3"},
    "百川":     {"base_url": "https://api.baichuan-ai.com/v1",                    "key": "BAICHUAN_API_KEY",   "model": "Baichuan4"},
}

# 换个 key 就能切模型,业务逻辑一行不动
print(chat(MODELS["Kimi"], "用一句话解释什么是大模型"))
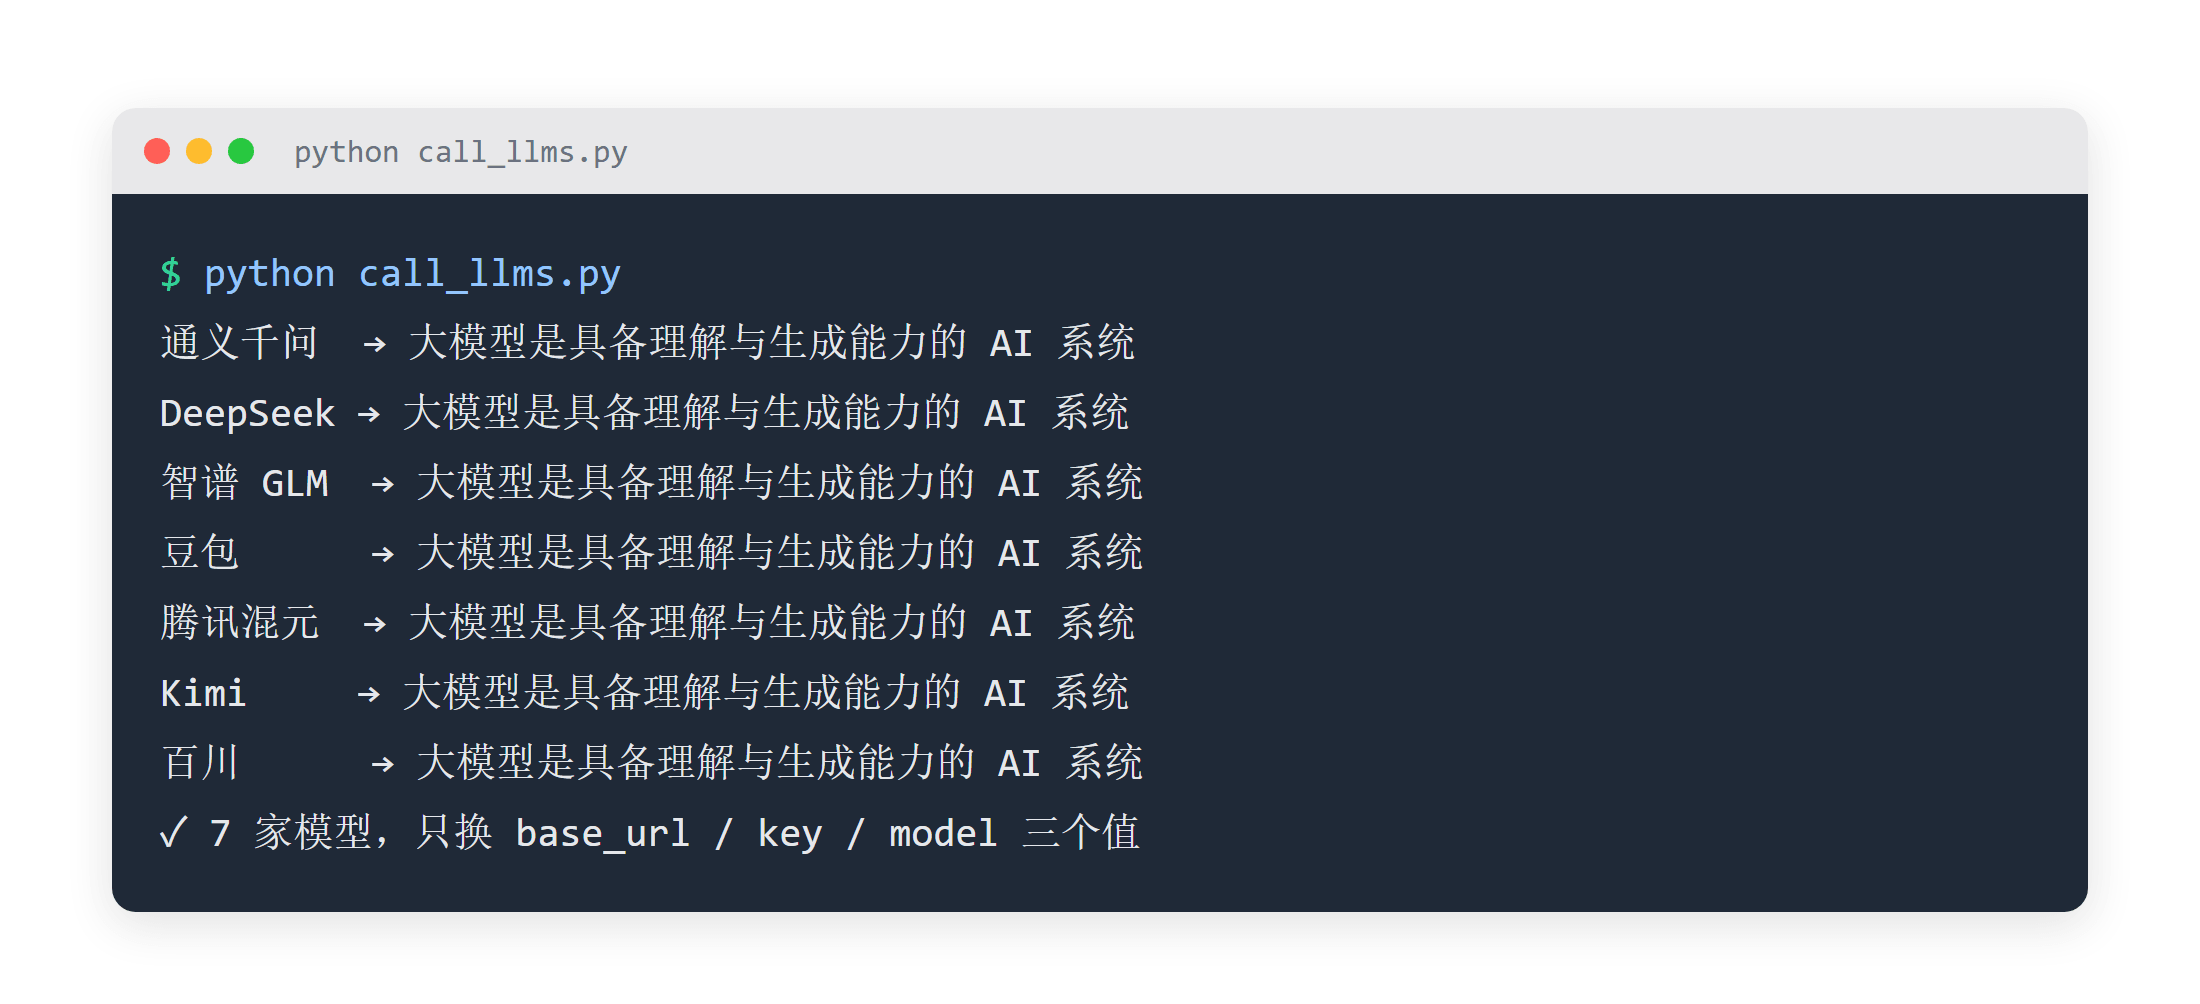
注意豆包(火山方舟)的 model 填的是"推理接入点 ID",而不是模型名本身,创建接入点时再绑定具体版本;混元、Kimi、百川的 model 名会随版本迭代,正式接入前以各自控制台的"模型列表"为准。需要强调:本文所有示例均为最小可运行骨架,正式接入前请确认你账号的可用模型列表与配额。
五、横向对比与新手避坑
把前面提到的主流模型摆在一起,选择思路就清晰了:
| 模型 | 厂商 | 接入方式 | 上下文 / 特点 | 更适合的场景 | 注意点 |
|---|---|---|---|---|---|
| 通义千问 Qwen | 阿里 | 开源 + API | 多语言、档位多 | 通用对话、开源部署 | 模型档位多,按价选 |
| 文心一言 ERNIE | 百度 | API(千帆) | 中文理解强 | 中文理解、百度生态打通 | 走千帆 SDK,需 Access Token |
| 智谱 GLM | 智谱 AI | 开源 + API | 长文本、GLM 生态 | 学术、长文本 | 兼容 OpenAI 协议 |
| DeepSeek | DeepSeek | 开源 + API | 代码、推理强 | 代码、推理、性价比 | 推理强,中文亦稳 |
| 豆包 Doubao | 字节(火山方舟) | API(兼容) | 性价比高、家族全 | 对应生态内的产品集成 | model 填接入点 ID,非模型名 |
| 腾讯混元 Hunyuan | 腾讯 | API(兼容) | 腾讯生态、混元生文 | 腾讯云生态集成 | 功能逐步迁 TokenHub,认准官方端点 |
| Kimi | 月之暗面 | API(兼容) | 长上下文(最高 1M token) | 长文档、知识工作 | 有思考/非思考模式,temperature 范围不同 |
| 百川 Baichuan | 百川智能 | API(兼容) | 医疗、企业场景强 | 行业应用、企业落地 | 新用户有赠送额度 |
| 零一万物 Yi | 01.AI | 开源 + API | 200K 上下文 | 通用、长上下文 | 兼容 OpenAI 协议 |
| 讯飞星火 Spark | 科大讯飞 | API(私有协议) | 语音、多模态 | 语音交互、教育 | 走 WebSocket,非 OpenAI 兼容 |
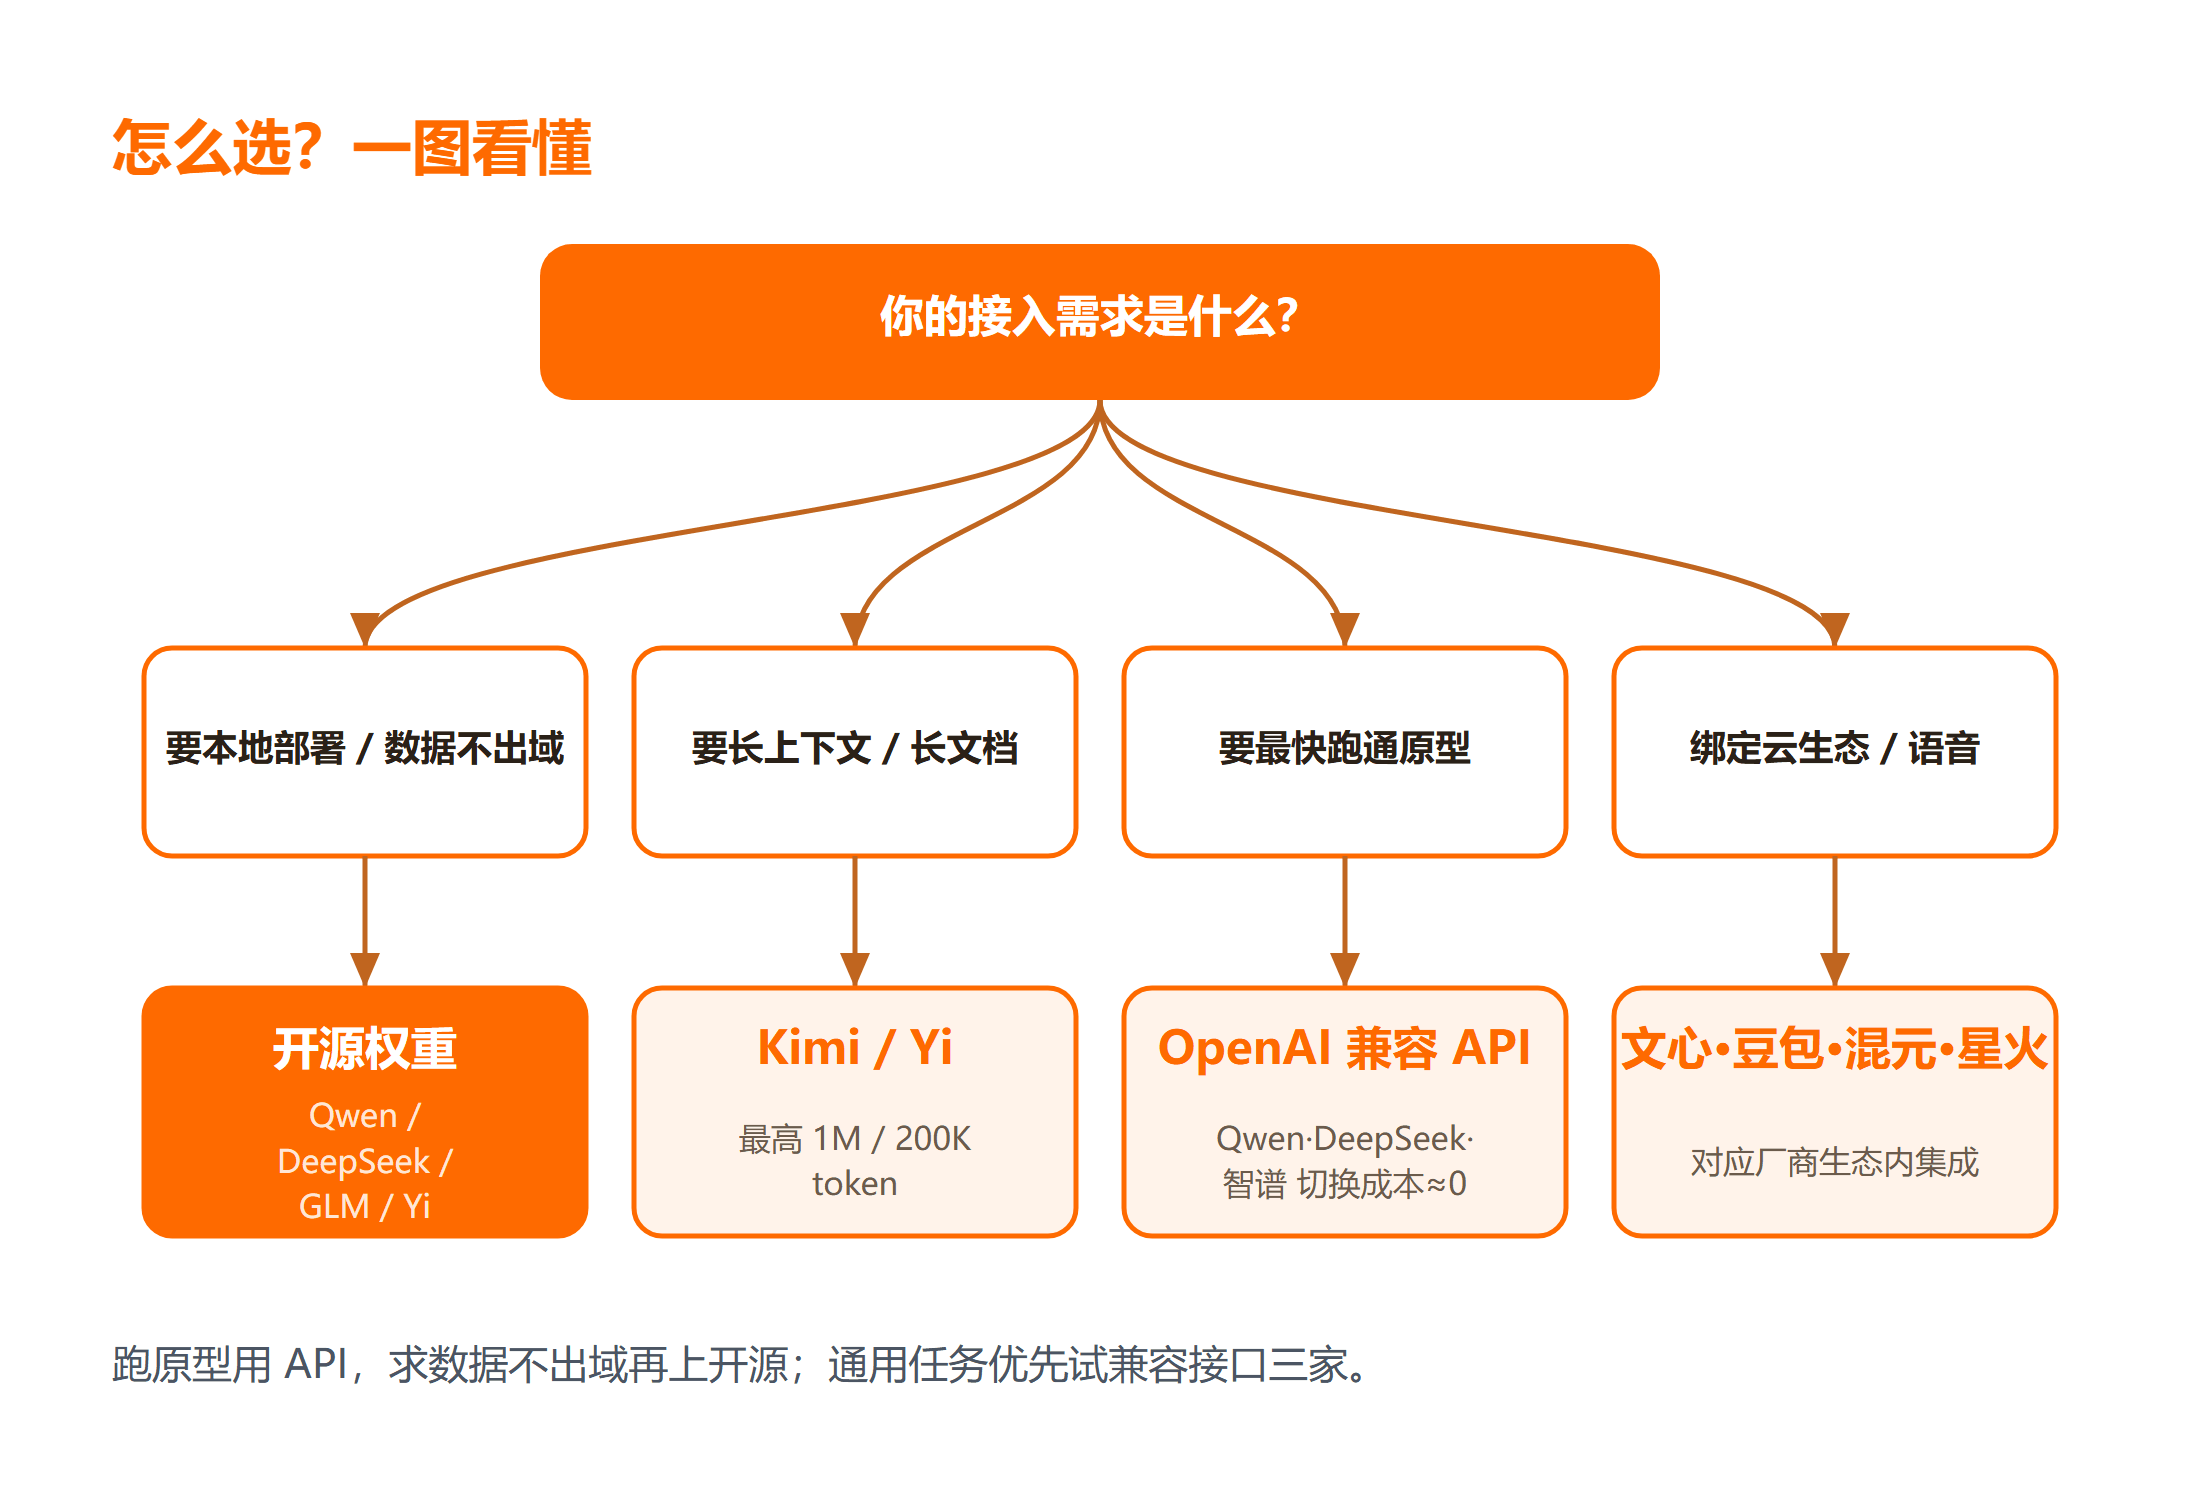
一句话建议:跑原型用 API,求数据不出域再上开源;通用任务优先试 Qwen、DeepSeek、智谱这三家兼容接口,切换成本几乎为零。
怎么选?一图看懂
坑一:把 Key 提交到 Git。 上文已经强调用环境变量。万一写错了,立刻去平台吊销旧 Key 并换新,别抱侥幸。
坑二:忽视 token 上限导致截断。 你以为把整本书塞进 prompt 它就能读,实际超过上下文长度会被默默截断,回答前半句对、后半句飘。先估文本量级,超过就做分块或摘要。token 到底是什么、怎么算,可以看这篇 Token 是什么\。
坑三:中文乱码。 Windows 下读写含中文的文件忘了指定编码,输出就成乱码。凡是碰中文文本,显式写 encoding="utf-8"。
坑四:不限流硬刷。 免费额度或共享账号下高频调用会触发限流(HTTP 429)。加一点退避重试,比盲目重试更稳,也避免被封。
总结
国内大模型对开发者已经足够友好:主流几家要么开源可部署,要么提供 OpenAI 兼容 API,同一套 Python 客户端换几个参数就能切换。要点带走:
- 先用 API 把业务链路跑通,再决定是否私有化部署;
- 通义千问、DeepSeek、智谱 GLM、豆包、混元、Kimi、百川都兼容 OpenAI 协议,切换成本极低;
- Key 走环境变量、注意 token 上限与限流,是上线前必须补齐的两件事。
下一步如果还没系统学过 Python,建议先把基础语法和接口调用的关系理顺,再回头扩充本文的示例。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想系统入门 Python,Python3 入门课程_编程实战微课 是边学边练的形式,适合打基础;
- 想建立生成式 AI 的整体认知,生成式 AI 入门教程\ 讲清了从聊天到接口的全貌;
- 已经在写代码但常和文件打交道,Python 怎么读取 JSON 文件?\ 这篇笔记把读文件和常见报错一次讲清。
常见问题
Q:国内大模型和 ChatGPT 比,开发者用起来差别大吗?
A:对写代码的人来说差别在接口而不在能力。很多国产模型提供 OpenAI 兼容端点,你把 base_url 和 Key 一换就能调,业务逻辑几乎不用改。差别主要在中文语感、价格和数据合规要求上。
Q:完全不会 Python,能调国内大模型吗?
A:可以。各平台都提供网页对话和可视化控制台,不用写代码也能用。但要把模型接进你自己的产品、做批量处理或自动化,还是得会一点 Python 或至少能看懂 HTTP 请求。
Q:开源模型是不是一定比 API 便宜?
A:不一定。开源省的是调用费,但要自己买显卡、运维推理服务,小流量时反而更贵。只有调用量大、对数据不出域有硬要求时,私有化部署才划算。
Q:同一个 prompt,换个模型结果差很多正常吗?
A:正常。不同模型训练数据、对齐方式和系统提示不同,对同一句话的理解会有偏差。上线前用你的真实样本在 2 到 3 家模型上各跑一遍,挑最稳的那家固化下来。



