 免费 AI IDE

CUDA Rust 已经能用 Rust 编写并编译 GPU kernel,但截至 2026 年 9 月仍处早期阶段,不适合直接替换成熟的 CUDA C++ 或 CUDA Python 生产链路。普通开发者更合理的动作是先判断硬件、工具链和学习目标,再决定体验哪条路线。
“原生”在这里不是给 CUDA 套一层 Rust 调用包装,而是 kernel 本身用 Rust 编写并编译到 PTX。本文依据 NVIDIA 9 月 8 日的官方说明,拆开 cuda-oxide 与 cutile-rs 两条路线,给出一份 CUDA Rust 学习成本清单。没有 NVIDIA GPU 或只想学习通用 Rust 的读者,也能据此判断是否值得投入。
一、先看结论:现在要不要学 CUDA Rust
| 你的情况 | 建议 | 原因 |
|---|---|---|
| 有 NVIDIA GPU,想体验 Rust 写 kernel | 可以试,优先 cutile-rs | Tile 抽象更高,stable Rust 门槛更低 |
| 必须精细控制线程、共享内存 | 再看 cuda-oxide | SIMT 控制力强,但 early alpha |
| 想直接替换生产 CUDA C++/Python | 暂不建议 | 两条路线都未 production-ready |
| 没有 NVIDIA GPU | 先学 Rust 和并行概念 | 无法完成真实 kernel 运行验证 |
| 只想学通用 Rust | 不必进入 CUDA Rust | 所有权、借用、生命周期先打牢 |
| 已有 SIMT 算法要迁移 | 评估 cuda-oxide | 需要固定 nightly、LLVM 和驱动组合 |
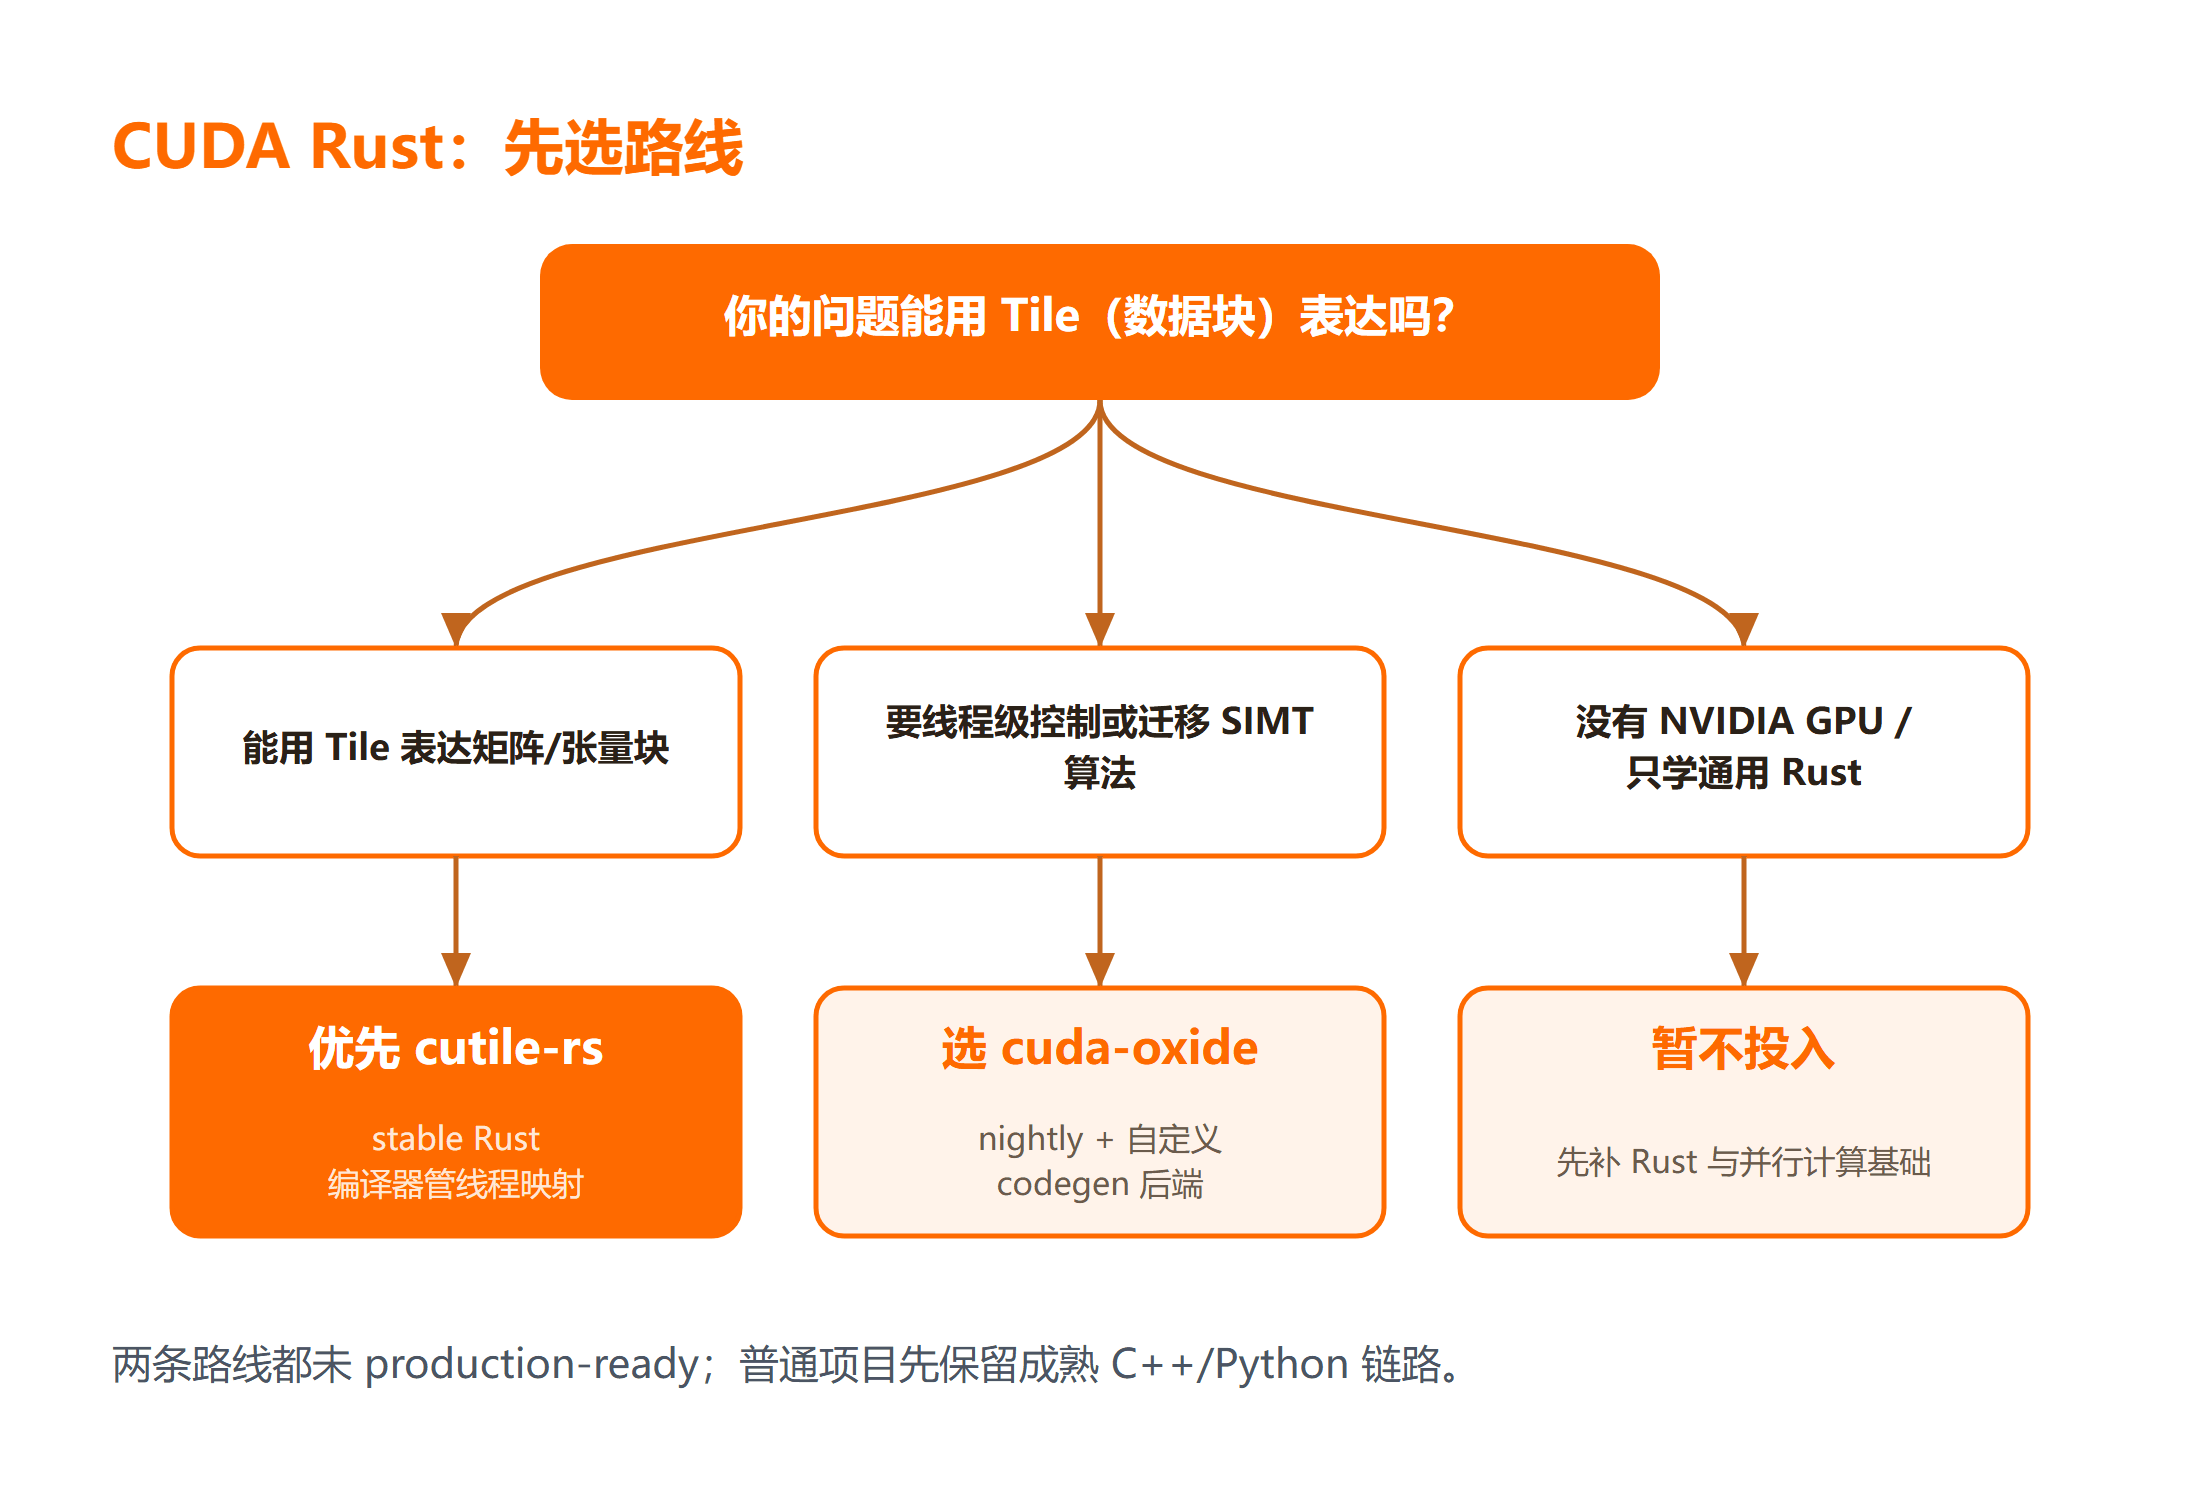
一句话:学习可以,生产迁移要等;能用 Tile 表达先看 cutile-rs,必须线程级控制再看 cuda-oxide。
二、CUDA Rust 的变化,不只是多了一组绑定
NVIDIA CUDA Rust介绍 明确区分了两条路径:
- cuda-oxide 面向 SIMT,也就是你控制线程、索引和内存;
- cutile-rs 面向 Tile,把一块数据作为计算单位,让编译器决定线程映射和部分内存布局。
cuda-oxide 会借助自定义 rustc codegen backend 把 Rust kernel 编译到 PTX,保留接近 CUDA C++ 的控制能力。cutile-rs 则通过 CUDA Tile IR 即时编译,使用稳定版 Rust,抽象层更高。
两者的共同价值是让所有权和类型系统更早参与 GPU 内存安全检查,而不只是从 Rust 调用一段别的语言代码。
| 对比项 | cuda-oxide | cutile-rs |
|---|---|---|
| 编程模型 | SIMT,描述单个线程 | Tile,描述数据块 |
| Rust 工具链 | 固定 nightly,另需 LLVM | stable Rust 1.89+ |
| CUDA 要求 | 依项目说明准备 | 官方示例写明 CUDA 13.3 |
| 控制力度 | 高,可接触线程与共享内存 | 编译器承担更多映射 |
| 当前阶段 | early alpha | 较前者成熟,但 API 仍会变化 |
| 适合人群 | 需要线程级控制的开发者 | 能用矩阵/张量块表达的问题 |
如果 Rust 的所有权、借用和生命周期还不熟,直接进入 GPU 会同时背两套认知负担。先过一遍 Rust 基础教程 再看 kernel,通常比边查语法边排 CUDA 错误更省时间。
三、两条 CUDA Rust 路线怎么选
NVIDIA 的建议是优先考虑 Tile:当问题能表达成矩阵或张量块时,编译器可以替你处理架构映射;只有必须精细控制线程、共享内存或迁移已有 SIMT 算法时,再选择 cuda-oxide。这个建议不是说 Tile 永远更快,而是先减少手动控制面。
CUDA Rust 生态成熟度的关键结论也在官方文章里:两个项目都尚未 production-ready。cutile-rs 已发布到 crates.io,并出现在一些推理项目中;cuda-oxide 仍是早期 alpha。
能运行 hello world,只能证明环境接通,不能证明 API 稳定、性能达标或长期维护成本可控。
| 判断维度 | 优先 cutile-rs | 优先 cuda-oxide |
|---|---|---|
| 问题表达 | 矩阵、张量块、规则数据并行 | 线程、共享内存、分支控制 |
| 工具链偏好 | 想用 stable Rust | 能接受固定 nightly |
| 迁移来源 | 新项目、Tile 风格算法 | 已有 CUDA C++ SIMT 算法 |
| 风险承受 | 希望 API 相对稳 | 愿意跟进早期 alpha |
| 学习目标 | 先理解 GPU 数据并行 | 深入线程级控制 |
四、普通开发者要付出的四类学习成本
第一类是硬件成本。CUDA 面向 NVIDIA GPU;只有集成显卡或其他厂商显卡时,照着命令安装也不会得到可用设备。
第二类是系统成本,驱动、CUDA Toolkit、编译工具链和 Rust 版本必须形成匹配组合。
第三类是并行思维成本。Rust 能防住部分别名和生命周期错误,却不会自动把串行算法变成高效 kernel。你仍要理解数据搬运、访存合并、分支发散、同步与 host/device 边界。
第四类是生态变化成本。nightly、编译后端与早期 API 都可能调整。教程里能跑的版本组合,几周后未必仍能无修改复现。
| 成本类别 | 具体内容 | 降低方法 |
|---|---|---|
| 硬件成本 | 需要 NVIDIA GPU | 先 nvidia-smi 确认设备 |
| 系统成本 | 驱动、CUDA、LLVM、Rust 版本匹配 | 记录完整版本组合 |
| 并行思维 | 数据搬运、访存合并、分支发散、同步 | 先补并行计算与 Rust 并发 |
| 生态变化 | nightly、后端、API 频繁调整 | 固定提交号,保存完整日志 |
若这些概念完全陌生,先用 Rust语言进阶资料 熟悉类型与并发,再进入 GPU 会更顺。
每次试验都要记录 GPU 型号、驱动、CUDA、rustc、cargo 和依赖提交号,而不是只记“安装成功”。
五、先做环境核对,再跑官方最小示例
开始前按顺序确认:
- 用
nvidia-smi确认设备、驱动和可见 GPU; - 用
nvcc --version核对 CUDA Toolkit,不把驱动显示的最高 CUDA 能力当作本机已安装版本; - 用
rustc --version与cargo --version记录 Rust 工具链; - 选择与官方说明一致的路线和提交,不从搜索结果里混搭旧命令;
- 只运行仓库自带的 hello world,再逐步替换输入规模。
# 查看 NVIDIA GPU、驱动和可见设备
nvidia-smi

# 核对本机安装的 CUDA Toolkit 版本
nvcc --version

# 记录 Rust 编译器版本
rustc --version

# 记录 Cargo 版本
cargo --version
本文环境没有 NVIDIA GPU、rustc 与 cargo,因此没有执行 CUDA Rust 示例。依据官方文档,cuda-oxide 的最小流程包含:
# 创建 cuda-oxide 项目
cargo oxide new

# 运行 cuda-oxide 项目
cargo oxide run
cutile-rs 的示例命令是:
# 运行 cutile-rs 官方 hello world 示例
cargo run -p cutile-examples --example hello_world
预期结果(未在本机执行)是示例完成编译并由 GPU 执行,不出现驱动加载、PTX 版本或设备不可见错误。实际输出会随仓库版本改变,应保存完整日志,而不是复制文章里的某一行。
| 核对项 | 命令 | 记录内容 |
|---|---|---|
| GPU 与驱动 | nvidia-smi |
型号、驱动版本、可见设备 |
| CUDA Toolkit | nvcc --version |
本机安装的 CUDA 版本 |
| Rust 编译器 | rustc --version |
nightly/stable 与具体版本 |
| Cargo | cargo --version |
包管理与构建版本 |
| 项目提交 | git rev-parse HEAD |
依赖提交号,便于复现 |
六、从“能跑”到“值得用”还要过三关
第一关是正确性。给同一组小输入分别跑 CPU 参考实现和 GPU kernel,比较每个元素,不要只看程序退出码。浮点计算还要约定容差。
第二关是性能,把编译时间、首次 JIT 和稳定运行分开计时;只测一次常会把初始化成本误当成 kernel 性能。
第三关是维护性。你要确认所需数据类型、调试工具、测试方式和跨语言互操作是否已经覆盖。若项目依赖某个尚未实现的 API,继续堆业务代码只会放大迁移成本。
CUDA Rust 学习成本的上限往往不是语法,而是你要维护多少早期工具链。
| 验证关 | 检查项 | 通过标准 |
|---|---|---|
| 正确性 | CPU/GPU 逐元素对比 | 数值一致或满足容差 |
| 性能 | 编译、首次 JIT、稳定运行分开计时 | 有基线,能区分搬运与计算瓶颈 |
| 维护性 | API 覆盖、调试工具、测试方式、互操作 | 项目依赖的功能已实现且可维护 |
| 回退方案 | 成熟 CUDA C++/Python 链路 | 出问题能切回 |
出现驱动或 PTX 不匹配时,先回到官方支持矩阵;出现 nightly 失效时,切回项目锁定工具链;示例正确但性能差时,先用 profiler 区分数据搬运与计算瓶颈。不要用关闭安全检查或随意升级全部依赖来“消灭报错”。
总结
CUDA Rust 的意义是真正把 Rust 带进 GPU kernel,而不是换一种语言调用 CUDA。cuda-oxide 给 SIMT 控制力,cutile-rs 用 Tile 降低线程映射负担;两条路都值得关注,也都还没有成熟到让普通项目无条件迁移。
如果你的目标是学习,可以固定版本、跑官方示例并比较 CPU 结果;如果目标是生产,现阶段应保留成熟链路,把 CUDA Rust 当验证分支。判断 CUDA Rust 生态成熟度时,至少同时看 API 覆盖、工具链稳定、性能证据与回退成本。
延伸学习
- 需要理解现有 kernel 写法时,可对照 C++基础教程;
- 想用较高层方式先接触 GPU 计算,可先补 Python3基础教程;
- 想了解 Rust 的近期趋势,再看 Rust进入榜单前十的解读,但技术选择仍以项目验证为准。
常见问题
Q:CUDA Rust 已经能用于生产了吗?
A:官方结论是否定的。两条路线都处早期阶段,cuda-oxide 更明确是 early alpha。生产试点至少要有固定工具链、正确性对照、性能基线和可回退实现。
Q:没有 NVIDIA 显卡能学习吗?
A:可以阅读 Rust 与并行编程概念,但无法完成真实 CUDA kernel 运行验证。云端 GPU 也可试验,不过仍要记录驱动和 CUDA 版本。
Q:新手选 cuda-oxide 还是 cutile-rs?
A:能用 Tile 表达的问题先看 cutile-rs;需要线程级控制或迁移 SIMT 算法再看 cuda-oxide。完全不熟 GPU 时,先补并行计算基础。
Q:Rust 安全是否等于 kernel 不会出错?
A:不等于。类型系统能提前阻止部分内存别名问题,但算法错误、越界设计、数值误差、性能退化和主机设备交互仍需测试。