
 TRAE-AI编程

结论先说:在 JavaScript 里保证数组插入时的唯一性,首选先查后插——用 Set 做去重容器,或用 includes/indexOf 判断存在再 push。如果只是"最终数组不重复",直接 Set 转回数组最省事;如果插入频繁且不在意顺序,每次插入前判断一次最直观。用错场景的典型表现是:用 indexOf 在几千条数据里反复查重,把本应是 O(n) 的插入拖成 O(n²),页面越用越卡。
典型的挫败场景是这样的:你写了个"添加标签"的功能,用户点了同一个标签两次,列表里出现了两条一样的;你加上判重,小数据没问题,数据一多点击就卡顿;再进阶一点,你想保留插入顺序又想去重,发现 Set 虽然能去重但某些旧环境行为不一致。这类问题八成不是数组不会用,而是没分清"该用哪种去重"。
本文用同一个"向数组追加不重复项"的场景,讲清三种做法的取舍,给出可运行的代码、预期结果与三个最常见的失败分支。示例基于 ECMAScript 2015 之后的标准,未在浏览器本机执行,请按你的运行环境验证。
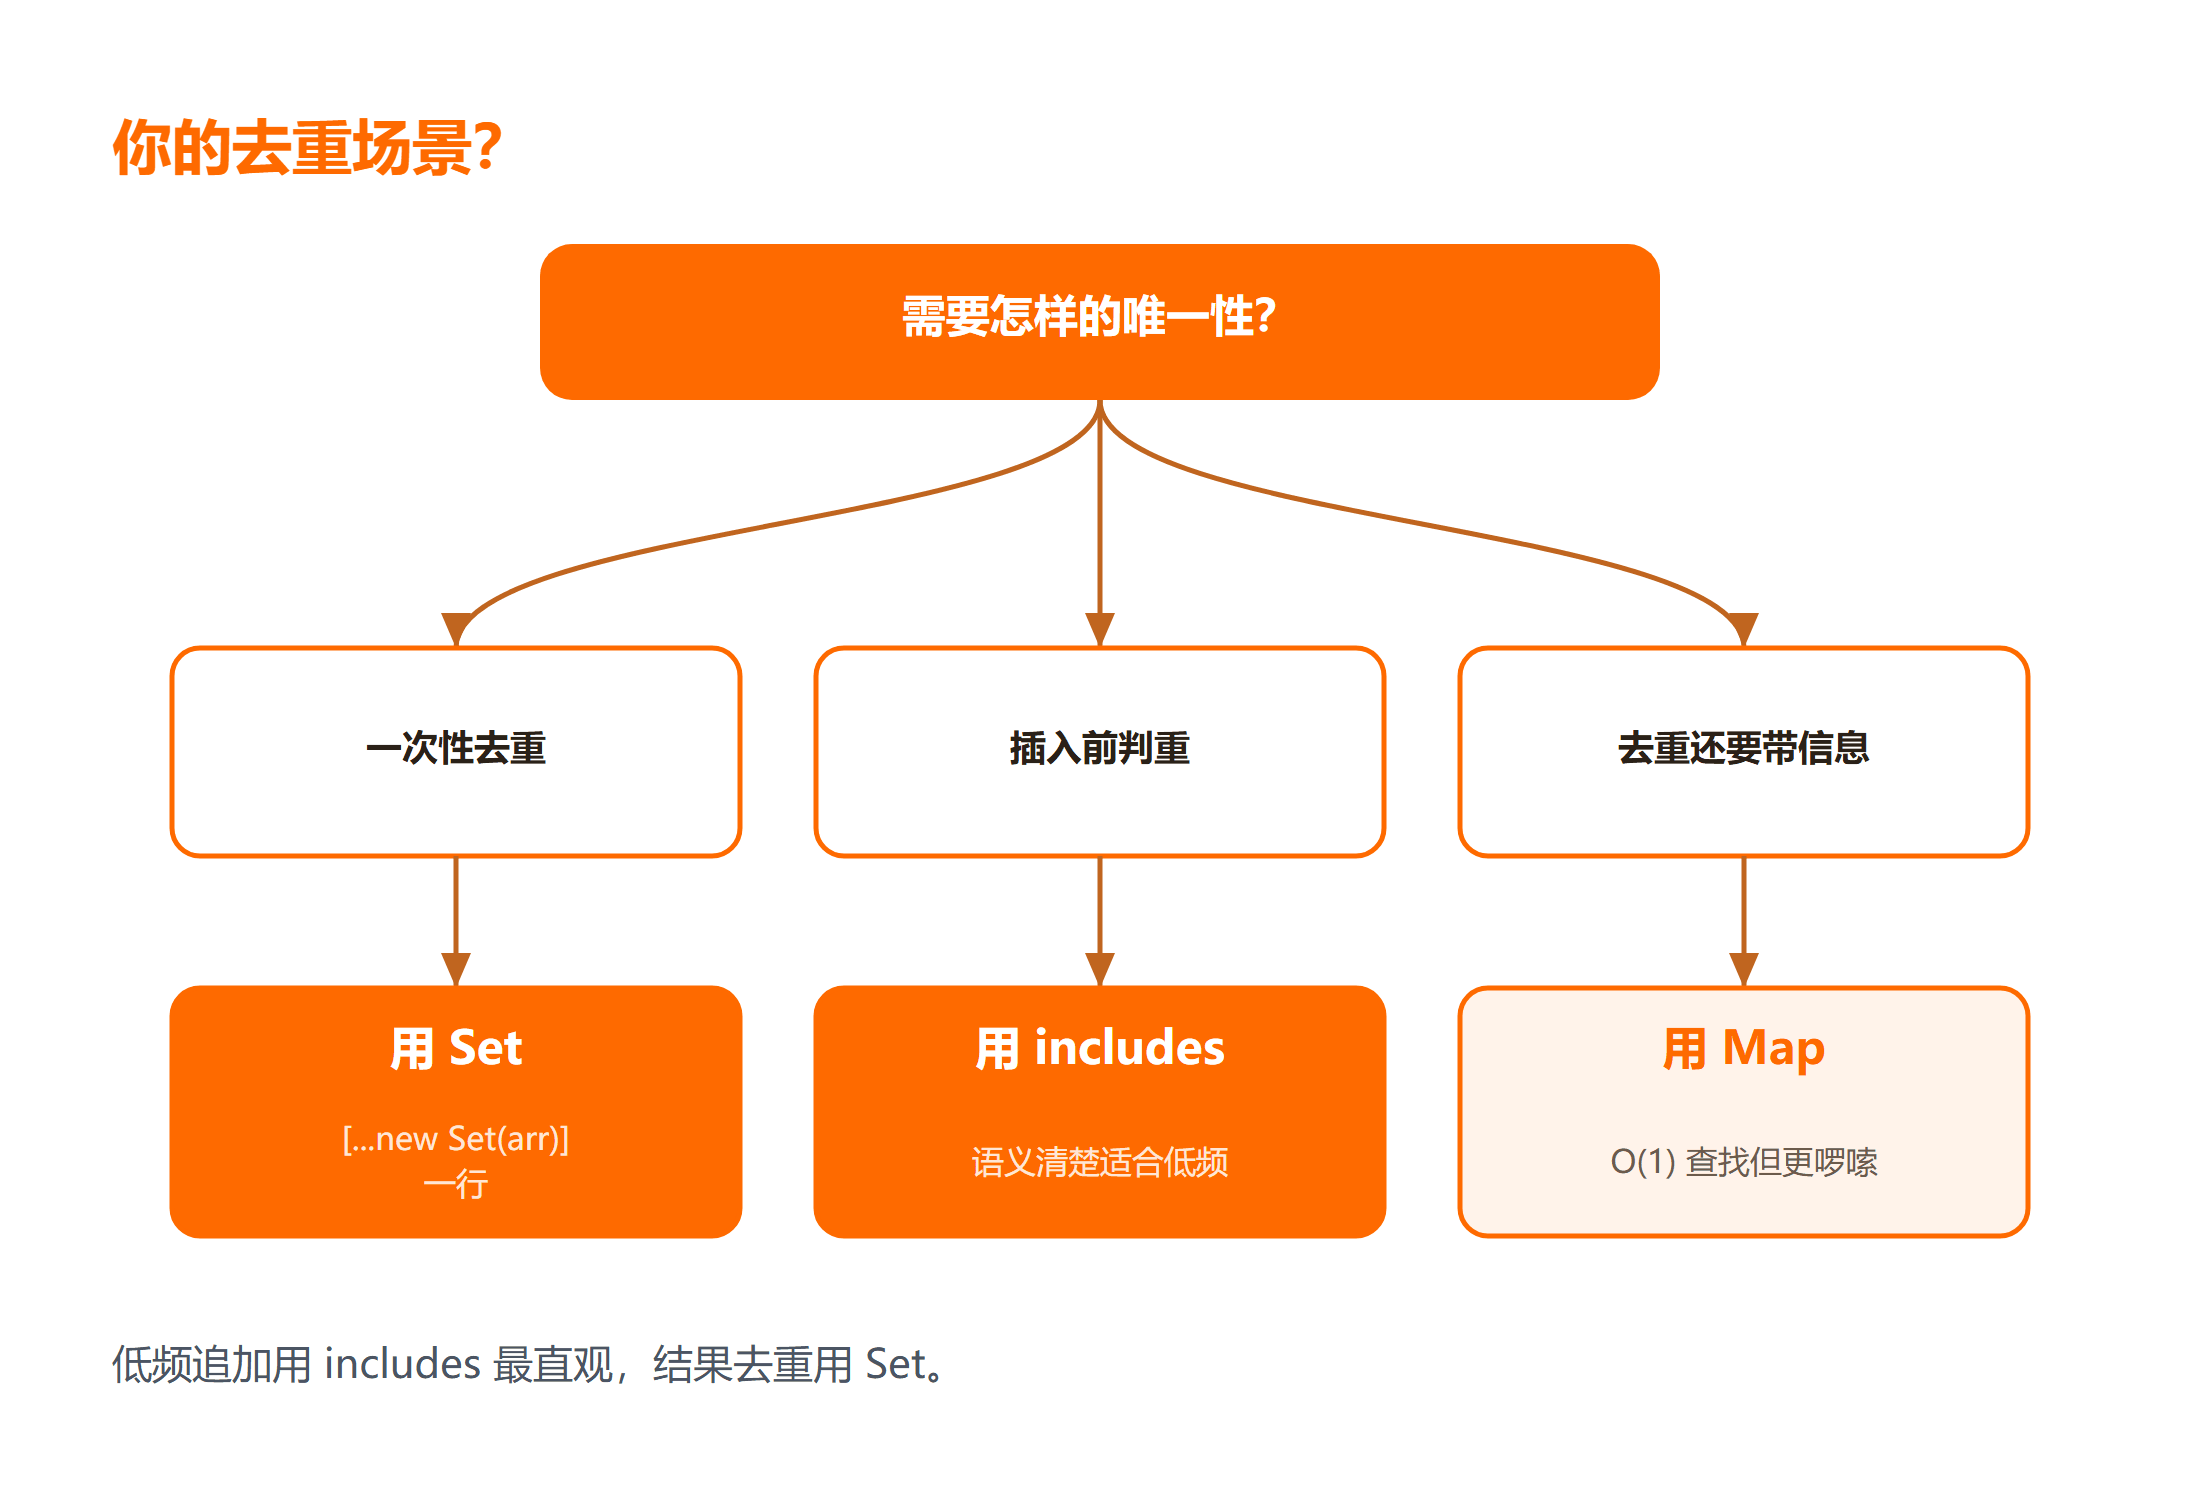
先看结论
- 一次性去重用 Set:
[...new Set(arr)]一行搞定,最稳。 - 插入前判重用 includes:语义清楚,适合低频追加。
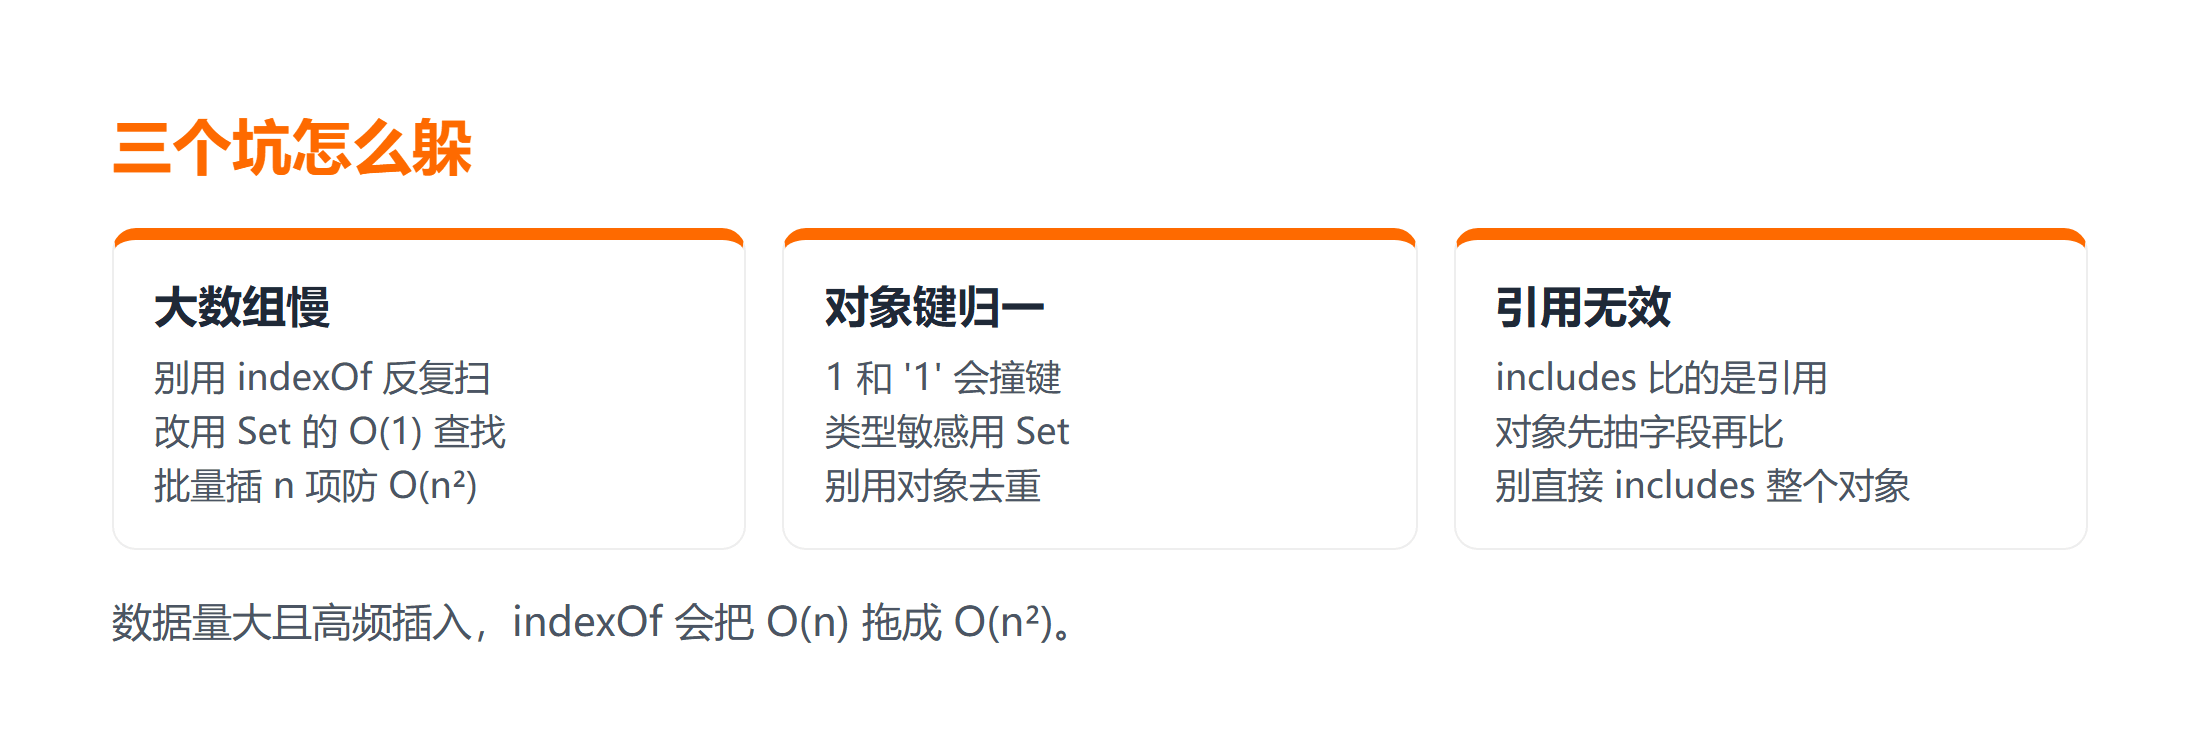
- 大数组高频插入慎用 indexOf:每次 O(n) 查找,累积成 O(n²)。
- 顺序敏感别用对象去重:对象键会被统一转成字符串,数字和字符串可能撞键。
- 引用类型去重要先抽可比较字段:直接
includes整个对象永远判不等。
一、最小场景与预期行为
统一约定:有一个字符串数组 tags,调用 addTag(tags, 'vue') 把 'vue' 追加进去;如果已经存在,返回原数组不变。这个场景对应着标签输入、最近搜索、已选列表这一类"不能重复添加"的交互。
let tags = ['react', 'vue'];
预期行为:addTag(tags, 'vue') 返回 ['react', 'vue'](不变),addTag(tags, 'svelte') 返回 ['react', 'vue', 'svelte']。判断的依据是"值相等",不是"引用相等"——数组里存的是原始值,用 === 比较即可。入门阶段建议先把 JavaScript 教程 里的数组与集合部分过一遍,避免把 push 和 concat 的用法搞混。
二、最稳的实现:Set 去重与 includes 判重
最省心的两种写法:
// 写法一:插入前判重(保留顺序,低频追加)
function addTag(list, item) {
  if (!list.includes(item)) list.push(item);
  return list;
}

// 写法二:一次性去重(不关心插入过程,只要结果不重复)
function unique(list) {
  return [...new Set(list)];
}
预期结果:addTag(['a', 'b'], 'a') 不变,addTag(['a', 'b'], 'c') 变 ['a', 'b', 'c'];unique([1, 1, 2]) 返回 [1, 2]。includes 内部就是 indexOf 的布尔版,可读性更好,现代环境都支持。要快速查某个方法的具体签名,可以翻 JavaScript 速查手册,把数组常用方法对照着看。
失败分支一:用 list.indexOf(item) === -1 判重本身没错,但在循环里对大数组反复调用,每次都是线性扫描。数据量上到几千时,单次批量插入会明显卡顿。处理方式是改用 Set 做查找结构,或者用一次 Set 转换替代逐条判断。
三、替代方案与取舍:filter、对象与 Map
三种做法不是互相替代,而是回答不同问题:
| 做法 | 回答的问题 | 复杂度 | 主要风险 |
|---|---|---|---|
| Set 去重 | 最终数组不重复 | O(n) | 旧环境需 polyfill |
| includes 判重 | 插入时是否已有 | O(n) | 大数组高频会慢 |
| Map 判重 | 既要去重又要带附加信息 | O(1) | 写法更啰嗦 |
选错的代价很直接:为了"插入时顺手判重"去维护一个 Map,代码复杂度白涨;反过来要边插边查附加值却用纯数组,就得反复遍历,性能塌方。如果你需要的不只是去重,而是"每个值对应一个计数或对象",Map 比反复 find 高效得多。类型层面,同一个去重逻辑在 TypeScript 里只是多了泛型标注,思路完全一致,可参考 TypeScript 教程 的集合类型部分。
四、反例、边界和常见失败:这 3 个坑最常见
坑一:用 indexOf 做大数组高频插入
在一个几千项的数组里,每次 push 前都 indexOf 扫一遍,单次插入 O(n),批量插 n 项就是 O(n²)。表现是列表项越多,添加越卡。处理方式是先把数组转成 Set,插入走 Set 的 O(1) 查找,最后再转回数组,把线性扫描从"每插一次"降到"只做一次"。
坑二:数字和字符串被对象键归一
用对象 { [item]: true } 去重时,1 和 '1' 会撞成同一个键,因为对象键都被转成字符串。处理方式是需要类型敏感时用 Set(它区分 '1' 和 1),而不是对象;如果一定要用对象,先把值序列化成带类型的字符串再当键。
坑三:includes 对引用类型永远判不等
[{}].includes({}) 是 false,因为两个空对象是不同引用。处理方式是引用类型要么用唯一 id 判重,要么先用 map 抽出可比较的字段再比,不要直接 includes 整个对象,否则永远去不掉重。
动手核对清单
- 前置:确认运行环境支持 ES2015,现代浏览器与 Node.js 12+ 都原生支持
Set与includes;老环境需要引入 polyfill。 - 操作:低频追加用
if (!list.includes(item)) list.push(item),一次性去重用[...new Set(list)],并确认返回的是新数组还是原地修改。 - 检查:打印去重前后的数组长度,确认重复项确实被合并;对引用类型,额外打印每个元素的唯一 id 字段。
- 验证:预期结果(未在本机执行)是相同值只保留首次出现的位置,顺序与首次出现顺序一致;
Set不会重排。 - 失败处理:常见失败是大数组卡顿和引用类型去重无效;前者换 Set/Map,后者先抽可比较字段再判重。
- 适用边界:
Set适合原始值与类型敏感去重;需要"去重同时附带计数或对象"时才上Map;不要为了去重把代码写得更难懂。 - 性能取舍:单次插入判重是 O(n),批量场景先把数据灌进 Set 再转回,能把整体复杂度从 O(n²) 降到 O(n),数据量越大收益越明显。
总结
在 JavaScript 里保证数组插入唯一性,低频追加用 includes 判重后 push 最直观,最终去重用 Set 一行搞定,需要附带信息才上 Map。记住三件事:大数组高频插入别用 indexOf 反复扫、类型敏感别用对象键、includes 对引用类型无效。
要点带走:
- 数据量小且顺序敏感,用
includes判重再插入最清楚; - 只关心结果不重复,
[...new Set(arr)]是首选; - 引用类型要去重,先抽可比较字段,别直接
includes整个对象; - 批量去重先转 Set 再转回,避免每插一次都全表扫描。
常见问题
Q:为什么 Set 去重后顺序变了?
A:Set 保留的是插入顺序,不会重排。[...new Set(arr)] 的结果顺序和原数组首次出现顺序一致,顺序"变"通常是因为你原本期望的是排序,而 Set 只去重不排序。
Q:includes 和 indexOf 该用哪个?
A:只关心"在不在",用 includes 语义更清楚;需要拿到下标再处理,才用 indexOf。两者查找成本一样,选可读性更好的即可。
Q:旧浏览器不支持 Set 怎么办?
A:Set 在 IE11 之外的环境都原生支持;确需兼容老环境,用 indexOf 判重或引入 polyfill,逻辑等价,只是写法更啰嗦。
Q:怎么给对象数组按某个字段去重?
A:先用 map 取出该字段构成的新数组去重,或者用一个 Map 以字段值为键、以对象为值,后者能顺便保留去重后的对象本身,避免再去原数组里找回对象。
延伸学习
- 想补齐数组与集合的基础,JavaScript 原生模块_编程实战微课;
- 关于异步场景下的计时与节流边界,JavaScript setTimeout() – 延迟 N 秒的 JS 计时器 这篇笔记从用法讲到常见失败;
- 常用方法与第三方资源可以查 Javascript 开发资源,里面有速查与练习入口。



