 TRAE-AI编程

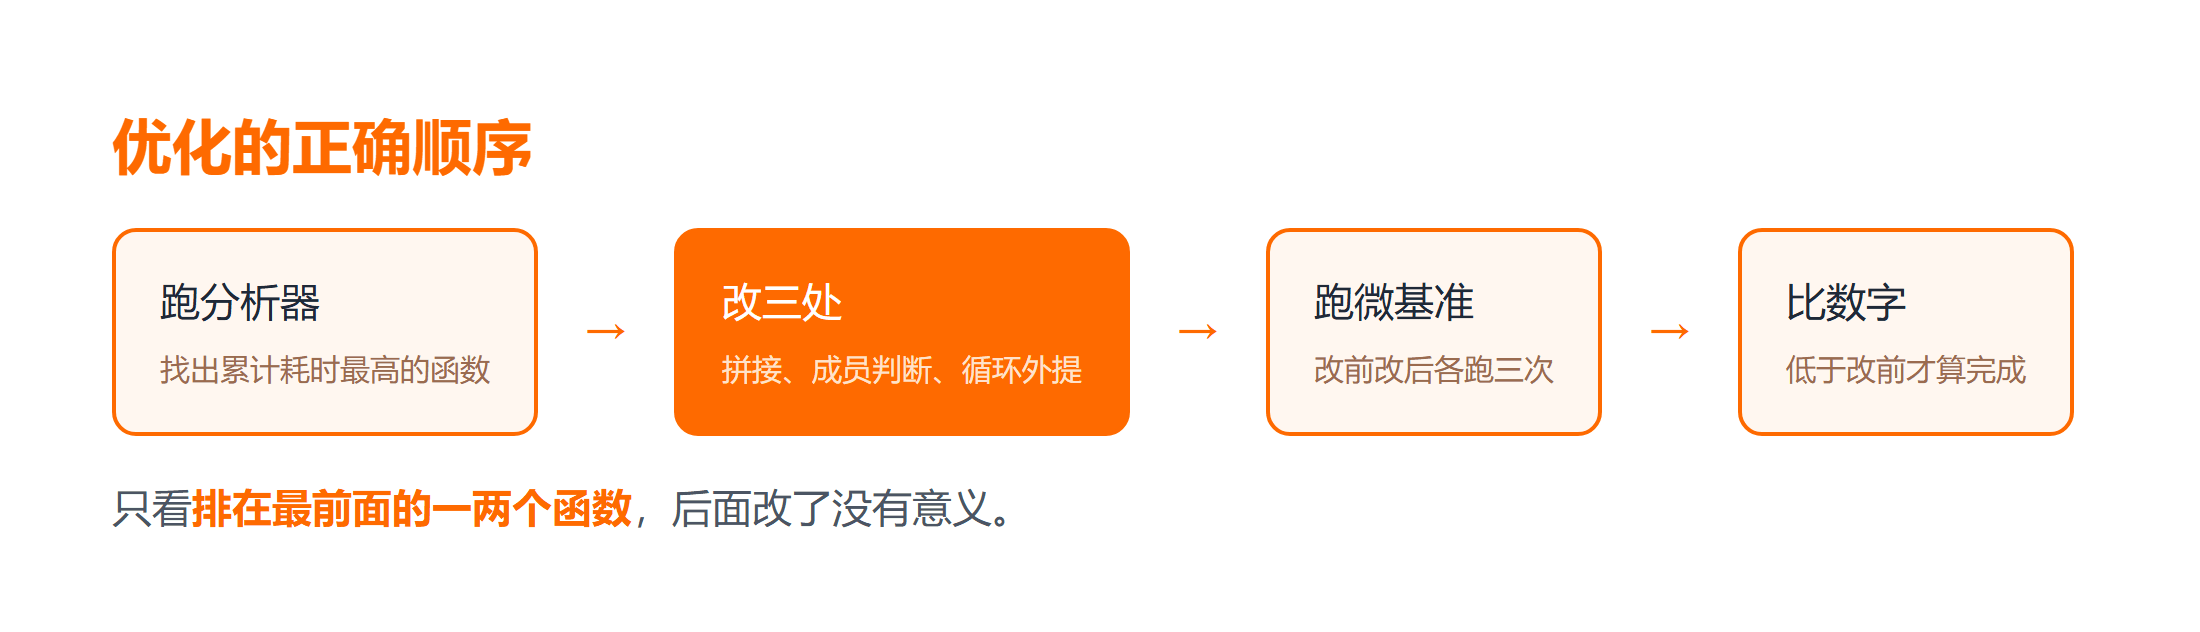
先给结论:Python 代码跑得慢,正确的顺序永远是先测量再改。用内置的分析器找出真正耗时的函数,然后集中改三处——循环里的字符串拼接、重复做的成员判断、以及可以提到循环外的重复计算。凭直觉改往往改的是根本不耗时的地方。
新手最常见的做法是看到循环就觉得慢,然后把所有循环改写成一行推导式。改完之后跑一遍,耗时几乎没变,因为瓶颈其实在别处——可能是一次网络请求,可能是一次没必要的全量拷贝。
本文基于 CPython 的通用行为,给出一套可复现的定位流程:先跑内置分析器,再用微基准确认单次开销,最后对照三处常见热点改。每一步都有可以复制的代码和预期输出。
先看结论
- 先测量:内置分析器能直接给出每个函数的累计耗时和调用次数,没有这一步的代码优化都是猜测。
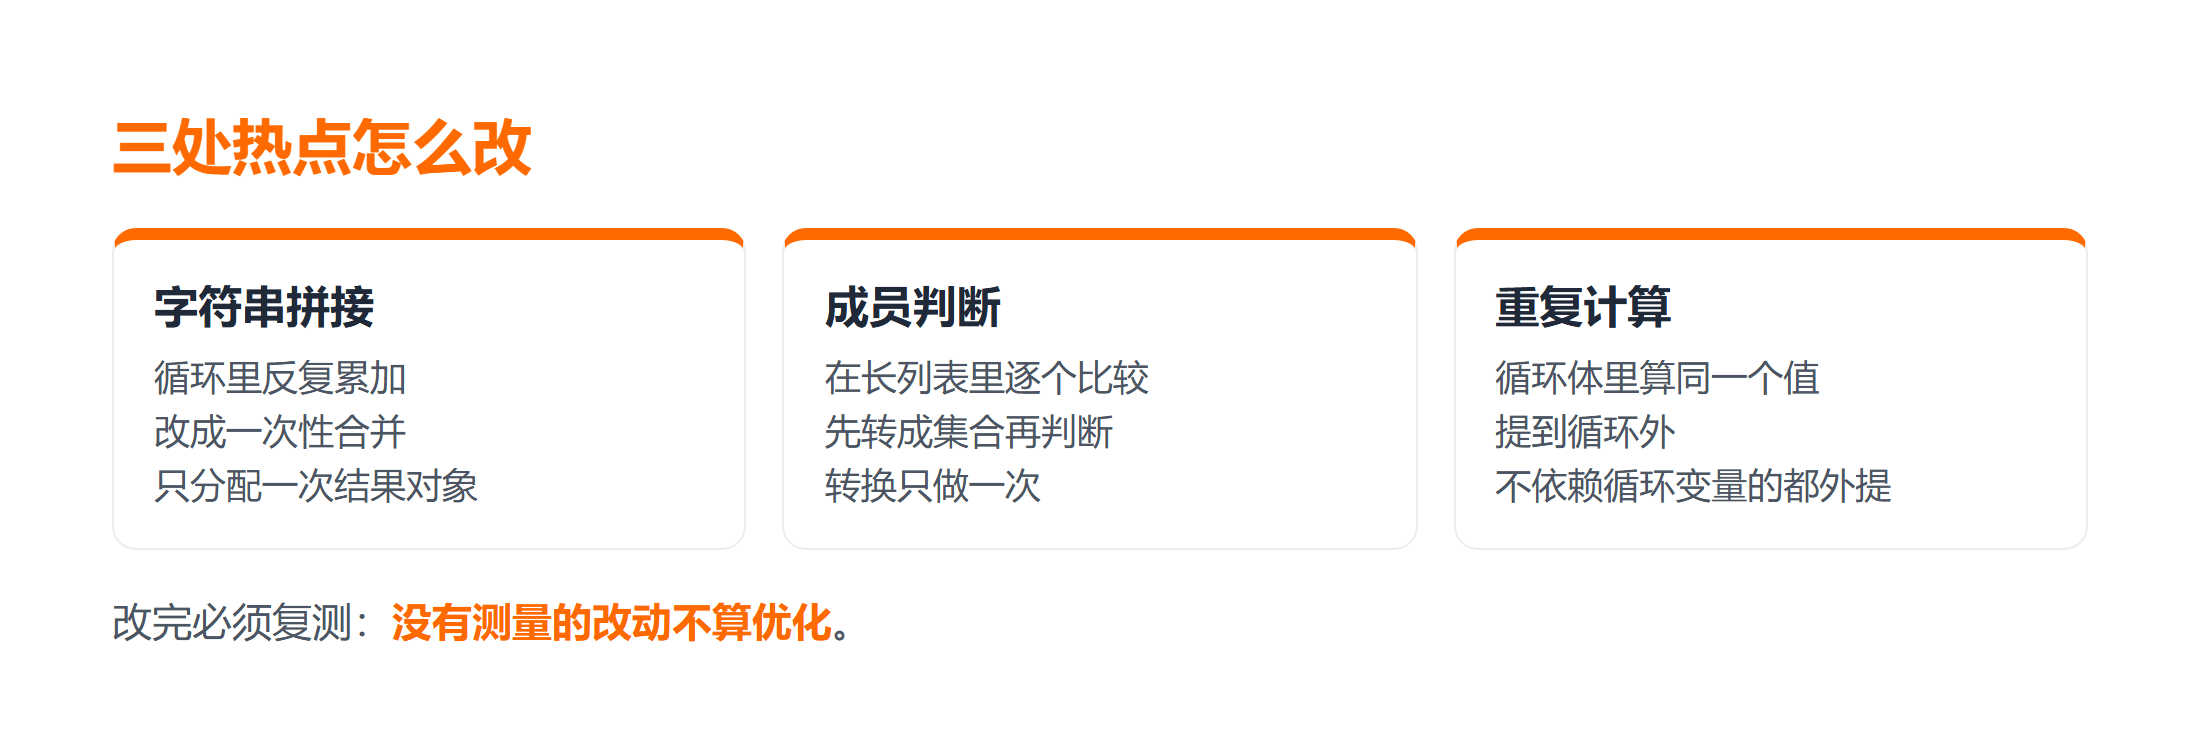
- 再改三处:字符串拼接改成一次性合并、成员判断换成集合、重复计算提到循环外。
- 后复测:改完必须再跑一次同一个基准,数字下降才算优化完成。
标准库的函数细节记不清时,翻 Python3 教程 里按模块分类的章节最快。
一、先用内置分析器找出真正的热点
把问题定死:一个脚本跑完要十几秒,但不知道慢在哪。第一步不是改代码,而是跑一次分析。cProfile 是标准库自带的性能分析器,不需要额外安装,它按函数统计调用次数与累计耗时,是做代码优化时唯一该先跑的工具。
import cProfile
import pstats

def build(n):
    s = ''
    for i in range(n):
        s = s + str(i)
    return s

def main():
    return build(200000)

cProfile.run('main()', 'prof.out')
p = pstats.Stats('prof.out')
p.sort_stats('cumulative').print_stats(5)
这段做的是对整个入口做一次性能分析,并按累计耗时排序打印前几行。预期结果(未在本机执行):输出里会列出每个函数的调用次数、自身耗时与累计耗时,排在最前面的就是热点。
判断标准很简单:只看排在最前面的那一两个函数。后面的函数即便看着不顺眼,占比也很低,改了没有意义。
二、第一处:循环里的字符串拼接
字符串是不可变对象,每次拼接都会生成一个新的对象。循环次数一多,开销就非常可观。
# 慢:每次都生成新对象
def concat_slow(items):
    s = ''
    for x in items:
        s = s + str(x)
    return s

# 快:一次性合并
def concat_fast(items):
    return ''.join(str(x) for x in items)
这段做的是对比两种拼接方式。改法是把一次次累加换成一次性合并,让解释器只分配一次结果对象。
用微基准量一下差别:
import timeit

data = list(range(10000))
t1 = timeit.timeit(lambda: concat_slow(data), number=10)
t2 = timeit.timeit(lambda: concat_fast(data), number=10)
print('累加 %.4f 秒,合并 %.4f 秒' % (t1, t2))
这段做的是用 timeit 各跑十次并打印耗时。预期结果(未在本机执行):合并方式的耗时会明显低于累加方式,且数据量越大差距越明显。
适用边界要讲清:只有循环次数多的时候这个优化才有意义。拼接三五个字符串用哪种写法都一样,不必为此牺牲可读性。
三、第二处:重复做的成员判断
代码优化的第二处热点是成员判断。在列表里做判断是逐项比较,数据量一大就变成线性扫描;换成集合之后变成哈希查找,代价基本恒定。
# 慢:每次判断都要扫一遍列表
def filter_slow(rows, blacklist):
    out = []
    for r in rows:
        if r['id'] not in blacklist:
            out.append(r)
    return out

# 快:先把名单转成集合
def filter_fast(rows, blacklist):
    banned = set(blacklist)
return [r for r in rows if r['id'] not in banned]这段做的是把黑名单先转成集合再判断。关键点是转换只做一次,如果写在循环里每次都转,反而更慢。
性能测试要讲清前提:列表很短时两者差别可以忽略,集合还有构建开销。只有当被判断的容器有几十项以上、且判断次数远多于容器长度时,这个优化才划算。
四、第三处:可以提到循环外的重复计算
代码优化的第三处最容易写完就忘:循环体里反复计算同一个值,或者反复访问同一个属性链。
# 慢:每次循环都重新算一遍
def total_slow(rows, factor):
    s = 0
    for r in rows:
        s += r['price'] * (1 + calc_rate(factor))
    return s

# 快:循环外算一次
def total_fast(rows, factor):
    rate = 1 + calc_rate(factor)
    s = 0
    for r in rows:
        s += r['price'] * rate
    return s

def calc_rate(factor):
    return 0.06 * factor
这段做的是把不随循环变量变化的计算提到循环外。这类改动不涉及算法,收益却很直接,而且不会降低可读性。
同类问题还包括:循环里反复做类型转换、反复打开同一个文件、反复构造同一个对象。判断方法是看循环体里的表达式是否依赖循环变量,不依赖的都该外提。
💡 小提示:改完不要急着全面替换。先把热点函数改掉,跑一次基准确认有效,再决定要不要把同样的写法推广到别处。
4.1 改了之后耗时没变化
说明改的不是热点。回到分析器的输出,重新确认排在最前面的函数,不要凭感觉继续改。
4.2 微基准结果与真实运行不符
timeit 默认会跑很多次取总时间,如果被测函数有副作用(比如写文件、发请求),结果会被缓存或限流干扰。修复方式是把纯计算部分单独抽出来做基准。
4.3 推导式反而更慢
把带复杂条件的循环塞进一行推导式,可读性变差但耗时未必下降。推导式的优势在简单的映射和过滤,条件复杂时老的写法更快也更清楚。
4.4 验证清单
- 检查:分析器输出里累计耗时最高的是哪个函数
- 运行:对改前改后的同一份数据各跑三次基准,取中位数
- 预期:三处优化各自都能让热点函数的耗时下降
- 失败:数字没有变化,说明改的不是热点,回到第一步重新定位
- 修复:按拼接、成员判断、循环外提三处依次改
- 验证:用改前的同一段基准代码重测,输出的数字必须低于改前
上面这些步骤做的是把"感觉慢"变成可对比的数字。预期结果(未在本机执行)是三次测量稳定且低于改前;如果波动很大,先排除磁盘与网络干扰再测。
总结
代码优化的顺序不能反:先用内置分析器定位热点,再针对字符串拼接、成员判断、循环外提这三处改,最后用同一个基准复测。
三条要点带走:
- 没有测量的改动不算优化,先跑一次分析器;
- 拼接改一次性合并、成员判断换集合且只转一次;
- 不依赖循环变量的计算一律提到循环外,改完必须复测。
下一步建议把分析器的调用封装成一个可选开关,需要时加一个参数就能跑。语法细节可以对照 Python 速查手册 再确认一遍。
常见问题
Q:Python 代码跑得慢怎么知道是哪一段慢?
A:用内置分析器跑一次入口函数,按累计耗时排序,排在最前面的就是热点。不要凭直觉猜。
Q:为什么把所有循环改成推导式还是很慢?
A:因为瓶颈不在循环写法。推导式只在简单映射和过滤时有优势,真正的耗时点要靠分析器确认。
Q:字符串拼接用哪种写法最快?
A:一次性合并最快。循环里反复累加会不断生成新对象,数据量越大差距越明显。
Q:成员判断用集合一定更快吗?
A:不一定。集合有构建开销,容器很短时反而更慢。判断次数远多于容器长度时才划算,且转换只做一次。
Q:timeit 的结果为什么和真实运行差很多?
A:通常是被测函数带副作用,比如写文件或发请求,会被缓存和限流干扰。把纯计算部分单独抽出来做基准。
延伸学习
想把性能这块做扎实,可以按这个顺序来:
- 想系统补一遍语言基础,Python 零基础到高薪就业 可以跟一遍;
- 读一篇相关笔记 列表去重的性能比较,看别人怎么量性能;
- 想随手验证一段代码,用 Python 在线运行 跑一遍最快。