
 TRAE-AI编程

用 Kimi 读长文档,定位关键段落的核心做法是:先把几十页的 PDF 或网页交给模型做「带位置引用的摘要」,再针对摘要里的要点反查原文页码,最后用追问把模糊段落逼到具体句子。不要整篇丢进去只问「讲的是什么」,那样模型很容易编造位置。下面按「先确认场景、再给方法、最后验证」的顺序讲清,让你每次读长材料都能快速抓到真正重要的几段。尤其当你面对合同、论文、研报这类几十页起步的材料时,先定方法比直接开读省下数倍时间,也更不容易被模型的总结带偏。
先看结论
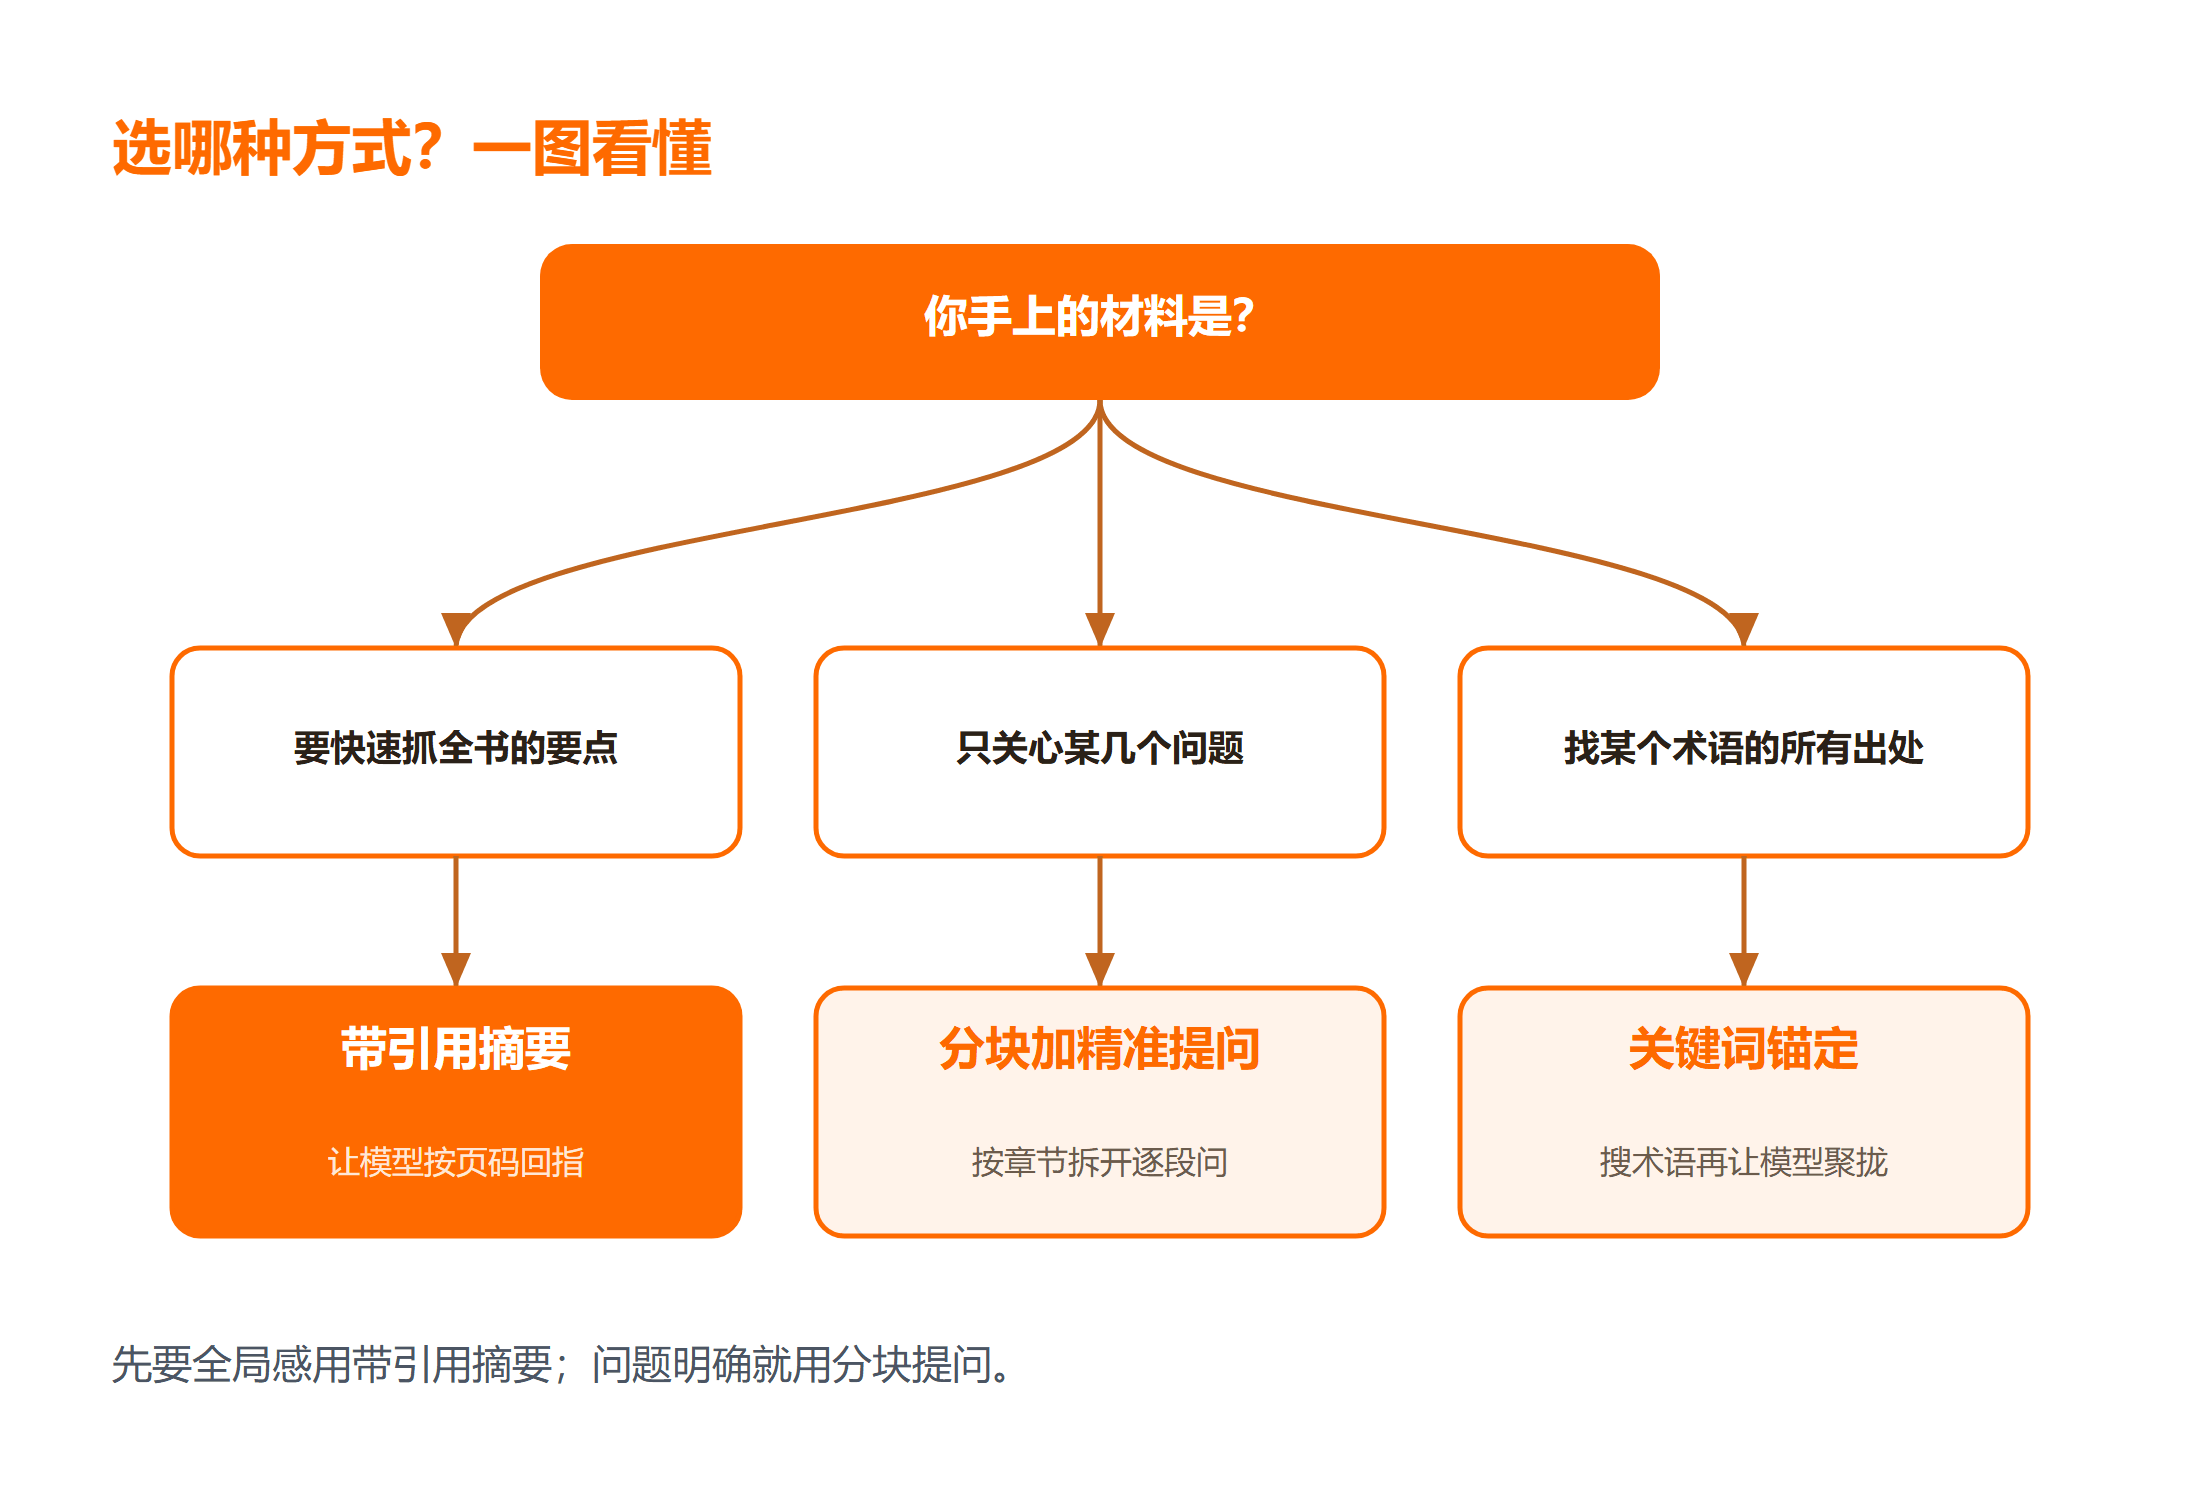
先把结论摆清楚:Kimi 这类长上下文模型最适合做的不是「理解全书」,而是「在全书里找答案」。你给它一份百页合同或论文,最稳的流程是:上传时开启引用、让它用「第几页 / 第几段」回答、拿到片段后立刻回原文核对。本文先给三种定位方式,再讲最容易翻车的几个坑。选型口诀是:要全局感用带引用摘要,问题明确用分块提问,找术语出处用关键词锚定。
一、带引用摘要:让模型自己回指页码
第一种方式最省力,也最容易被误用。把整份长材料上传后,prompt 里必须强调「每一句结论都要标注它来自第几页第几段」。Kimi 的长上下文窗口能整篇读入,因此它在内部确实能看到位置信息。关键是你要求它把位置显式写出来,而不是只给一段通顺的总结。
实际操作时,先问「这份材料的核心观点有哪些,分别在第几页」,拿到带页码的清单后,再去原文核对其中两三条。如果模型写的页码对不上,说明它在这部分发生了幻觉,应当缩小范围重新问这一章。关于把模型调用串进脚本批量处理多份文件,也可以参考 OpenClaw 中文教程,它讲清楚了如何把长材料接进自己的工具链。
二、分块加精准提问:问题明确时更稳
当你已经知道关心什么,不要再用全局摘要。把材料按章节拆开,只把相关那一章贴进去,提问要具体到「第三章里关于退款的条款怎么写的」。这种分块提问能把上下文窗口全部留给真正相关的段落,模型给出的位置也准得多。
如果你打算用代码批量切分文档,Python3 教程 里的文件读写和字符串处理基础就够用了。切完之后逐块喂给模型,每块只问一个明确问题,最后把各块的答案按页码拼回原文结构。相比整篇一次问,分块方式在超过模型稳定窗口时不会丢上下文,是处理几百页材料的稳妥路线,也更符合 AI 阅读的本意:让人聚焦、让模型只负责定位关键段落。
三、关键词锚定:专门找某个术语的所有出处
第三种方式适合「我想知道这份材料里所有提到某某概念的地方」。你先让模型列出该术语出现过的页码,再逐页确认。比起前两种,关键词锚定更像是「检索增强」而不是「通读理解」。DeepSeek 中文教程 里的检索式提问技巧同样适用:把术语用引号包住、要求只返回位置,能显著降低模型跑题的概率。
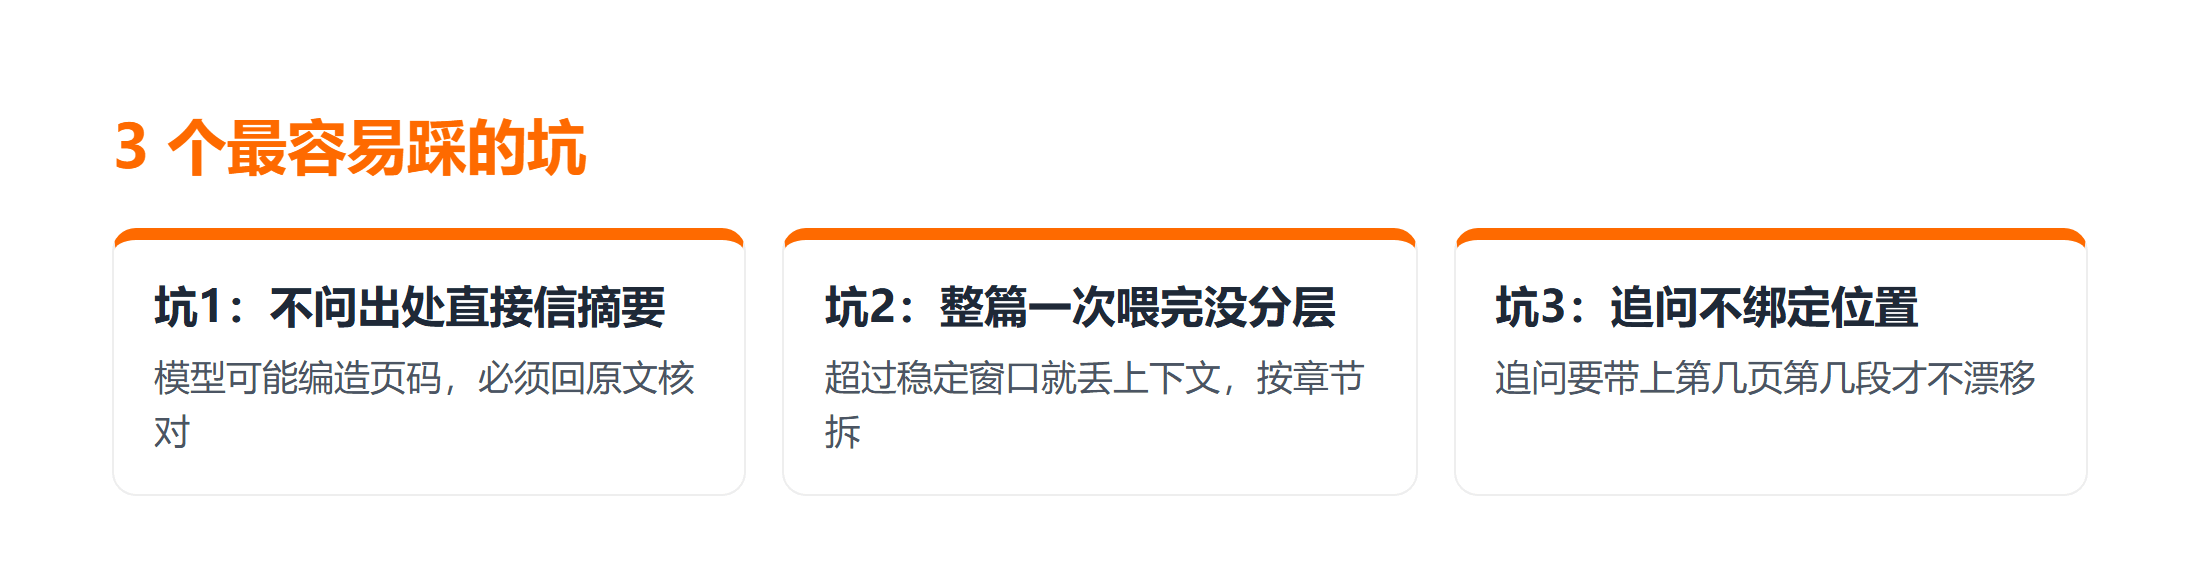
使用关键词锚定时有个常见的失败点:术语在文档里出现次数太多,模型会挑第一个返回,而你真正要的是某一段特定上下文。解决办法是给术语加限定范围,比如「第三章里关于退款的条款」而不是只问「退款」;当模型返回的位置相互矛盾时,优先以原文句子片段回查,而不是相信它给的页码,因为页码往往只是模型的内部估计,并不绝对可靠。
做 AI 阅读类任务时,也可以把 AI 编程技能教程 里的提示词结构借过来:先定义输出格式(页码 + 原文片段 + 一句话解释),再让模型填空,比开放式提问更容易拿到可核对的结果。多试几次你会发现,关键段落的定位准确率几乎完全取决于你有没有把「输出必须带位置」写进 prompt,而不是模型本身。
实操检查清单
- 前置:先确认你的文档格式与长度,并准备好可上传的测试文档。
- 操作:按本文方法用 Kimi 定位关键段落,观察实际命中与引用。
- 检查:看返回是否指向正确段落,预期与问题语义一致。
- 失败处理:若定位不准,按「切分粒度 → 关键词 → 追问澄清」逐条修复并重新验证。
- 适用边界:该方案适用于长报告与论文通读;超长文档需先分章再提问。
总结
回到开头:用 Kimi 读长文档,关键段落的定位不是靠模型「记住全书」,而是靠你设计「带位置输出」的流程。要全局感用带引用摘要,问题明确用分块提问,找术语出处用关键词锚定。无论哪种方式,拿到模型的页码后都必须回原文核对一两条,否则幻觉会悄悄混进你的结论。把「位置可追溯」当成硬要求,长材料的阅读效率才能真正提上来。
常见问题
Q:Kimi 说在第 20 页,但原文根本没有这一页怎么办?
多半是模型发生了位置幻觉。把提问范围缩小到某一章再问一次,或者要求它引用原文的句子片段而非只给页码,靠句子内容回查比靠页码更可靠。
Q:文档超过 Kimi 的上下文窗口怎么处理?
按章节或固定字数切分后分批喂入,不要硬塞整篇。每批只问与这批相关的问题,最后再汇总各批答案。
Q:能不能完全相信模型标注的页码?
不能。页码只是模型的内部估计,必须抽样回原文核对。尤其涉及合同条款、数据结论时,以原文为准。
Q:除了 Kimi 还有哪些长上下文模型可用?
DeepSeek、通义等同样支持长文本,但接入方式与稳定性不同。定位方法通用:核心都是「要求带位置输出 + 回原文核对」。
Q:为什么不直接用全文检索工具?
检索工具能找到词,但读不懂上下文关系。Kimi 的价值是把检索到的段落组织成可理解的答案,两者可结合使用。



