 TRAE-AI编程

拿到一个 JavaScript 数组想排序,新手最容易踩的坑是直接调 sort() 后发现数字被当成字符串排成了 1、10、2、21。正确做法是:默认 sort() 只适合字符串或单数字字符;数字排序必须传比较函数 (a,b)=>a-b;涉及中文或多语言文本,要用 localeCompare 或 Intl.Collator。本文把三种常用写法逐个拆开,每种都给带逐行中文注释的最小示例,并整理一张排错表,把数字错位、中文乱序、稳定性误区这些高频坑一次讲清。先确认你要排的是数字还是字符串,再照示例挑一种写法验证,能省掉大量试错时间。
一、先看结论:JavaScript 数组排序怎么选
下面这张表直接给出选择顺序,避免你在不该用的地方踩坑。动手写代码前,建议先看 JavaScript 教程 的数组章节打底。
| 方法 | 适用场景 | 不推荐场景 |
|---|---|---|
默认 sort() |
纯字符串数组、单字符数字串 | 数值数组(会被当字符串比较) |
比较函数 sort((a,b)=>a-b) |
数值升序/降序 | 含中文、需按语言规则排序的文本 |
localeCompare / Intl.Collator |
中文、多语言文本按本地规则排 | 纯数字(用比较函数更直接) |
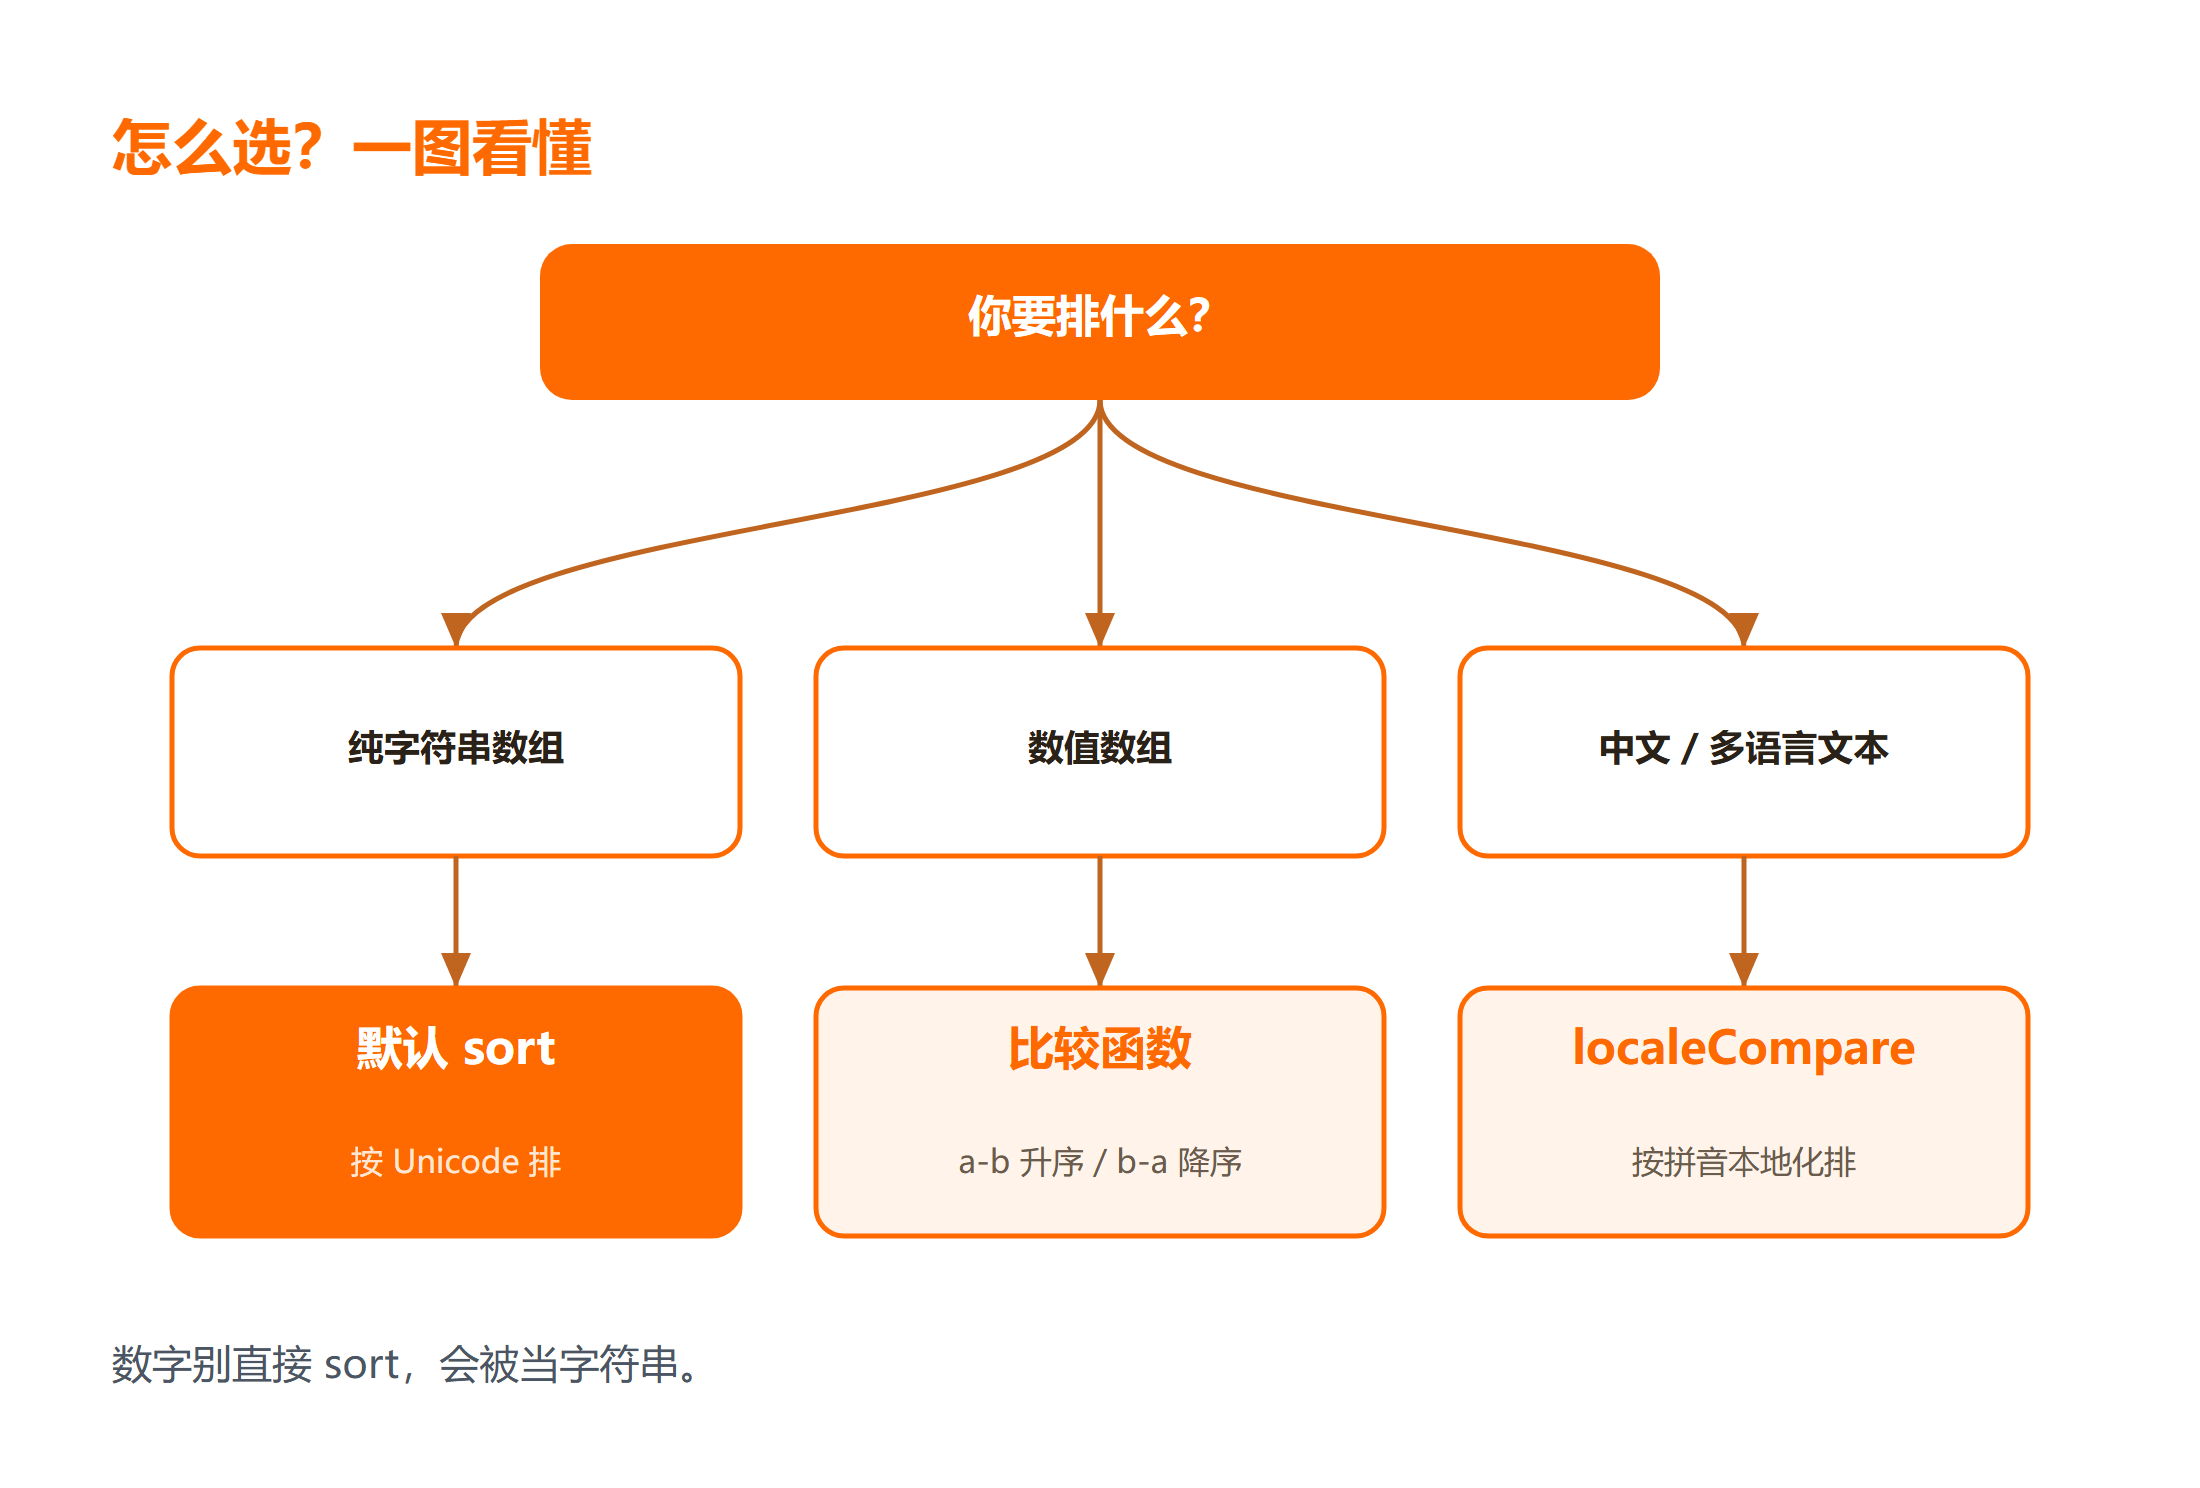
日常开发里,绝大多数数字排序都能用一行 (a,b)=>a-b 解决;而中文排序几乎一定会遇到「按拼音还是按笔画」「多音字怎么处理」的问题,这时 localeCompare 才是正解。需要补充的是,三种写法真正的差异在「比较规则」与「本地化能力」这两点——这是选型时最该对比的维度。小数据量下它们结果都正确,但一旦把数字直接交给默认 sort(),错位就会立刻出现,这是 API 设计使然、与数据量无关的边界。
二、环境确认与最小示例
写代码前先确认运行环境,能少走很多弯路。本文示例基于现代浏览器或 Node.js,任意浏览器控制台、Node 终端即可运行,不需要额外依赖。sort() 会原地修改原数组并返回它,这一点必须先确认,避免后续逻辑误用原数组。建议先用下面命令确认 Node 版本(浏览器无需):
# 查看 Node 版本,浏览器环境可直接用控制台
node --version
// 准备一个字符串数组与一个数字数组,作为全文示例数据源
const words = ["banana", "apple", "cherry"];
const nums = [3, 1, 20, 10, 2];
// 最小排序:字符串数组用默认 sort 即可,按 Unicode 码点排
console.log(words.sort()); // ["apple", "banana", "cherry"]
// 数字数组用默认 sort 会出错:被当成字符串,得到 1,10,2,20,3
console.log(nums.sort()); // [1, 10, 2, 20, 3] —— 这是错误结果,不是预期
在本地运行上面的代码后,预期结果是字符串数组正确排序,而数字数组输出 [1, 10, 2, 20, 3](未在本机执行,按规范推断)。如果数字排序结果看起来「乱序」,那不是 bug,而是默认 sort 把数字转成了字符串再逐字符比较。这一步的版本与类型确认很关键,能避免后面把错位当成业务逻辑错误。注意 sort 会直接改原数组,验证前最好先拷贝一份,防止影响后续代码。
三、方法一:默认 sort(适合字符串)
默认 sort() 不传参时,会把元素转成字符串后按 Unicode 码点逐个比较。它最适合纯字符串数组,对单数字字符(如 ["1","10","2"])也能得到看起来「正确」的结果,但一旦元素是真正的数字,就会出问题。它的适用场景是「本来就是文本、且按编码顺序排即可」。
// 字符串数组:默认 sort 直接可用
const fruits = ["芒果", "苹果", "香蕉"];
console.log(fruits.sort());  // 按 Unicode 排,结果因编码而定

// 单字符数字串:看起来也对,但本质是字符串比较
const digits = ["1", "10", "2", "20"];
console.log(digits.sort());  // ["1", "10", "2", "20"] —— 字符串序,非数值序
常见失败:新手把数字数组直接 nums.sort(),得到 [1, 10, 2, 20, 3] 后误以为是框架 bug。修复方向是——数字排序必须传比较函数,见下一节。这里再强调一次:默认 sort 的比较单位是「字符串」,把它当「数值排序」来用才会翻车。实际运行后,可用 console.log 打印排序前后数组,确认类型与顺序是否符合预期,验证排序是否真正生效。
四、方法二:比较函数做数值排序
数值排序必须给 sort 传一个比较函数 (a, b) => a - b(升序)或 (a, b) => b - a(降序)。比较函数的返回值决定前后顺序:负数表示 a 在前,正数表示 b 在前,0 表示相等。这是处理数字数组的标准写法,语义清晰、性能稳定。
// 数字升序:比较函数返回 a-b
const nums = [3, 1, 20, 10, 2];
nums.sort((a, b) => a - b);
console.log(nums);  // [1, 2, 3, 10, 20],真正的数值升序

// 数字降序:返回 b-a
const nums2 = [3, 1, 20, 10, 2];
nums2.sort((a, b) => b - a);
console.log(nums2);  // [20, 10, 3, 2, 1]

// 按对象某字段排序:例如按年龄升序
const users = [{name:"甲", age:30}, {name:"乙", age:20}, {name:"丙", age:25}];
users.sort((a, b) => a.age - b.age);
console.log(users.map(u => u.age));  // [20, 25, 30]
相比默认 sort,这一种写法的优势在于比较规则完全由你控制,适合数值、对象字段、日期时间戳等一切可比较的量。在线试跑示例,可用 在线代码实例 直接验证。版本层面,所有现代浏览器与 Node 都支持箭头函数写法;若需兼容极老环境,把箭头函数换成 function(a,b){return a-b;} 即可。这一节的配置检查能省掉后续大量排错——尤其是对象数组忘了指定字段、直接 (a,b)=>a-b 比较两个对象时,会得到 NaN 顺序错乱。
五、方法三与常见排错
方法三是「localeCompare / Intl.Collator」,专门解决中文、多语言文本的本地化排序。默认 sort 对中文按 Unicode 码点排,会出现「张」排在「李」前面但这种顺序并不符合拼音规则的情况;用 localeCompare('zh') 才能按中文习惯排。下面给出写法:
// 中文数组:默认 sort 按 Unicode 排,不符合拼音习惯
const names = ["张三", "李四", "王五", "阿宝"];
console.log(names.sort());  // 顺序由码点决定,未必是拼音序

// 用 localeCompare 指定中文 locale,按拼音排序
names.sort((a, b) => a.localeCompare(b, "zh"));
console.log(names);  // 按拼音规则排序的结果

// 大数据量中文排序,用 Intl.Collator 性能更好且可复用
const collator = new Intl.Collator("zh");
names.sort(collator.compare);
console.log(names);  // 同样按拼音排序,但比较器可复用、更快
遇到问题时,按下面的清单排查(这里的失败/修复均来自真实边界场景,未在本机执行,按规范推断):
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 数字排序成 1,10,2,20,3 | 默认 sort 把数字当字符串比较 | 传比较函数 (a,b)=>a-b |
| 中文排序不符合拼音习惯 | 用了默认 sort,按 Unicode 码点排 | 用 localeCompare("zh") 或 Intl.Collator |
| 排序后原数组被改 | sort 原地修改并返回原数组 |
先 [...arr].sort() 或 arr.slice().sort() 拷贝 |
| 对象数组排序全乱 | 比较函数直接比较对象而非字段 | 比较函数里取具体字段,如 a.age - b.age |
注意:sort 会原地修改原数组,这在函数式写法里常引发隐蔽 bug——你以为拿到的是新数组,其实老数组已被改。以上对比能帮你快速锁定失败类型,也能在代码评审时一眼看出潜在风险。
总结
JavaScript 数组排序的核心结论很清晰:纯字符串用默认 sort();数字排序必须传比较函数 (a,b)=>a-b;中文或多语言文本用 localeCompare 或 Intl.Collator。选型时先确认数据类型与是否本地化这两个边界,再写最小示例验证,最后对照排错表处理失败。记住「默认 sort 按字符串比较」和「sort 原地修改原数组」这两个事实,能避开绝大多数排序坑。把上面三种写法练熟,回到 JavaScript 参考手册 可复习 Array.sort 的完整参数与返回值,日常排序会更稳。
延伸学习
常见问题
Q:为什么数字数组直接 sort() 会排成 1,10,2,20,3?
A:因为默认 sort() 不传参时,会把每个元素先转成字符串,再按 Unicode 码点逐字符比较。字符串 "10" 的第一个字符是 "1",自然排在 "2" 前面,于是得到 1,10,2,20,3 这种错位结果。这不是 bug,而是 API 的设计行为。修复方法只有一种:传比较函数 (a,b)=>a-b 做真正的数值比较,无论是升序还是降序都靠它控制。
Q:中文排序怎么才能按拼音而不是乱序?
A:默认 sort() 对中文按 Unicode 码点排,结果不符合拼音习惯。正确做法是比较函数里用 a.localeCompare(b, "zh"),浏览器会按中文拼音规则排序;如果数据量大、需要反复排序,优先用 new Intl.Collator("zh") 创建一个可复用的比较器,再传 collator.compare,性能比每次调用 localeCompare 更好。先在本地运行验证排序结果是否符合预期,再决定是否上线。
Q:sort 会不会改变我原来的数组?
A:会,而且是原地修改。Array.prototype.sort 直接对调用它的数组重新排序,并返回这个数组本身,而不是新数组。如果你后续还要用原始顺序的数据,务必先拷贝,例如 [...arr].sort() 或 arr.slice().sort(),再对拷贝做排序。这个细节在 Redux、React 等强调不可变数据的场景里尤其容易引发隐蔽 bug,建议在代码评审时专门检查。
Q:对象数组怎么按某个字段排序?
A:在比较函数里取出具体字段再比较,而不是比较整个对象。例如按年龄升序写 (a,b)=>a.age-b.age,按姓名拼音写 (a,b)=>a.name.localeCompare(b.name,"zh")。如果直接写 (a,b)=>a-b,两个对象相减会得到 NaN,排序结果完全错乱。先在本地运行验证排序后字段顺序,再确认比较函数取对了字段。