 TRAE-AI编程

先给结论:AI 辅助调试能不能用起来,不取决于模型多强,而取决于你给的东西够不够它复现。固定成三步——先把 bug 压成一段能独立运行的最小复现,再把错误堆栈与期望行为一次喂全,最后要求它先输出复现步骤和根因假设、再给补丁。跳过任何一步,得到的通常是一段看起来合理但改不对的代码。
很多人用 AI 调试的方式是把报错信息直接粘进去问"怎么改"。这个问法的问题在于,模型看到的只有一个症状,它既不知道你的输入是什么,也不知道你期望的结果是什么,只能从最常见的几种原因里猜。猜对了算运气,猜错了你会觉得"AI 不行"。
本文用一个真实的 Python 报错场景,走完 AI 辅助调试的三步:从能跑崩的最小代码开始,到喂上下文的清单,再到验证补丁的三条硬标准。文中流程为编辑实践总结(证据类型:编辑推断),命令与工具用法以各自官方文档为准。
先看结论
- 第一步压最小复现:把无关依赖、无关业务逻辑都删掉,留下能稳定触发错误的那几行。
- 第二步喂全上下文:错误堆栈全文、触发输入、期望与实际、你已经试过的办法,缺一样都别问。
- 第三步要它先复现:先让 AI 说清"怎么触发、根因是什么",再让它给补丁,别一上来就要代码。
调试命令记不清时,翻 GDB 速查手册 里的常用指令最快。
一、最小场景与预期行为
任务定死:一段处理订单的 Python 代码在生产环境偶发报错,日志里只有一行 KeyError。目标是在本地稳定复现它,并拿到一个能解释根因的补丁。
原始代码有三百行、依赖四个内部模块、还要连数据库。直接把它丢给 AI 是不可能的:上下文放不下,放了也抓不住重点。
# 压到最小之后
def calc_total(order):
    return order["items"][0]["price"] * order["items"][0]["count"]

print(calc_total({"items": []}))
这段做的是把问题从业务代码里剥离出来:只留下一个函数、一个空列表输入。运行它会稳定抛出 IndexError,与线上的 KeyError 同源——都是没校验数据是否为空。
预期结果(未在本机执行):本地稳定报错,报错位置与线上日志指向同一行。能做到这一点,才算拿到了可以交给 AI 的材料。
二、第一步:把 bug 压成最小复现
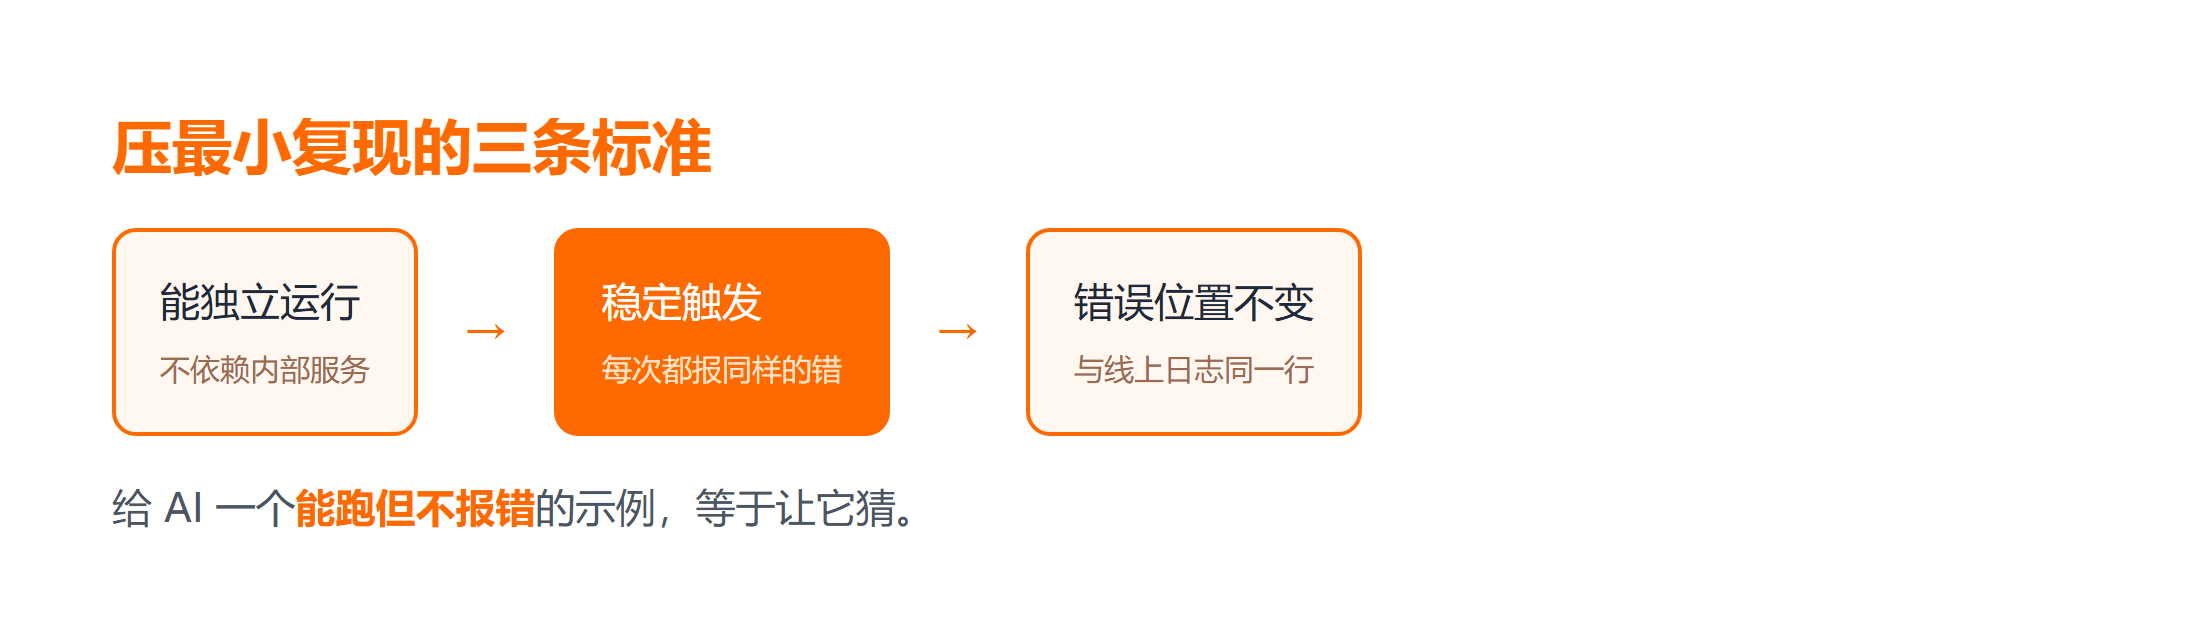
AI 辅助调试的第一步就是把 bug 压成最小复现,这不是"随便简化一下",它有明确标准:
- 能独立运行:不依赖内部服务、不依赖数据库,复制到一个空文件里就能跑。
- 稳定触发:每次运行都报同样的错,不能是偶发。偶发问题要先找到让它必现的条件(并发次数、特定数据、特定顺序)。
- 错误位置不变:报错行号与线上日志指向同一个判断,说明你没把根因简化掉。
python -c "
import order_demo
order_demo.calc_total({'items': []})
"
这条命令做的是用一个确定的输入去调用目标函数。把它连同完整输出一起交给 AI,比交给它三百行业务代码有用得多。
这一步最容易被跳过,也最影响结果。如果 AI 拿到的是"能跑但不报错"的最小示例,它只能凭描述猜,给出的补丁多半落在错误的位置。
三、第二步:把上下文一次喂全
喂上下文时,下面五样一次给全,不要挤牙膏:
- 最小复现代码:可运行的那一版,不要给片段。
- 错误堆栈全文:从 Traceback 第一行到最后一行,包括被省略的中间帧。
- 触发输入:具体的参数值,而不是"传了一个订单"。
- 期望与实际:期望得到什么,实际得到了什么。
- 已试过的办法:你说过"试过加判空没用",它才不会又建议加判空。
我的代码在 order["items"] 为空时报错,完整堆栈如下:
(粘贴 Traceback 全文)

期望:items 为空时返回 0
实际:抛出 IndexError: list index out of range
已试过:在调用方加了 if not items,但还有另一个入口没覆盖

请先告诉我怎么稳定复现,再分析根因,最后给补丁。
这段提示词做的是把症状、证据和约束一次性说清,并把回答顺序固定下来。最后那句顺序要求很关键——直接要补丁,模型会跳过分分析直接生成代码,准确率明显下降。
上下文太长时的处理办法:优先保留堆栈与出错函数本身,把调用链上的代码换成一句话描述。宁可少给调用方,也不要截断堆栈。
四、第三步:先复现再改,以及失败处理
4.1 让 AI 先输出复现与假设
拿到材料后,先要三样东西,再要代码:
- 复现步骤:用什么输入、什么命令能稳定触发。
- 根因假设:出错的直接原因,以及为什么之前没被发现。
- 补丁范围:要改哪些文件、哪些函数,会不会影响别的调用方。
请只回答以下三点,先不要写代码:
1. 这段代码在什么输入下会报错?
2. 根因是直接取了下标还是上游没校验?
3. 修在被调用方还是调用方,各有什么代价?
这段提示词做的是把分析阶段和编码阶段分开。分析对了,补丁通常也就对了;分析错了,代码写得再漂亮也没用。
4.2 三个高频失败分支
- AI 编造不存在的 API:它会给出一个看起来合理但你的版本里没有的方法。处理办法是让它注明依据来源,自己再查一次文档确认。
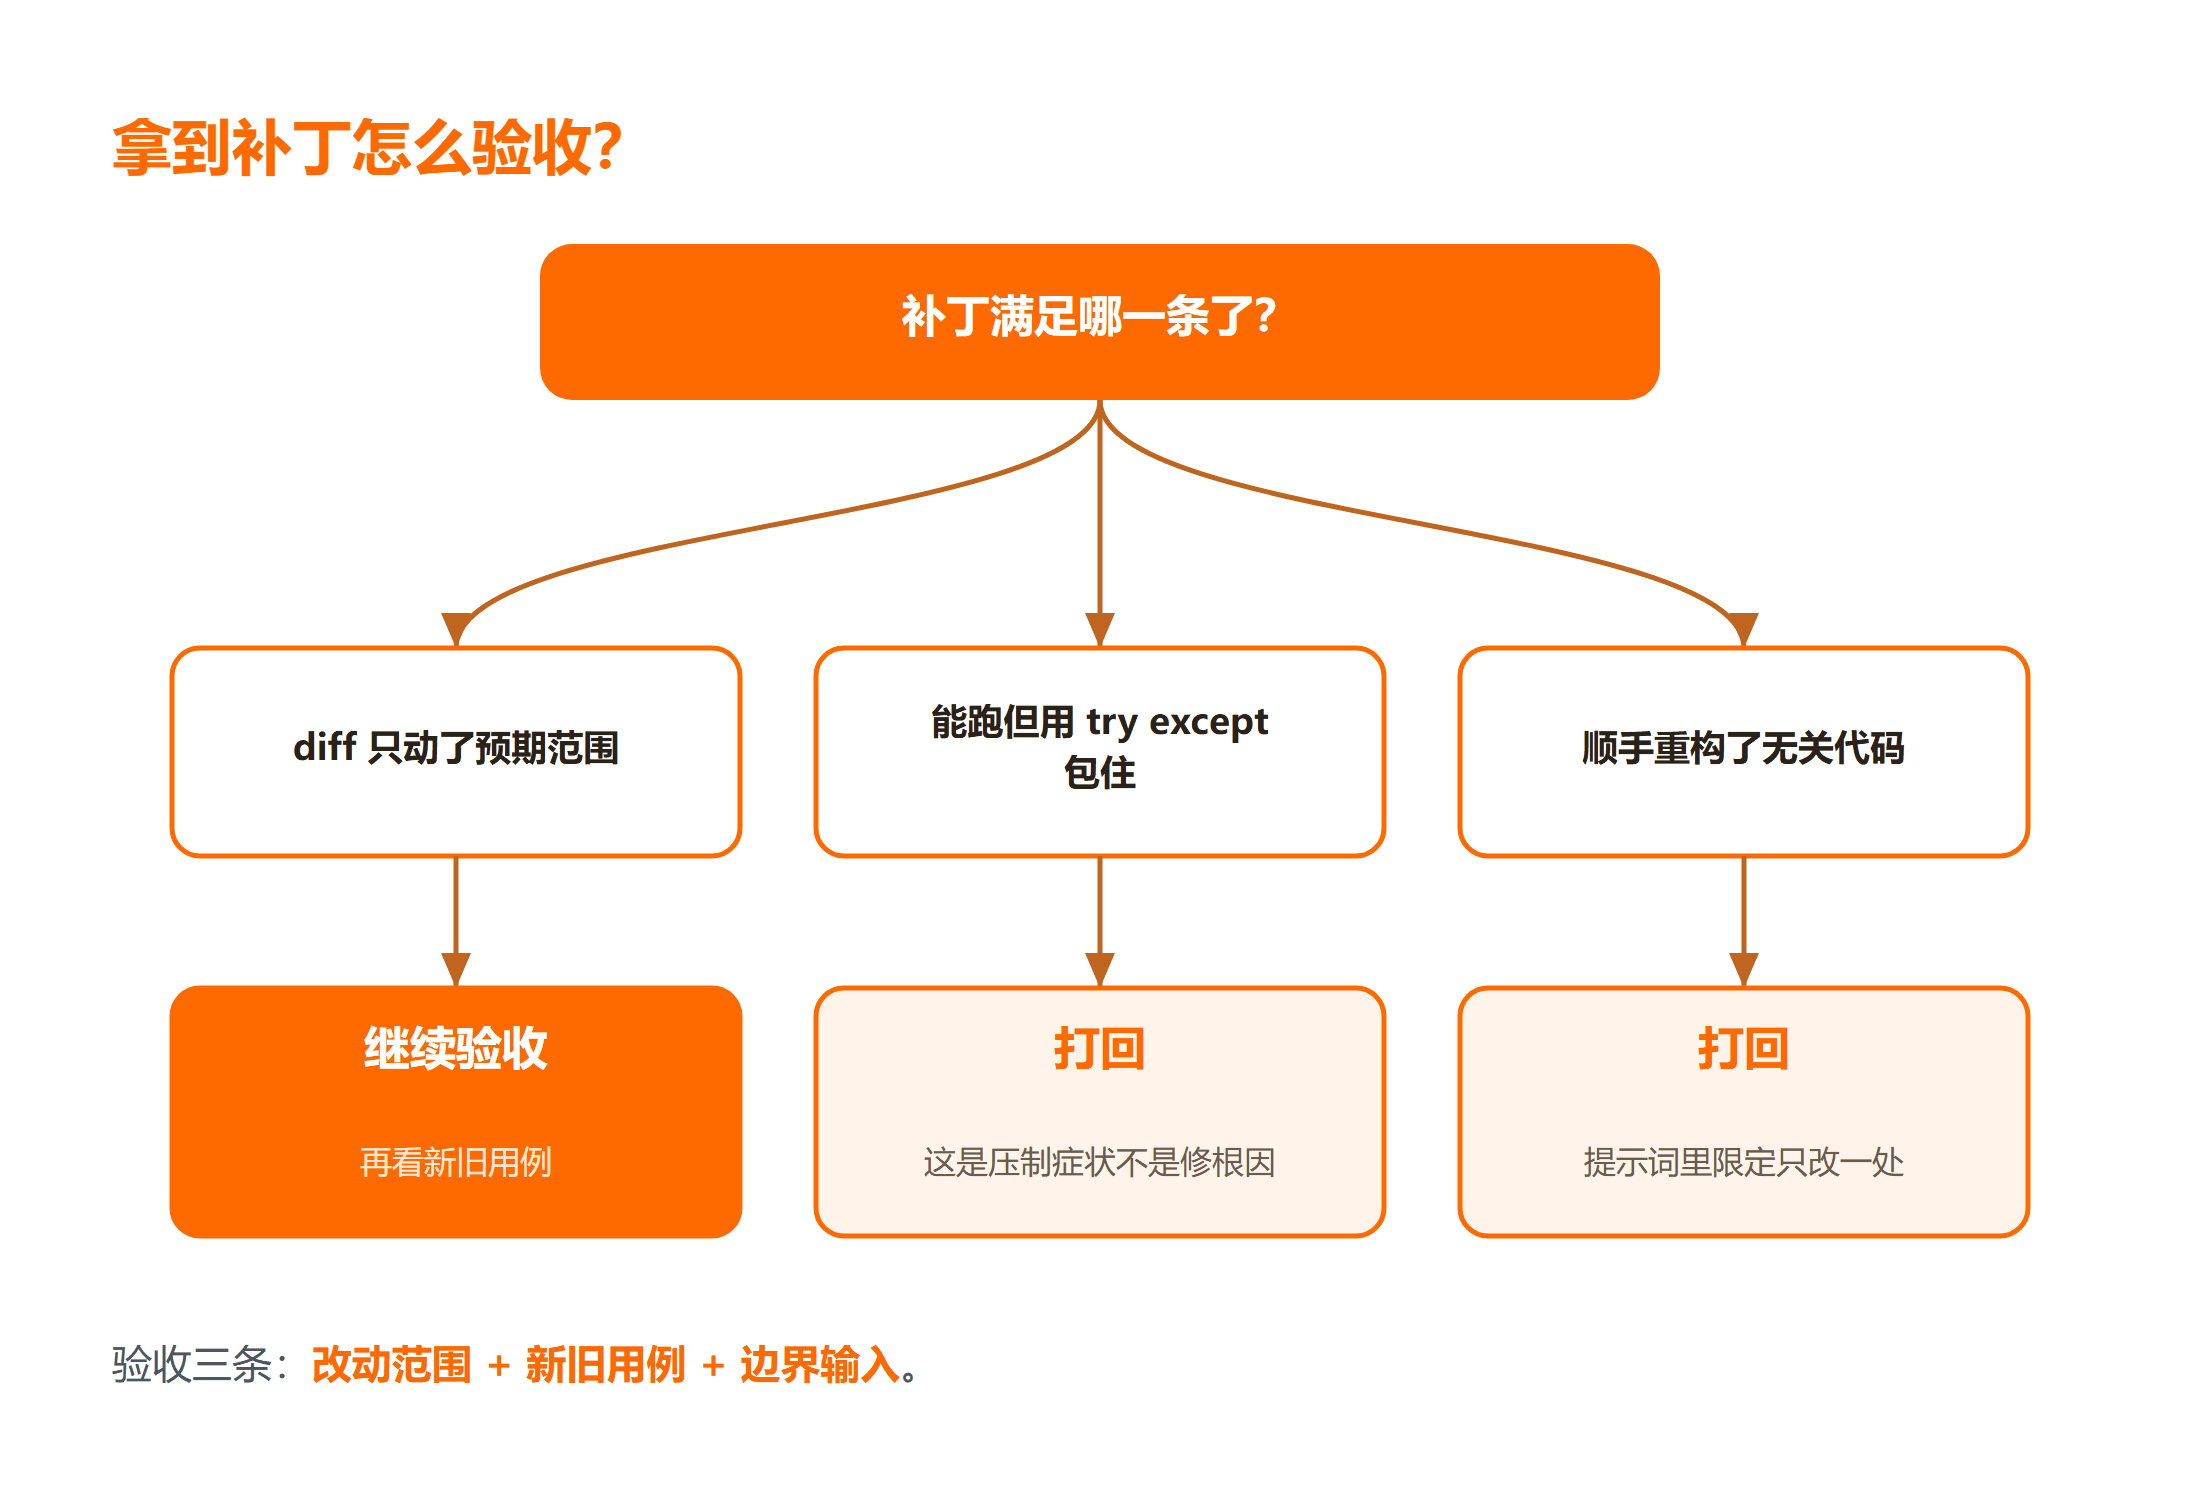
- 补丁能跑但掩盖根因:比如在出口处包一层 try except,错误不报了,数据却是错的。处理办法是要求它说明"为什么这样改是根因修复,而不是压制症状"。
- 改动范围失控:顺手重构了无关代码,diff 变得无法审阅。处理办法是在提示词里明确只改一个函数,其余一律不动。
4.3 验证清单
- 检查:补丁的 diff 是否只动了预期范围内的代码
- 运行:用最小复现的输入跑一次,再跑一遍原有用例
- 预期:最小复现不再报错,原有用例全部通过
- 失败:原有用例挂了 → 补丁改到了共用逻辑
- 修复:把补丁范围收回到出错函数内部,只加边界判断
- 验证:换一组边界输入(空、单条、超长)各跑一次
上面这些步骤做的是确认改动范围、跑通新旧用例、覆盖边界输入。预期结果(未在本机执行)是三组边界输入都得到合理结果;若空输入返回了异常值,说明补丁只压住了报错没修根因。
总结
AI 辅助调试的瓶颈在输入端,不在模型端。压出能独立运行的最小复现,把堆栈、输入、期望、已试办法一次喂全,再要求它先分析后给码,这三步能把命中率从"碰运气"提到"可控"。拿到补丁后仍要按改动范围、新旧用例、边界输入三条标准验收。
三条要点带走:
- 最小复现的三条标准:能独立跑、稳定触发、错误位置不变;
- 上下文宁可少给调用方,也不要截断错误堆栈;
- 先要分析和复现步骤,再要代码,能显著提高补丁正确率。
下一步建议把你常用的调试提示词存成模板,每次只替换堆栈与输入两处,省下的时间用来做验收。问题排查的更多做法,TRAE 问题排查 里有更系统的说明。
常见问题
Q:为什么我把报错粘给 AI,它给的答案总是改不对?
A:因为它只看到了症状,不知道输入、期望和上下文。AI 辅助调试靠的是完整证据链,补上最小复现代码、触发输入和已试过的办法,命中率会明显提升。
Q:AI 给的补丁能跑,但感觉不对怎么办?
A:让它说明"为什么这是根因修复而不是压制症状"。用 try except 包一层、或者加默认值掩盖错误,都属于压制症状。
Q:上下文太长放不下怎么处理?
A:优先保留错误堆栈全文和出错函数本体,把调用链换成一句话描述。截断堆栈会让模型完全失去定位依据。
Q:AI 用了我没装过的方法怎么办?
A:让它注明依据来源并给出版本要求,自己再查一次文档确认。遇到不存在的 API 时,把你的版本号一起告诉它。
Q:怎么防止 AI 顺手改掉一堆无关代码?
A:在提示词里明确只改一个函数,其余一律不动。拿到补丁后先看 diff 范围,超出预期就打回重来。
延伸学习
想把 AI 调试这套流程练熟,可以按这个顺序来:
- 读一篇相关笔记 程序调试入门,把调试的基本思路先补齐;
- 想系统学 AI 辅助开发,阿里Lingma+AI开发实战课程 可以跟一遍;
- 想把最小复现代码立刻跑一遍验证,可以用 在线代码实例。