
 TRAE-AI编程

刚学编程的新手,十有八九是被满屏英文报错劝退的:TypeError、Traceback、undefined reference,一个词都不认识,只能把代码删了重写。其实报错信息是给修复方法指路的地图,而 AI 排错正是把这张地图翻译成人话的最快途径。正确做法是三步:先把完整报错和代码上下文喂给 AI,再追问根因并用官方文档验证,最后落地修复并留一条防复发的检查。本文用一个真实的 Python 报错示例走完全流程,并给出 AI 答案不可信、修复不生效等高频失败的排错清单。
一、先看结论:什么报错适合交给 AI
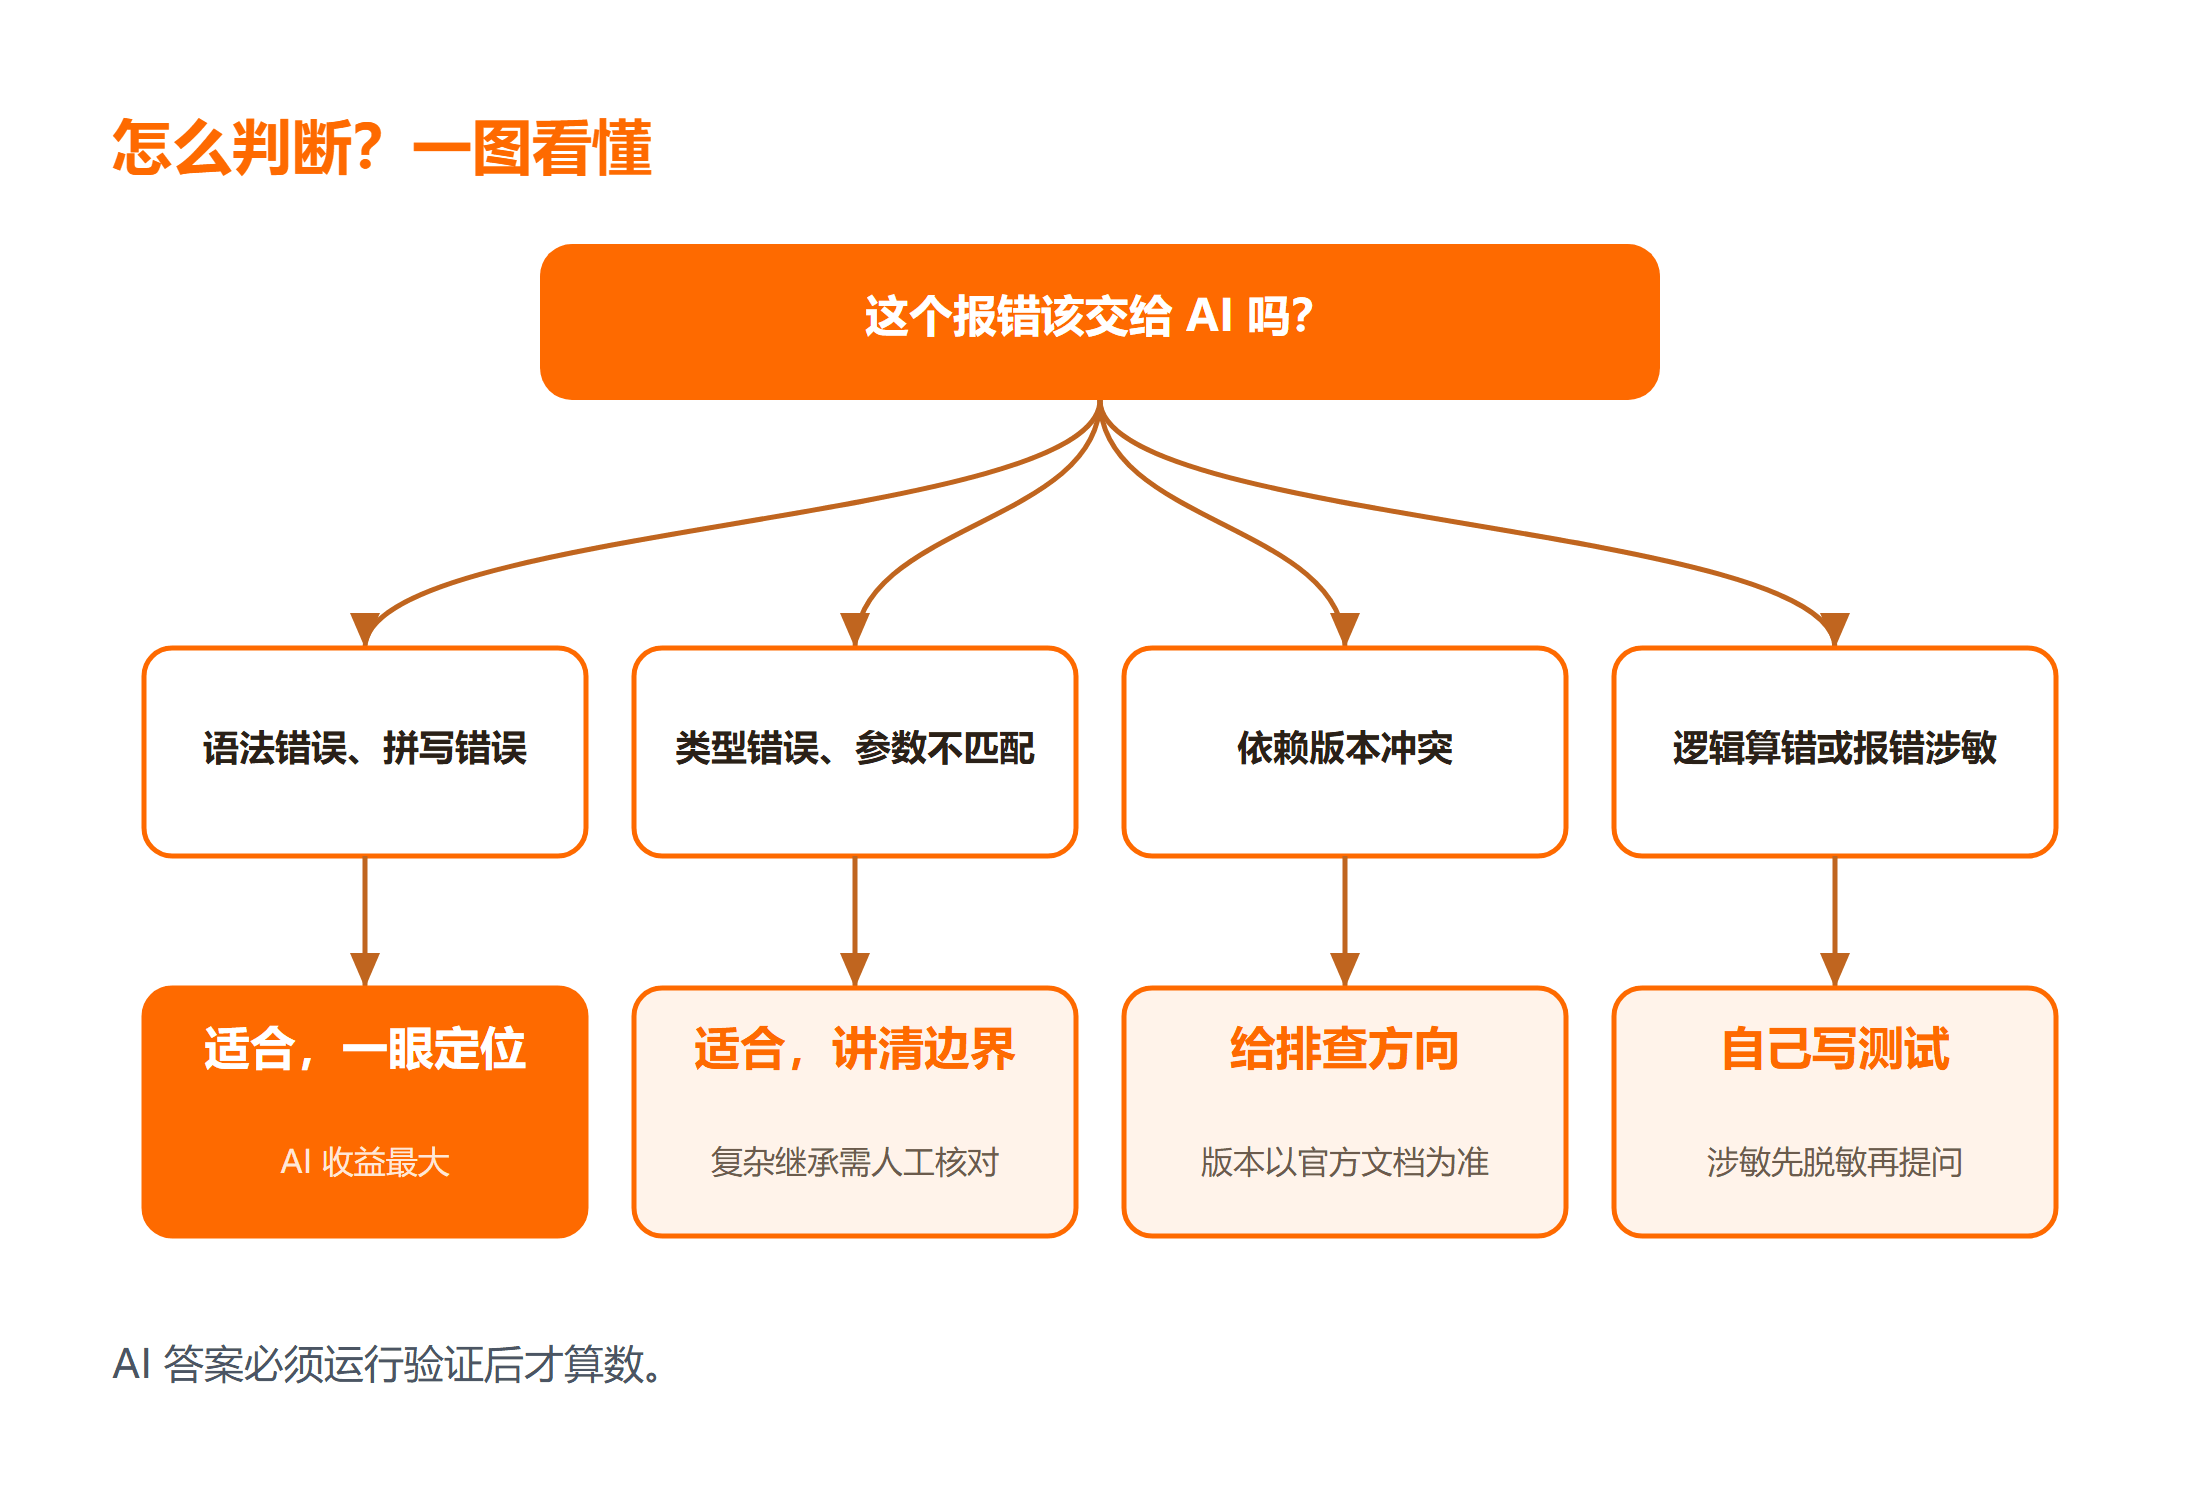
不是所有报错都值得问 AI。下面这张表按报错类型给出选择建议,先对号入座再动手。
| 报错场景 | 适合交给 AI | 不适合/需谨慎 |
|---|---|---|
| 语法错误、拼写错误 | 适合,一眼定位 | 无 |
| 类型错误、参数不匹配 | 适合,AI 能讲清类型边界 | 涉及复杂继承链时需人工核对 |
| 依赖版本冲突 | 适合给出排查方向 | 版本号需以官方文档为准 |
| 业务逻辑算错(不报错) | 不适合,AI 看不出"错" | 需自己写测试断言 |
| 报错含密钥、内网地址 | 谨慎,先脱敏再提问 | 涉敏内容禁止外发 |
对编程新手来说,前两类占日常报错的八成以上,交给 AI 收益最大。第三类要特别小心:AI 给的版本组合可能是过时的,必须回到 Python 教程 或依赖官方文档核对。最后一类是安全边界——报错信息里常带服务器路径、账号信息,直接贴给在线 AI 等于泄露,先替换成占位符再提问。把这张表记熟,AI 排错就不会用错场合。
二、准备阶段:喂给 AI 的最小上下文
AI 排错的质量取决于上下文的完整度。最小上下文有四样:完整报错原文(从 Traceback 第一行到最后一行,不要只截最后一行)、出错的代码片段、你期望的正确行为、运行环境版本。缺一样,AI 就只能猜。准备时按下面清单检查:
# 1. 确认语言与版本,AI 判断语法边界需要它
python --version

# 2. 完整重跑一次,拿到从第一行开始的完整报错
python main.py 2> error.log
# 演示用最小错误示例:本意是拼接字符串与数字
age = 18
msg = "今年 " + age + " 岁" # 预期输出:今年 18 岁
print(msg)
预期结果是抛出 TypeError: can only concatenate str (not "int") to str(未在本机执行,按 Python 官方文档推断)。很多新手只把 TypeError 三个词发给 AI,结果得到一堆泛泛而谈的可能原因;把整段 Traceback 加上这两行代码一起发,AI 会直接指出 age 是 int、要先用 str(age) 转换。这就是"完整上下文"与"只给关键词"的差距。下一节开始走三步流程。
三、第一步:还原报错原文与定位
第一步的目标是让 AI 把报错"翻译"清楚,并定位到出错的行。提问模板可以固定成三句:这是完整报错原文;这是我出错的代码;请逐行解释报错含义并指出具体哪一行出了什么问题。还用上面的例子:
# 把报错原文与代码一起给 AI(发给 AI 前的提问内容应类似这样)
"""
完整报错:
Traceback (most recent call last):
  File "main.py", line 3, in <module>
    msg = "今年 " + age + " 岁"
TypeError: can only concatenate str (not "int") to str

我的代码:
age = 18
msg = "今年 " + age + " 岁"
请逐行解释报错含义,指出哪一行错了、为什么错。
"""
AI 会返回类似:第 3 行的 "今年 " 是字符串,age 是整数,Python 不允许字符串直接加整数,所以抛出 TypeError。到这里,报错信息就从天书变成了人话。这一步的验收标准是:你能不看 AI 的回答,自己复述出这段报错信息的"哪一行、什么类型、错在哪"。如果 AI 的解释里出现你没用过的函数或文件名,大概率是它在补全想象,立刻回到上一节检查上下文是否喂全。其他 AI 编辑器也把这套流程做成了文档,例如 TRAE 问题排查 里"先还原现场再排查"的思路完全一致。
四、第二步:追问根因并验证
AI 给出解释后,别急着复制答案,先追问根因再验证。追问模板同样固定:为什么会这样设计;有没有其他写法;哪种是官方推荐。继续上面的例子:
# AI 给出的两种修复,追问后让它对比
age = 18

# 方案 A:str() 转换后拼接
msg_a = "今年 " + str(age) + " 岁"

# 方案 B:f-string 格式化(官方更推荐)
msg_b = f"今年 {age} 岁"

print(msg_a)  # 输出:今年 18 岁
print(msg_b)  # 输出:今年 18 岁
两种写法的预期输出相同,都是"今年 18 岁"(未在本机执行,按 Python 官方文档推断)。验证的关键是:把 AI 给的答案放进你自己的项目里跑一遍,而不是只看它说得通。验证通过后,再核对写法是否官方推荐——f-string 是 Python 3.6+ 的标准做法,这类"哪种更好"的结论可在 在线代码实例 里直接跑对比。AI 排错最容易翻车的点在这一步:它给的 API 可能根本不存在,或参数是旧版本的,所以凡是没有运行验证的答案,一律当作"待验证假设"。
五、第三步:落地修复与防复发
修复生效后还差最后一步:把这次报错变成经验,防止同类问题复发。做法是把报错类型、根因、修复写进你的笔记,并让 AI 顺手给一条通用检查建议。常见失败按下面清单排查:
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| AI 的修复跑完还是同样报错 | 只贴了报错最后一行,上下文不全 | 补全 Traceback 与相关代码再问 |
| AI 说了个不存在的函数 | 模型幻觉,编造 API | 回官方文档核对,或要求 AI 给出来源 |
| 修了这处、别处又报同类错 | 只修表面,没修根因 | 让 AI 解释这类错误的通用成因 |
| 报错含敏感信息不敢提问 | 报错栈带路径、密钥 | 先脱敏:替换成占位符再发 |
| 英文报错翻译了还是不懂 | 缺少语言基础 | 回教程补对应章节的语法概念 |
防复发的关键动作是沉淀:同一类报错信息第三次出现时,你不该再问 AI。把每次 AI 排错的问答整理成两行笔记(报错特征、修复方法),一个月后你会发现大部分报错信息已经能秒判。这也是 AI 排错的真正价值——它不只是替你修这一次,而是加速你学会自己修。
总结
用 AI 从报错定位到修复,核心是三步:先喂全上下文(完整报错信息、代码、预期、版本),再追问根因并用运行结果验证,最后落地修复并沉淀防复发笔记。两个边界要牢记:涉敏报错先脱敏,AI 答案必须运行验证后才算数。对编程新手来说,这套流程练熟后,报错信息会从劝退天书变成修复方法最快的路标。下次遇到看不懂的报错信息,按本文三步走一遍,你会发现 AI 排错的确定性比自己盲试高得多。
延伸学习
常见问题
Q:把报错发给 AI 会不会泄露代码或账号?
A:要看报错内容和使用的产品。报错栈里常见三类敏感信息:服务器绝对路径、数据库连接串、接口密钥,其中密钥泄露后果最严重。发给任何在线 AI 前,先做脱敏:把密钥、内网 IP、真实域名替换成 xxx 占位符,报错的结构不受影响,AI 照样能定位。如果代码涉及公司核心业务,优先选支持本地部署或明确承诺不训练的工具,或者只用 AI 排脱敏后的最小复现示例。
Q:AI 给的修复方案互相矛盾,听谁的?
A:以"能在你本机运行验证的那个"为准,而不是说得最流畅的那个。AI 的回答没有真值,只有可验证性:两个方案都拿最小示例跑一遍,能通过、且写法更接近官方文档的那个胜出。如果两个都能跑通,再比较可读性与边界处理——例如 f-string 与 str 拼接都能用时,选官方推荐的 f-string。矛盾本身是好事,它说明这个问题值得你回教程补一次基础概念。
Q:报错太长,全贴给 AI 会不会浪费?
A:不会浪费,反而省时间。Traceback 从第一行到最后一行是调用链,AI 需要完整链条才能定位真正的出错点;只贴最后一行,AI 只能列出若干"可能原因"让你自己试。如果报错确实超长(比如依赖冲突刷了几百行),可以先折叠重复部分,但第一次出现的那行和最后一行必须保留。经验上,完整上下文换来的是一次问对,截断换来的是反复追问。
Q:新手要不要背下常见报错类型?
A:要,但不用刻意背。TypeError、NameError、IndexError、KeyError 这四个最高频,每次遇到就让 AI 讲一次,配合自己的笔记,两三周自然记住。记住它们的收益是:报错一出现你就知道往哪个方向查,AI 排错从"每次从零开始"变成"每次只补细节"。判断标准很简单——当你能不看翻译复述报错含义时,这一类就可以从提问清单里划掉了。



